一个 200 台节点、每台 24TB 的 HDFS 集群,block 按 128MB 切,大约有 4000 万个 block。而 NameNode 要把所有目录树、文件、block 映射全放在内存里——经验值是 1GB 内存管约 100 万个 block,4000 万 block 就是约 40GB 堆。节点再往上翻一倍,NN 内存奔着上百 GB 去。
把 NameNode 的 JVM 堆一路调大?Full GC 一次停顿几十秒,整个集群元数据操作全卡死。这不是长久之计。HDFS 给出的答案是 Federation:与其让一个 NN 扛全部元数据,不如拆成多个,各管一摊。
30 秒心智模型
单 NameNode 是"一个管家管整栋楼"。Federation 是"多个管家各管一层楼":
- 多个 NameNode 并存,每个管自己的命名空间(Namespace)和 block 池(BlockPool),互相独立、不互相协调;
- 同一批 DataNode 被所有 NameNode 共用,每台 DN 向所有 NN 注册、发心跳、汇报 block;
- 用户不感知分裂:通过 ViewFs 一个统一入口访问,路径
/data、/user分别落到不同的 NN 上。
一、为什么单 NameNode 撑不住
HDFS 的元数据完全在 NameNode 内存里:目录树、每个文件权限、每个文件由哪些 block 组成。注意——block 存在哪台 DataNode 上不落盘,是启动时 DN 上报后在内存重建的,但"文件→block 列表"这层映射必须常驻内存。
算笔账:
- 1GB 内存 ≈ 100 万个 block 的元数据;
- 200 节点 × 24TB ÷ 128MB ≈ 4000 万 block;
- 对应约 40GB NN 内存。
文件数再多、小文件再多,NN 内存线性上涨。它不只是"内存贵"的问题,更是单点:所有元数据请求都打在一个进程上,它挂了整个集群不可用。Federation 解决的是内存与水平扩展,不是高可用(这点后面会讲)。
二、Federation 架构:多 NN、共享 DN
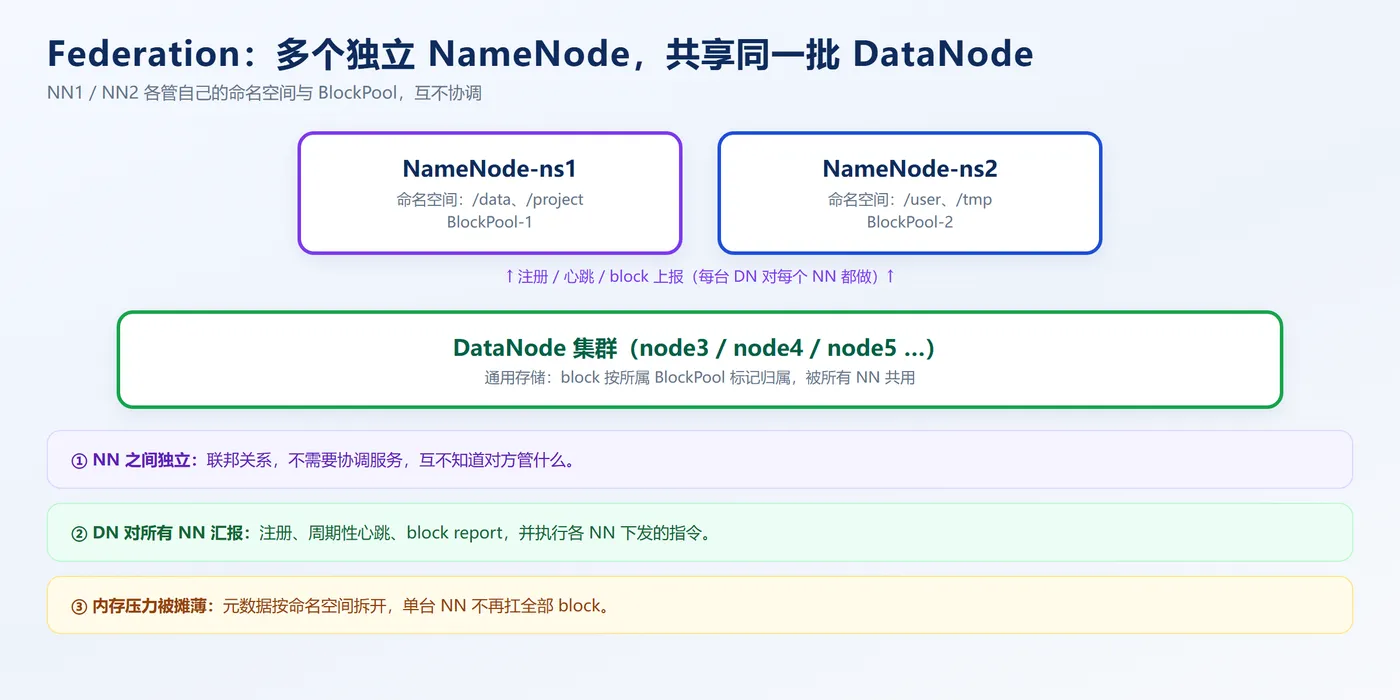
三个关键事实:
- NameNode 之间相互独立:它们是联邦关系,不需要 ZooKeeper 之类的协调服务,各自维护自己的命名空间,一个 NN 不知道另一个 NN 管什么;
- DataNode 是公共存储:同一批 DN 同时被多个 NN 使用。每台 DN 要向集群里所有 NN 注册,周期性发心跳、上报 block 列表,并执行来自各 NN 的指令;
- block 按命名空间隔离:每个 NN 有自己的 BlockPool,DN 上的 block 会标记归属哪个 pool,互不串扰。
这就把"一个 NN 的内存压力"按命名空间拆开了——比如 /data、/project 给 NN1,/user、/tmp 给 NN2,各管一半元数据。
三、ViewFs:用户眼里还是一个文件系统
问题来了:用户怎么知道 /data 在 NN1、/user 在 NN2?总不能让业务代码写 hdfs://node1:8020/data、hdfs://node2:8020/user。
答案是 ViewFs——一个客户端侧的挂载表,类似 Linux 的 /etc/fstab。它对外暴露一个统一的逻辑根,把不同子路径映射到不同的实际 HDFS 地址:
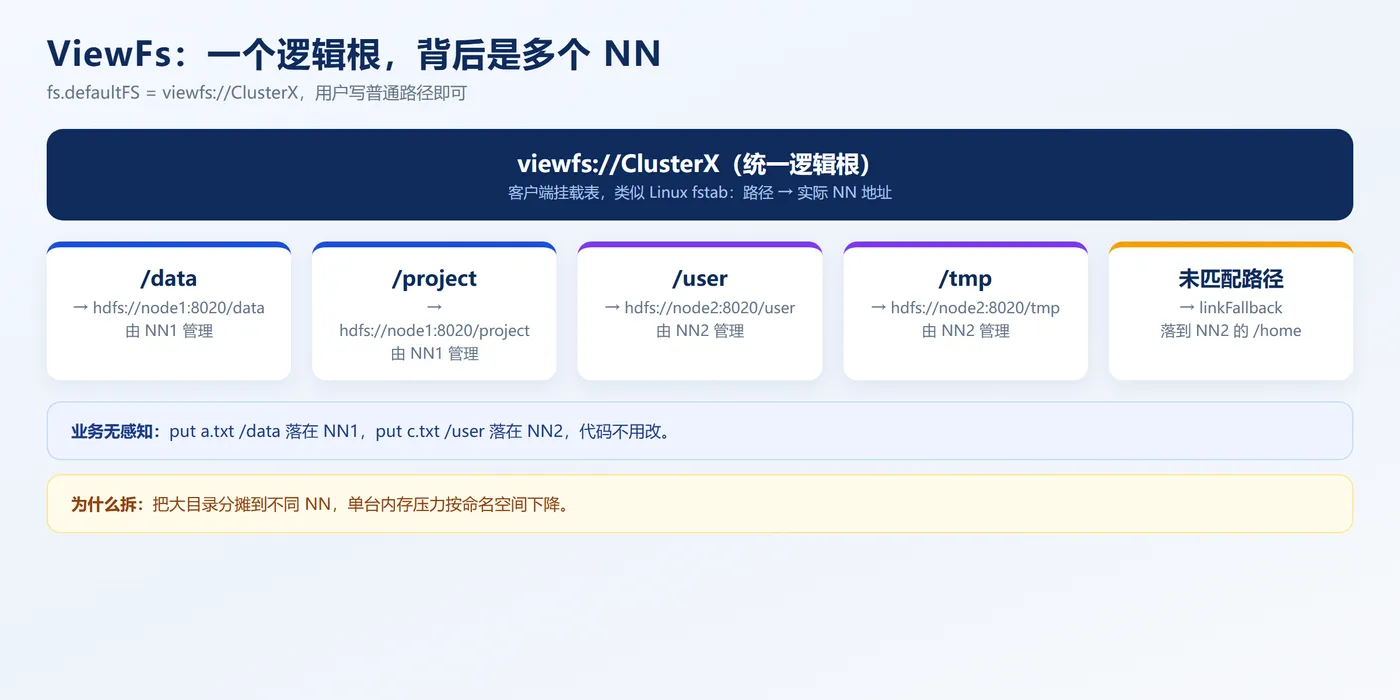
客户端把 fs.defaultFS 配成 viewfs://ClusterX,再配置每条挂载规则。用户像访问单个 HDFS 一样写路径,由 ViewFs 在客户端翻译成具体的 NN 地址。
核心配置长这样(节选):
<property>
  <name>fs.defaultFS</name>
  <value>viewfs://ClusterX</value>
</property>
<property>
  <name>fs.viewfs.mounttable.ClusterX.link./data</name>
  <value>hdfs://node1:8020/data</value>
</property>
<property>
  <name>fs.viewfs.mounttable.ClusterX.link./user</name>
  <value>hdfs://node2:8020/user</value>
</property>
<!-- 未匹配路径兜底到 NN2 的 /home -->
<property>
  <name>fs.viewfs.mounttable.ClusterX.linkFallback</name>
  <value>hdfs://node2:8020/home</value>
</property>
对应的 hdfs-site.xml 里要把多个命名空间都声明出来:
<property><name>dfs.nameservices</name><value>ns1,ns2</value></property>
<property><name>dfs.namenode.rpc-address.ns1</name><value>node1:8020</value></property>
<property><name>dfs.namenode.rpc-address.ns2</name><value>node2:8020</value></property>
这样 hdfs dfs -put a.txt /data 和 -put c.txt /user,前者落在 NN1、后者落在 NN2,业务无感知。
四、两个常被忽略的细节
格式化要用同一个 clusterId。 两个 NN 是"一个集群的联邦",格式化时必须指定相同的 clusterId,否则 DN 不认:
# node1 和 node2 上都执行,clusterId 必须一致
hdfs namenode -format -clusterId viewfs
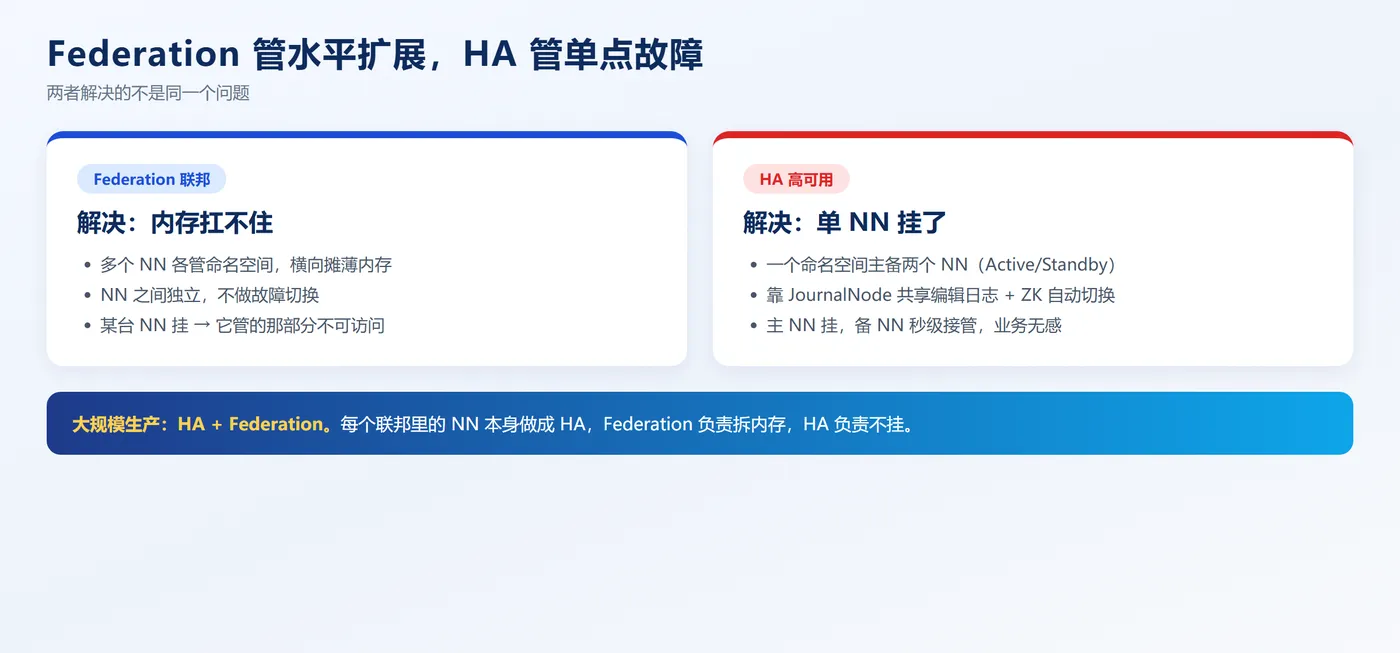
Federation 不解决单点故障。 这是最容易踩的误区。每个 NN 只管自己那摊,NN1 挂了,它名下的 /data、/project 就全不可访问——虽然还有 SecondaryNameNode 能协助恢复元数据,但得手动重启 NN。所以真正大规模的生产集群,是 HA + Federation:每个联邦里的 NN 本身又做成主备高可用(靠 JournalNode + ZooKeeper Failover),Federation 负责水平扩内存,HA 负责单个 NN 不挂。
五、常见误区
- 误区一:Federation 就是起多个 NameNode 凑数。 不是,它们各管独立命名空间和 block 池,靠 clusterId 归到同一集群,DN 共享。
- 误区二:Federation 后某个 NN 挂了整个集群不能用。 不对,只有它管的那部分命名空间不可访问,其他 NN 照常服务——但这恰恰说明它没解决单点。
- 误区三:有了 Federation 就不用 HA。 大规模生产一定是两者叠加:Federation 拆内存,HA 保单个 NN 高可用。
写在最后
HDFS Federation 的本质,是把"元数据集中在一个进程"这件事按命名空间切开,用多 NN 水平摊薄内存压力,再用 ViewFs 把这个分裂对业务藏起来。它回答的是"集群再大、NameNode 内存扛不住怎么办",而不是"NameNode 挂了怎么办"——后者是 HA 的活。
看到这里,建议顺着两个问题自己理一遍:你的集群 NN 现在堆多大?block 数除以 100 万估一下内存水位,离拆命名空间还有多远?这比背配置项有用得多。