大模型进入规模化落地阶段后,企业和技术团队面对的提问方式发生了根本变化。两年前,讨论的焦点是"这款模型能力够不够";而到了2026年,更常见的问题变成了"这套能力跑下来一个月要花多少钱"。能力提升与成本控制,已经成为同一枚硬币的两面。
这一转变有清晰的现实背景。一方面,旗舰模型承担的推理链路越来越长——它们不再只回答一句问题,而是要在数十轮对话、整仓代码、成百上千页文档中保持规划、执行、反思与修正,单次任务的Token消耗量级随之抬升;另一方面,多模态生成、智能体自动化、编程辅助等高频调用的应用形态大规模铺开,调用次数从"按天"变为"按秒"。当单位成本被高频次放大,采购方式的细微差别就会被迅速积累成显著的账面差距。
阿里云在2026年双十一期间围绕AI大模型推出的这批权益,恰好覆盖了从"选对模型"到"买对计费方式"的完整链条。它包含四个彼此配合的层次:以模型分级实现能力与成本的匹配,以时段折扣消化可延迟的任务,以订阅制统一日常调用口径,以承诺换折扣的方式压低确定性支出。本文按模型、时段、订阅、折扣四个维度逐项展开,说明每一类优惠的适用条件、价格结构与使用边界,并以用量规模为线索给出组合建议。
需要首先明确一条前提:以下所有价格均为活动期间的参考口径,活动的产品范围、库存、地域限制与续费规则可能随官方政策调整,实际结算以控制台与订单页实时展示为准。
一、Qwen3.8-Max与Qwen3.8-Flash:能力分级背后的成本分级
1.1 两款模型的定位差异
Qwen3.8-Max与Qwen3.8-Flash同属通义千问Qwen系列,但面向的场景截然不同。理解二者的差异,是控制调用成本的第一步。
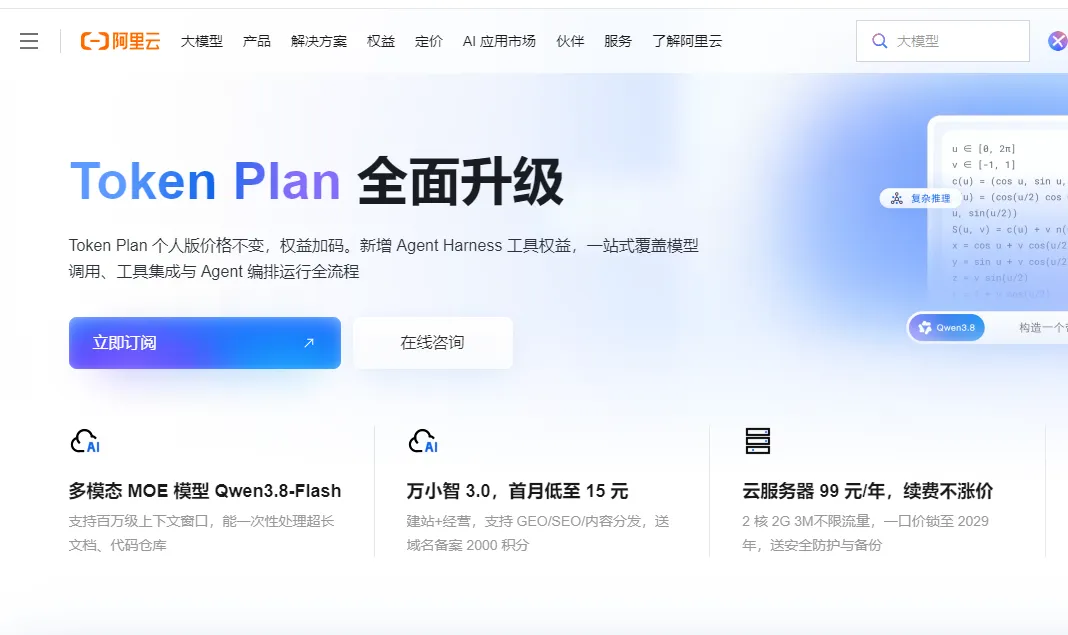
Qwen3.8-Max是旗舰级大模型,整体定位高于基础对话模型和轻量模型,面向复杂推理、长文档处理、专业办公、代码工程、多模态理解和智能体任务等场景。从公开信息看,它采用MoE混合专家架构,总参数量达到2.4万亿,推理时激活约950亿参数。MoE架构的特点是模型内部存在多个"专家模块",不同任务会被路由到更适合的专家子网络处理,从而在大规模参数与推理效率之间取得平衡。
Qwen3.8-Flash是轻量级多模态大模型,主打高性能、低延迟、低资源和高性价比,更适合高频、轻量、规模化调用场景。它采用Next新架构,总参数量约1250亿,推理时每Token仅激活约60亿参数,训练成本较上一代同定位模型大幅下降,在高并发多模态场景中具备明显的单位成本优势。
对使用者而言,一个直观的区分方式是:Max解决"要求高、链路长、失败成本高"的任务,Flash解决"次数多、单次轻、追求响应速度"的任务。二者并非替代关系,而是分工关系。
1.2 Qwen3.8-Max的核心能力
Qwen3.8-Max更接近面向真实业务的智能生产力引擎,它并不只负责"回答问题",而是能够在较长任务链路中保持规划、执行、反思和修正能力。其能力可归纳为五个方面。
第一,复杂逻辑推理能力。 在专业领域推理、多步骤任务拆解、长链思考方面表现突出,适合处理法律、金融、科研、商业分析、复杂系统设计等问题。对于需要"先理解材料、再拆解问题、再推理判断、最后输出结论"的任务,它比普通轻量模型更稳定。
第二,长文档处理能力。 模型支持百万级上下文窗口,能够一次性处理超长文档、多份材料、大型代码仓库和复杂历史对话,对长文档问答、跨材料归纳、多章节总结、合同审查、报告初稿生成等场景比较友好。
第三,编程与工程能力。 具备较强的代码生成、代码理解、缺陷修复、测试生成、架构分析能力,可以辅助开发者阅读多个文件、理解项目结构、补全业务代码、定位错误原因,并在一定条件下完成较完整的工程任务。
第四,多模态理解能力。 支持文本、图像、视频等多模态输入,能够理解图片内容、截图信息、图表结构、视频关键语义和图文混合材料,在界面解析、图片问答、文档截图提取、视频内容理解、科研图像分析等场景有实际价值。
第五,智能体与工具调用能力。 支持Function Calling、结构化输出、联网搜索、代码沙盒执行、工具调用等能力,适合构建AI Agent——它可以围绕任务自动规划步骤,调用外部工具,读取返回结果,再继续生成最终答案。
典型的高价值场景包括企业知识库、法律合同分析、金融研报摘要、复杂代码开发、AI Agent自动化流程、长文档问答等。
1.3 Qwen3.8-Flash的能力边界
Qwen3.8-Flash的核心能力覆盖文本生成、多模态理解、轻量推理、基础代码辅助、内容摘要、问答对话、智能体协作、图文理解等。它同样支持文本、图像、视频等多模态输入,具备较强的理解与生成能力,同时拥有出色的响应速度。
需要正视的是其能力边界:相比旗舰模型,Flash在复杂深度推理、超长专业文档、复杂多步骤Agent任务上的处理能力相对有限。但对大多数日常场景而言已经足够——短文案生成、基础问答、摘要整理、代码注释、简单脚本、常见问题自动回复、内容分类、关键词提取、图文问答等任务,Flash通常都能稳定完成。
值得注意的是,Flash在编程辅助、智能体协作、图文理解等场景中表现突出,可以处理简单代码的自动修复、辅助桌面应用操作、分析图表与长文档等任务。它并非简单意义上的"小模型",而是在效率与能力之间做了明确取舍。
1.4 Night Plan夜间活动:把"可等待"的任务移到低成本时段
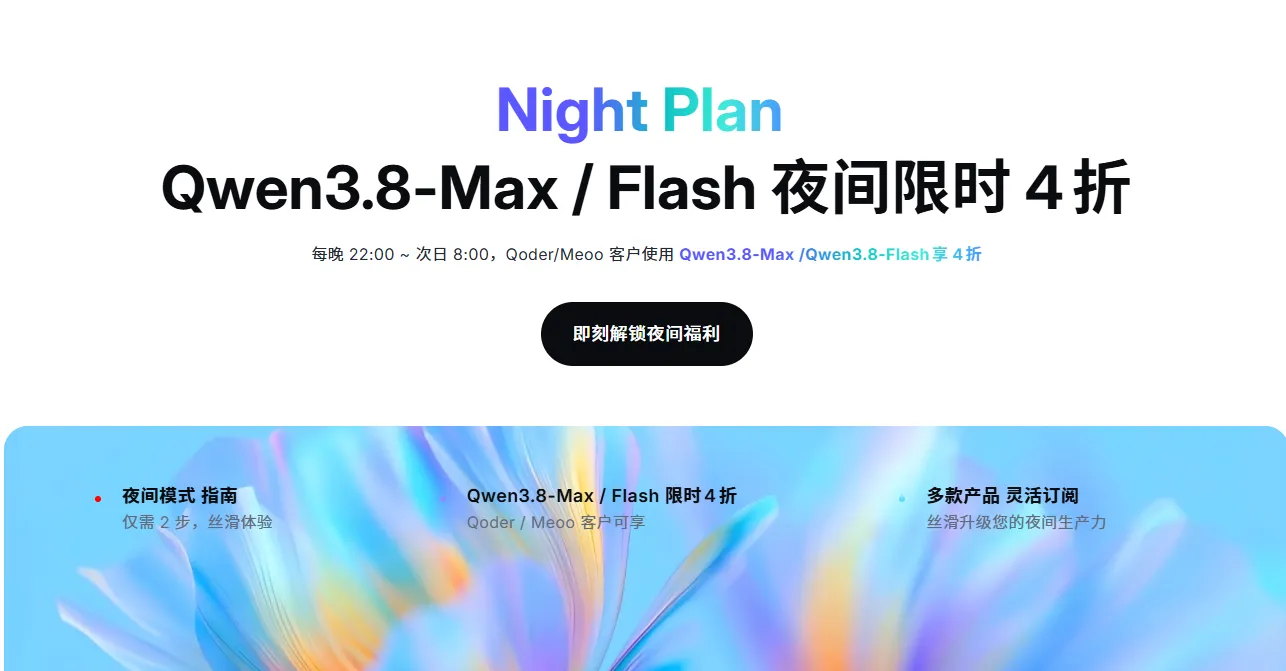
在模型分级之外,时段是第二个成本杠杆。Qwen3.8-Max和Qwen3.8-Flash在夜间时段提供显著优惠,适合可以延迟处理的任务。根据活动机制,每晚22:00至次日8:00期间,使用这两款模型可享受限时4折优惠;Qoder、Meoo相关客户在该时段内调用,也可获得更明显的成本下降。
夜间活动的价值在于把"可等待"的任务转移到低成本时段执行。相当一部分AI应用任务并不需要秒级实时返回,只要最终在次日使用前完成即可:白天的信息收集、问题整理、代码与素材准备,都可以在夜间统一提交处理。典型场景包括长文档摘要、视频内容分析、代码仓库扫描、知识库整理、营销文案批量生成、常见问题库自动维护、客服记录复盘和报告初稿生成。
对团队用户而言,将任务队列、自动化脚本与夜间处理结合起来,长期节省效果会非常明显。参与前应确认账号类型、使用场景和产品范围是否符合活动条件,例如是否属于Qoder、Meoo相关客户,调用链路是否在优惠时段内完成,计费方式是否支持折扣抵扣。活动详情可参考:https://www.aliyun.com/benefit
二、Wan3.0-Video:一体化视频生成模型的能力与价格
2.1 模型定位
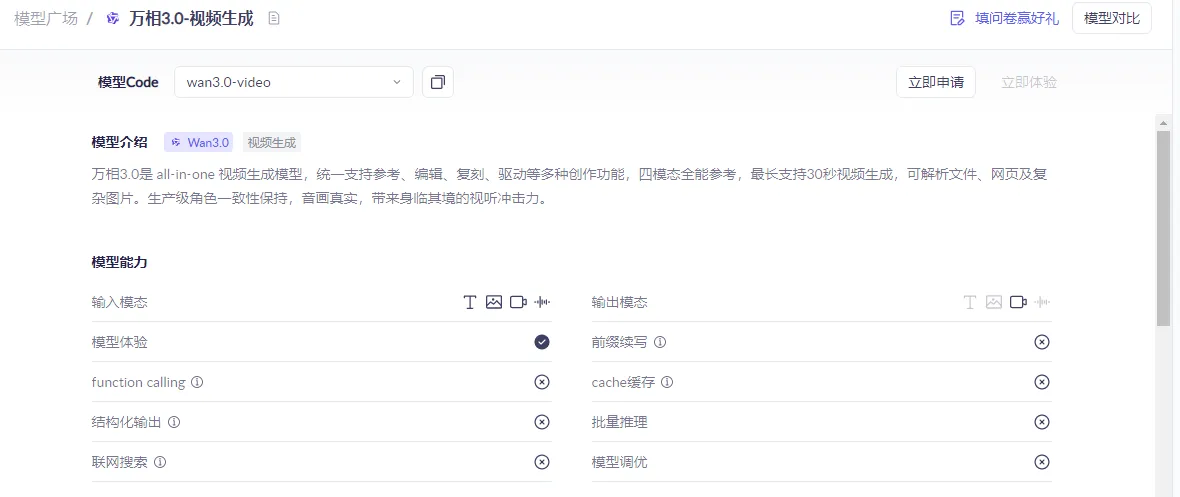
万相3.0(Wan3.0)是阿里云推出的一款all-in-one(一体化)视频生成模型,模型Code为wan3.0-video,定位于视频生成场景。它统一支持参考、编辑、复刻、驱动等多种创作功能,实现了四模态全能参考,最长支持30秒视频生成,并可解析文件、网页及复杂图片等多种来源的素材。
在生成质量方面,万相3.0具备生产级角色一致性保持能力,音画表现真实自然,能够提供较强的视听冲击力。无论是创意短片、广告素材还是故事化内容创作,都可采用从参考到生成的一站式方案。wan3.0-video模型的推理服务由阿里云百炼提供,入口见:https://www.aliyun.com/product/bailian
2.2 五类适用场景
Wan3.0-Video的适用场景覆盖以下任务类型,每一类对应不同的生产需求。
第一,文生视频。 仅通过提示词生成视频,支持单镜头和多镜头分镜叙事,原生生成同步台词、BGM和音效,适用于创意短片、故事叙述等场景。
第二,图生视频(首帧/首尾帧)。 通过指定首帧或同时指定首尾帧图像生成视频,像素级还原参考画面,适用于需要精准控制起止画面的产品展示、动画过渡等场景。
第三,全模态参考生视频。 支持最多20个参考素材(图片、视频、音频、文档、网页)组合输入,适用于角色物品一致性视频生成、运镜动作复刻、风格迁移、音频驱动口型动画、基于PPT与Excel等文档自动生成视频、基于公开网页内容生成视频等场景。
第四,视频编辑。 通过参考视频结合提示词指令,实现增删改元素、风格转换、光线编辑、台词编辑等功能。
第五,视频延长。 支持向前、向后或双向延长已有视频内容。
2.3 模态支持与能力边界
在模态支持方面,万相3.0-Video的输入模态覆盖文本、图像、视频、音频四种类型,充分体现了四模态全能参考的产品特性;输出模态为视频,专注于高质量视频内容的生成。
在具体功能支持方面,模型当前支持模型体验,用户可在平台内直接在线试用;而前缀续写、函数调用(function calling)、缓存(cache)、结构化输出、批量推理、联网搜索、模型调优等功能暂不支持。整体来看,其能力设计聚焦于视频生成本身,通过多模态输入驱动视频创作,能力边界清晰、定位明确,适合以内容创作为核心诉求的使用场景。
此外,Wan3.0-Video还提供优速版wan3.0-video-prime,在保持同等生成能力的前提下提升端到端生成速度,适合对出片效率有更高要求的场景。
2.4 按秒计费与限时七折
万相3.0-Video采用按视频时长(每秒)计费的模式,提供三档分辨率规格,且当前均享受限时7折优惠。华北2(北京)地域标准版价格为480P 0.3元/秒、720P 0.6元/秒、1080P 1.2元/秒,具体价格以控制台实时显示为准。
| 服务规格 | 优惠活动 | 原价 | 折后价(按7折估算) |
|---|---|---|---|
| 视频生成(480P) | 限时7折 | 0.3元/秒 | 约0.21元/秒 |
| 视频生成(720P) | 限时7折 | 0.6元/秒 | 约0.42元/秒 |
| 视频生成(1080P) | 限时7折 | 1.2元/秒 | 约0.84元/秒 |
从价格体系可以看出,模型按分辨率分级定价,分辨率越高、单秒价格越高,用户可根据预算与画质需求灵活选择:480P适合快速草稿与创意验证,720P兼顾画质与成本,1080P面向成品级输出。叠加限时7折优惠后,整体使用成本进一步降低,对创作者和企业用户而言性价比突出。活动详情可参考:https://www.aliyun.com/benefit/select/cloud-discount
三、百炼Token Plan:把多个计费口径收敛为一个额度池
3.1 Credits统一抵扣机制
Token Plan采用Credits统一抵扣机制,一份订阅即可在Claude Code、Cursor、Qwen Code、Codex、Qoder、Qoder CN、OpenClaw等主流AI编程和智能体工具中使用。它支持文本生成、图像生成、视频生成、语音识别、实时语音对话等多种模型,以及联网搜索、代码解释器等模型内置工具。
理解Token Plan的关键,在于理解Credits的作用。无论调用的是推理模型、图片生成模型还是视频生成模型,无论使用的是模型本身还是模型内置的联网搜索、代码解释器等工具,最终都会折算成同一套Credits额度进行抵扣。这意味着成本核算的对象,从"多个模型单价×多个工具计费口径"收敛为一个额度池,既方便个人开发者估算月度支出,也便于团队按席位分配预算。
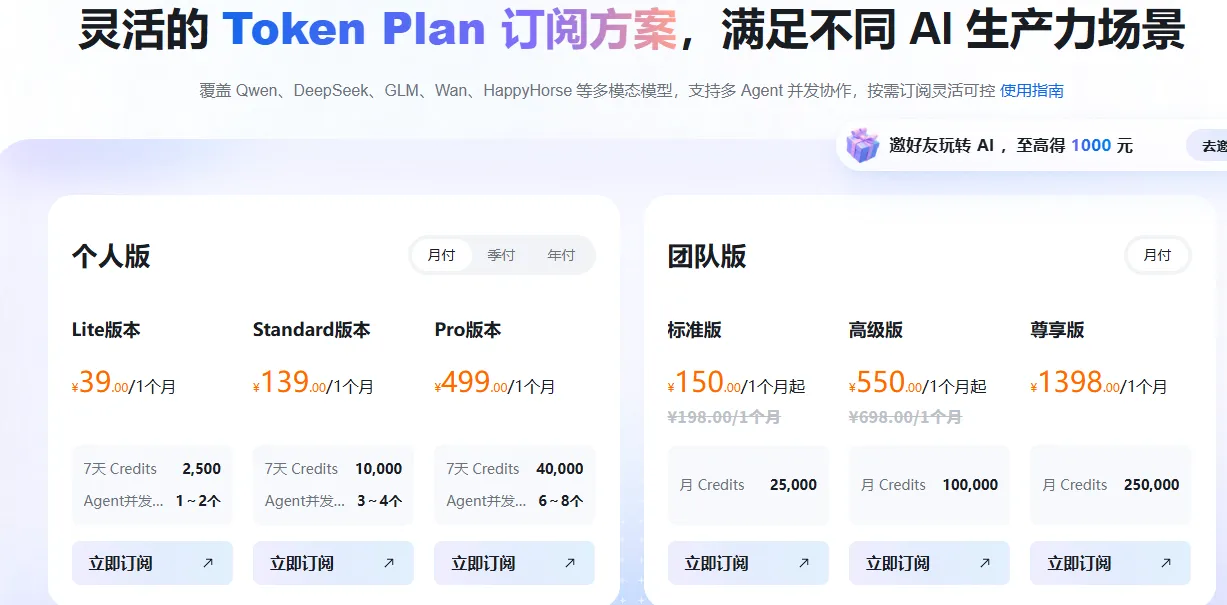
产品分为两条线:个人版面向个人开发者,提供Lite、Essential、Standard、Pro四档套餐;团队版面向团队和企业,提供标准席位、高级席位、尊享席位三个档位,支持多席位管理、用量分析,并承诺不使用数据训练模型。
3.2 个人版核心特性
- Credits统一计量:通过Credits统一抵扣模型调用及模型内置工具的费用。
- 多模态模型支持:覆盖文本生成、推理、视觉理解、图片生成、语音合成、实时语音对话、语音识别、视频生成等能力。
- Harness权益:Standard与Pro套餐附赠自研工具的每月免费额度与后付费折扣。
- 加油包:套餐月限额不足时,可购买加油包补充额度,每个加油包含20,000 Credits,最多同时持有5个。
- 兼容多种工具:适配Claude Code、Cursor、Qwen Code、Qoder、Qoder CN、OpenClaw等主流AI编程和智能体工具。
3.3 团队版核心特性
- 多模型灵活切换:支持多模型按需切换,按Credits统一抵扣。
- 兼容多种工具:适配多种主流编程工具及热门Agent工具。工作台提供快速接入入口,支持Qwen Code、Claude Code、Qoder、Qoder CN、OpenClaw等工具接入。
- 多档位套餐:提供标准席位、高级席位、尊享席位多档位套餐,匹配不同使用强度。
- 团队管理:提供管理后台,支持席位分配与回收、成员用量分析等能力。
- 预算可控:支持按月订阅,预算可控。
- 数据安全:承诺不使用对话数据进行模型训练,满足企业级数据隐私要求。
- 平稳运行:多租户隔离架构,调用高峰期间不排队。
Token Plan团队版提供套餐Base URL,兼容OpenAI、Anthropic接口标准,具体地址可在工作台API Key页面查看。
3.4 个人版与团队版最新活动价格
个人版定位为面向个人开发者的AI大模型及Harness综合订阅服务,共设四档套餐,价格与权益如下。
| 套餐 | 价格(月/季/年) | 额度 | 并发能力 | 主要权益说明 |
|---|---|---|---|---|
| Lite | 39元/月、110元/季、420元/年 | 2,500 Credits/7天 | 1-2个Agent并发 | 入门探索之选,适用于原型验证或轻度测试单任务的智能体用户;含文本、视觉、语音等多模态模型、联网搜索等内置工具 |
| Essential | 79元/月、220元/季、860元/年 | 25,500 Credits/月 | 2-3个Agent并发 | 中间档位,Credits统一计量,可在主流编程与智能体工具中使用;不含Standard与Pro附赠的Harness权益;目前仅支持华北2(北京)地域 |
| Standard | 139元/月、396元/季、1510元/年 | 10,000 Credits/7天 | 3-4个Agent并发 | 效率升级之选;享受Lite套餐全部权益,用量为Lite的4倍;额外赠送Harness权益(AgentStudio多款工具权益额度、Harness畅享后付费88折) |
| Pro | 499元/月、1420元/季、5600元/年 | 40,000 Credits/7天 | 6-8个Agent并发 | 专业优选之选;享受Standard套餐全部权益,用量为Lite的16倍;同样赠送Harness权益 |
需要留意的是,Essential套餐订阅月内未用完的额度不结转至下一周期,额度用尽后可购买用量包补充或等待下一个订阅月重置。价格可能调整,请以控制台实时显示为准。
团队版按席位订阅,分为三档。
| 席位类型 | 价格(月/年) | 额度 | 适用对象 |
|---|---|---|---|
| 标准坐席 | 150元/席位/月、1800元/席位/年 | 25,000 Credits/月 | 适合轻度使用AI辅助的团队成员 |
| 高级坐席 | 550元/席位/月、6600元/席位/年 | 100,000 Credits/月 | 适合日常高频使用AI编程的团队成员 |
| 尊享坐席 | 1398元/席位/月、16776元/席位/年 | 250,000 Credits/月 | 适合重度依赖AI编码的核心开发者 |
三档席位均包含文本、视觉、语音等多模态模型与联网搜索等模型内置工具,并适配主流工具且持续扩展。更多详情可访问阿里云百炼Token Plan服务页面:https://www.aliyun.com/benefit/scene/tokenplan
四、AI通用型节省计划:以承诺换折扣的确定性优化
4.1 三种成本工具的边界
百炼平台默认采用按量后付费模式,不支持直接提前赠送Token额度。如需降低模型调用成本,可选择AI通用型节省计划:通过承诺每月消费金额来换取阶梯式折扣,最高可享5.3折优惠。该方案可抵扣阿里直供的绝大部分模型,灵活性最高,是多数场景下的首选。
为避免混淆,需要区分三类成本工具的分工。
| 维度 | AI通用型节省计划 | 资源包 | Token Plan |
|---|---|---|---|
| 计费模式 | 承诺月消费换阶梯折扣 | 一次性购买固定Token量 | 一次性购买Credits额度 |
| 模型覆盖 | 覆盖绝大部分模型(阿里直供) | 仅适用单个特定模型 | 仅支持部分模型 |
| 适用场景 | 长期稳定使用 | 用量小或集中特定模型 | AI编程与智能体工具使用(个人版/团队版) |
| 接入方式 | 百炼通用API Key与Base URL,费用自动抵扣 | 百炼通用API Key与Base URL,费用自动抵扣 | 专属套餐API Key与Base URL,需配置到AI工具后使用 |
4.2 核心优势
AI通用型节省计划是针对大模型按量付费使用场景设计的折扣方案。用户只需承诺在一定期限内(3个月、6个月、12个月或24个月)的月消费金额,即可在保留按量付费灵活性的基础上享受阶梯式折扣。其核心优势如下:
- 覆盖全面:可抵扣阿里直供的绝大部分模型,一次购买即可跨模型使用。
- 成本优化显著:承诺消费金额越高、周期越长,折扣力度越大,最高可享5.3折优惠。
- 管理流程便捷:购买后可立即或按指定时间生效,无需手动激活或绑定,自动抵扣,支持自动续费。
4.3 折扣信息
不同模型、不同档位、承诺周期和付款方式享受不同的折扣。举例说明:若选择为期12个月、每月承诺消费10,000元的节省计划,采用全预付方式支付,此时调用千问文本生成模型(A类)享受8折优惠,即一次原价1元的模型调用,实际从节省计划额度中抵扣0.8元。
下表金额范围含起始值、不含结束值,例如1,000-5,000表示金额大于等于1,000且小于5,000。C类模型无折扣。
| 付款方式 | 月承诺金额(元) | A类3个月 | A类6个月 | A类12个月 | A类24个月 | B类3个月 | B类6个月 | B类12个月 | B类24个月 |
|---|---|---|---|---|---|---|---|---|---|
| 全预付 | 1,000-5,000 | 8.8折 | 8.6折 | 8.4折 | 8.2折 | 8.3折 | 8折 | 7.7折 | 7.4折 |
| 全预付 | 5,000-10,000 | 8.6折 | 8.4折 | 8.2折 | 8折 | 8折 | 7.7折 | 7.4折 | 7.1折 |
| 全预付 | 10,000-30,000 | 8.4折 | 8.2折 | 8折 | 7.8折 | 7.7折 | 7.4折 | 7.1折 | 6.8折 |
| 全预付 | 30,000-50,000 | 8.2折 | 8折 | 7.8折 | 7.6折 | 7.4折 | 7.1折 | 6.8折 | 6.5折 |
| 全预付 | 50,000-100,000 | 8折 | 7.8折 | 7.6折 | 7.4折 | 7.1折 | 6.8折 | 6.5折 | 6.2折 |
| 全预付 | 100,000-300,000 | 7.8折 | 7.6折 | 7.4折 | 7.2折 | 6.8折 | 6.5折 | 6.2折 | 5.9折 |
| 全预付 | 300,000-1,000,000 | 7.6折 | 7.4折 | 7.2折 | 7折 | 6.5折 | 6.2折 | 5.9折 | 5.6折 |
| 全预付 | 1,000,000+ | 7.4折 | 7.2折 | 7折 | 6.8折 | 6.2折 | 5.9折 | 5.6折 | 5.3折 |
| 零预付(需联系商务经理开通) | 1,000-5,000 | 9折 | 8.8折 | 8.6折 | 8.4折 | 8.5折 | 8.2折 | 7.9折 | 7.6折 |
| 零预付(需联系商务经理开通) | 5,000-10,000 | 8.8折 | 8.6折 | 8.4折 | 8.2折 | 8.2折 | 7.9折 | 7.6折 | 7.3折 |
| 零预付(需联系商务经理开通) | 10,000-30,000 | 8.6折 | 8.4折 | 8.2折 | 8折 | 7.9折 | 7.6折 | 7.3折 | 7折 |
| 零预付(需联系商务经理开通) | 30,000-50,000 | 8.4折 | 8.2折 | 8折 | 7.8折 | 7.6折 | 7.3折 | 7折 | 6.7折 |
| 零预付(需联系商务经理开通) | 50,000-100,000 | 8.2折 | 8折 | 7.8折 | 7.6折 | 7.3折 | 7折 | 6.7折 | 6.4折 |
| 零预付(需联系商务经理开通) | 100,000-300,000 | 8折 | 7.8折 | 7.6折 | 7.4折 | 7折 | 6.7折 | 6.4折 | 6.1折 |
| 零预付(需联系商务经理开通) | 300,000-1,000,000 | 7.8折 | 7.6折 | 7.4折 | 7.2折 | 6.7折 | 6.4折 | 6.1折 | 5.8折 |
| 零预付(需联系商务经理开通) | 1,000,000+ | 7.6折 | 7.4折 | 7.2折 | 7折 | 6.4折 | 6.1折 | 5.8折 | 5.5折 |
这张表可以纵向与横向两个方向解读。纵向看,同一月承诺金额下,周期越长折扣越低,24个月档位相对3个月档位普遍再降0.6至1.0折;横向看,同一周期下,月承诺金额越高折扣越低,全预付的100万以上24个月档位可触达全场最低的5.3折。此外,B类模型的折扣力度整体优于A类,同一档位下两者相差约0.3至0.6折。零预付方式虽然免去一次性资金占用,但折扣力度普遍比全预付低0.2至0.3折,属于以资金换折扣的权衡。
4.4 使用说明
生效时间:可按需选择"下单后立即生效"或"指定时间(按小时)生效"。
承诺周期:节省计划以动态月为周期分配额度——从购买日生效日起算,每满一个月为一个周期,非自然月月初重置;订购日次日0点重置为当月满额。月承诺周期结束时,剩余额度自动过期,不可累积到下一周期。
这一规则有两个容易被误读之处,需要特别说明:
其一,若一次性订阅了3个月的节省计划(月承诺额度1,000元),并非在3个月内获得3,000元总额度,而是每月独立获得1,000元额度,当月未使用完的部分自动清零,不可累积到下个订阅月。
其二,若选择包季套餐(如27元抵60元),总额度60元分3个月按月发放(每月20元),不一次性到账;包月套餐则一次性发放当月全额额度,仅限购买日起动态月内使用。
扣减口径:节省计划额度的扣减基于实际出账时间,而非任务提交时间。系统出账通常存在2至10分钟延迟,控制台数据刷新也存在延迟。若任务提交时账户显示仍有额度,但实际出账时节省计划已过期或额度已耗尽,仍会产生按量计费费用。建议设置较高的消费预警阈值以监控费用,避免因出账延迟导致意外欠费。
抵扣范围,分为支持与不支持两部分。
支持抵扣的范围包括:模型调用(输入和输出Tokens)、模型原生工具调用(如Function Call、网页抓取等)、上下文缓存、批量推理等产生的费用。需要注意的是,节省计划的抵扣与调用方服务器所在地域无关(包括通过ECS等实例调用百炼API的场景)。只要服务器位于国内,且调用百炼API时选择华北2(北京)地域的Base URL,产生的调用费用即可正常被节省计划抵扣,不受跨区域调用影响。
不支持抵扣的范围包括:模型调优、模型部署的费用;联网搜索插件(独立计费,以实际账单为准)、MCP广场、通义深度搜索、案例检索等插件或工具产生的费用;Qoder CN产品当前仅支持通过Credits调用,不支持使用AI通用型节省计划抵扣。第三方工具可通过API接入百炼,但相关联网搜索费用不在节省计划抵扣范围内;通过百炼API调用模型产生的费用仍属于支持抵扣范围。
知识库(RAG)费用的处理需要单独说明:知识库使用过程中产生的向量模型(Embedding)和排序模型(Rerank)调用费用,属于A类模型调用范畴,可被AI通用型节省计划抵扣;如需专项抵扣,也可单独购买向量及排序模型节省计划。知识库的规格费用(运行时长,标准版0.03元/知识库/小时、旗舰版0.2元/RCU/小时)不属于模型调用费用,不在节省计划抵扣范围内,需通过资源包或按量付费结算。
4.5 入门型AI通用节省计划
入门型AI通用节省计划是AI通用型节省计划的新客专享版本,两者的主要区别如下。
| 对比项 | AI通用型节省计划 | 入门型AI通用节省计划 |
|---|---|---|
| 购买入口 | 通过AI通用型节省计划购买页购买 | 通过AI优惠活动页的"全模型通享"模块购买 |
| 活动限制 | 无首购限制 | 活动价格仅限首购 |
| 适用模型 | 详见购买指引中的抵扣范围 | 与AI通用型节省计划支持的模型范围基本相同,但月承诺金额1000元以下(不含1000元)的档位不支持抵扣kimi-k3 |
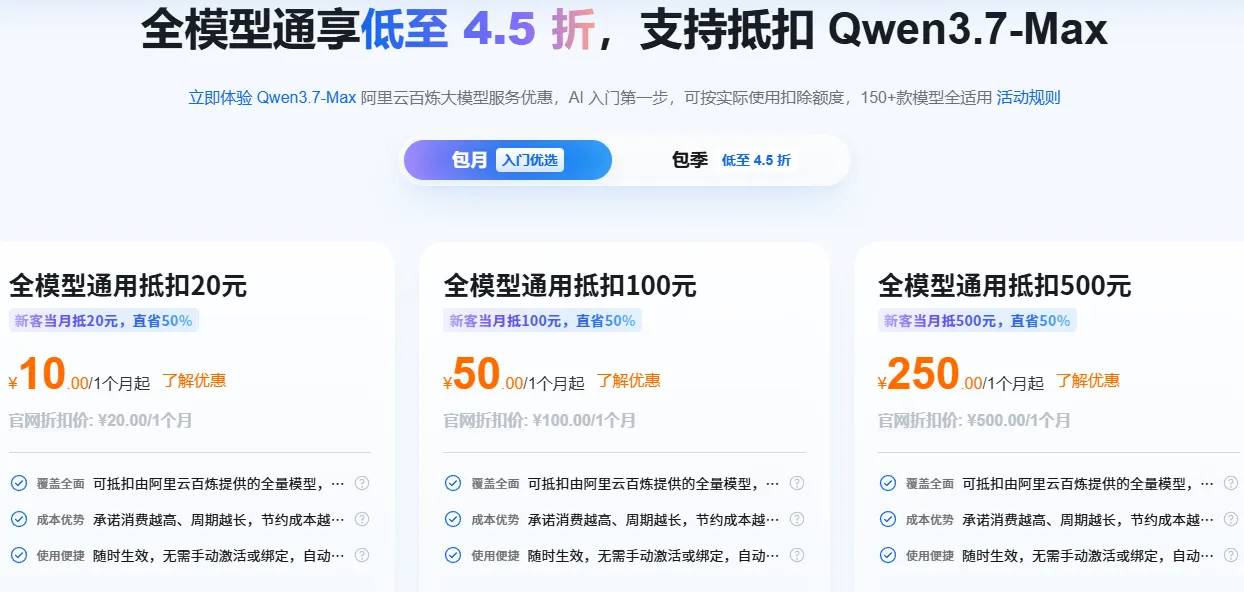
| 折扣方式 | 不同档位对应不同按量付费折扣,档位越高折扣越大 | 按量计费,无按量付费折扣;仅首次购买时有优惠,档位以购买页为准(例如:10元抵20元、27元抵60元、135元抵300元) |
入门型方案还需注意以下使用规则:
- 额度清零:每月额度按动态月独立发放,当月未使用完的部分自动清零,不累积到下一周期。包季套餐(如27元抵60元)总额度分3个月按月发放(每月20元),不一次性到账。
- 退订政策:一经支付,不支持退订,请在购买前确认档位和需求。
- 抵扣范围:与AI通用型节省计划相同,仅支持抵扣阿里直供模型产生的调用费用,不支持第三方直供模型(C类中的三方直供模型)。
- 模型限制:月承诺金额1000元以下(不含1000元)的入门型AI通用节省计划,不支持抵扣kimi-k3模型的调用费用;月承诺金额1000元及以上档位支持抵扣。
新客首月10元起,当月可抵扣20元(直省50%),覆盖千问、DeepSeek、万相、HappyHorse等全模型通兑,承诺消费越高、周期越长,节约成本越多。更多大模型节省计划详情了解:https://help.aliyun.com/zh/model-studio/savings-plan-and-resource-package
节省计划的核心逻辑是以承诺换折扣,适用于用量可预期的用户。它可与订阅制产品形成互补:订阅解决日常交互式调用的额度,节省计划则对确定性较强的消耗做成本优化。
五、AI用量加速计划:新老同享、达量后返
5.1 活动主旨与参与方式
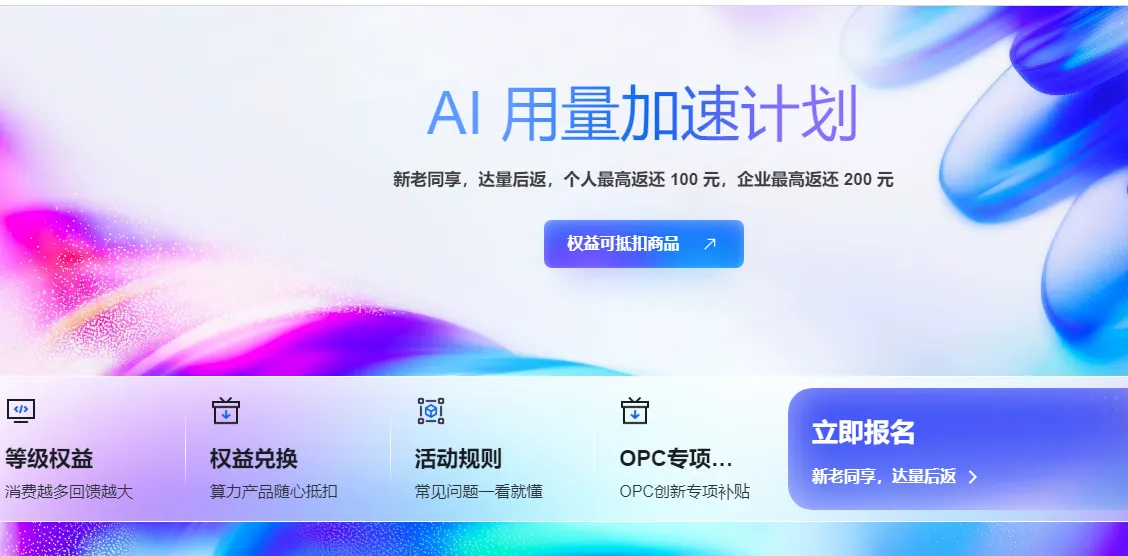
阿里云"AI用量加速计划"以"新老同享、达量后返"为核心,低至10元的月度实付门槛大幅降低了参与成本,最高档位可锁定超150元的综合回馈。返还的三重权益可直接抵扣AI编程、建站、视频创作、智能体开发等热门AI应用,覆盖全系列大模型订阅产品与云服务器算力资源,帮助不同规模的用户在日常AI开发与上云过程中系统性摊低综合使用成本。
活动设置了等级权益、权益兑换、活动规则、OPC专项四大入口模块,分别对应"消费越多回馈越大""算力产品随心抵扣""常见问题一看就懂""OPC创新专项补贴"四项服务说明,用户点击"立即报名"按钮即可参与达量后返计划。活动详情可参考:https://www.aliyun.com/benefit/client/maas
5.2 权益等级细则
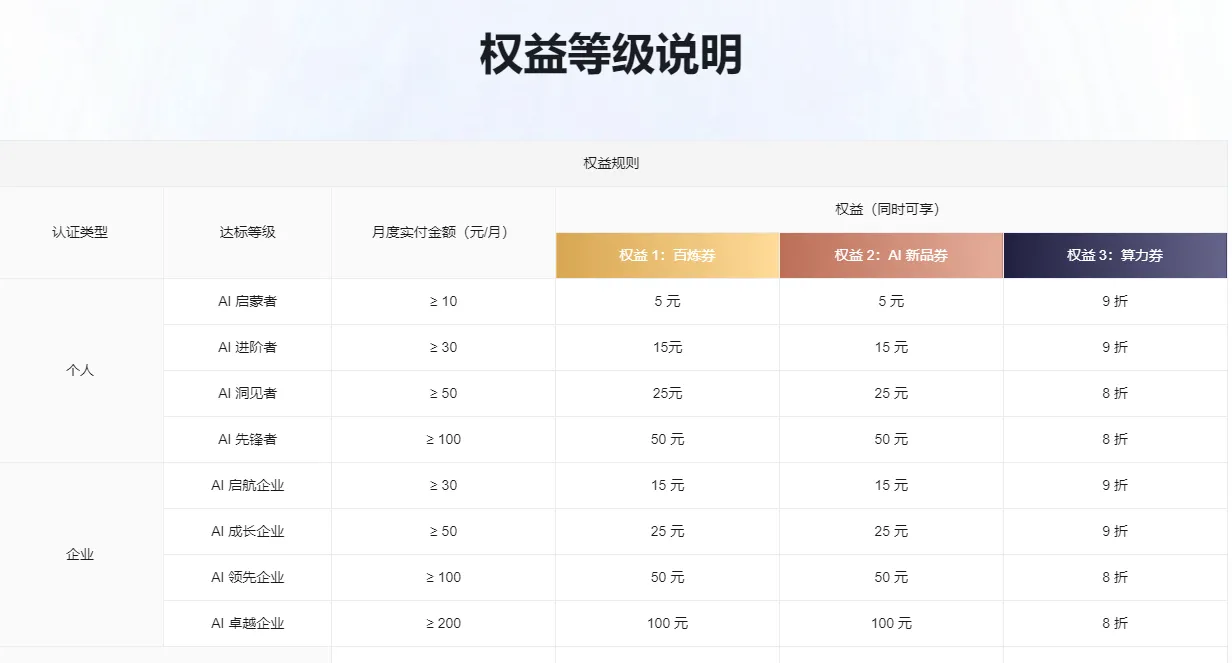
活动按照月度实付金额(元/月)划分五个达标档位,认证类型为个企同享,即个人认证与企业认证用户均可同享以下权益规则。达标后用户可同时享受三重权益:权益1百炼券、权益2 AI新品券、权益3算力券。
| 月度实付金额(元/月) | 权益1:百炼券 | 权益2:AI新品券 | 权益3:算力券 |
|---|---|---|---|
| ≥10 | 2元 | 2元 | / |
| ≥30 | 6元 | 6元 | / |
| ≥50 | 10元 | 10元 | / |
| ≥100 | 20元 | 20元 | 9折(最高50元) |
| ≥200 | 50元 | 50元 | 9折(最高50元) |
当月度实付金额达到200元档时,用户可同时获得50元百炼券与50元AI新品券,合计返还价值高达100元,这正是"次月最高返还100元"的由来;此外还可叠加享受算力券9折(最高50元)优惠,实际回馈力度超过票面价值。
5.3 达标口径与抵扣规则
达标口径方面,产品范围包含以下产品的合计实付金额:大模型服务平台百炼产品(不含百炼Coding Plan商品)与智能体应用平台;Qoder CN;万小智;万镜一刻;秒悟。金额范围为月度账单中的应付金额(应付金额=目录总价-优惠金额-优惠券抵扣金额-抹零金额)。
权益1抵扣规则:可抵产品为大模型服务平台百炼产品(不含百炼Coding Plan商品和Token Plan个人版商品)、智能体应用平台。互斥说明为本次优惠不可与其他指定营销活动、优惠券或代金券叠加使用,具体以实际页面结算为准。
权益2抵扣规则:可抵产品仅支持页面指定AI应用产品,以实际为准。互斥说明同上。
权益3抵扣规则:可抵产品为ECS和轻量服务器;补贴上限为最高50元。互斥说明同上。
发放时间:达标后次月20日前,以实际发放时间为准。
六、按用量规模组合四项权益的执行思路
把前述四类优惠放在一起看,可以按用量规模归纳出三条组合路径。
路径一:低频试水型个人开发者。 这类用户的特征是调用量不稳定、以验证想法为主。建议以Qwen3.8-Flash作为日常主力,把复杂推理任务交由Qwen3.8-Max按需兜底;计费上先使用入门型AI通用节省计划(10元抵20元档)感受折扣结构,同时报名AI用量加速计划,以最低10元的月度实付门槛获取达标返还。这套组合的优势是启动成本低、退出灵活,且能同时观察模型效果与费用曲线。
路径二:高频调用的独立开发者与小团队。 这类用户的调用已进入稳定节奏,编程与智能体工具是主要消耗口。建议优先选择Token Plan个人版的Standard档或按实际席位数量配置团队版标准坐席,以获得Credits统一计费与Harness权益;同时把可延迟的批量任务——代码仓库扫描、文档摘要、素材批量处理——统一调度到22:00至次日8:00的夜间4折时段执行。对于用量稳定且可预测的部分,再叠加AI通用型节省计划以进一步锁定折扣。
路径三:企业级规模化使用。 这类用户的关键词是确定性。建议企业先完成实名认证以解锁全部权益资格,再按业务线拆分为"稳定消耗"与"弹性消耗"两类:稳定部分交由AI通用型节省计划(可选择较长周期与全预付以争取更低折扣),弹性部分保留按量付费的灵活性;视频生成等高单价场景采用Wan3.0-Video的分辨率分级策略,用480P做草稿验证、720P做正式产出、1080P只用于成品级输出,避免高分辨率资源的无效消耗。
通用执行清单,可归纳为六条:
- 先定模型分级,再谈折扣。 成本优化的第一杠杆是选对模型——把轻量任务交给Flash,把复杂任务留给Max,比在任何单一模型上追求折扣都更有效。
- 先看时段,再看单价。 可延迟的任务一律安排在夜间折扣时段,这一步不需要任何采购动作即可完成。
- 算清动态月规则。 节省计划与订阅产品的额度均按月独立发放、当月清零,不存在跨月累积,因此承诺金额应贴近实际消耗的月度均值,而非峰值。
- 区分可抵扣与不可抵扣。 模型调优、模型部署、联网搜索插件、MCP广场等费用不在节省计划抵扣范围内,预算测算时须单独列项。
- 留意出账延迟。 节省计划按实际出账时间扣减,系统出账存在2至10分钟延迟,建议设置消费预警阈值。
- 报名先于消费。 达量后返类活动需先报名才计入达标统计周期,且达标后权益于次月20日前发放,时间节奏须纳入预算安排。
七、结语
2026年双十一期间围绕AI大模型推出的这批权益,本质上是一套分层的成本治理工具:模型分级解决"用什么",时段折扣解决"何时用",订阅制解决"怎么计费",承诺折扣解决"如何锁定"。Qwen3.8-Max与Qwen3.8-Flash构成能力与成本的两端,Wan3.0-Video以分辨率分级给出视频生成的弹性定价,Token Plan用Credits把多口径计费收敛为一个额度池,AI通用型节省计划以承诺换折扣锁定确定性支出,AI用量加速计划则通过返还机制补贴持续使用的边际成本。
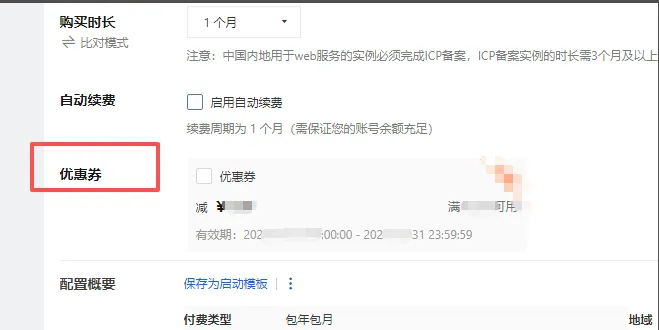
这些工具之间并非彼此替代,而是可以叠加使用的组合。真正决定最终支出的,往往不是某一次调用的单价,而是采购动作是否在做选择之前完成——是否先分级、是否先看时段、是否先报名、是否先核清抵扣范围。把这几件事前置,长期成本曲线自然会平缓下来。友情提示:购买之前,个人和企业用户均可一键领取优惠券:https://t.aliyun.com/U/a23cv1 优惠券金额不固定。折扣优惠券在结算订单时自动抵扣。
需要再次提示:所有价格、折扣、产品范围、时段与返还规则均以活动期间控制台与官方页面实时展示为准,实际下单与调用前请核对当前生效版本。