2.0 把 parent/child 的实现整个重写,
_parent默认走 doc values,但只对 2.0 及以后创建的索引生效,所以用_parent的老索引升级后功能照常、改进拿不到,要 reindex 才行。同一份迁移文档里还有两条:父类型不能先于子类型存在,top_children查询被删。本文对照 v2.4.6 源码把这三条的触发条件核了一遍。
说明
来源和边界先交代:本文的依据出自 v2.4.6 标签下的官方文件(parent_child.asciidoc、ParentFieldMapper.java、Version.java),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
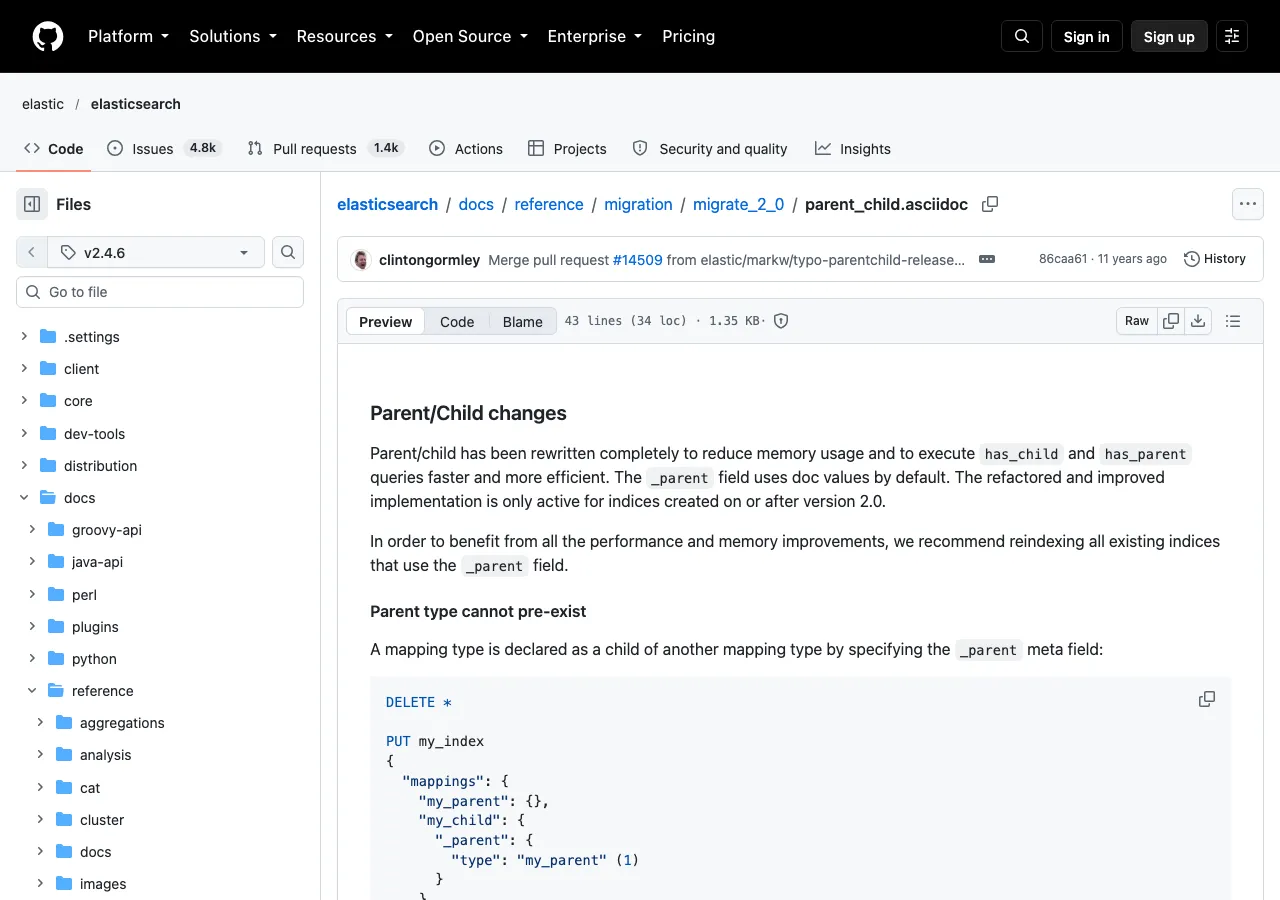
图 1:官方文件 parent_child.asciidoc(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 parent_child.asciidoc
先看官方原文
2.0 的迁移文档(parent_child.asciidoc 第 4–10 行)开头是这两段:
Parent/child has been rewritten completely to reduce memory usage and to execute
has_childandhas_parentqueries faster and more efficient. The_parentfield uses doc values by default. The refactored and improved implementation is only active for indices created on or after version 2.0.In order to benefit from all the performance and memory improvements, we recommend reindexing all existing indices that use the
_parentfield.
第三句是重点:新实现只对 2.0 及以后创建的索引生效。集群从 1.x 升到 2.x,老索引的文件不变,父子关系还是走老路径,功能正常,内存和查询上的改进拿不到。要拿到,只能 reindex。文档没有给出内存或性能的具体数字,本文也不编数字。
图 2:官方文件 MetaDataMappingServiceTests.java(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 MetaDataMappingServiceTests.java
这条迁移的风险在于升级后没有任何信号
通常的 breaking change 会报错或行为明显变化,读者马上知道要处理。这一条升级后父子查询照常返回结果,没有报错,也没有日志提示,容易被当成已经升级完成。后面发现父子查询还是慢、内存还是高,才会回头看到文档里那句 "we recommend reindexing"。
我的建议是升级 2.0 时就把这类索引的 reindex 排进计划。原因有两个:这些改进只在重建后才生效,不重建等于没有升级这部分;数据量只会增长,重建的窗口越往后越难找。
reindex 的成本也值得先掂量。父子关系解决的是"一对多、子文档需要独立更新",我的判断是:如果子文档很少变动,用 nested 或把子对象放进父文档,查询和维护成本往往更低。这是建模上的建议,本文没有做基准测试。
图 3:官方文件 ParentFieldMapper.java(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 ParentFieldMapper.java
"按创建版本生效"在源码里是什么样
迁移文档的说法可以在 v2.4.6 源码里对上。ParentFieldMapper 第 126–131 行在构建 _parent 的 mapper 时,对创建版本早于 Version.V_2_0_0_beta1 的索引,把 parent/child 两个 join 字段的 doc values 关掉:
if (context.indexCreatedVersion().before(Version.V_2_0_0_beta1)) {

    childJoinFieldType.setHasDocValues(false);
    childJoinFieldType.setDocValuesType(DocValuesType.NONE);
    parentJoinFieldType.setHasDocValues(false);
    parentJoinFieldType.setDocValuesType(DocValuesType.NONE);
}
第 281–284 行的 joinFieldTypeForParentType 对同样的条件做了同样的处理。所以"doc values 默认开启"只对 2.0 及以后创建的索引成立,老索引在同一份代码里被显式关掉。Version.java 里 1.7.0 的版本号是 1070099,2.0.0-beta1 是 2000001(Version.java 第 249、264 行),可以用来判断 index.version.created 属于哪一边。
父类型不能先于子类型存在
2.0 里,一个类型通过 _parent 元字段声明自己是另一个类型的子类型(迁移文档 第 12 行起的 "Parent type cannot pre-exist"):
PUT my_index
{

  "mappings": {

    "my_parent": {
   },
    "my_child": {

      "_parent": {

        "type": "my_parent"
      }
    }
  }
}
文档对顺序的限定是:
The mapping for the parent type can be added at the same time as the mapping for the child type, but cannot be added before the child type.
_parent 元字段文档的限制一节说得更直接(parent-field.asciidoc 第 109–111 行):_parent.type 只能指向一个还不存在的类型,一个类型在创建之后不能再变成父类型。
源码里这条校验在 MetaDataMappingService 第 269–277 行:对 2.0 及以后创建的索引,往已有索引里新增一个带 _parent 的类型时,如果它指向的类型已经存在、而且还不是任何类型的父类型,就抛 IllegalArgumentException,消息是:
can't add a _parent field that points to an already existing type, that isn't already a parent
测试里有对应的两个用例(MetaDataMappingServiceTests):先建 type,再给 child 加指向 type 的 _parent,会失败;先建 parent 和 child1,再加指向 parent 的 child2,因为 parent 已经是父类型,所以允许。
对建索引脚本的影响:如果脚本是先建好父类型的 mapping,再用 put mapping 去加子类型,会触发这个错误;在创建索引的同一个请求里同时给出父类型和子类型的 mapping,文档说明是可以的。这个限制只对 2.0 及以后创建的索引生效,条件里的 Version.indexCreated(...).onOrAfter(Version.V_2_0_0_beta1) 就是判断依据。
top_children 查询被删了
迁移文档(第 38–43 行)的原文:
The
top_childrenquery has been removed in favour of thehas_childquery. It wasn't always faster than thehas_childquery and the results were usually inaccurate. The total hits and any aggregations in the same search request would be incorrect iftop_childrenwas used.
官方给了三条理由:
- 并不总是比
has_child快; - 结果通常不准确;
- 同一个请求里的 total hits 和聚合会算错。
第三条的影响最大:不只是返回的文档不准,连总数和聚合都跟着错。用了 top_children 的查询在 2.0 里没有"先用着"的余地,要换成 has_child。这次删除没有保留兼容期,从理由看是合理的:结果错误的查询,保留比删除代价更高。
2.0 前后对照
| 项 | 1.x | 2.0 |
|---|---|---|
_parent 的 doc values |
源码里对老索引关闭 | 新建索引默认开启 |
| 新实现的生效范围 | 无 | 仅 2.0 及以后创建的索引 |
| 老索引 | 沿用旧路径 | 要 reindex 才能受益 |
| 父子相关查询 | has_child、has_parent、top_children |
has_child、has_parent |
| 父类型的定义顺序 | 无此限制 | 不能先于子类型存在 |
怎么确认索引用的是不是新实现
文档没有给判断方法,但既然新实现只看创建版本,可以直接看索引设置里的 index.version.created:
curl -s 'localhost:9200/_cat/indices?v'
curl -s 'localhost:9200/my_index/_settings?pretty' | grep version
输出里的 created 是版本号的数字形式。按上面 Version.java 的编码,2.4.6 是 2040699,1.x 创建的索引是以 1 开头的七位数,比如 1070099。创建于 2000001(2.0.0-beta1)之前的索引,父子关系是老实现,要重建。
reindex 怎么做
下面的流程把老索引的数据搬到一个新建的 2.0+ 索引。reindex 在 v2.4.6 里是 experimental,reindex 文档第 4 行标明 API 可能以不兼容的方式变化;文档开头的 IMPORTANT(第 6 行起)还写明 reindex 不会帮你建目标索引,mapping、分片数等要先自己配好。
# 1) 建新索引,父类型和子类型在同一个请求里给出
curl -XPUT 'localhost:9200/my_index_v2' -d '{
  "mappings": {
    "my_parent": {},
    "my_child": { "_parent": { "type": "my_parent" } }
  }
}'

# 2) 搬运数据
curl -XPOST 'localhost:9200/_reindex' -d '{
  "source": { "index": "my_index" },
  "dest":   { "index": "my_index_v2" }
}'

# 3) 核对数量,再切别名
curl -s 'localhost:9200/my_index/_count'
curl -s 'localhost:9200/my_index_v2/_count'
_parent 的值是从哪里带过去的
这里要纠正一种常见的担心:是不是要先把 parent id 存成 _source 里的普通字段,reindex 才带得过去。读 v2.4.6 的源码,不需要。
- AbstractAsyncBulkIndexByScrollAction 第 110–112 行的
copyMetadata从每条命中里读_parent,调用index.parent(...)设到新的索引请求上;路由在 第 127–129 行同样从_routing复制; - 命中里为什么有这两个值:FieldsVisitor 第 58–64 行的
BASE_REQUIRED_FIELDS里包含_routing和_parent,取文档时默认就会读出来。
所以按代码读,_parent 和 _routing 会被 reindex 原样带到目标索引,不依赖 _source 里有没有这个字段。这是读源码的推断,没有跑过,建议先拿一组小数据验证:reindex 之后对目标索引跑 has_child,能返回结果就说明关系带过去了。官方 reindex 文档的脚本章节(第 263 行)也把 _parent 列在脚本能修改的元数据里。
路由的约束
_parent 文档里还有一条限制:父子文档必须在同一个分片,parent ID 同时作为子文档的路由值,所以对子文档做 GET、DELETE、UPDATE 时都要带同样的 parent 值。reindex 之后写入端和读取端对 parent 的传法不能变,这是改完索引之后要核对的客户端行为。
reindex 前的准备
父子文档之间有依赖关系,动手前建议确认这几件事:
- 规模:父文档数、子文档数、平均每个父下挂多少个子,用来估时间和磁盘;
- reindex 期间的写入:如果业务还在写,期间新增和修改的文档不会自动出现在新索引里。常见的做法是新老索引双写一段时间,reindex 历史数据,切换查询后再停掉对旧索引的写入,代价是写入逻辑要改;
- 别名:用别名指向索引,切换时改别名指向,业务代码不用改,前提是所有读写都走别名,直接写索引名的代码会漏;
- 试跑:拿一个小的父子索引完整跑一遍(reindex、校验、切换),再动大的。试跑能暴露 mapping 顺序、查询改写这类问题。
重建之后怎么验证父子关系
reindex 跑完不等于完成。建议验三样:
- 计数:父文档数、子文档数和原索引一致,能发现漏文档;
- 抽样验证关系:挑几个父文档,用
has_child查它们下面的子文档,数量要对:
curl -s -XPOST 'localhost:9200/my_index_v2/_search' -d '{
  "query": {
    "has_child": {
      "type": "my_child",
      "query": { "match_all": {} }
    }
  }
}'
反向用 has_parent 也验一次;
- 对比关键查询:选几个业务上真实的父子查询,在新旧索引上各跑一次,对比返回的文档 id 集合。计数和抽样都通过,也可能出现个别子文档挂错父的局部错误,只有这一步能发现。
什么时候别用父子关系
适合的场景:一对多,且子文档需要频繁独立增删改。父子的价值在于更新子文档时不用重写整个父文档。
不太适合的场景:
- 一对多但子文档很少变动:用
nested或直接把子对象放进父文档,查询和维护都简单; - 想用它做 JOIN 出报表:ES 不是为这个设计的,放在应用层或数仓里更合适;
2.0 的重写之后,内存和查询效率相对 1.x 有改进,但 _parent 文档里列出的限制还在:父子要在同一个分片,父类型不能事后追加,对子文档做 GET、DELETE、UPDATE 要带 parent。这是选型时的取舍。
写在最后
这篇涉及三条改动:新实现只对 2.0 及以后创建的索引生效,老索引要 reindex;父类型不能先于子类型存在,put mapping 顺序写反会报错;top_children 被删,要换成 has_child。
前两条都是不报错或要到特定操作时才暴露的类型:老索引升级后功能正常、改进没拿到,建索引脚本的顺序只在用 put mapping 追加子类型时才出问题。第三条会让旧的查询请求直接失败,至少能被发现。
对"索引级"的改进,升级后要主动确认生效,不能假设升级集群版本就受益。确认的办法是看索引的元数据,这里是 index.version.created,而不是集群版本号。大版本升级后,挑几个有代表性的索引把设置打出来对一遍,这个清单不长,能覆盖"升级了但没真正生效"的情况。
参考
本文引用的原文与示例均来自本地
elasticsearch仓库v2.4.6标签下的迁移文档;未给出内存或性能的具体数字,因为原文没有提供。本文对照 Elasticsearch
v2.4.6标签的官方文档核对,引文逐字取自原文。撰写时未启动集群、未运行测试。