
先说背景:召回投诉的正确打开方式
企业知识库上线后的第一类投诉是"搜不到/搜不准"。默认处置往往是换 embedding 模型或重灌文档,二者都是高成本动作且常常不对症。本文给一条低成本诊断顺序,并在阿里云百炼命令行 bl knowledge 上用一次性知识库实测(2026-10-27,bl 2.5.0):分数对照 → chunk 取证 → 阈值联动 → 查询措辞 → 最后才是模型与文档。
诊断基座:一次性知识库
三条命令建基座:doc upload 上传一份故意含词面缺口的小文档(全文只用"忠诚度点数"、不出现"积分");create --wait 建库等导入终态;service create --scene search 建检索服务(draft/beta)。建库时定死两个旋钮:chunk-size 默认 600(建议 300-800)、embedding-model 默认 text-embedding-v4。装命令行与领 Key 见CLI 安装页与控制台密钥管理页。
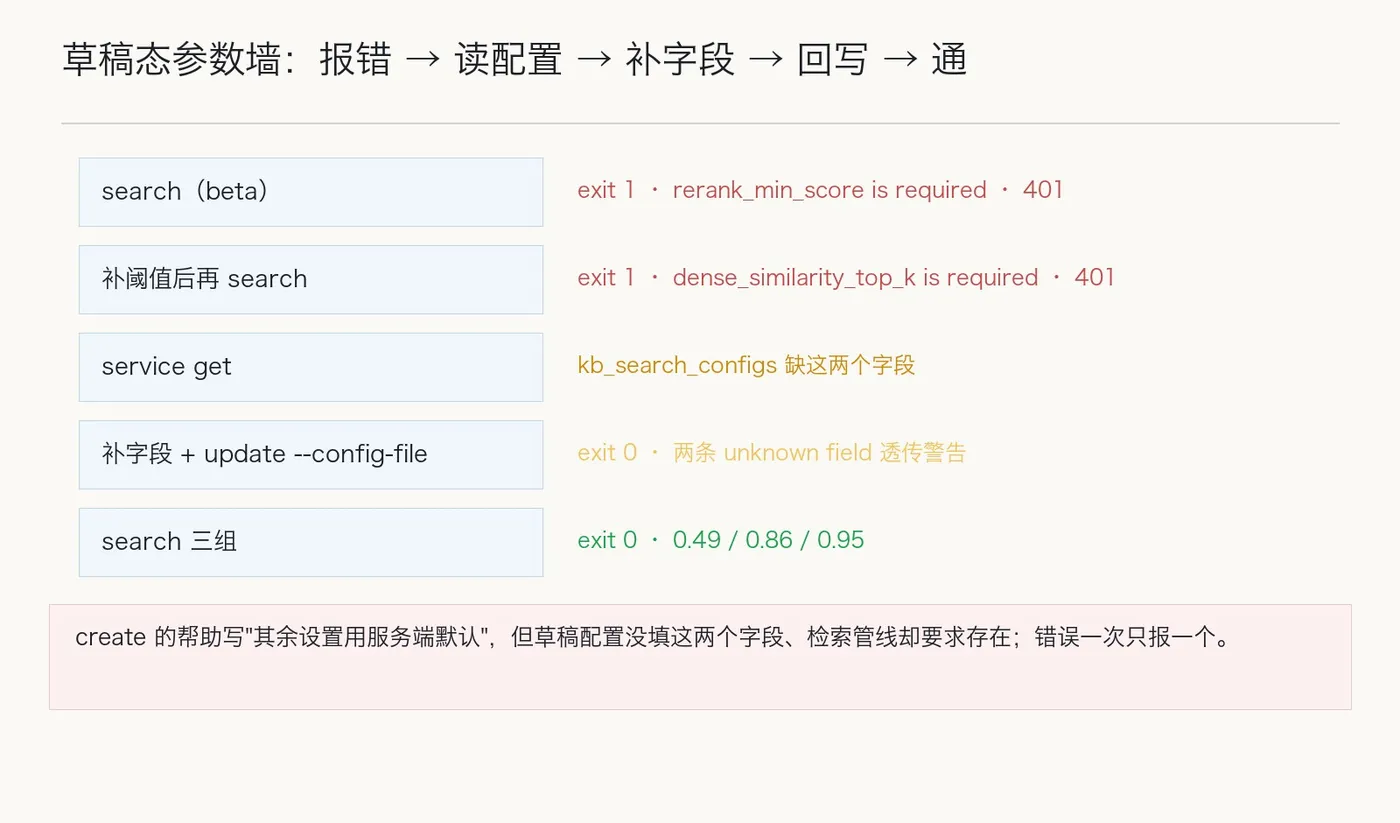
第一道环境墙:草稿态检索的参数缺失
beta 服务直接检索 exit 1:先报缺 rerank_min_score,补后报缺 dense_similarity_top_k,同状态码 401、同 InvalidParameter、逐个报。与 service create 帮助"其余用服务端默认"的表述矛盾:草稿配置 kb_search_configs 未填这两字段而检索管线要求存在。企业侧绕法固定为三步:service get 读配置 → 补字段(阈值 0.01、dense/sparse top-k 10)→ service update --config-file 回写。建议把这三步写进知识库上线 checklist,避免每个新库重踩。
分数对照:把"不准"量化成档位
同服务同 chunk 三组查询:同义词 0.4926、精确词 0.8626、数字事实 0.9497,耗时约 1 秒级。语义召回能捞回同义词(0.49 非零)但词面不命中显著压低分数;三组同 chunk 说明差异在打分而非召回集合。企业验收可据此设基线:精确词与数字事实应显著高于同义词档,若三组贴近则先查措辞与阈值而非模型。
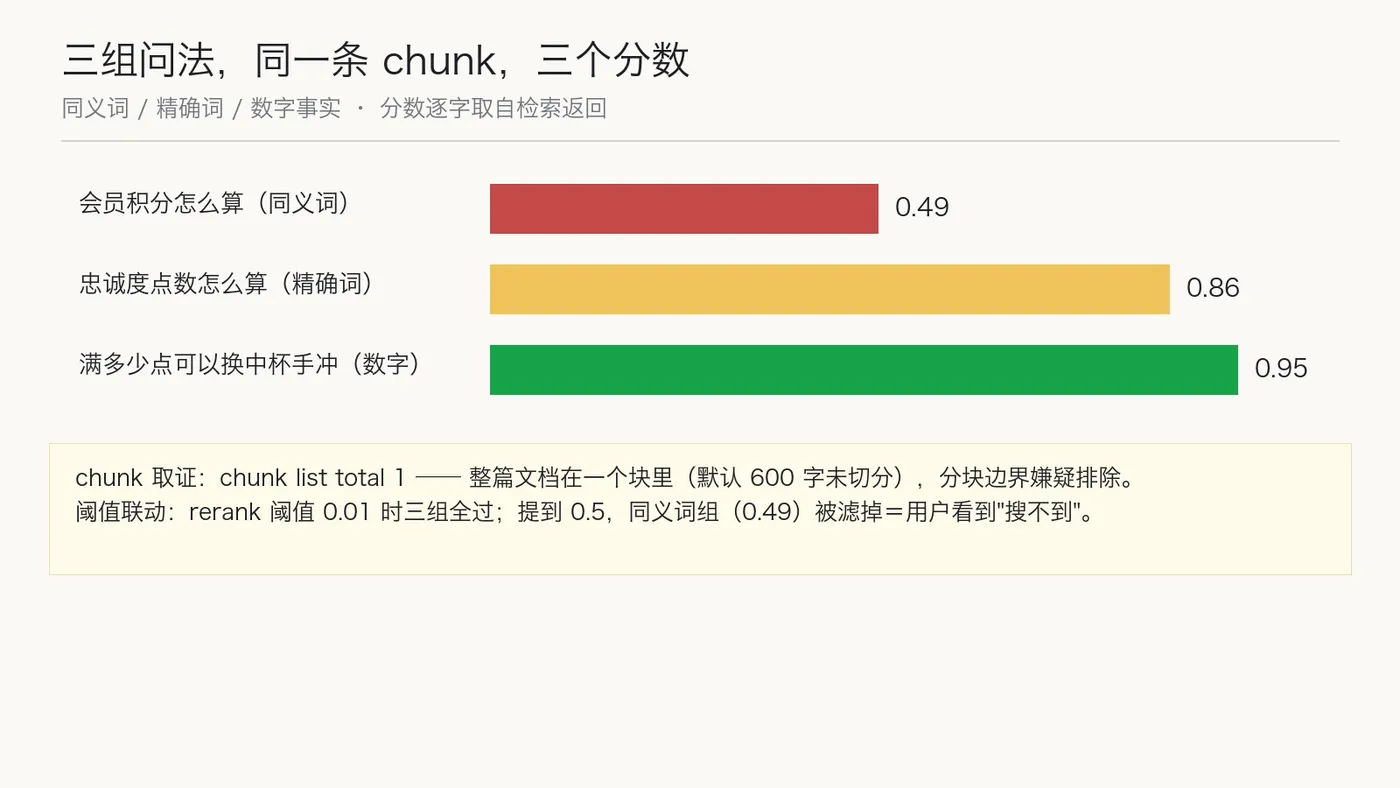
chunk 取证:排除分块边界
chunk list 显示 total 1(文档小于默认 600 字未切分),分块边界嫌疑排除。判据:仅当 chunk 多条且答案跨块、或块内噪声大时,才调整建库 chunk-size 并重建;单块完整时重建是浪费。
阈值联动:区分两种"搜不到"
库级 rerank 阈值 0.01 时三组全过;提到 0.5 则同义词组(0.49)被滤掉,用户看到"搜不到"而检索其实召回过。据此定义两种故障:召回不准=分数低但在阈值上(相关但排序/分数难看);召回不到=分数低于阈值被滤(其实召回过)。区分只需分数与阈值并排看,两条只读命令。建议把"阈值 vs 分数分布"写进监控告警的判据,而非单一命中率。
诊断顺序的管理侧意义
四步诊断(分数→chunk→阈值→措辞)全部为只读或一次性资源,可在一次投诉响应内完成;而换 embedding 与重灌文档属于重建级动作,需要排期与窗口。先诊断后排期,能把无效重建降到零,也让排期会有依据:拿着三档探针分数与阈值距离去申请重建预算,比拿着"用户说搜不到"去申请,通过率和准确度都更高。
与既有监控的衔接
若已有命中率监控,不建议替换,建议并列加一条"最低档探针分数与阈值距离"。命中率是结果指标,滞后且受流量结构影响;距离是前置指标,能在投诉之前提示阈值翻转风险。两条并列看,误报率会明显低于单看命中率。
探针基线进运维日历
建议把三组探针分数与阈值归档为季度回归基线:同义档、精确档、数字档各一条,改语料或配置后复跑对照,掉队档位触发复查。基线只读可复算,不引入额外云侧写操作;归档字段建议含分数、阈值、chunk 总数、CLI 版本与日期,缺一项对照系即不可复算。
清理四段写进诊断手册末尾
临时诊断库的治理风险不在建而在删:跳过删除与复核,临时库就变成常驻费用项与权限残留。固定四段——建(一次性资源)、测(只读+探针)、删(仅自建资源、显式确认)、复核(列表名字消失、总数回落)。本文实验按四段走完并复核净增为零;建议企业侧把四段作为诊断手册的强制末尾节,审计时以复核记录为准。
把诊断顺序写进验收标准
建议企业知识库验收标准加入四条可执行项:探针分数档位(同义/精确/数字三档应拉开且精确档显著高于同义档);chunk 完整性(答案不跨块,或跨块时已按 300-800 重建并复测);阈值-分数距离(最低档探针分数与阈值保持安全间距,间距纳入告警);参数墙过检(草稿态检索前确认 kb_search_configs 必需字段在位)。四条均为只读或一次性资源可验证,不引入额外云侧写操作。
参数墙进上线 checklist
草稿态参数墙(检索逐个索要 rerank_min_score / dense_similarity_top_k,401 InvalidParameter)应作为上线 checklist 的固定一项:service create 之后立即 service get 检查 kb_search_configs 必需字段,缺失则补字段并经 config-file 回写,再进入验收。把墙放在 checklist 而非排障文档里,是因为它发生在"库刚建好、还没人用"的窗口期,越早过越便宜。
旋钮清单与治理建议
CLI 可达旋钮四类:建库时 chunk-size 与 embedding-model;服务侧 rerank 阈值/top-k(经 config-file);调用侧查询措辞与 --agent-version;其余建库时定死。治理建议三条:把参数墙三步写进上线 checklist;把分数档位基线写进验收;把阈值-分数联动写进告警判据。
边界
单文档单 chunk 单次运行,非基准;不评价模型优劣;不引 workspace 库总数(隐私)。实验资源自建自删、删除后复核净增 0;删除类命令仅对自建资源且显式确认。检索费用与额度不在本文口径内,以官方文档为准。控制台入口见阿里云百炼。


