9.1 加了
SAMPLE聚合函数,作用是从字段里取若干个样例值。它不解决复杂问题,但有一类场景特别合适:你想知道"这个字段里到底装的什么",而不想先跑一次去重统计。
说明
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.1.0.yml、sample.md、sample.md),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
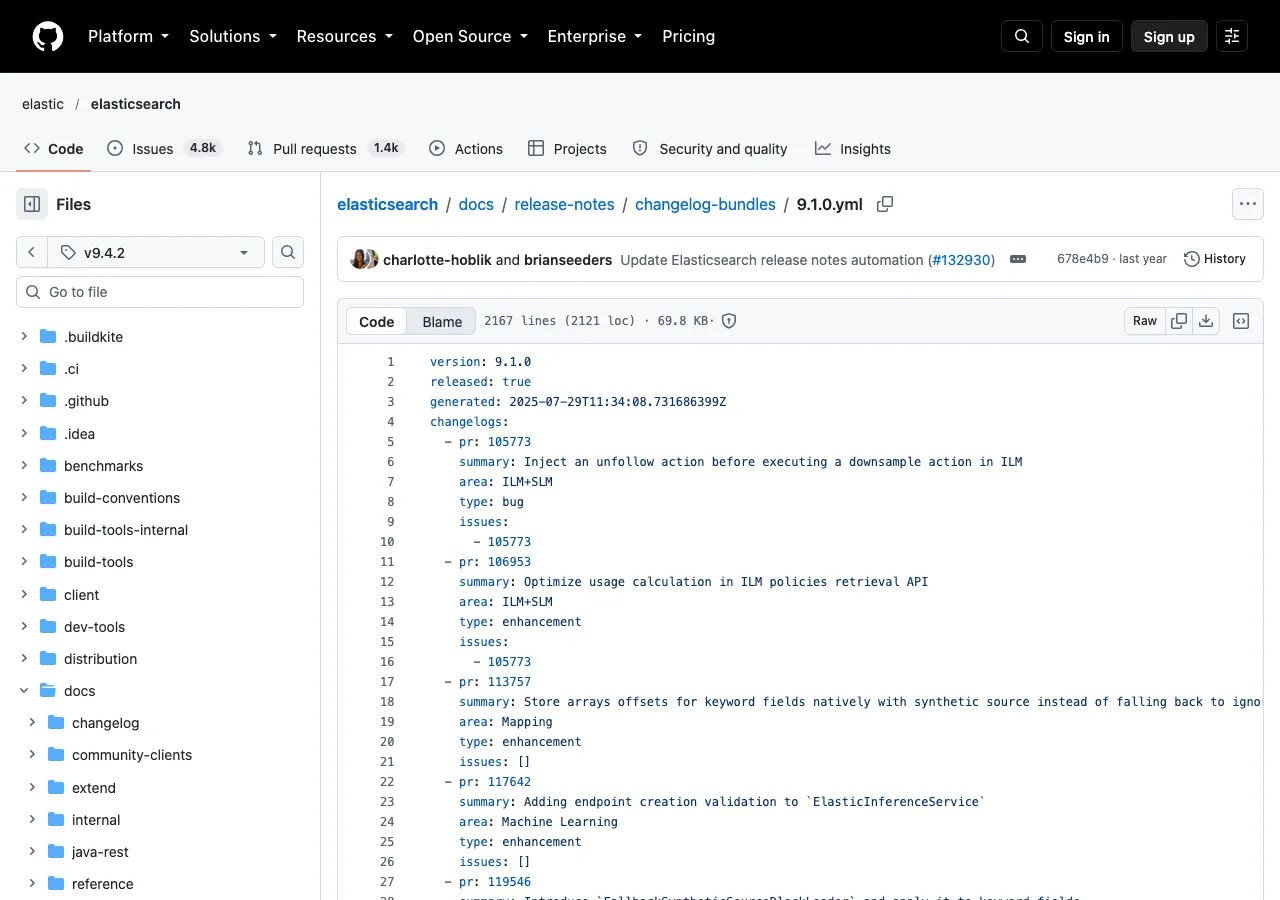
图 1:官方文件 9.1.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.1.0.yml
官方条目
9.1 的 changelog 标为 feature(9.1.0.yml 第 1404–1407 行 @ v9.4.2),area: Machine Learning,PR 127636。
只有一行 summary,没有 details。好在函数有独立文档,下面按文档和源码核。
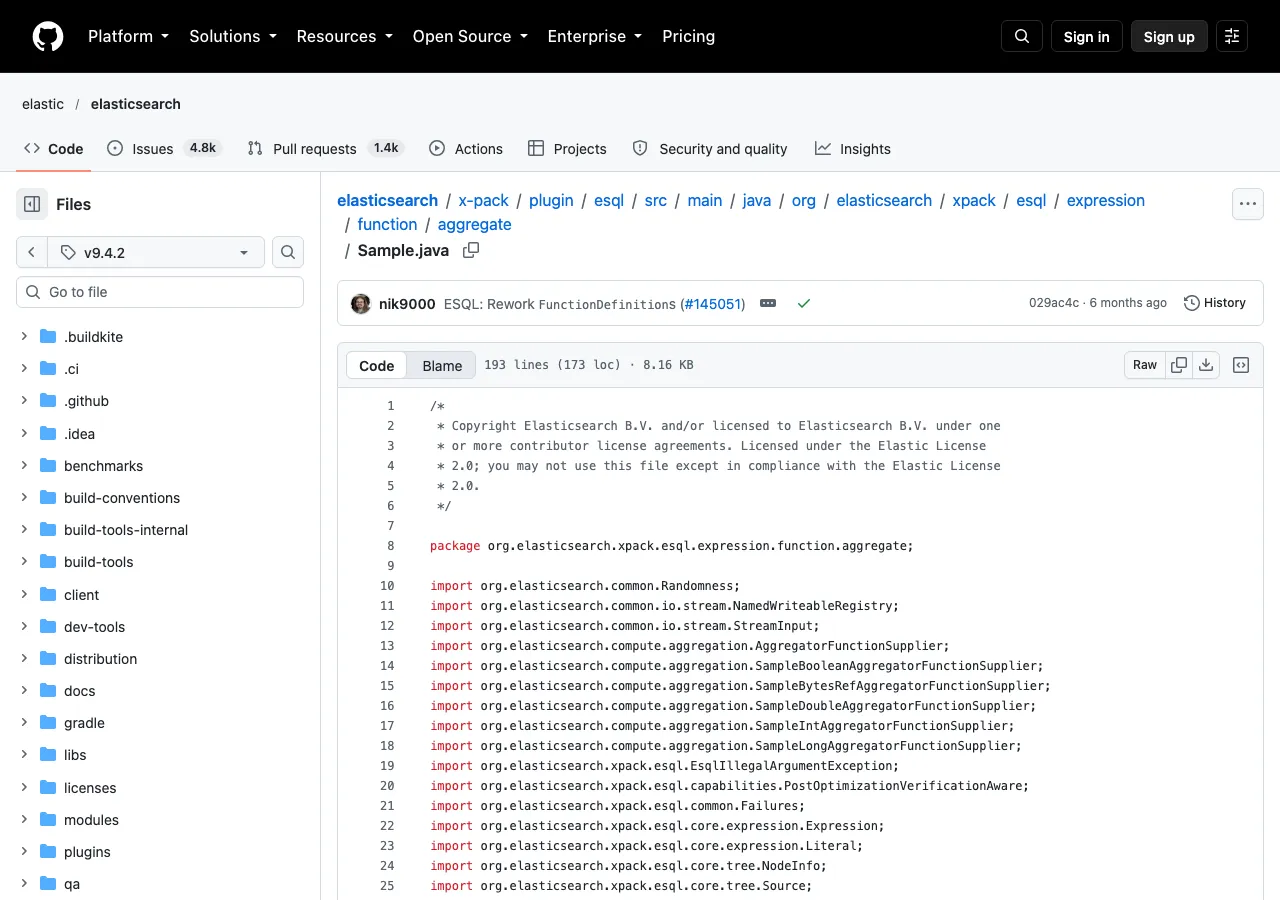
图 2:官方文件 Sample.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 Sample.java
函数做什么
官方描述(functions/description/sample.md @ v9.4.2):
Collects sample values for a field.
收集一个字段的样例值。 一行话,没有更多解释。
官方示例(functions/examples/sample.md @ v9.4.2):
FROM employees
| STATS sample = SAMPLE(gender, 5)
返回:
| sample:keyword |
| --- |
| [F, M, M, F, M] |
两个参数很清楚:
- 第一个是要取样的字段;
- 第二个是要取几个(
5)。
返回的是一个数组(多值字段),不是单值。
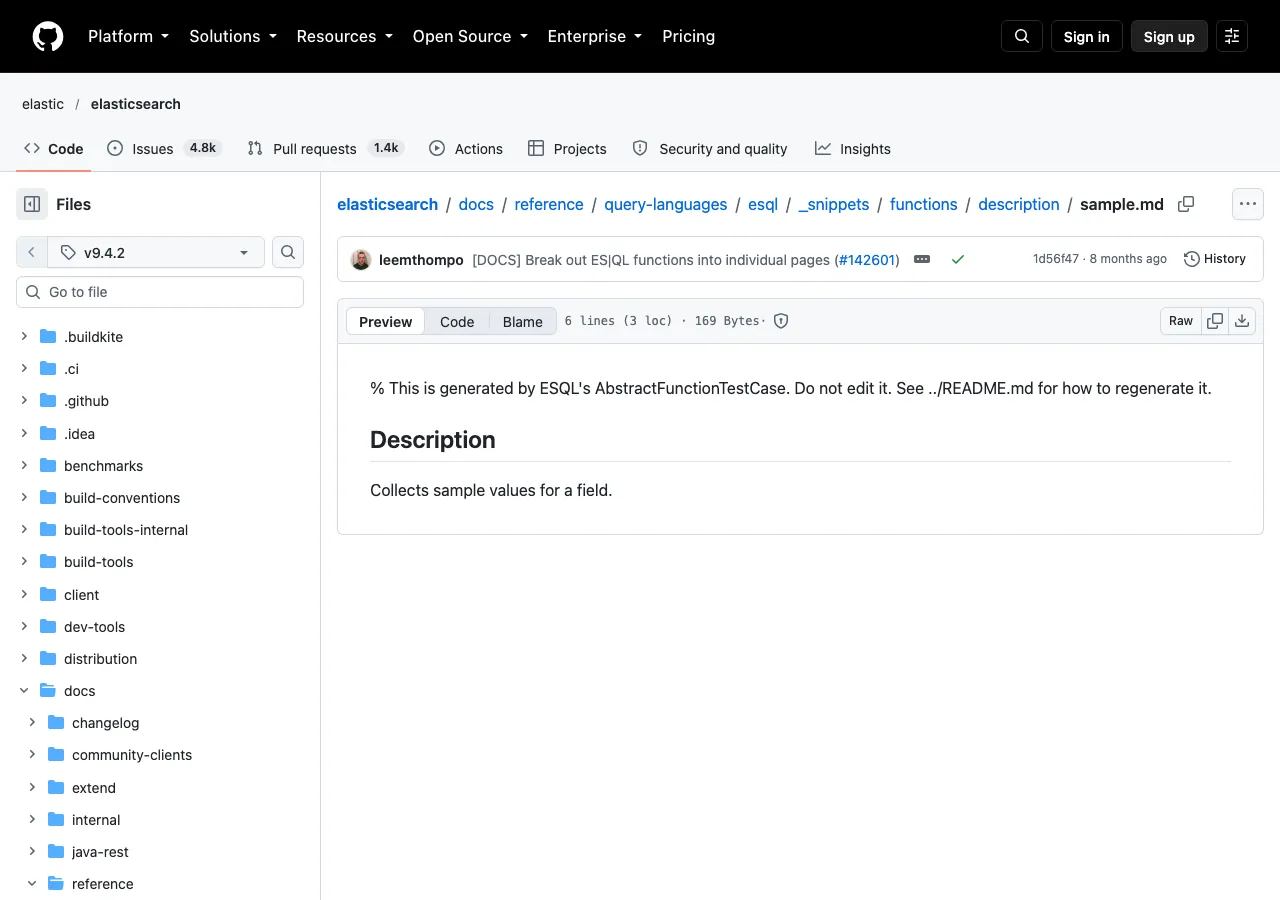
图 3:官方文件 sample.md(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 sample.md
它解决什么问题
按理解,这个函数的定位是快速了解字段内容。
典型场景:你接手一个不熟悉的索引,想知道某个字段里装的是什么形态的数据。以前的做法有几种:
VALUES或 terms 聚合——拿到所有去重值。问题是如果基数很高,结果会很大,而且聚合本身有开销;LIMIT几条文档——直接看原始数据。问题是看到的不一定有代表性,前几条可能恰好都相同;CARDINALITY——只知道有多少种,不知道是哪些。
SAMPLE 提供的是第四种:取 N 个值看看。它不保证覆盖全部,也不保证均匀,但足够让你有个印象。
和 VALUES 的区别
这是最该说清楚的一点,两者容易混淆:
SAMPLE(field, N) |
VALUES(field) |
|
|---|---|---|
| 返回数量 | 固定 N 个(或少于 N) | 全部去重值 |
| 去重 | 不一定(见下) | 是 |
| 基数高时 | 结果可控 | 结果可能很大 |
| 用途 | 看个大概 | 要完整清单 |
关键区别是数量可控。SAMPLE 你说了要 5 个,最多就返回 5 个;VALUES 有多少返回多少,可能几万条。
所以判断是:
- 只要"看看长什么样" →
SAMPLE; - 要完整的取值清单(比如做枚举、生成下拉选项) →
VALUES。
示例里的重复值是怎么来的
示例返回的是 [F, M, M, F, M]——有重复(F 出现两次,M 三次)。
这个示例暗示 SAMPLE 不去重。也就是说它取的是"5 个值",不是"5 个不同的值"。
但这点无法确定,理由有两条:
- 示例只有一条,样本太小,也可能是恰好取到了重复;
- 文档描述只说 "Collects sample values",没说是否去重。
如果你依赖"取到的是不同的值",我的建议是实测确认。做法很简单:在一个已知基数很小的字段上跑,看返回值有没有重复。
(文档没写清的边界,跑一次就知道,别猜。)
什么时候用它最合适
适用场景说具体一些,因为它不是"任何时候都能用"的通用聚合。
适合:
- 接手陌生索引时的第一轮探索。想知道某个字段的形态(是枚举值?是自由文本?是数字还是字符串?),跑一次
SAMPLE比翻 mapping 直观——mapping 告诉你类型,样例告诉你内容。 - 排查数据异常。怀疑某个字段有脏数据(比如该是数字的地方混进了字符串、该是枚举的地方出现了意外值),采样几条看看比全量扫快。
- 文档量极大时的快速预览。几亿条文档上跑
VALUES可能很慢或者结果爆炸,SAMPLE(..., 10)的开销小得多。
不适合:
- 要完整取值清单——用
VALUES; - 要精确统计——采样结果不能当统计用;
- 要写进测试断言——结果不稳定。
它主要用在人工排查而非程序逻辑里。这是个"给人看"的函数,不是"给程序用"的。
为什么要有这个"给人看"的函数
顺着上面再想一层:ES 已经有那么多聚合函数,为什么还要加一个功能上"不那么严谨"的采样?
理解是:探索和验证是两个不同的动作,以前只有后者的工具。
- 验证("这个字段是不是只有这三种值")→
VALUES、CARDINALITY,精确; - 探索("这个字段装的什么")→ 以前没有专门工具,只能拿验证类的工具凑合。
拿 VALUES 做探索的问题是开销和结果量都不可控——你只是想看一眼,它却把几万个值都算出来了。
SAMPLE 填补的是这个空档:明确告诉你"这只是抽样,别当真",换来的是快和可控。
我的判断是这个取舍是对的:工具应该诚实地表明自己的精度——一个"看起来精确但实际是抽样"的函数才危险。
源码里的一个细节
Sample.java 里有段注释值得看(第 111–112 行 @ v9.4.2):
 * samples of size N. The uuid is used to ensure that the optimizer does not optimize both
 * expressions to one, resulting in identical samples.
大意是:用了一个 uuid,防止优化器把两个相同的采样表达式合并成一个,导致拿到相同的样本。
这段话透露了两个信息:
- 采样是随机的(否则不需要担心"相同"的问题);
- ES|QL 的优化器会把写法相同的两个表达式合并成一个——这是个通用优化,本来是好事(省一次计算),但对采样这种"每次要不同结果"的场景就有问题了。
用 uuid 区分是绕过这个优化的办法。
对使用者的实际影响:如果你在一条查询里写两个一模一样的 SAMPLE(x, 5),拿到的不是两组独立样本——除非有这个 uuid 机制。按注释的说法,uuid 已经解决了这个问题,所以两个 SAMPLE 应该能得到不同结果。
(说明:这段是读注释得出的,未实测两个 SAMPLE 的实际行为。需要的话自己跑一次。)
采样随机的含义
既然是随机采样,有两个后果要知道:
一,结果不保证稳定。 同样的查询跑两次,可能返回不同的值。这在做回归测试时要注意——不要把 SAMPLE 的结果写进断言。
二,不保证代表性。 它是采样,不是全量统计。样本量小的时候,可能碰巧没覆盖到某些值。所以不能拿它下"这个字段只有这几种值"的结论。
第二条尤其要提醒:SAMPLE(x, 5) 返回 5 个 M,不代表这个字段只有 M——可能只是恰好抽到了 M。想知道有哪些值,用 VALUES 或者 CARDINALITY。
和别的新函数放一起看
9.x 在 ES|QL 上投入很大,前面写过好几个新函数:
| 条目 | 函数 | 用途 | |
|---|---|---|---|
| ES\ | QL 的 SCORE() | SCORE() |
给单个条件打分(分析相关性) |
| QSTR 的可选参数 | QSTR 的 options |
调整查询串行为 | |
| 本篇 | SAMPLE() |
看字段内容 | |
| ES\ | QL 的 dense_vector | dense_vector 类型 |
向量作为一等类型 |
共同点是把原本要换个工具做的事,放进 ES|QL 里——SCORE 替代部分 _explain 的用法,SAMPLE 替代"先跑一次聚合看看"。
这个方向是对的:排查和探索类操作不该要求你切换工具。能在原查询里加一行解决的,比开另一个 API 方便得多。
怎么验证"是否去重"
前面说了未确认它去不去重,这里给出具体的验证办法——这是个通用做法,对任何"文档没写清"的函数边界都适用。
第一步:找一个已知基数很小的字段。 比如状态字段,你知道它只有 3 种值。
第二步:取一个远大于基数的 N。
FROM my_index
| STATS s = SAMPLE(status, 20)
第三步:看返回值里有没有重复。
- 有重复 → 不去重(取的是 N 个值,不是 N 个不同的值);
- 无重复且长度小于 20(等于实际基数)→ 去重,或者说"最多返回 min(N, 基数) 个不同的值"。
这个测试一分钟就能做完,结论明确。比看文档猜可靠。
同理可以验证随机性:同一条查询跑两次,比较结果。相同不代表不随机(小样本可能碰巧一样),但不同就一定能确认它是随机的。
把这类做法写下来,是因为写技术文章时经常遇到"文档没说清"的情况——给读者一个验证方法,比给一个不确定的结论更有用。
写在最后
这个函数很小——取 N 个值,一行话能说完。
这条值得写是因为它属于"排查效率"那一类工具:不改变任何功能,但让你少走几步。这类改动在阅读 changelog 时最容易被跳过("就这?"),但实际用起来会发现省事。
一,SAMPLE(field, N) 取 N 个样例值,返回数组。 数量可控是它相对 VALUES 的优势——VALUES 有多少返回多少,SAMPLE 你说几个就最多几个。
二,结果可能不稳定、不保证代表性。 不要写进回归测试断言,也不要用它下"字段有哪些值"的结论——那是 VALUES 和 CARDINALITY 的活。它是给人看的,不是给程序用的。
三,随机的。 源码注释里用 uuid 防止两个相同采样被优化器合并,说明每次采样是独立的。想要可复现的结果,这个函数给不了。
另外诚实标注了两点未确认的:是否去重(示例暗示不去重,但未实测),以及两个相同 SAMPLE 的实际行为(按注释推断应该不同,但未验证)。要用就跑一次确认。
参考
- changelog 9.1.0:ES|QL SAMPLE aggregation function(第 1404–1407 行)@ v9.4.2
functions/description/sample.md:函数说明 @ v9.4.2functions/examples/sample.md:官方示例(SAMPLE(gender, 5))@ v9.4.2Sample.java:uuid 防止优化器合并相同采样的注释(第 111–112 行)@ v9.4.2- PR 127636
本文对照 Elasticsearch
v9.4.2标签的 changelog、函数文档与源码核对,引文与代码逐字取自原文。"SAMPLE 是否去重"根据官方示例的返回值推断,未实测;"两个相同 SAMPLE 返回不同样本"依据源码注释推断,也未验证,两处均已在正文标注。撰写时未启动集群、未运行测试。