
摘要:GitHub在2026年10月公开说明,开发者与Agent并发工作、仓库每天承载海量提交,正在推动Git基础设施重构。对测试团队来说,新增风险不仅是“AI代码有Bug”,还包括引用失效、基线漂移、合并排队和缓存不一致让测试证据本身失真。
GitHub Engineering在2026年10月6日发布文章,明确把开发者与Agent在同一仓库并发工作、每天数百万次提交描述为下一轮架构压力,并说明正在一边运行、一边重建Git基础设施。文章讨论的是GitHub自身公开的工程方向,不等于所有团队都已出现同样规模的事故。
把这个变化放到测试现场:昨晚回归基于提交A通过,早上三个Coding Agent分别修改依赖、生成测试、重写配置,合并队列又重排了基线。失败截图仍在,但它对应的代码树、依赖和测试选择已经不是当前候选版本。问题不再只是跑得慢,而是“这份通过证据究竟证明了谁”。
旧回归默认了一个正在消失的前提
传统流水线默认提交节奏相对可控:开发推送、CI构建、测试出结果、合并。Agent并发后,同一时间可能产生更多分支、短命提交和自动重写。队列等待变长,测试结果返回时,基线可能已经变化。
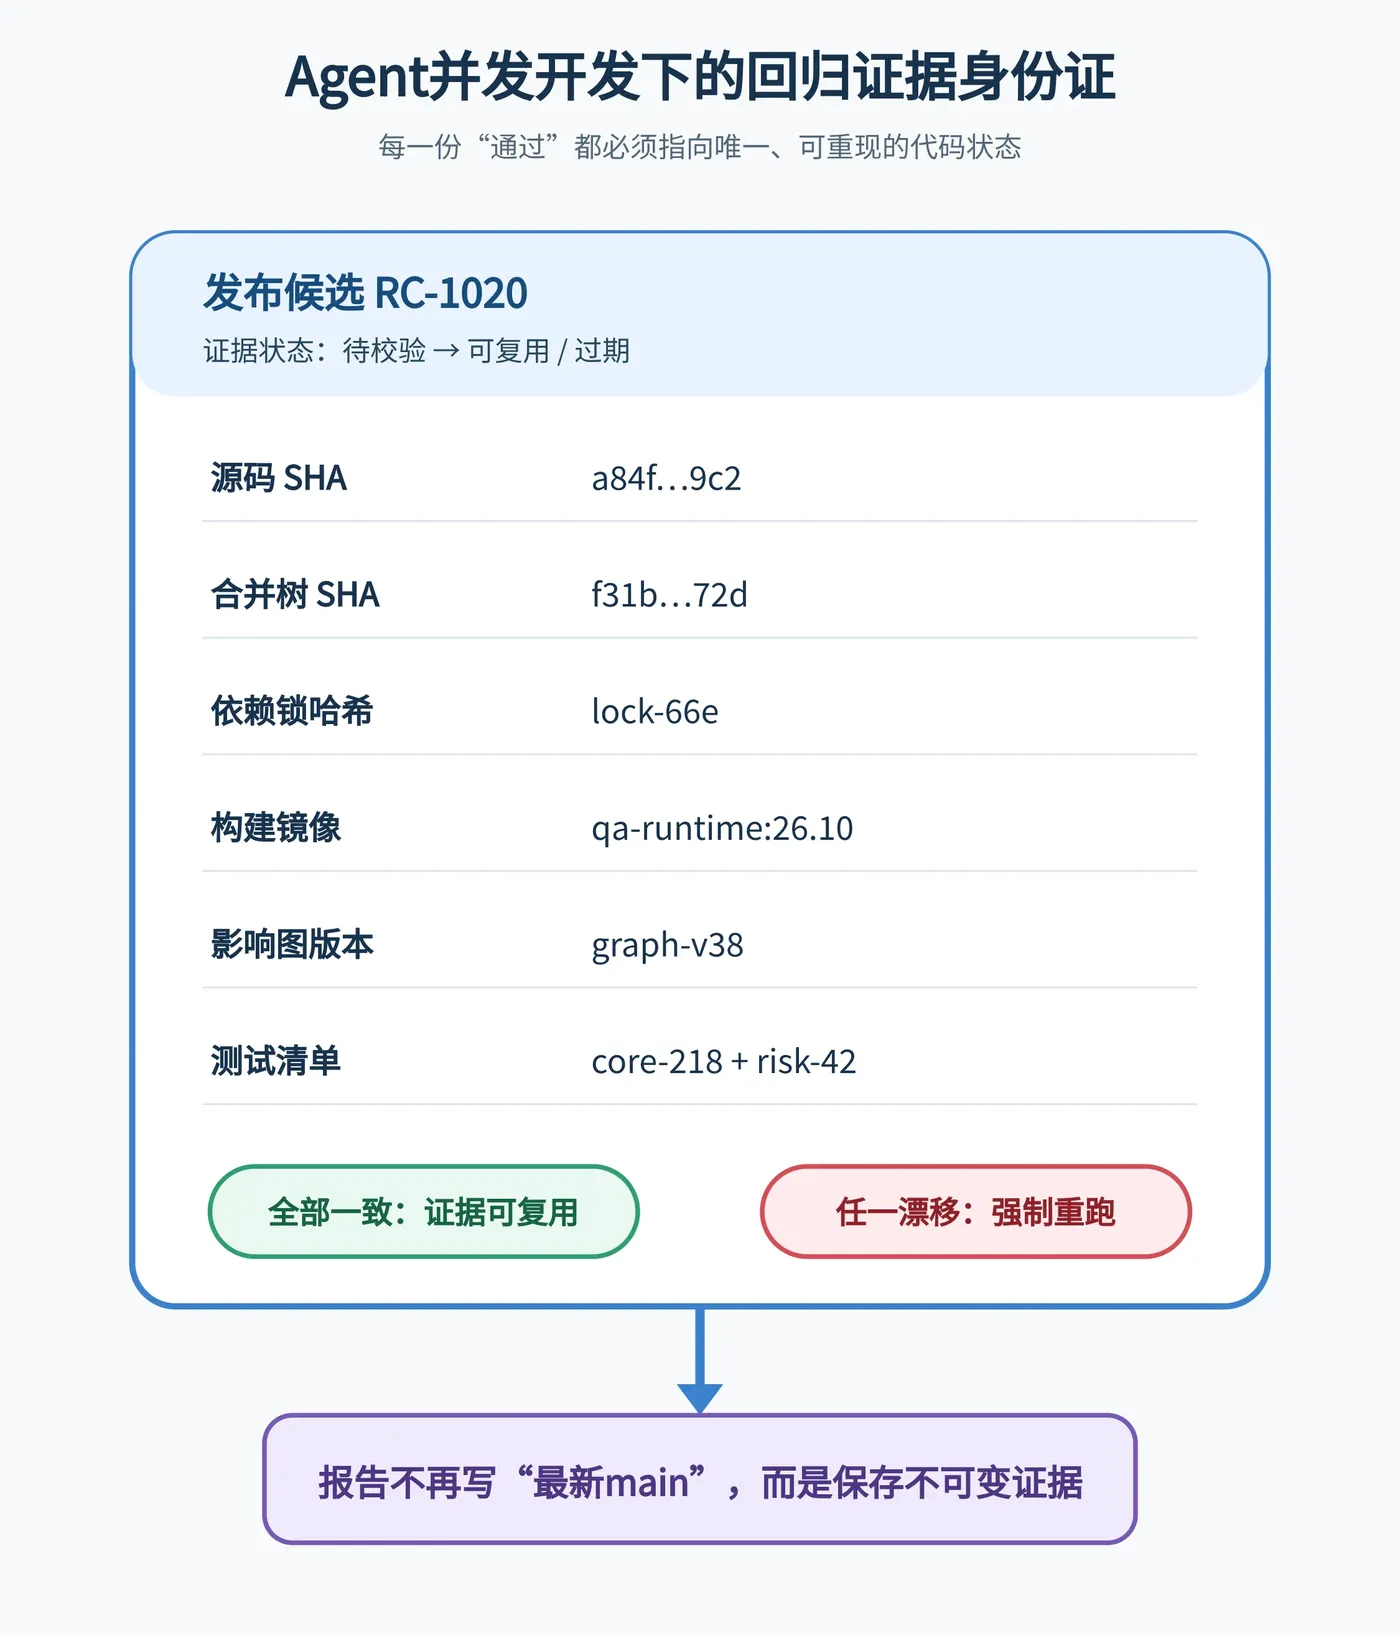
因此要区分三个标识:被测提交、目标基线、实际生成的合并树。只保存分支名或“最新main”不够,报告必须记录不可变SHA、依赖锁文件哈希和测试环境镜像。否则一次通过很容易被错误复用。
| 风险 | 表面现象 | 应记录的证据 | 门禁 |
|---|---|---|---|
| 基线漂移 | 旧结果覆盖新提交 | source SHA、merge SHA | SHA不一致重跑 |
| 缓存污染 | 不相关失败或虚假通过 | cache key、依赖哈希 | 锁文件变化失效缓存 |
| 选择遗漏 | 只跑了错误子集 | diff、影响图、测试清单 | 高风险目录强制全量 |
| 并发冲突 | 单分支通过、合并后失败 | 合并树、队列顺序 | 合并树复验 |
回归策略要从“按提交跑”改成“按证据有效期跑”
最快的检查可以在分支上执行,但它只能证明局部修改没有明显问题;合并前必须基于真实合并树跑关键集。依赖、权限、数据库迁移、构建脚本等高影响文件一旦改变,早先缓存的测试结果应自动失效。
Agent生成的测试也不能天然成为独立证据。如果代码和测试由同一上下文产生,它们可能共享误解。关键业务契约要来自独立规则或历史缺陷集;变异测试可以检查新增单测是否真的能杀死错误实现。
def evidence_is_reusable(result, candidate):
    return (
        result["source_sha"] == candidate["source_sha"]
        and result["merge_sha"] == candidate["merge_sha"]
        and result["lock_hash"] == candidate["lock_hash"]
        and not candidate["touches_high_risk"]
    )
这段判断没有优化测试速度,而是先防止错误复用。只有证据身份明确,后续的并行、缓存与智能选测才有意义。
测试团队可以先做的四件事
第一,给每份报告补齐三元组:源码、合并树、环境。第二,为缓存建立可解释失效规则,不只看文件名。第三,把Agent提交单独统计,包括提交频率、重写率、回滚率和队列等待。第四,对“代码与测试一起生成”的变更增加契约审查或变异检查。
GitHub公开的是平台级架构重构,不是现成的测试方案。本文的工程推断是:Agent规模开发会先放大证据身份和并发一致性问题。测试团队真正要守住的,不是让流水线追上每个提交,而是保证每个放行结论都指向唯一、可重现的代码状态。
三个容易被忽略的并发故障
第一个是生成物漂移。两个Agent基于同一基线修改依赖,分别提交新的锁文件。单独运行都通过,合并后解析出的版本组合却从未被测试。用例要模拟锁文件并发变化,并强制在最终合并树重新安装依赖,而不是复用分支环境。
第二个是测试选择竞争。智能选测根据Diff决定子集,但另一个并发提交改变了调用图。若影响分析使用旧图,新合并树会漏掉真正相关的测试。报告应记录影响图版本;目标基线改变时重新计算选择结果。高风险目录不能完全依赖动态选测。
第三个是结果乱序。较早提交的慢任务晚于新提交返回,控制台若按“最后完成”覆盖状态,就可能把旧绿灯显示在新版本上。测试平台要把结果与不可变提交绑定,并在界面明确显示已过期,而不是简单隐藏。
建立一张证据账本
每次候选发布保存:源码SHA、合并树SHA、父提交、依赖哈希、构建镜像、测试清单、测试代码版本、数据快照、开始与结束时间。九个字段看起来繁琐,但它们能回答复盘中最常见的三个问题:测的是哪份代码,用的是什么环境,为什么当时允许合并。
证据账本还应描述“为什么没有跑某些测试”。如果因为影响分析跳过,要保存规则与输入;如果因为资源不足取消,要标成证据缺失,不能等同通过;如果沿用旧结果,要记录复用条件。缺失原因往往比通过数量更能暴露风险。
资源有限时怎么排队
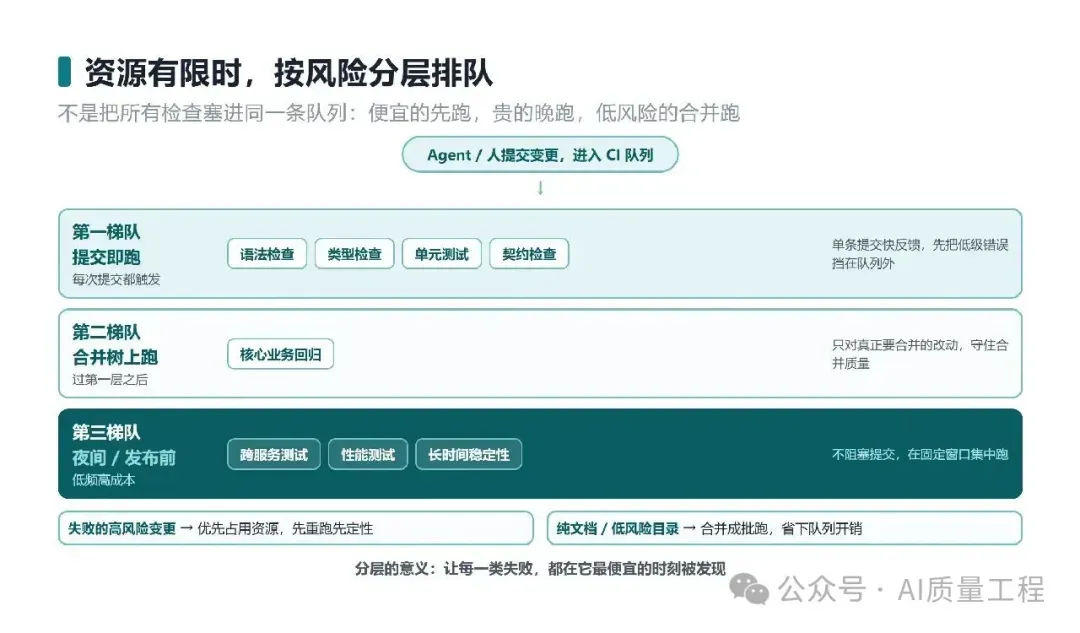
Agent增加提交后,最直接的反应可能是无限扩容CI,但成本会迅速上升。更合理的是按风险分层:语法、类型、单元和契约检查先跑;合并树上的核心业务集次之;跨服务、性能和长时稳定性进入夜间或发布前。失败的高风险变更优先占用资源,纯文档或低风险目录可以合并批次。
批量合并也有代价:一组提交失败时,定位范围变大。队列策略要在吞吐与可诊断性之间选择,测试团队可以用“平均等待、重跑次数、失败定位时间、过期结果比例”四个指标观察,而不是只追求总执行时长下降。
Agent生成提交还要加来源标签
机器提交并不天然更差,但其生成上下文和修改范围应可追踪。记录使用的Agent、任务描述、基础提交、是否由人修改、是否同时生成测试。发现缺陷后,团队才能判断是需求解释、工具权限、合并策略还是实现能力问题。
最后做一次混沌演练:同时创建多个分支,故意让依赖、测试选择图和合并顺序变化;注入缓存命中、队列取消和结果延迟;检查平台是否仍能把每个结论绑定到正确树。能扛住这组实验,才说明回归系统开始适应Agent规模,而不是只在理想串行流程中工作。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。

