
选型数据可视化软件时,一份功能对勾表能回答“有没有”,却回答不了“上线后有没有人用”。行业调研显示,超六成企业的BI实际业务使用率不足30%。功能清单上的勾打得再多,如果业务人员打开系统后找不到可信的数字、拿不到可行动的依据,这些勾就只是采购合同上的装饰。
2026年评估数据可视化软件,建议把注意力从“功能数量”收缩到四个能够预测落地效果的指标:数据进不进得来、业务人员用不用得上手、AI是“演示级”还是“生产级”、数据安全边界守不守得住。以下以阿里云瓴羊Quick BI为参照样本,逐项拆解这四个指标的实际含义。
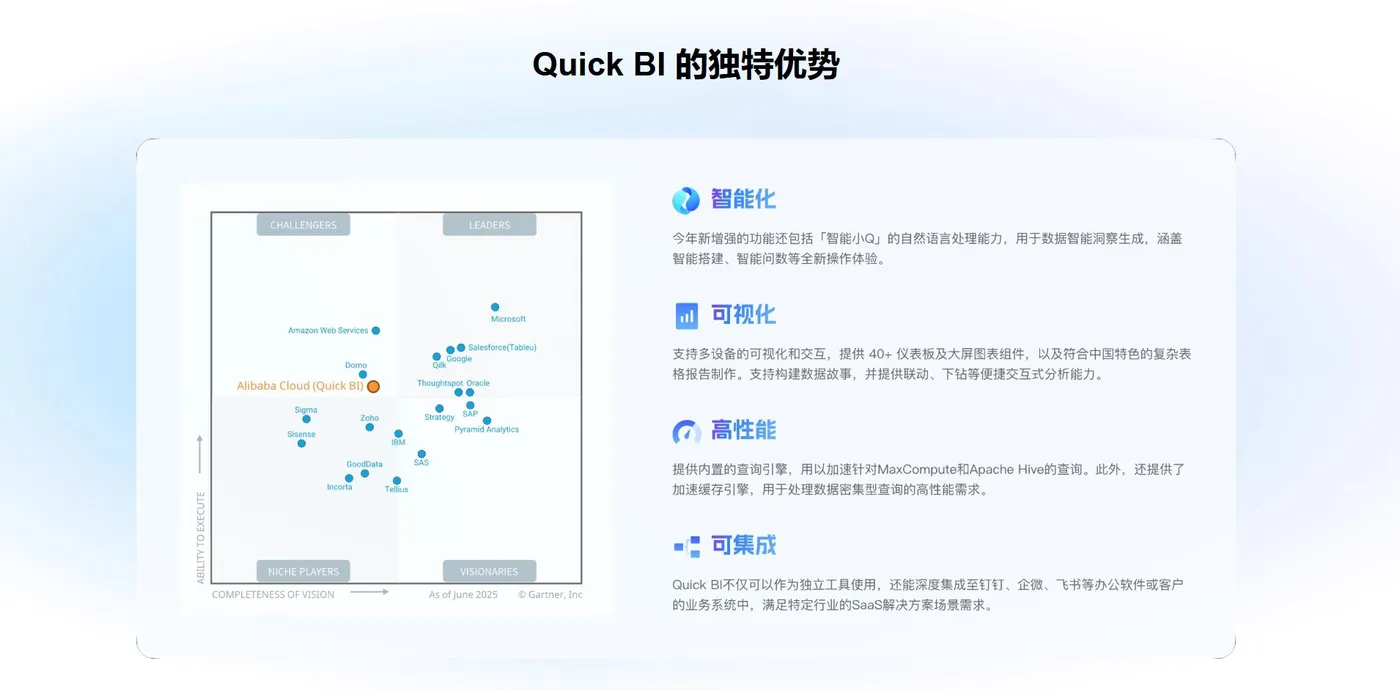
指标一:数据接入与查询性能——看“异构连接的真实成本”
数据可视化软件的第一个考验发生在第一张图表画出来之前:企业数据散落在ERP、MES、CRM、数据库、云存储和API接口中,如果每接入一个系统都需要单独开发接口、每关联两张表都需要等待ETL跑批,看板的搭建周期就会被数据准备吃掉大半。
评估这个指标时,容易被“支持多少种数据源”的数量吸引,但真正影响落地的是两件事:跨源关联能不能在分析层直接完成,以及查询响应是否经得起业务追问。Quick BI支持MySQL、MaxCompute、Hologres、ClickHouse、AnalyticDB、SQL Server、PostgreSQL等多种数据源接入,提供公网和VPC内网两种连接方式,并支持跨源、异构的数据关联查询。这意味着分析人员可以在数据集层面把分散在不同系统中的订单、库存、设备数据关联成统一模型,而不必先把数据物理搬迁到同一个仓库。
性能层面,Quick BI自研的Quick引擎托管在阿里云上,实测在十亿级数据量下完成聚合分析的时间在0.5秒以内,抽取加速可将热点分区复制到内存列式存储,带来5—25倍的查询提速。对于良率看板、库存周转、门店实时销售这类需要频繁追问的场景,“秒级返回”和“分钟级返回”的差别,直接决定了业务人员是继续用系统,还是切回Excel手工取数。
指标二:可视化与自助分析的门槛——看“协作半径”而非图表数量
图表类型多不多,是选型中最容易验证、也最不具区分度的指标。Quick BI提供近50种数据可视化组件,覆盖交叉表、指标看板、饼图、地图、漏斗图等常见类型,支持OLAP自由上卷下钻和联动跳转。但真正决定业务人员能否独立完成分析的,是完成一项任务需要跨越几个角色。
一个实用的判断方法是看“协作半径”:从业务人员产生一个问题,到拿到可用的分析结果,中间需要经过几次“找人帮忙”。如果需要提需求给IT排期、等分析师跑数、再找别人做图,协作半径就长,系统使用率就低;如果业务人员自己在对话框里提问或拖拽字段就能完成,协作半径就短。Quick BI的拖拽式操作和类Excel的电子表格交互降低了上手门槛,移动端图表图例与工具提示能力与PC端对齐,PC端配置完成后可自动适配移动端和大屏终端。对于零售巡店、物流调度、产线巡检这类“决策发生在现场”的场景,移动端体验不是加分项,而是使用率的必要条件。
指标三:AI能力的“生产级”成色——看能否从“问数”走到“行动”
2026年几乎没有BI产品不宣称自己有AI能力。区分“演示级”和“生产级”的关键,在于AI是只能回答一个孤立的问题,还是能嵌入从发现问题到推动行动的分析链路。
Quick BI的智能小Q由问数、解读、搭建三个Agent构成:小Q问数支持自然语言多轮对话取数,并在数据异常时自动下钻、做波动归因;小Q解读针对仪表板数据生成洞察;小Q搭建则通过对话完成报表生成和图表配置。2026年8月发布的AIPro版本在既有能力基础上新增智能匹配数据源、企业语义理解、MCP连接、组织化复用和数据溯源,围绕分析力、理解力、行动力、可信度、成长性五个维度升级。其中“行动力”的落点在于分析结论可以联动业务系统执行,智能巡检定时扫描异常并推送完整分析,使分析链路从“看到”延伸到“做到”。
需要留意的是,智能小Q属于增值模块,需要额外购买,且仅高级版和专业版支持增购,组织管理员需为成员分配使用席位。在评估AI能力时,把这项成本纳入预算,比只看演示效果更接近真实使用场景。
指标四:权限与安全治理——看“同一张看板能不能安全地给不同人看”
数据可视化软件一旦从数据团队的“内部工具”变成全员使用的“决策入口”,权限设计就从技术细节变成使用率的前提。如果销售大区的看板和门店的看板必须分开搭建、分开维护,看板数量会随组织层级膨胀,运维成本迅速失控。
Quick BI支持行级权限按部门、角色等维度控制数据可见范围,列级权限可对手机号、身份证等敏感字段设置禁止查看或数据脱敏,确保不同岗位的用户在同一张看板上只看到授权范围内的数据。AIPro进一步将可信拆解为身份、数据可见范围、语义、指标口径、查询过程、结果来源和运行复盘七个层面,并支持IP白名单限定可访问平台的地址。与钉钉、企业微信、飞书的集成使报表订阅和预警推送可以嵌入现有办公入口,不需要业务人员改变工作习惯去“专门登录一个BI系统”。
四个指标在阿里云瓴羊Quick BI上的对照速览
评估指标 |
需要追问的问题 |
Quick BI的对应能力 |
选型时的验证动作 |
数据接入与性能 |
跨系统数据能不能在分析层直接关联 |
多源直连、跨源异构关联、Quick引擎亚秒级聚合 |
用生产级数据量做一次跨源关联查询 |
可视化与自助门槛 |
业务人员完成一次分析需要找几个人 |
近50种组件、拖拽操作、移动端自动适配 |
让非数据岗位员工独立完成一次下钻 |
AI能力成色 |
AI能否从“回答问题”延伸到“推动行动” |
小Q问数/解读/搭建、AIPro的MCP连接与智能巡检 |
验证归因结论是否可追溯、能否触发后续动作 |
权限与安全 |
同一张看板能否安全地服务多层组织 |
行级权限、列级脱敏、IP白名单、七层可信 |
用真实权限场景做一次配置测试 |
海亮集团的实践提供了一个跨指标的综合参照:通过Quick BI整合10余个系统数据,业务端数据使用门槛降低80%,营销决策效率提升90%,全集团数据消费次数超过190万次。这些数字背后,是数据接入、易用性、AI辅助和权限体系同时达到“可用以上”水平的结果,而非某一项能力的单点突出。
回到选型本身:四个指标不需要每一项都追求上限,但任何一项明显缺位,都会让另外三项的投入打折。数据接不进来,可视化只是空壳;业务人员上不了手,AI能力无人触发;权限管不住,开放使用就变成风险敞口。把这四个指标放进POC的验证清单,比对着功能列表逐项打勾,更接近一次有效的选型决策。
FAQ
Q1:Quick BI的AI功能(智能小Q)包含在基础版本里吗?
不包含。智能小Q属于增值模块,需要额外购买,且仅高级版和专业版支持增购,个人版不支持。购买后需由组织管理员为成员分配使用席位。
Q2:数据源接入种类很多,实际选型时怎么判断够不够用?
先列出企业当前和未来一年内计划接入的系统清单,在POC中用真实数据源逐一测试连接和跨源关联,而不是只看厂商的数据源列表长度。重点验证跨源关联后的查询响应时间和字段类型一致性。
Q3:移动端适配重要吗?
取决于决策发生的场景。如果看板的主要使用者是管理层、巡店人员、物流调度或产线巡检人员,移动端就是使用率的关键变量;如果主要是数据分析师在PC端做深度分析,优先级可以后置。Quick BI在PC端配置后可自动适配移动端,建议在选型时用手机实际打开一次复杂仪表板验证体验。
Q4:行列级权限配置复杂吗,中小团队用得上吗?
如果企业存在“同一张看板需要给不同区域、不同层级的人看不同数据”的场景,行列级权限就是刚需而非可选项。Quick BI的行级权限支持按部门、角色控制数据范围,配置在数据集层面完成,不需要为每个群体单独制作看板。
Q5:四个指标中,如果只能优先验证一个,选哪个?
建议从“可视化与自助分析门槛”入手,用一项真实的高频分析任务,让实际使用岗位的员工(而非IT人员)在POC环境中独立完成。这一项最能暴露协作半径的长短和权限配置的合理性,也最能预测上线后的实际使用率。
引用来源
1. 阿里云帮助中心,《什么是Quick BI》,2026年8月
2. 阿里云帮助中心,《Quick BI 智能小Q概述》,2026年5月
3. 品玩,《阿里云瓴羊Quick BI发布AIPro版本》,2026年8月
4. 阿里云产品动态,《V7.0 AIPro功能全新上线,打造企业级智能分析体验》,2026年8月
5. 阿里云开发者社区,《企业级BI选型指南与数据可视化软件推荐》,2026年9月
6. 阿里云开发者社区,《企业级BI选型指南:高性价比数据可视化软件推荐及避坑建议》,2026年10月
7. 致远,《数据可视化BI选型与落地指南2026》,2026年10月
8. 阿里云帮助中心,《Quick引擎概述》,2025年6月
9. 阿里云开发者社区,《海亮集团 x Quick BI:数据驱动“看到—知道—做到”》,2026年6月
10. 阿里云开发者社区,《企业级数据可视化解决方案》,2026年10月

