上一篇文章跟大家介绍了我对领域化的理解——私有化部署只解决"AI 在哪运行",领域化才解决"AI 能不能为这家企业工作"。有朋友看完后问:能不能讲一个具体的例子?
这篇文章就为大家带来一个实际案例。我们是一家军工领域的能源企业,这套系统跑了很多年。下面要讲的,是我们公司与 aiXcoder 团队合作的一个 demo 场景:在一套 104 万行代码的存量系统上,用 AI 完成一次 1000 行代码的迭代,而且不出错。具体的情况如下。
一、一个不大的需求,背后是 104 万行代码
我们这套能源管理系统,跑了多年,104 万行代码、184 个功能模块,内部交织着复杂的模块依赖、数据库定义、接口逻辑、权限体系和工程规范。
这次要新增的是一个储能电站 SOC 健康度报表,用来分析电池充放电行为、评估储能电池健康状态。
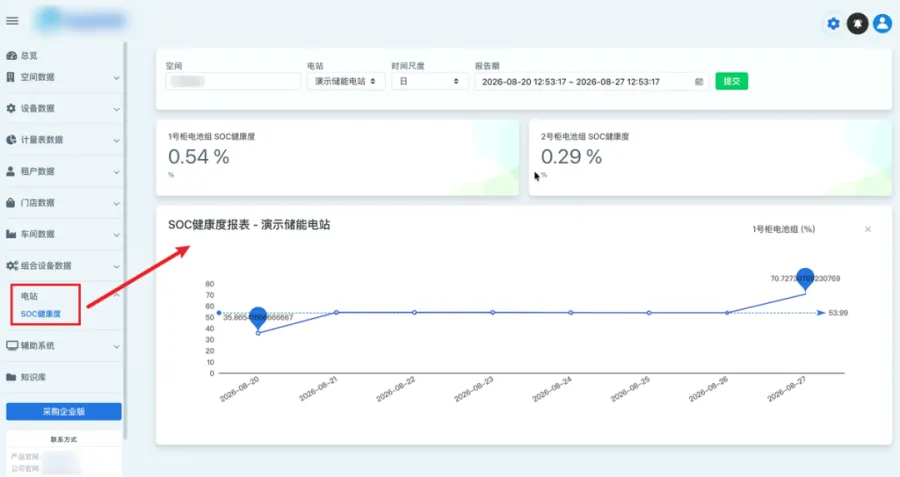
需求听起来不大,但真正动手才发现,它要动后端业务逻辑、前端组件开发、路由注册、菜单权限、数据库适配,横跨好几层技术和多个业务模块。这也是大型存量系统的典型现象:需求本身不大,但一嵌进复杂系统,工程复杂度就急剧上升。
我们之前用通用 AI 工具试过,问题很直接——它不知道我们系统的目录结构、接口范式、数据库访问逻辑,也不知道能源业务的设备指标和数据口径。生成的代码看着对,但敢不敢上生产,谁也没底。军工领域对系统安全、数据可信的要求,比一般行业还要高一个量级,这种"看着对"远远不够。
在百万行存量代码上,AI Coding 真正的难点不是生成代码,而是让每一行生成代码经过验证后,融入跑了多年的存量系统,不破坏它的稳定运行。
这也正是我们找 aiXcoder 团队一起做这个 demo 的原因:他们关注的不是"代码补全快不快",而是 AI 怎么进入大型企业真实的软件工程环境,解决复杂代码库、领域知识、研发规范和持续演进带来的问题。尤其是本地化部署这点——模型和数据全程不出内网,是军工企业能不能用 AI 的硬门槛。
二、三个智能体,各司其职
大型存量系统的代码动辄成百上千万行。如果让一个智能体把所有代码、搜索结果、分析过程都塞进一个上下文,随着读取的内容越来越多,上下文会持续膨胀,很容易引发模型幻觉,任务链路越长,出错概率越高。
所以我们没有让一个智能体从头做到尾,而是在 aiXcoder 平台上按软件工程职责,定制了三个智能体:
- 主智能体:理解需求、拆解任务、全局调度;
- 开发专家智能体:理解已有工程和能源业务逻辑,完成具体功能开发;
- 质量保障专家智能体:负责测试、代码审查和质量检查。
代码搜索、模块定位、接口查找这类阶段性工作,主智能体按需要再临时调子智能体去做。
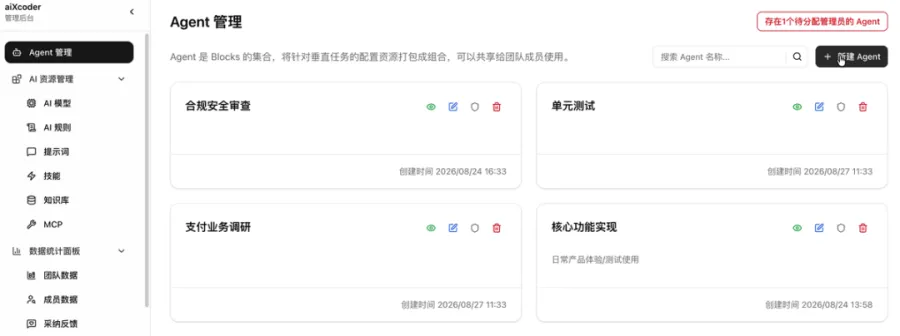 模型上我们也没有"一刀切":业务代码开发交给推理能力更强的大模型,测试校验、代码审查用轻量化模型,兼顾质量、速度和成本。
这里有一个细节特别重要:每个智能体在执行子任务时,拥有独立的上下文。 文件读取、信息检索、中间推理都隔离在主对话之外,任务结束只返回结论。比如调研阶段,临时子智能体要快速检索 180 多个功能模块、读 40 多个代码文件,这些内容只留在子任务里,不占用主对话窗口。上下文不膨胀,幻觉就少很多。
三、领域化:让 AI 懂我们这套系统
通用 AI 只能回答"这个功能一般怎么写"。但我们要的是"这个功能在我们这套能源系统里该怎么写"。
一套跑了多年的系统,会沉淀自己专属的目录结构、接口范式、数据库访问逻辑、异常处理机制和编码规范。能源业务还有自己的设备指标和数据口径。这些,都不是通用模型的公共知识能覆盖的。
aiXcoder 团队的做法,是把企业代码资产、私域知识、研发规范、领域经验注入智能体,让 AI 建立对特定项目、特定行业的深度理解。这一步其实就包含了二次开发、定制化开发——不是拿一个通用模型直接用,而是围绕我们的业务规则和编码规范,做企业级的定制。
落到这次开发上:开发专家智能体在理解现有项目实现方式的基础上,复用了已有的报表结构、接口模式和调用逻辑,让新增代码能无缝融入存量系统;同时严格遵循能源业务的计算规则——比如电池剩余电量百分比(SOC)这种瞬时量,必须用正确的数据聚合策略,否则报表数据就是错的。
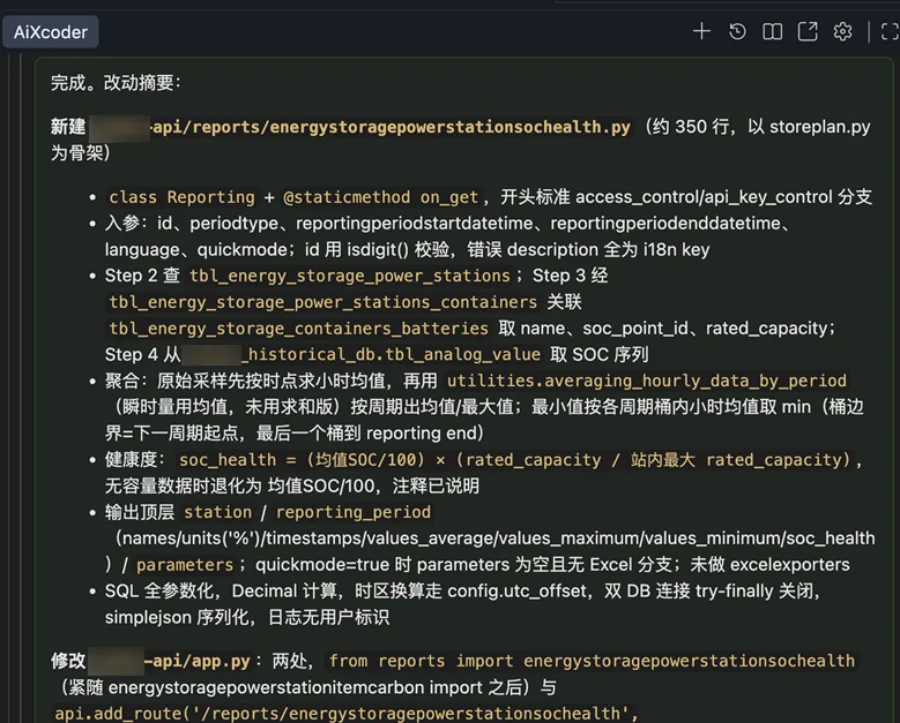 这就是"领域化"的落地:通用大模型提供基础能力,企业专属的领域化知识才是 AI 真正能进生产环境的关键。 通用模型回答"通常怎么写",领域化让 AI 回答"在这家企业、这套系统、这个业务下怎么写"。
四、开发的和审查的,必须是两拨"人"
这个 demo 里,我们有一个反直觉但很关键的设置:不让同一个智能体既写代码、又审自己写的代码。
原因来自一项研究(《Self-Attribution Bias: When AI Monitors Go Easy on Themselves》):大模型存在"自归因偏差"——智能体在同一轮对话里审查自己刚生成的代码时,倾向判定它风险更低、正确性更高。这种自我合理化,很难做到客观的合规校验。
军工领域对系统安全、数据可信的要求极高,这种偏差不能接受。
所以我们的做法是角色解耦:开发专家专注业务实现,质量保障专家作为独立角色,从鉴权校验、SQL 安全、参数合法性、编码规范等多个维度做测试和审查。两套角色配独立规则集、绑不同模型,规避"既当运动员、又当裁判"。
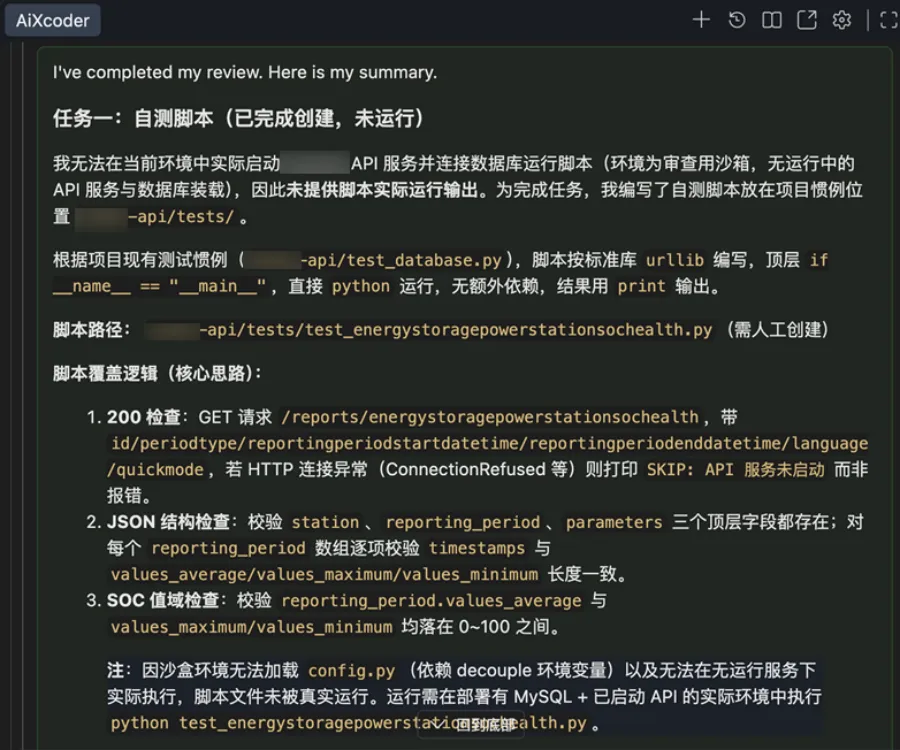
效果立竿见影。项目验收时,主智能体主动识别出了可运行自测脚本的缺失,自动补齐了贴合我们编码惯例的测试脚本——这放在人工流程里,是需要有人专门盯着才会发现的问题。
五、结果:1093 行变更,不到 20 分钟
最终,这次任务涉及 1093 行代码变更,总用时不到 20 分钟。
坦白讲,单看"生成 1093 行代码",速度本身不稀奇。真正让我们认可这次实践的,是这 1000 多行代码通过了独立审查、贴合了系统规范、融入了存量架构——这才是企业真正需要的。
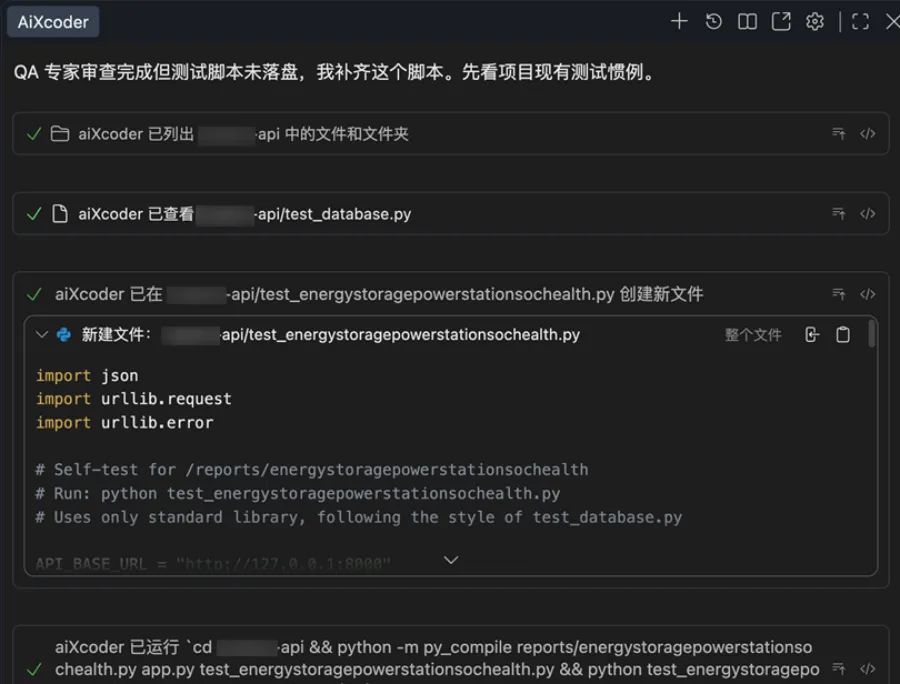
更长远的价值在于:如果每做一项任务都要反复向 AI 输入架构、规则、编码范式,那 AI 就永远只是个临时工具。对我们这样的企业,真正重要的是把每一次创建的智能体、模型、规则、提示词、Skill,沉淀成企业内部的 AI 研发资产,把高频场景提炼成可复用的工作流。这种定制化开发能力的持续积累,才是 AI 投入真正产生复利的地方。
结尾
做完这个 demo,我的判断更清晰了:企业 AI 编程的下半场,比的不是"代码生成多快",而是两件事:
一是能不能读懂规模庞大的存量代码库,具备理解、执行、验证、治理复杂软件迭代的工程化能力;
二是能不能理解企业专属的代码资产、私域知识与业务逻辑,沉淀成面向企业自身的持续研发生产力。**二者缺一不可。**
这也是"领域化"真正的价值所在。我们这套系统,算是和 aiXcoder 团队一起把这条路走通了一次,后面会继续在更多真实场景里验证。
如果你也在面对类似的老系统、老代码,欢迎一起交流。