报告首页那一个大号平均数,撑不起一次容量决策。
发布评估会,投影第一页写着一个大字:平均 320ms,底下一行小字「达标」。会议室里没有人追问这个数字是怎么平均出来的,而接下来三件事都要从这一页出发——容量要不要加机器、SLA 条款怎么写进合同、灰度是否继续放量。问题不在于这个平均数算错了,而在于它本来就不该单独站在报告首页。
平均延迟会漏掉哪两种形状
先统一译名,后面不再换说法。平均延迟(mean latency,一组请求耗时的算术平均值)是总耗时除以请求数得到的一个点;P50(第 50 百分位数,也叫中位数,含义是一半请求比它快、一半比它慢)是把请求按耗时从小到大排完后正中间那个值;P95 与 P99(尾部延迟,即最慢的 5% 与 1% 请求所在的分界值)看的是这条分布的右尾巴翘到哪里;TTFT(Time To First Token,首个字返回耗时)是流式响应里从发出请求到第一个字出现的间隔;端到端总耗时则是从发出请求到整段响应吐完的间隔。
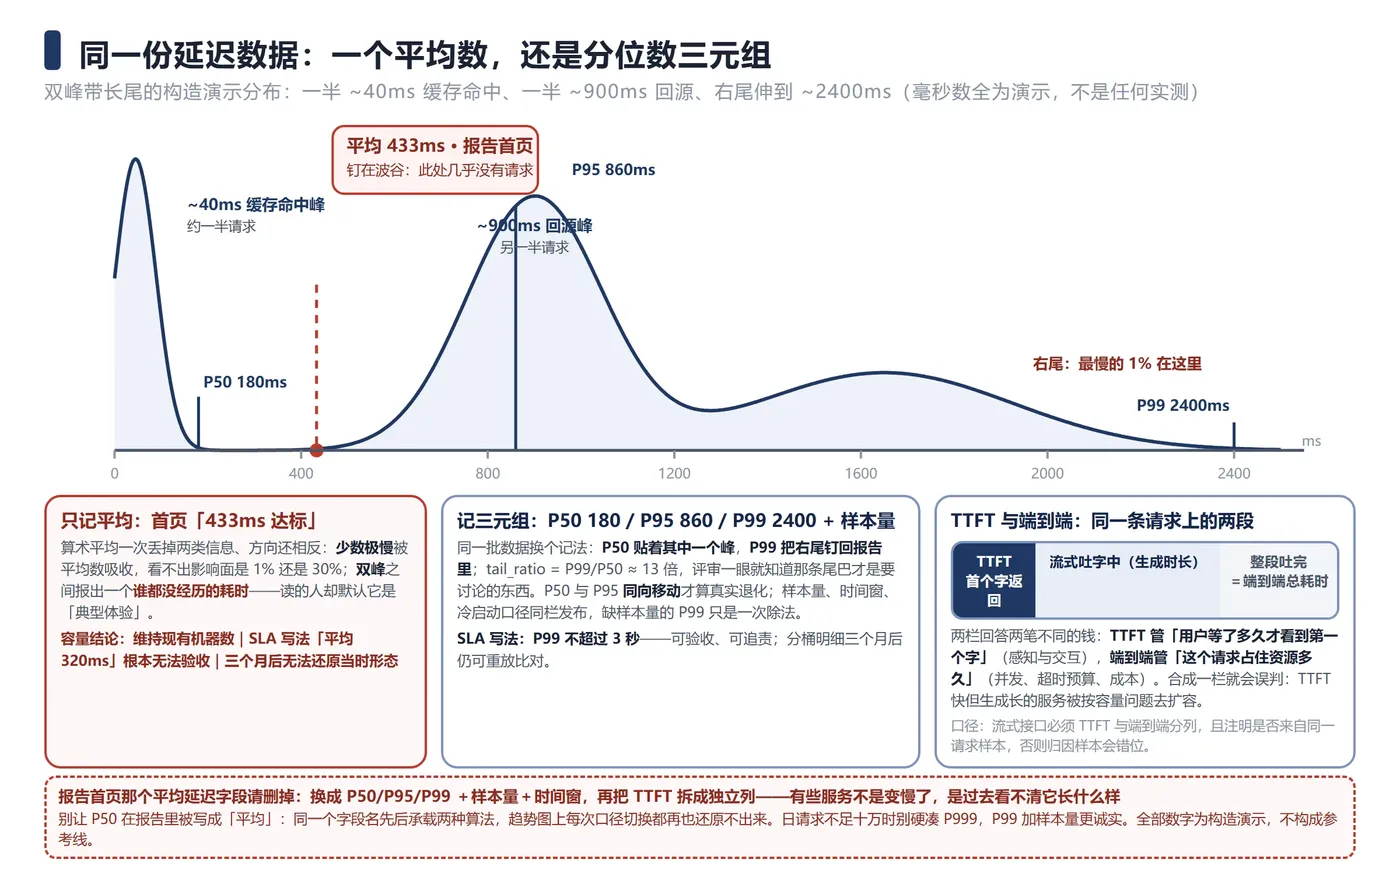
平均数一次丢掉两类信息,方向还相反。第一类是少数极慢请求把算术平均往上拽:报出来的数字变差了,可没人知道是 1% 的请求慢还是 30% 的请求慢,而这两种情形对应完全不同的处置——前者多是超时预算与重试策略的问题,后者才是容量问题。第二类更隐蔽,是双峰:一半请求命中缓存、走 40ms 量级,一半回源、走 900ms 量级,平均数会落在 470ms 附近,而这个数值附近几乎没有请求。报告只写平均数时,读的人默认它是「典型体验」,于是把一个谁都没经历过的耗时当成了用户感受。
一条可独立摘录的口径是:在请求耗时呈双峰分布的服务里,平均延迟同时偏离两个峰值,此时以它为基准做的容量估算与 SLA 承诺都不可复现。
| 分布形状 | 只看平均延迟会漏掉什么 | 改记分位数三元组后能看到什么 |
|---|---|---|
| 少数极慢长尾 | 数字被抬高,但看不出影响面是 1% 还是 30% | P95 与 P99 的间距给出尾巴长度,配样本量能估出受影响请求数 |
| 双峰(缓存命中与回源并存) | 报出一个位于波谷、无人经历的耗时 | P50 贴近其中一个峰,P50 与 P95 的落差直接暴露分叉 |
| 冷热启动混合 | 冷启动的代价被大量热请求稀释 | 分桶后各出三元组,冷启动是否计入写在表头即可核 |
| 与历史版本比较 | 差异说不清真伪,一次抖动就能改写结论 | P50 与 P95 分别比对,同向移动才算真实退化 |
同一份数据,两种记法差多远
把同一批请求换个记法摆出来,差别不在精度而在结论。下面这张对照表是同一次数据的两种写法,左列是过去常见的归档姿势,右列是这次要推的姿势。
| 同一份数据的两种归档写法 | 只记平均 | 记三元组+双栏 |
|---|---|---|
| 首页主指标 | 320ms | P50 180ms/P95 860ms/P99 2400ms |
| 读出的判断 | 达标,体验稳定 | 一半请求很快,最慢的 1% 在 2.4 秒量级 |
| 容量结论 | 维持现有机器数 | 尾巴来源要先定位,扩机未必对症 |
| SLA 写法 | 平均 320ms(无法验收) | P99 不超过 3 秒(可验收、可追责) |
| 复盘可用性 | 三个月后无法还原当时形态 | 分桶明细+样本量可重放比对 |
分位数三元组怎么从一堆原始耗时算出来
字段清单看着玄,落到代码其实十几行:拿到一组请求耗时,排序取分位数,和样本量一起归档。下面这段可以直接跑,输入换成你的压测落下来的原始数组即可。
# latency_report.py —— 分位数三元组 + 样本量:报告首页的最小实现
from statistics import quantiles

def latency_summary(samples_ms, cold_start_excluded=True):
    """把一批请求耗时(毫秒)压成报告首页要用的三元组 + 样本量。
    关键在别只落平均值:真实场景由压测工具落原始数组,这里只做汇总。"""
    n = len(samples_ms)
    ordered = sorted(samples_ms)
    q = quantiles(ordered, n=100)          # 用 100 段近似出 P50/P95/P99
    p50, p95, p99 = q[49], q[94], q[98]    # 样本量 < 100 时别硬凑 P99,改报精确秩
    return {

        "n": n,
        "p50_ms": round(p50, 1),
        "p95_ms": round(p95, 1),
        "p99_ms": round(p99, 1),
        "tail_ratio": round(p99 / p50, 2) if p50 else None,   # P99/P50:尾巴有多长
        "cold_start": "excluded" if cold_start_excluded else "included",
    }

if __name__ == "__main__":
    demo = [40] * 55 + [900] * 45          # 双峰:一半命中缓存、一半回源(构造演示)
    print(latency_summary(demo))
    # 平均数落在约 433ms——一个谁都没经历的耗时;三元组给的是 P50 40 / P95 900 / P99 900,双峰当场现形
为什么坚持三元组而不是平均数:这段代码里唯一多的动作就是 sorted + 取秩,成本几乎为零,可它保住了平均数一定会丢的右尾。tail_ratio(P99 除以 P50)是给评审用的一眼指标——比值接近 1 说明分布紧凑,比值拉到几十倍说明那条尾巴才是真正该讨论的东西。冷启动口径 cold_start 显式落到返回结构里,是为了让「上线首日」和「稳定期」不再被糊进同一列趋势。
TTFT 与端到端总耗时为什么要分两栏
结论是:两栏回答的是两笔不同的钱。TTFT 回答「用户等多久才看到第一个字」,它决定的是感知的响应性与交互流畅度,优化方向多在调度、排队与首块生成;端到端总耗时回答「这个请求占住资源多久」,它决定的是并发容量、超时预算和成本。把两者合成一栏,就会出现两种互相矛盾的误判:一个 TTFT 很快但生成很长的服务,总耗时栏很难看,于是被按容量问题去扩容,而真正该改的是超时与流式呈现;反过来一个 TTFT 很慢、吐字很快的服务,总耗时看着还行,用户却在白屏里等了两秒。
对报告而言,一条可摘录的口径是:流式接口的延迟记录必须同时给出 TTFT 与端到端总耗时两栏,并注明两者是否来自同一请求样本,否则首屏体验问题与吞吐容量问题无法分开归因。
| 报告栏位方案 | 能回答的决策 | 回答不了的决策 |
|---|---|---|
| 单一端到端总耗时一栏 | 并发占用、超时阈值、单位请求成本 | 用户等了多久才看到第一个字 |
| TTFT 与总耗时分两栏 | 首屏感知与吞吐容量分开归因,分别定责任人 | 需要额外说明两栏是否同一批请求,否则样本会错位 |
「延迟怎么记」字段清单
一张合格的延迟表,最少要能回答「谁在什么时候、按什么口径、算了多少请求」。建议字段固定六项,缺一项就在报告头部写明原因。
| 字段 | 记什么 | 不记会怎样 |
|---|---|---|
| 分位数集合 | P50、P95、P99 三值同报,不省略 P99 | 尾部消失,只剩一个可被拉动的点 |
| 栏位拆分 | TTFT 与端到端总耗时分列 | 感知问题与容量问题混为一条 |
| 样本量 | 该窗内请求总数,分桶时各桶单独给 | 百分位在几十样本上本身就是噪声 |
| 时间窗 | 起止时刻与是否覆盖峰值时段 | 早晚两个窗口的数字被当成同一件事 |
| 冷启动口径 | 首次调用、扩容期是否计入,计入哪些桶 | 上线首日与稳定期互相污染趋势 |
| 分桶维度 | 接口、机型或区域、是否命中缓存 | 双峰被平均掉,定位无从下手 |
清单里最容易被砍掉的是 P99,理由通常是「样本不够」。这条要顶住:样本不足可以通过把样本量同栏发布来诚实表达,直接砍掉等于把尾巴从报告里删了。一条可独立摘录的口径是:分位数只有与样本量、时间窗同栏发布时才构成可用观测,缺样本量的 P99 只说明取数的人做了一次除法。
第二个常见偷懒是把 P50 直接写成「平均」,两个词在报告里必须各归各位。混用的代价不在那一份报告,而在半年后:历史归档里同一个字段名先后承载过两种算法,趋势图上的每一次口径切换都再也还原不出来,读者只能挑一条曲线相信自己想看的那条。
清单落地的顺序也提一句:先给首页加一行「P50/P95/P99+样本量」,再把 TTFT 拆成独立列,最后补冷启动与分桶说明。三步里最容易被省掉的是第三步,而恰恰是第三步决定前两步的数字能不能和历史比。
这一步的边界
本篇只谈呈现与归档,不谈准入。慢没慢、要不要拦住这次发布,属于门禁判据问题,判据要贴着各服务自己的业务峰值定,不在这里给数。文中所有毫秒数与分布形态都只用于说明记法差异,不对应任何真实产品的实测成绩,也不构成行业基准,拿来当参考线是误用。分位数该取到 P99 还是 P999,取决于你的请求量级:日请求不足十万时,P999 的位置上可能只有几百个样本,报出来反而制造虚假精度,这时老老实实给 P99 加样本量更诚实。
结语:下次归档之前
下一次压测跑完,在报告模板里做一件小事:把首页那个平均延迟字段删掉,换成 P50/P95/P99 三个值加一行样本量与时间窗,再把 TTFT 拆成单独一栏。改完你会立刻发现,有些服务并不是变慢了,而是过去看不清它长什么样。
延迟报告的价值不在给出一个更好看的数字,而在让最慢的那一批请求有人认领。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。