
AI 把写测试变得极廉价之后,测到东西和测了个寂寞之间,只剩三道验收线。
这轮补的回归用例是 AI 写的:一个下午生成四十条,挂上流水线跑了一夜,全绿,第二天就合进了主回归集。两周后线上出事故——已经领过券的用户,页面上再点一次领取按钮,居然又领到一张。你把这四十条摊开挨个看,越看越后背发凉:二十几条的断言只有一句「响应码等于 200」;有一条压根断言了「第二次领取应当成功」,因为模型给期望值填的是它猜出来的「理想答案」;真能拦住这个 bug 的那条不变量断言,一条都没有。bug 没躲在没测到的地方,它藏在一整片绿色底下。
AI 给写用例带来的提速是真的,掺进来的水分也是真的。批量生成的用例在进回归集之前,得过三道验收闸门:断言有效性、数据来源、失败可归因。这篇给出逐条验收的技术清单,外加一个把验收做成机械检查的 pytest 门禁——不讲看板,不讲管理指标,只讲每条用例怎么审。
第一道:断言有效性——它到底断没断业务
验收口径只有一条:只断「返回 200」「结果非空」的用例,等价于没测。问写这条用例的人(或者生成它的你)一句话:「这条用例红的时候,意味着哪条业务规则被破坏了?」答不上来,就是假绿。拿同一领券接口摆个对照:
# test_coupon_claim.py —— 假测试 vs 真测试,同一个接口
# 业务规则:营销券 c1,同一用户限领一次

def test_claim_fake_ai_style(client):
    """AI 批量生成用例的典型形态:只证明「接口回了话」"""
    resp = client.post("/coupons/c1/claim", json={
   "user": "u_1001"})
    assert resp.json() is not None          # 任何响应都通过,等于没断言
    assert resp.status_code == 200          # 哪怕逻辑全错,只要没崩就绿

def test_claim_real(client, db):
    """真测试:断言业务不变量——第二次领取必须被拒,且不落第二条记录"""
    client.post("/coupons/c1/claim", json={
   "user": "u_1001"})
    resp = client.post("/coupons/c1/claim", json={
   "user": "u_1001"})
    assert resp.status_code == 409, "同一用户重复领券必须被拒绝"
    assert db.count_claims(coupon="c1", user="u_1001") == 1, "领取记录数不变量被破坏"
为什么这个对照值得贴在验收清单第一条:接口就算把「限领一次」的逻辑整个删掉、让用户连领十张,上面那条假测试照样高高兴兴地绿;而真测试的第一句断言当场就红。有效断言(针对业务不变量的断言,即条数、金额、权限边界、幂等这类「不该变的东西」)至少得有一条,存在性断言和状态码断言只能算配菜。顺手再抠一个细节:断言消息里要把业务规则写出来,这同时是第三道验收线的伏笔。
团队批量引入 AI 用例后,这一道线还有个容易被糊弄的走法:去数 assert 的条数。别——十条「非空」叠起来,还是一条什么都没断。更可靠的口径是按用例盘点一份「它声称覆盖的业务规则清单」:每条用例必须能对到至少一条具体规则上,对不上的直接进待删清单,而不是看断言密度这种表面指标。断言有效性这道线,卡的是「这条用例有没有资格叫测试」,不是「它写得勤不勤」。
第二道:数据来源——输入和期望值是不是编的
AI 填测试数据有个稳定的坏习惯:期望值写的是「看起来应该对」的答案,而不是查证过的事实。前面重复领券那条假用例就是现行犯——期望值该来自业务规则文档,模型却按语感猜了一个。验收动作分两半。输入侧:每个测试夹具(fixture,用例运行前搭好的前置数据)里的数据,要么来自脱敏后的线上采样,要么来自产品规则表,要么是显式手搓并标注了构造意图,三者都对不上的,说明它造了一个不存在的前置状态——不存在的券 ID、不可能的权限组、永远不会命中的时间窗。期望侧:每个断言的期望值必须能指回一条规则或一份采样,指不回去的,宁可先把用例降级成待查清单,也不要让它带着编造的绿灯进回归集。用编造数据侥幸通过的用例,比压根没跑的用例更危险——它给你一种「这块有人守着」的错觉。三类出处可信度也不同:线上脱敏采样离真实分布最近,但要过隐私关;产品规则表能覆盖边界条款,容易漏掉历史包袱;显式手搓的构造数据意图最可控,却也最容易混进模型凭空发明的券和权限组。验收记录里别只写「有出处」,要写明是哪类出处——下次数据模型漂移,你能按类型批量重查。
第三道:失败可归因——红了能不能一眼看到案发现场
用例的成本不只花在写,更花在它半夜挂掉之后那十分钟。AI 用例的失败信息经常长这样:assert None is not None,或者光秃秃一个 timeout,定位全靠翻日志。两道便宜的处理手法:其一,每条断言强制带一句人话理由,说明「破坏了什么规则」,上面真测试里那句「同一用户重复领券必须被拒绝」就是模板;其二,被测点的关键上下文——用户 ID、资源 ID、进行到哪一步——直接进断言消息或结构化日志,而不是失败后再 print。识别信号很直白:把这条用例想象成明早三点挂在你手机上,光看失败输出,你需不需要再去翻代码才知道它测的是哪条规则?需要,就没过这道线。还有个隐藏判据是失败后的第一动作:如果你的第一反应是「先重跑一次看看」,说明这条用例已经是个黑箱——重跑蒙过去一次,它就多空转一轮。归因好的用例,失败输出给足信息,让人想的是「去查这个用户这笔单的数据」,而不是「再赌一把它自己好」。
三种假绿:识别信号和对应处置
| 假绿形态 | 典型识别信号 | 处置 |
|---|---|---|
| 空断言 | 通篇只有状态码、非空、长度大于等于零 | 重写为业务不变量断言,消息里写明被破坏的规则 |
| 编数据 | 输入在规则文档和线上采样里都找不到出处;期望值「恰好」符合直觉 | 补数据溯源;查无出处的降级出回归集,进待查清单 |
| 难归因 | 失败输出只有 None/timeout,无用户与资源标识,需要翻代码才知测了啥 | 断言强制带 reason,关键上下文进消息或结构化日志 |
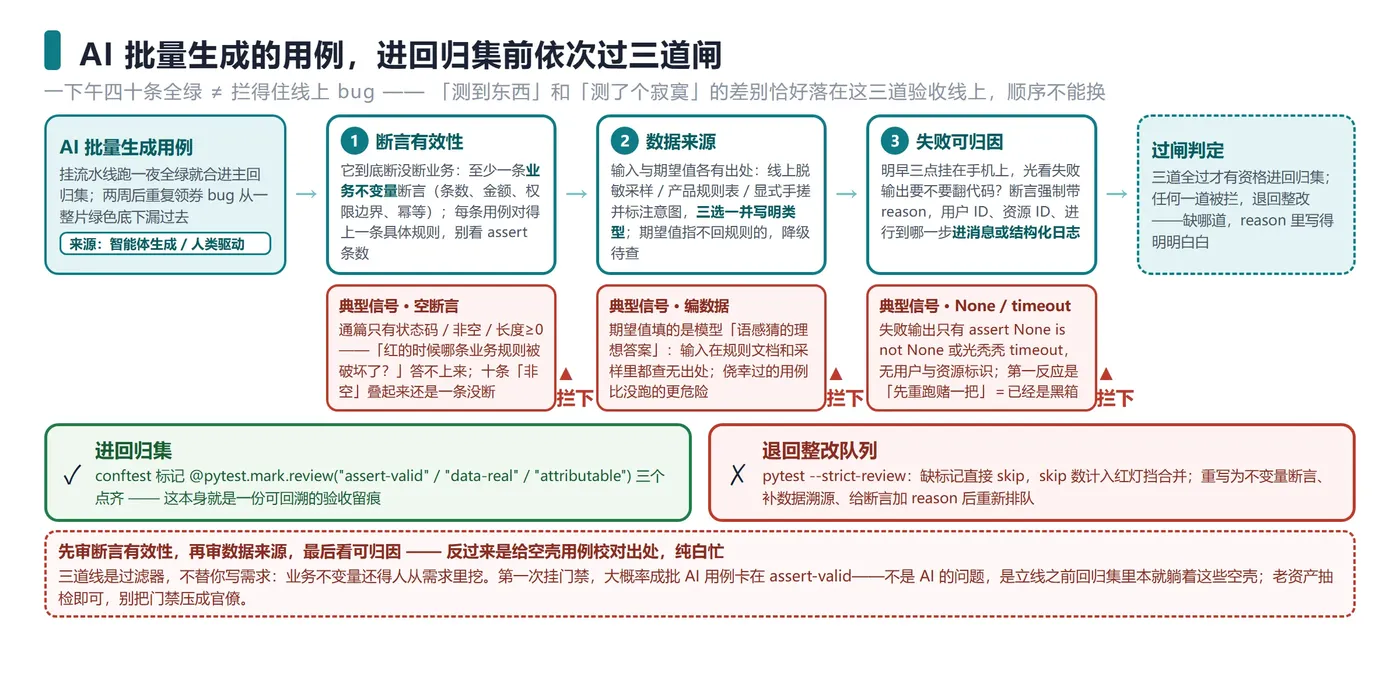
把验收做成门禁:conftest 拦住「没审过的用例」
口头清单一定会被赶工期绕过。更可靠的做法是把三道线变成机械检查:每条用例必须用标记声明自己过了哪几道闸门,没声明齐的,默认不让它在回归流水线里充当绿灯。
# conftest.py —— 三道验收做成 pytest 门禁:没过审的用例进不了回归集
import pytest

REQUIRED = {
   "assert-valid", "data-real", "attributable"}

def pytest_addoption(parser):
    parser.addoption("--strict-review", action="store_true",
                     help="回归集模式:强制校验三道验收标记")

def pytest_collection_modifyitems(config, items):
    if not config.getoption("--strict-review"):
        return
    for item in items:
        passed = {
   arg for m in item.iter_markers(name="review") for arg in m.args}
        missing = REQUIRED - passed
        if missing:
            item.add_marker(pytest.mark.skip(
                reason=f"未过三道验收,缺: {sorted(missing)}"))

# 用例文件里的声明方式:
# @pytest.mark.review("assert-valid")   —— 至少一条业务不变量断言
# @pytest.mark.review("data-real")      —— 输入与期望值均有溯源
# @pytest.mark.review("attributable")   —— 失败消息自带业务坐标
# 流水线跑 pytest --strict-review,skip 数计入红灯而非忽略
为什么这么写:skip 在这里不是放水,而是把「没验收」显式变成流水线上的红灯——CI 脚本里检查 skip 计数,非零就挡合并,每一条 skip 的 reason 直接写明缺了哪道闸门,不用人再问。这套标记同时是一份验收留痕:谁点的 assert-valid,出了假绿案子可以回溯到评审环节。第一次挂这道门禁时,大概率会有成批 AI 用例卡在 assert-valid 这一项上——那不是 AI 的问题,是这道线立起来之前,回归集里本来就躺着这些空壳。
边界:三道线是过滤器,不替你写需求
得把这层说破。三道验收只能筛掉「测了个寂寞」的用例,不能凭空长出「该测什么」的知识——业务不变量本身还是得有人从需求里挖,AI 只会替你写已经说清楚的东西。顺序也有讲究:先审断言有效性,再审数据来源,最后看可归因,反过来会白忙——给一条断言空洞的用例校对数据出处是浪费。成本同理:存量手写用例不必全量补标记,抽检即可;门禁严格拦的是新增的批量生成用例,别让它变成压在老资产上的新官僚。
结语:今晚合码之前,先跑一遍 strict-review
下一步很小:把上面那个 conftest 挂进仓库,给本周 AI 新生成的用例补上三个标记——补不出来,就说明它确实没过对应那道线,正好出不了门禁。跑顺之后,再按对照表把存量的空断言用例一条条挖出来重做。AI 让写用例的成本塌到地板上,用例的价值就整个浮到了验收上。
测试工程师被 AI 替代得最彻底的时刻,不是写不出用例,而是分不清哪条用例在空转。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。

