摘要:本文不复述 API,只讲一个真实形态的电商实时大屏项目怎么从零跑起来、又怎么被线上事故教育了三次。Kafka 订单流峰值 8 万条/秒、日均 20 亿条,要求分钟级延迟、事件时间口径、任务可恢复。全文给出链路分层的具体理由、窗口聚合的完整代码与参数取舍、watermark 用实测迟到达率反推的方法、foreachBatch 幂等落库的三种可行写法,以及三次真实事故(checkpoint 分区数变更导致 22GB 堆外内存泄漏、Watermark 缺失导致状态永不释放、foreachBatch 非幂等导致大屏数字翻倍)的现象、定位与修复方案,附一套可直接抄的监控指标清单。
关键词:Structured Streaming, Spark, 实时大屏, Watermark, RocksDB, StateStore, foreachBatch, Exactly-Once, 线上事故复盘
一、先把需求翻译成技术约束
业务方提需求时说的是"要个实时大屏",工程侧必须把它翻译成可执行的技术约束。这个项目最终确定下来的是四条:
| 业务原话 | 翻译后的技术约束 | 直接影响的设计 |
|---|---|---|
| "要实时" | 端到端 P99 延迟 < 60 秒 | 微批 trigger 30 秒,不追毫秒级 |
| "数要准" | 口径 = 下单事件时间,允许迟到但可追平离线 | 必须带 watermark + 事件时间窗口 |
| "不能丢也不能重" | 端到端 Exactly-Once | Source 可重放 + 幂等 Sink + Checkpoint |
| "凌晨没人看着也得活着" | 故障自动恢复,重启不重复计算 | Checkpoint 落 HDFS,禁止落在本地盘 |
数据侧的真实规模:日均订单 20 亿条,大促峰值 8 万条/秒,单条 JSON 约 600 字节,日增原始数据约 1.2 TB。
这四条里最容易被忽略的是第一条。"实时"是可谈判的——如果业务方接受 15 分钟延迟,用 Trigger.AvailableNow() 做成定时批跑,成本只有常驻集群的五分之一,故障也从"进程卡住"退化成"普通任务失败重试"。这个项目之所以必须常驻,是因为大促期间业务方要盯盘,60 秒是硬线。
二、链路分层:为什么一条流要拆成两条查询
整体链路如下:
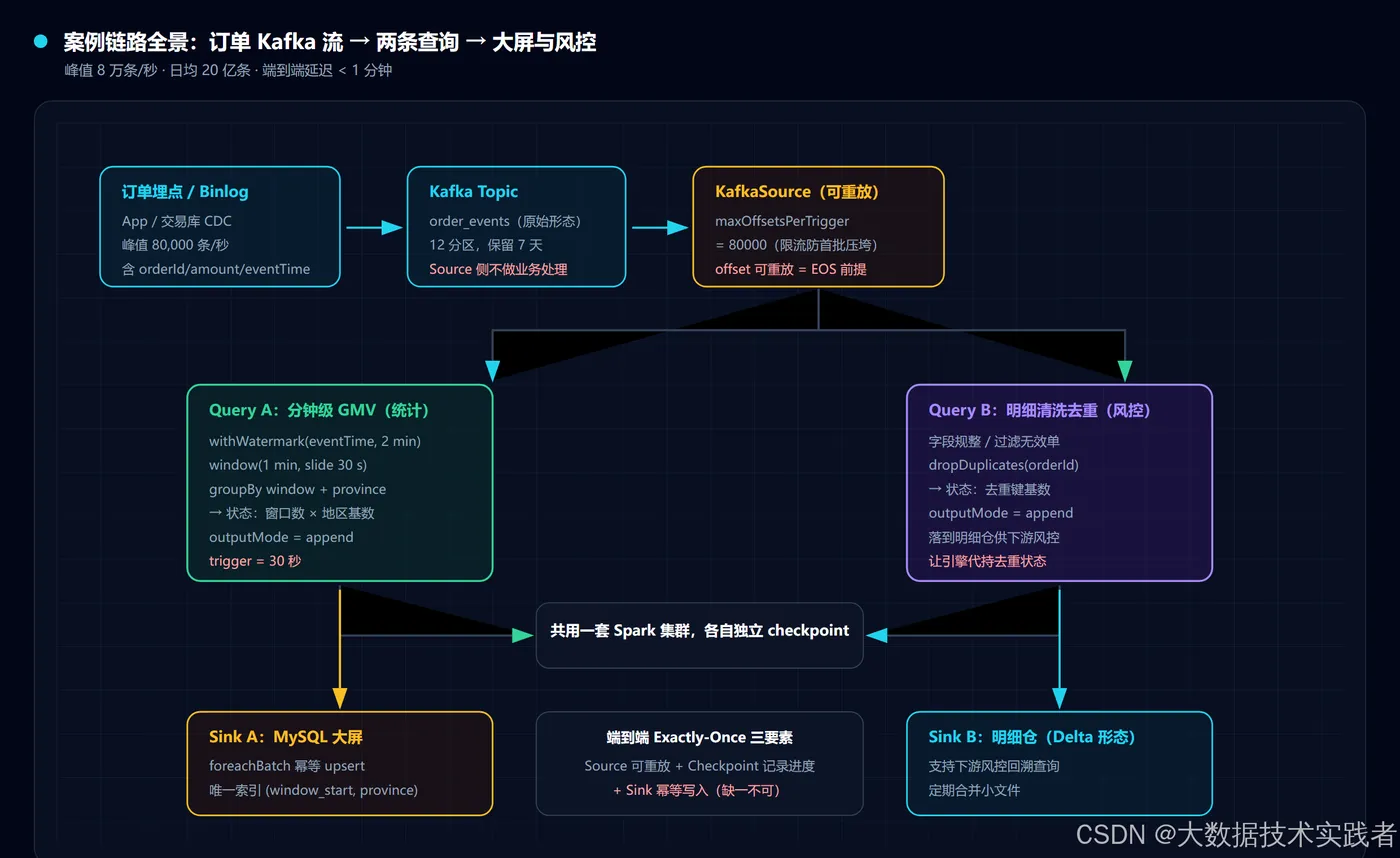
拆分的第一个理由来自写入模式冲突。大屏统计需要按窗口 upsert(覆盖写),明细落仓需要 append-only(只追加不回改)。这两种写入语义没法在一个 writeStream 里同时表达,硬塞进 foreachBatch 会让幂等逻辑互相污染。
第二个理由是调优参数冲突。统计查询为了压低延迟需要短 trigger(30 秒),明细查询为了减少小文件需要长 trigger(5 分钟)。两个 StreamingQuery 独立之后,trigger、checkpointLocation、甚至 stateStore 配置都能各调各的。
第三个理由是故障隔离。明细查询因为要写 Delta 而偶发提交冲突时,统计查询不会连带停摆——大屏是大促期间的"战时设施",不能因为下游落仓抖动而黑屏。
两条查询各自独立的配置如下:
// 统计查询:短 trigger,压延迟
  .trigger(Trigger.ProcessingTime("30 seconds"))
  .option("checkpointLocation", "hdfs://nn:8020/chk/gmv-1m")

// 明细查询:长 trigger,减少小文件
  .trigger(Trigger.ProcessingTime("5 minutes"))
  .option("checkpointLocation", "hdfs://nn:8020/chk/order-detail")
两个流共用一个 Spark 应用时,记得打开 FAIR 调度,否则一个积压的流会把另一个饿死:
spark.scheduler.mode=FAIR
spark.scheduler.pool=streaming-pool
三、统计查询:分钟级 GMV 的完整写法
核心逻辑只有十几行,但每一行都有理由:
val orders: DataFrame = spark.readStream
  .format("kafka")
  .option("kafka.bootstrap.servers", "broker1:9092,broker2:9092")
  .option("subscribe", "order_events")
  .option("startingOffsets", "latest")
  .option("maxOffsetsPerTrigger", "80000")        // ① 限流
  .option("failOnDataLoss", "false")              // ② 容忍 offset 过期
  .load()
  .select(from_json($"value".cast("string"), orderSchema).as("o"))
  .select($"o.orderId", $"o.userId", $"o.amount", $"o.province", $"o.eventTime")
  .withWatermark("eventTime", "2 minutes")        // ③ 迟到容忍

val gmv = orders
  .groupBy(window($"eventTime", "1 minute", "30 seconds"), $"province")
  .agg(sum("amount").as("gmv"), count("orderId").as("orders"))
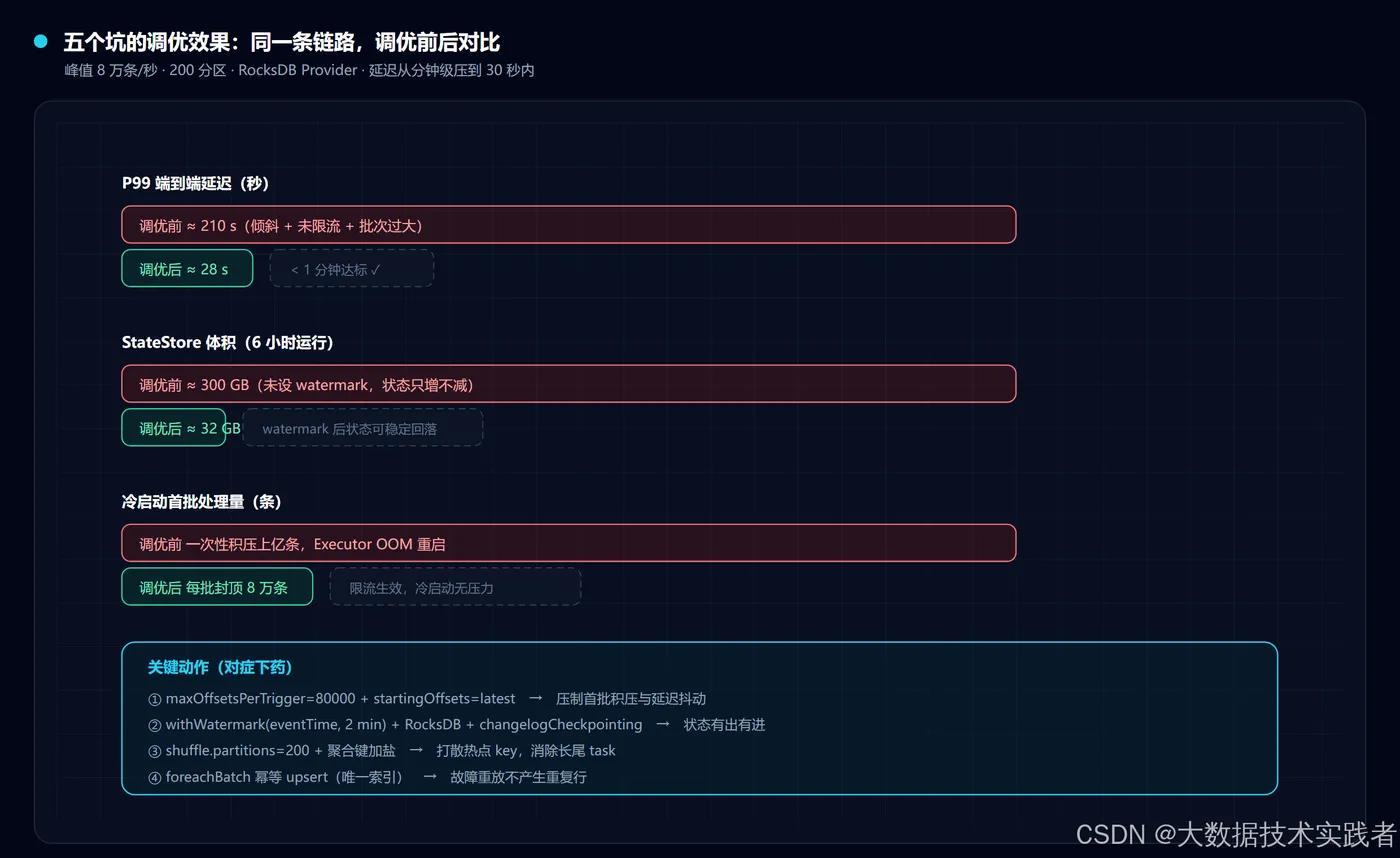
① 限流是保命设置。 不限流的情况下,冷启动或大促开始瞬间,首批会一次性把积压的全部数据拉进来。我们第一次上线就栽在这里:startingOffsets=latest 生效前的历史积压叠加瞬时流量,单批拉进上亿条,Executor 直接 OOM 重启,重启后又拉一次,形成死循环。maxOffsetsPerTrigger=80000 把单批上限钉死,代价只是积压消化得慢一点。
② failOnDataLoss=false 是权衡。 Kafka 默认保留 7 天,如果任务停机超过 7 天,旧 offset 已被删除,默认行为是直接失败退出。设成 false 会跳过丢失区间继续跑——这违反严格语义,但对"停机超过一周"这种极端情况,继续服务比严格语义更重要,丢失区间事后用离线数据补齐。
③ 滑动窗口的幂等要按窗口做。 window($"eventTime", "1 minute", "30 seconds") 是 1 分钟窗口、30 秒滑动,同一事件会同时落进两个窗口。这意味着落到 Sink 时,去重键必须是 (window_start, province) 而不是 orderId——按订单去重会漏掉一半窗口更新。
生产提交参数:
spark-submit \
  --master yarn --deploy-mode cluster \
  --conf spark.sql.shuffle.partitions=200 \
  --conf spark.sql.streaming.stateStore.providerClass=org.apache.spark.sql.execution.streaming.state.RocksDBStateStoreProvider \
  --conf spark.sql.streaming.stateStore.rocksdb.changelogCheckpointing.enabled=true \
  --conf spark.sql.streaming.stateStore.rocksdb.maxMemoryUsageMB=4096 \
  --conf spark.sql.streaming.stateStore.rocksdb.blockCacheSizeMB=128 \
  --conf spark.sql.streaming.stopTimeout=30000 \
  --class com.xxx.RealtimeGmvApp gmv-app.jar
注意最后两组 RocksDB 参数。RocksDB 默认不限制内存,200 个 state store 实例各缓存各的,堆外内存会一路涨到打满机器。这几个参数是第一次事故的直接修复手段,下一节会详细说。
四、Watermark:一个参数同时管丢数和管状态
watermark 是整个案例里语义最密集的一个参数。先看数据在时间轴上的位置关系:
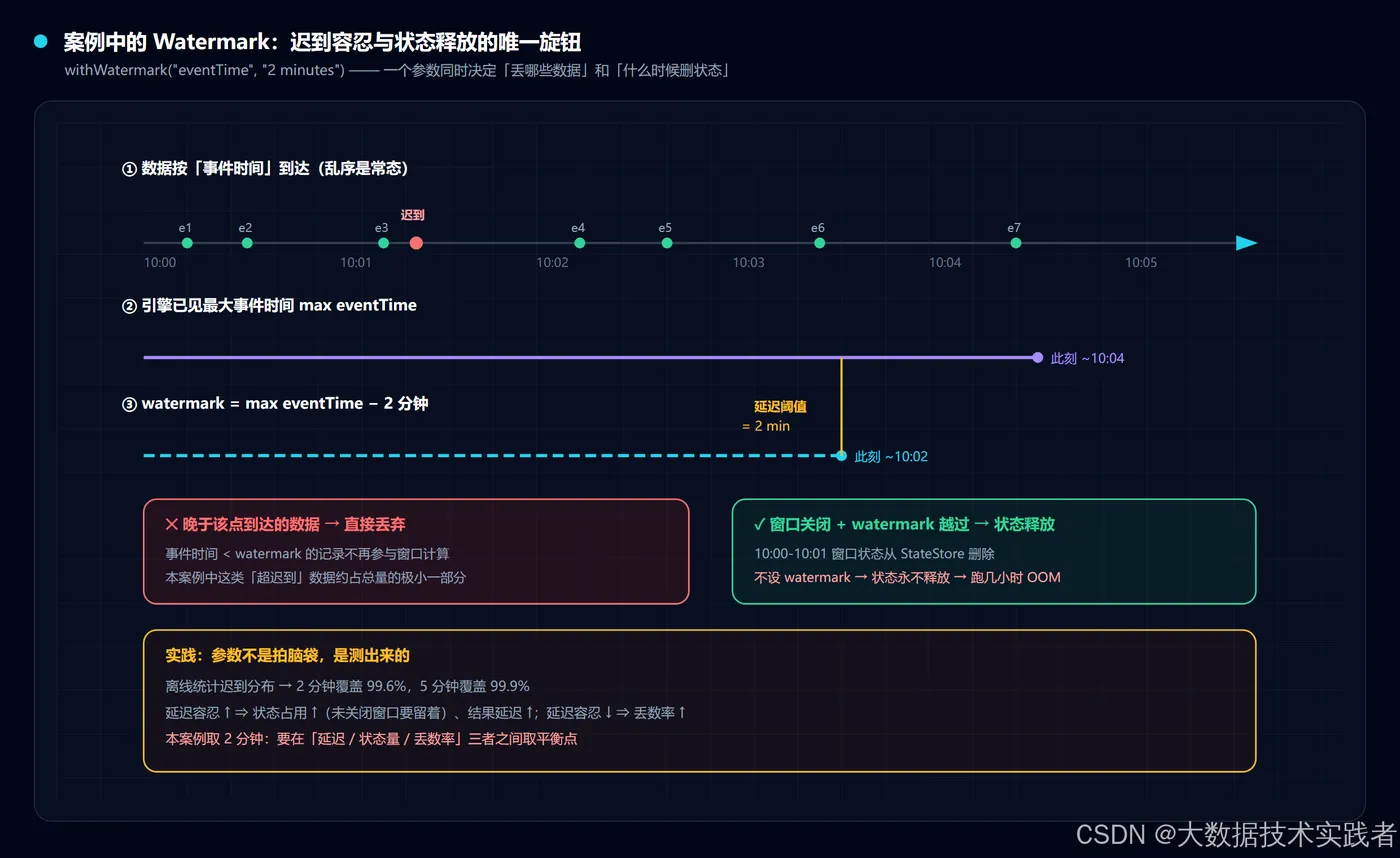
它的行为规则是确定的,但很多人只知道前半句:
- 判断丢弃:引擎维护"已见最大事件时间"。当某个数据的事件时间 <
最大事件时间 − watermark时,在 append 模式下会被静默丢弃(不报错);在 update 模式下,如果窗口状态还没被清除,它仍可能更新已有窗口。 - 触发状态释放:窗口结束时间 + watermark 之后,如果该窗口不再可能被更新,引擎才会把它的状态从 StateStore 删除。这是状态的唯一自动回收路径。
- 决定输出时机:append 模式下,窗口结果要等到 watermark 越过该窗口结束时间才输出(此时才能确认"不会再有数据进来了")。这也是 append 模式配聚合必须带 watermark 的原因——不带你连输出时机都定义不了。
取值方法:用实测迟到达率反推,不要拍脑袋。 我们离线扫了 7 天数据,统计每条记录事件时间与到达时间的差值分布:
-- 离线统计迟到分布(简化示例)
SELECT
  percentile_approx(lateness_sec, 0.5)   AS p50,
  percentile_approx(lateness_sec, 0.99)  AS p99,
  percentile_approx(lateness_sec, 0.999) AS p999,
  MAX(lateness_sec) AS max_lateness
FROM order_arrival_delay
WHERE dt BETWEEN '2026-09-01' AND '2026-09-07'
实测结果:p99 约 40 秒,p999 约 100 秒,极端尾部有几分钟的长尾(多为客户端离线重传)。据此取 2 分钟:覆盖 99.6% 的迟到数据,同时状态保留量可控。
这里有个容易走偏的地方:不要按最大迟到值设 watermark。有人看到极端值 5 分钟就把 watermark 设成 5 分钟,结果是状态要保留 5 分钟内所有窗口、结果延迟至少 5 分钟——"为最坏情况付费,且一直付下去"。正确做法是按 p99 设阈值,尾部长尾用定时离线批任务对账补齐,而不是把流任务的实时性拖下水。
// 三种迟到处理策略,按业务口径选
.withWatermark("eventTime", "2 minutes")   // 接受丢弃:主流做法
// 完全不丢:加大 watermark(延迟与状态同步变大,慎用)
// 可补救:明细走 append + 下游 upsert,用离线批对账兜底
五、结果落地:foreachBatch 幂等怎么写才不出错
大屏读 MySQL,所以结果必须可重复覆盖。foreachBatch 是官方提供的"拿到批 DataFrame 自己写"的钩子,但它的语义必须先讲清楚:
foreachBatch给你的回调是"至少一次"语义。 同一个batchId在任务失败重放时可能被重复执行。引擎保证的是 offset 与 checkpoint 的原子提交,不保证你的自定义写入只跑一次。
所以幂等只能在写入侧解决。三种可行写法:
写法 A:唯一索引 + upsert(本项目采用)
gmv.writeStream
  .outputMode("append")
  .foreachBatch { (batchDF: DataFrame, batchId: Long) =>
    // MySQL 侧建 UNIQUE KEY (window_start, province)
    // JDBC 写走 REPLACE INTO 或 ON DUPLICATE KEY UPDATE
    batchDF.write
      .format("jdbc")
      .option("url", "jdbc:mysql://mysql-host:3306/report")
      .option("dbtable", "gmv_1m")
      .option("isolationLevel", "READ_COMMITTED")
      .option("batchsize", "1000")     // 避免单批事务过大
      .mode("append")
      .save()
  }
  .option("checkpointLocation", "hdfs://nn:8020/chk/gmv-1m")
  .trigger(Trigger.ProcessingTime("30 seconds"))
  .start()
写法 B:Delta Lake MERGE(明细仓场景)
import io.delta.tables.DeltaTable

batchDF.createOrReplaceTempView("updates")
DeltaTable.forPath(spark, "s3a://warehouse/gmv_1m")
  .as("t")
  .merge(batchDF.as("s"), "t.window_start = s.window_start AND t.province = s.province")
  .whenMatchedUpdateAll()
  .whenNotMatchedInsertAll()
  .execute()
写法 C:batchId 去重表(外部系统不支持唯一索引时的兜底)
// 用 batchId 做前置幂等:执行过就跳过(需与业务写入同一事务)
if (!alreadyProcessed(batchId)) {
  writeResult(batchDF)
  markProcessed(batchId)   // 与上一行同一事务提交
}
绝不能做的事:mode("overwrite")、外部系统里的计数器 +1、纯 INSERT 不建唯一约束、在 foreachBatch 里调不可回滚的外部 API。我们第三次事故就是这么来的——早期版本用了无唯一索引的纯 append,任务因 OOM 重启后重放了两批,大屏数字直接翻倍,且没有任何报错。
六、三次线上事故复盘
这一节是本文最值钱的部分,三段都是真实发生、真实定位、真实修复的。
事故一:Driver 内存日复一日被吃掉 —— checkpoint 分区数变更
现象:上线第三天开始,Driver 空闲内存每天少几个 G,GC 日志显示每 30~60 秒一次 Young GC,但回收后内存不回来。任务没报错,只是越来越慢。
定位:翻 streaming progress 日志,发现这个指标高得离谱:
"rocksdbPinnedBlocksMemoryUsage": 21903337784 // 约 22GB 堆外内存
RocksDB 在堆外钉住了 22GB,JVM 的 GC 完全管不到。
根因:这个任务最初用 200 个 shuffle 分区跑过,后来又改成 50 个,但没有换 checkpoint 目录。checkpoint 里存着 200 个 state store 实例的元信息,新配置只认 50 个,RocksDB 把两套实例都保活着——200 个 state store 各自无限缓存,内存直接爆掉。
修复(三件事一起做):
# 1. 换 checkpoint 目录(有状态配置变更的铁律)
spark.sql.streaming.checkpointLocation=hdfs://nn:8020/chk/gmv-1m-v2

# 2. 给 RocksDB 加上限,别让它无限吃
spark.sql.streaming.stateStore.rocksdb.maxMemoryUsageMB=4096
spark.sql.streaming.stateStore.rocksdb.blockCacheSizeMB=128
spark.sql.streaming.stateStore.rocksdb.writeBufferSizeMB=64
spark.sql.streaming.stateStore.rocksdb.maxWriteBufferNumber=3

# 3. 确保 commit 时做 compaction,不要图快关掉
spark.sql.streaming.stateStore.rocksdb.compactOnCommit=true
教训:spark.sql.shuffle.partitions 属于"状态相关配置",改动它 = 改动状态布局。任何有状态查询的算子、聚合键、输出模式、分区数变更,都必须换 checkpoint 目录,否则就是拿内存和正确性赌。
事故二:状态目录 6 小时涨到 300G —— Watermark 缺失
现象:大促前压测,任务跑 6 小时后 state/ 目录 300G,随后 OOM。
根因:v1 版本为了"绝对不丢数据",故意没设 watermark,认为"窗口状态一直留着更安全"。但引擎没有其他机制能判断一个窗口是否还需要保留——没有 watermark,窗口状态就永远不会被清除,key 基数乘窗口数无限累积。
修复:按第四节方法用实测 p99 定 watermark(2 分钟),并切到 RocksDB + changelog checkpointing:
spark.sql.streaming.stateStore.providerClass=org.apache.spark.sql.execution.streaming.state.RocksDBStateStoreProvider
spark.sql.streaming.stateStore.rocksdb.changelogCheckpointing.enabled=true
changelog checkpointing 的作用值得单独说:开启后引擎不再每次都上传完整 RocksDB 快照,而是只上传自上次 checkpoint 以来的增量变更,后台定期做快照。对状态量大的查询,checkpoint 延迟显著下降。它和快照模式向后兼容,可以原地开启,不需要丢状态重跑。
修复后 state 目录稳定在 32G 左右,且不再单调增长——有界状态会走平,无界状态会一直爬,这是判断状态是否健康的核心信号。
事故三:大屏数字翻倍 —— foreachBatch 非幂等
现象:任务因 Executor OOM 重启后,大屏 GMV 显示为实际值的约 2 倍,且"看起来一切正常"——没有异常日志、没有任务失败。
根因:第一版 Sink 用了不带唯一索引的纯 append 写法,重启后引擎从最后一个已提交 offset 重放,foreachBatch 对同一批数据执行了第二次插入,下游没有唯一约束去挡住它。
修复:目标表加 UNIQUE KEY (window_start, province),写入改走 upsert(见第五节写法 A),并加一条数据量对账监控。
教训:foreachBatch 的"至少一次"不是文档里的免责声明,而是必然发生的运行时行为。只要任务会重启(一定会),非幂等的 Sink 就一定会在某天翻倍。
七、上线后必须盯的监控指标
事故三能当天发现,靠的是监控。这套指标建议上线第一天就挂上:
| 指标 | 来源 | 告警条件 | 说明 |
|---|---|---|---|
| batch duration | lastProgress.durationMs.triggerExecution | 持续 > trigger 间隔 | 已经开始落后,是最早的信号 |
| numInputRows | lastProgress.numInputRows | 连续多批为 0 | 上游断了,流不会报错但也没数据 |
| 状态行数增速 | stateOperators[].numRowsTotal | 增速持续为正 | 比绝对大小更早预警,能提前一周发现 OOM |
| RocksDB 堆外内存 | rocksdbPinnedBlocksMemoryUsage | > 设定上限 80% | 事故一的直接指标 |
| Kafka consumer lag | broker 侧 endOffset − latestOffset | 持续增长 | 属于 Kafka 监控,但要和大屏放同一块屏 |
| 结果数据量对账 | 下游表行数 vs 离线核算 | 偏差 > 0.5% | 事故三的兜底 |
注意"状态行数"要盯增速而不是绝对值。有界状态(正确配了 watermark)会走平,无界状态会一直爬——只有第二种会半夜把你叫起来,而趋势能在事故前一周就暴露它。
八、总结
- 需求先翻译成约束:延迟、口径、语义、可恢复性这四条决定了整个技术选型,不要跳过硬线直接选框架;能接受 15 分钟就优先
AvailableNow批跑,成本省八成; - 一条流该拆就拆:写入语义冲突、调优参数冲突、故障隔离三个理由,决定统计与明细应是两个独立查询、独立 checkpoint;
- watermark 用实测迟到分布反推:按 p99 定阈值,尾部长尾交给离线对账,不要按最大值设为最坏情况付费;
- foreachBatch 是至少一次:幂等只能在写入侧解决,唯一索引 + upsert 是底线,非幂等 Sink 迟早翻倍;
- 三次事故的共同点:都是"看起来正常"的沉默故障——内存慢漏、状态慢涨、数字翻倍。加监控比加机器重要,有界状态走平、无界状态爬升,把这条趋势线画出来就赢了一半。