一、第一版长什么样
先说第一版,因为它并不丢人。
业务要跑通「海外用户下单 → 系统去货源平台采购」,最先写的代码一定是这样的:
def fetch_goods(source, goods_id):
    if source == "A":
        signed = sign_a(params, secret_a)
        resp = call_a("/item/get", signed)
        return {"title": resp["item"]["subject"], "price": resp["item"]["price"], ...}
    elif source == "B":
        signed = sign_b(params, secret_b)
        resp = call_b("/product/detail", signed)
        return {"title": resp["name"], "price": resp["skuPrice"], ...}
    elif source == "C":
        ...
接第一个货源时,这段代码很好懂。接第二个开始,你会在每个方法里复制一遍结构。接第三个的时候,你发现改一个共同逻辑(比如加超时重试)要改三处,而且很容易漏。
那次我们的分水岭很具体:要给所有货源调用加「超时后重试一次 + 记录 trace_id」,结果改了六个方法,漏了一个,上线后那一类请求的日志里没有 trace_id,排查时抓瞎半天。
二、演进四段路
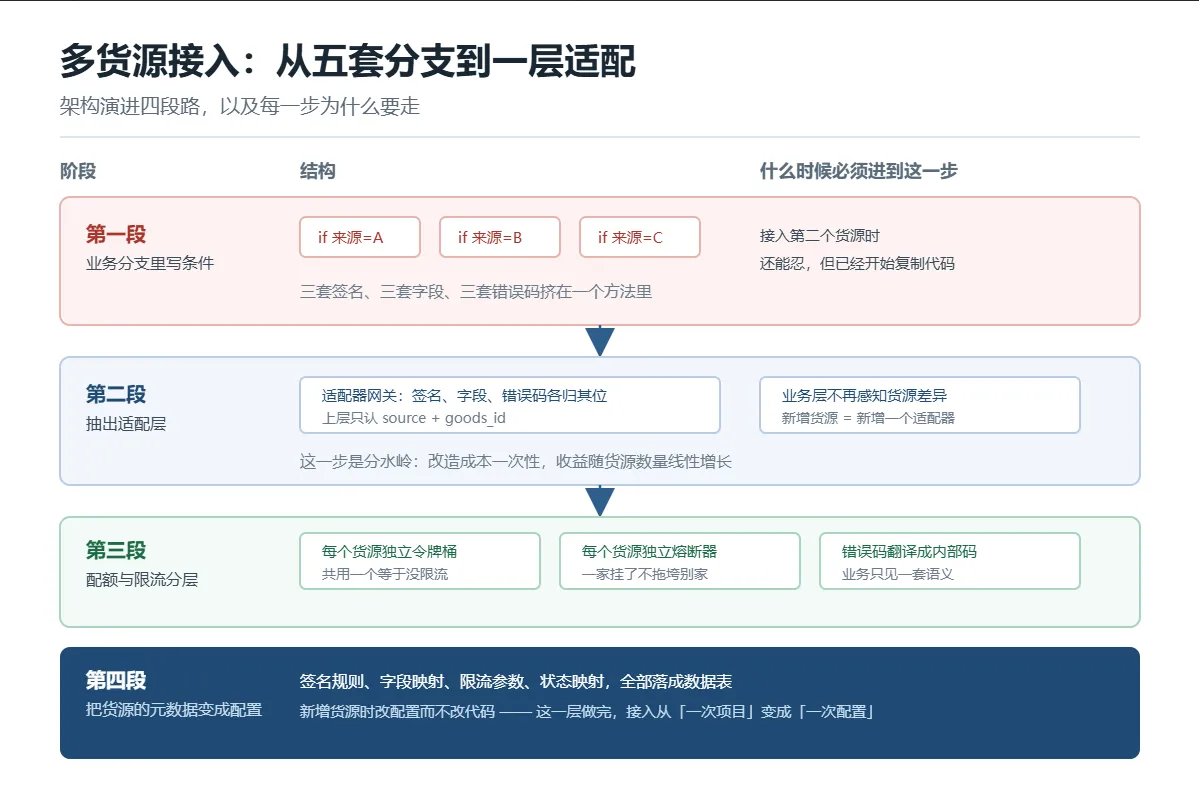
图:四段演进。判断该不该进下一步的标准不是「代码丑不丑」,而是「新增一个货源要改几处」。
第一段:条件分支。 判据:货源数量 ≤ 2,且你还在验证业务。这个阶段别急着抽象,抽象错了比不抽象更贵。
第二段:抽适配层。 判据:出现「同一处改动要在三个以上分支重复改」。做法是把差异收敛到适配器里,上层只认两个参数:source 和 goods_id。这一步是分水岭,做完之后新增货源只是新增一个适配器类。
第三段:配额与限流分层。 判据:开始出现「因为某个货源限流,导致整批同步全部失败」。注意是每个货源独立的令牌桶和熔断器,共用一个等于没做。
第四段:元数据配置化。 判据:适配器数量超过五个,且改动多是「字段映射变了」这类低价值变更。把它们落成数据表,接入就从「一次小项目」变成「一次配置」。
三、适配层的核心代码
这是第二段的核心,一个最小可用的适配器骨架:
from abc import ABC, abstractmethod
from dataclasses import dataclass
@dataclass
class Goods:
    """内部标准模型:上层只见这个结构,不见任何货源字段。"""
    source: str
    source_id: str
    title: str
    price_cents: int      # 一律用「分」存整数,避免浮点误差
    currency: str
    stock: int
class SourceAdapter(ABC):
    name: str = ""
    @abstractmethod
    def sign(self, params: dict) -> dict:
        """差异点一:签名规则,各家不同。"""
    @abstractmethod
    def to_goods(self, raw: dict) -> Goods:
        """差异点二:字段映射,各家命名不同。"""
    @abstractmethod
    def map_error(self, code: str) -> str:
        """差异点三:错误码翻译成内部码。"""
class AdapterRegistry:
    _adapters = {}
    @classmethod
    def register(cls, adapter: SourceAdapter):
        cls._adapters[adapter.name] = adapter
    @classmethod
    def get(cls, source: str) -> SourceAdapter:
        if source not in cls._adapters:
            raise KeyError("未注册的货源: %s" % source)
        return cls._adapters[source]
class WholesaleA(SourceAdapter):
    name = "source_a"
    def sign(self, params):
        # 示意:参数排序后拼接再哈希,细节按各家文档来
        pairs = sorted((k, str(v)) for k, v in params.pairs_iter() if k != "sign")
        raw = "&".join("%s=%s" % (k, v) for k, v in pairs)
        params["sign"] = hash_with_secret(raw, SECRET_A)
        return params
    def to_goods(self, raw):
        return Goods(
            source=self.name,
            source_id=raw["itemId"],
            title=raw["subject"],
            price_cents=int(round(float(raw["price"]) * 100)),
            currency="CNY",
            stock=int(raw.get("quantity", 0)),
        )
    def map_error(self, code):
        return {"SIGN_INVALID": "AUTH_FAILED", "FLOW_LIMIT": "RATE_LIMITED"}.get(code, "UPSTREAM_ERR")
有几个细节值得留意:
第一,price_cents 用整数分。 三家的价格字段一个是字符串、一个是浮点、一个是分。在适配器里一次性转成整数,上层永远不和浮点数打交道。
第二,map_error 必须实现。 很多团队只做字段映射不做错误码映射,结果上层要 if code == "xxx" 才能判断是否限流——差异又漏回去了。把错误码翻译成内部五六个枚举,上层只判断 RATE_LIMITED 就够了。
第三,注册表用 name 而不是类名。 这是为了让第三段的「每个货源独立限流」能按 name 找到对应的桶和熔断器,不用额外维护一张映射表。
四、第二段做完之后,数据能说明什么
改造前后的对比只统计我们自己的系统,没有外部数据:
| 指标 | 改造前(三货源分支) | 改造后(适配层) |
| 新增一个货源需要改的文件数 | 6 | 1(新增适配器) |
| 加一条通用重试逻辑要改的位置 | 3 处以上,容易漏 | 1 处(适配层统一) |
| 上层业务代码里出现的货源判断 | 40 余处 | 0 |
| 字段口径争议(价格单位不一致) | 每月 2-3 次 | 基本消失 |
需要注意的是,这些是我们自己的工作量统计,不代表别人的系统,但方向是通用的:适配层的收益和货源数量成正比,成本是一次性的。
五、检查清单
- 上层业务代码里没有任何货源名称的字符串判断
- 所有金额以整数分进入内部模型,浮点只在适配器内部出现
- 每个适配器都实现错误码映射,内部错误码不超过十个
- 适配器注册表以稳定标识注册,不依赖类名
- 每个货源有独立的限流桶与熔断器,参数可配
- 适配器有独立的契约测试:同一份样例报文,映射结果固定
- 新增货源只需要新增一个文件 + 一段配置,不改业务代码
- 签名逻辑只出现在适配器里,业务层永远不接触密钥
- 适配层的每次上游调用都带 trace_id
六、一句总结
架构演进这件事,判断标准不是「看起来是否优雅」,而是「下一次同类改动要花多少时间」。当答案是「又要改六处」的时候,就该抽那一层了。
做代购、集运、转运的团队,货源平台只会越接越多,这一层迟早要建。早建不一定好,但拖到第十个货源再建,代价会高很多。