
一次关于垂直 Agent 产品设计的认知纠偏
一、那个删掉输入框的用户
那天我在旁边看一个用户用我们的 App。
他盯着输入框看了几秒,打了一句「帮我做个视频」,又删掉了。停了一会儿,他退出对话,去首页翻了翻,再回来,最后什么也没发。
我没上去打断他。因为我知道他为什么删。
他不是不知道自己要什么。他是不确定:我们能不能做视频、做出来是什么样、要不要先传素材、大概要花多少积分。他更不确定的是——这个输入框,到底是不是一个「什么都能问」的通用助手。
如果是,他应该问天气、问新闻、让 AI 写段代码。可我们偏偏不是那样的产品。
那一刻我意识到,我们造了一个非通用的 Agent,却给了它一张通用助手的面孔。
二、能力都藏在模型后面
我们的 Agent 背后有二十多个工具。
它能文生图、做可编辑的 PPT、把 PPT 变成数字人讲解视频、把文档变成动效短片;能配音、克隆声音、克隆形象;能分离人声、剪音频、翻译视频、提取字幕、换脸、增强画质、抠图、识别图片文字、读表格做数据问答。
这些东西,模型都知道。因为我们把工具表注进了系统提示词,也写了详细的工具描述。
但用户不知道。
用户看到的,是一个输入框,和九张「试试这些」的示例卡。发完第一条消息,示例卡就消失了。再往后,页面上只剩下对话,用户只能凭记忆猜:「刚才那个功能在哪来着?」
更麻烦的是,工具表还会按附件类型动态收窄。没有上传音频,「人声分离」就不在模型的能力表里;没有 PPT,「数字人讲解视频」也不会出现。这个设计本身是对的,它防止模型乱调工具。但对用户来说,它变成了一个说不清的现象:
「为什么刚才还能做,现在又不能做了?」
我们试过加更多示例、改提示词、让模型解释得更清楚。效果有限。因为用户不读提示词,用户只看界面。
后来我们终于承认:这不是模型能力的问题,是产品表达能力的问题。
三、问题不在示例数量
一开始,我们的本能是「再加几张示例卡」。
九张不够,就加到十五张;十五张不够,就在文案里多写几句「我还能做什么」。但很快发现,这条路走不通。
第一,示例越多,首屏越像一张功能清单。用户不是来读清单的。
第二,示例只能覆盖一小部分能力。文生图、PPT、配音这些高频的可以放,声音克隆、视频翻译、换脸、表格问答呢?全放上去,页面就炸了。
第三,也是最关键的:示例解决的是「怎么开始」,解决不了「边界在哪」。用户点了示例之外的东西,还是会撞墙。
我们内部复盘时有一句话,我印象很深:
用户不是不会用,是不知道能做什么、需要什么、做完得到什么、做不了怎么办。
这四个问题,才是产品要回答的。示例卡只回答了第一个问题的一半。
四、第一个决定:不把它变通用,把它变可读
想清楚之后,我们做了一个有点反直觉的决定:
不把这个 Agent 做得更通用,而是把它做得更「可读」。
我们不再追求「什么都能聊」,我们追求四件事:
- 一眼看懂它能做什么;
- 一眼看懂做一件事需要什么素材;
- 一眼看懂做完会得到什么、大概要花多少;
- 做不了的时候,知道下一步去哪。
说白了,就是把原本藏在模型后面的能力表,翻译成用户能看懂的产品界面。
我们把它拆成三层:能力地图、常驻入口、边界兜底。
五、首屏:两扇门,而不是一排示例
新的首屏,我们放了两扇门:
- 我有素材:直接打开文件选择器,上传音频、视频、图片或文档;
- 从想法开始:不用素材,直接描述想要的产物。
为什么是两扇门?因为我们的能力本质上就分两类:一类是「素材进来,成片出去」,另一类是「从零生成」。用户第一眼需要的不是二十个功能名,而是一个动作方向。
门后面是能力地图,只放八张主卡:
直接生成:生成图片、可编辑 PPT、动效短片、配音。
素材处理:数字人讲解视频、人声分离、视频翻译、抠图/去背景。
每张卡都写清楚三件事:它做什么、产出什么、大概怎么计费。缺素材的卡片会直接写「需要先上传 PPT/PDF」「需要先上传音频」,而不是等用户点进去再被模型拒绝。
剩下的十六个能力,收在「查看全部能力」里。我们刻意没有一次铺满二十四个。首屏不是功能说明书,首屏只负责让用户迈出第一步。
我们还在首屏最下面写了一句话:
不擅长:闲聊、写代码、实时资讯、站外内容下载。
这句话看起来像在赶客。其实是我们在建立信任。一个敢说自己不做什么的产品,用户才敢相信它说能做什么。
顺便说一个很小的细节:新首屏做完之后,我们在手机上试,发现页面一进来就自动滚到了底部,用户看到的是能力地图的尾巴,而不是开头的两扇门。这个 bug 不影响功能,但它特别典型——我们差点又用「聊天记录」的惯性,去对待一个「能力导航」的页面。
六、能力入口必须常驻
上一版最大的漏洞,是示例卡发完第一条消息就消失了。
用户聊到一半,突然想做点别的,找不到入口。他只能退出重进,或者凭记忆打一句「你还能做什么」。
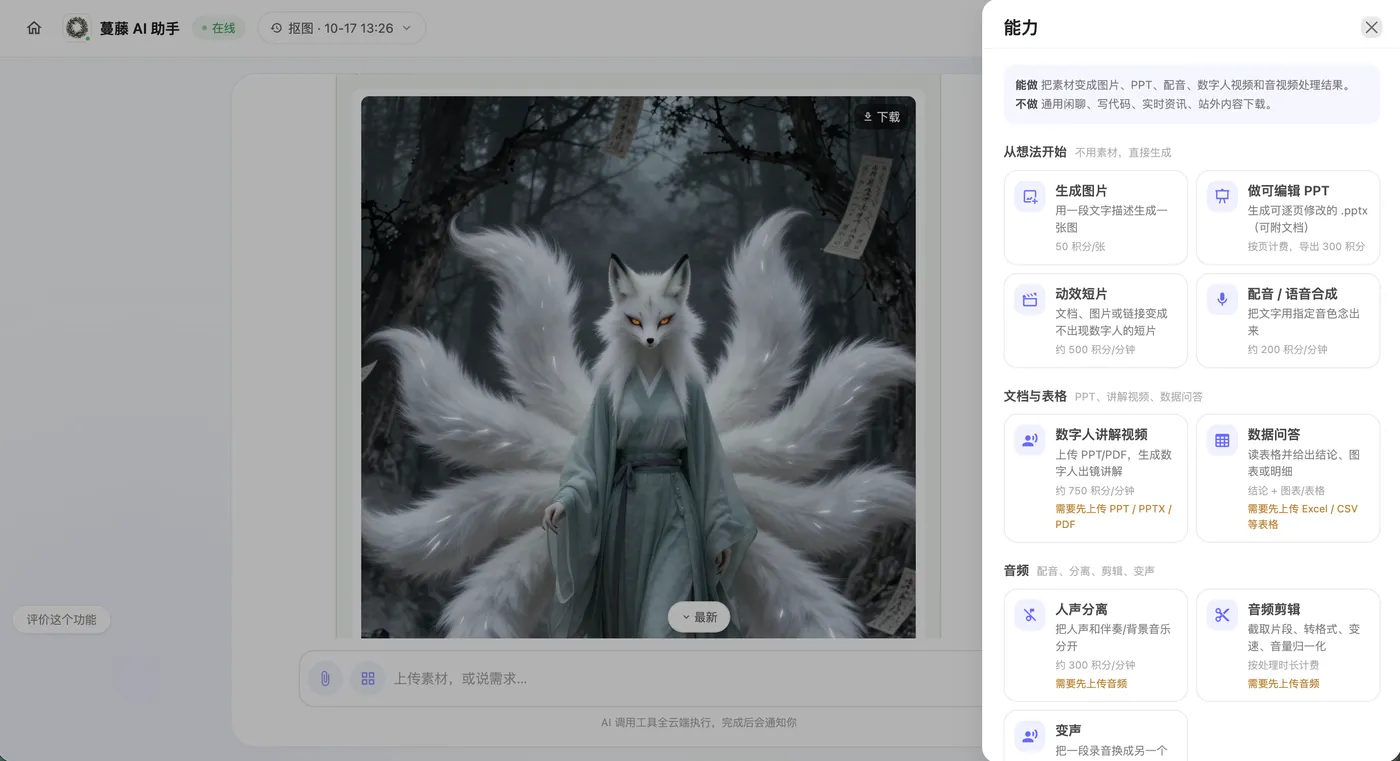
所以这次我们在输入框旁边加了一个固定的「能力」按钮。
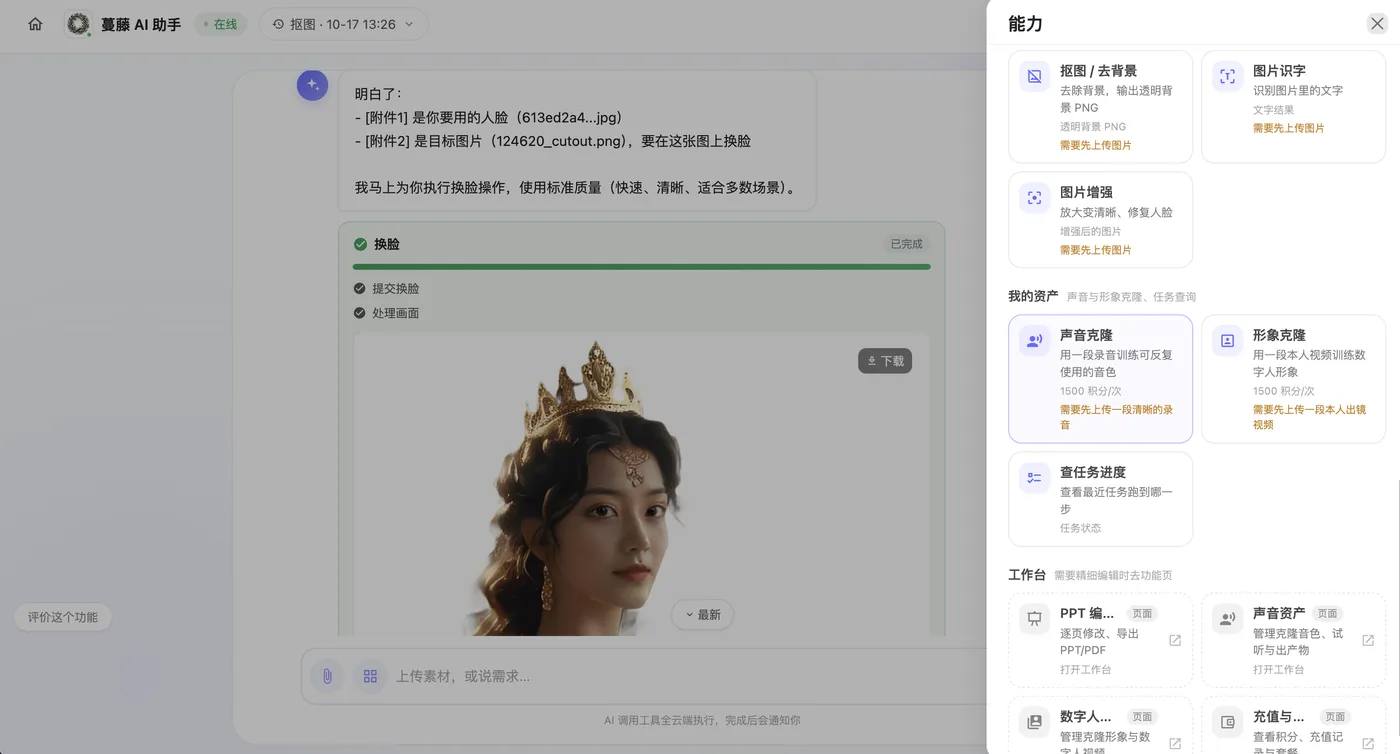
PC 上点开是右侧抽屉,App 上点开是底部抽屉。抽屉里按场景分组:从想法开始、文档与表格、音频、视频、图片、我的资产、工作台。二十四个能力全在里面,但不吵。
更重要的是,它会看用户手里有什么。
如果用户上传了 PPT,「数字人讲解视频」会被提到「适合当前素材」的最上面;如果上传了音频,「人声分离」「音频剪辑」会浮上来;如果是一张表格,「数据问答」会先出现。
这背后没有两套逻辑。首屏的能力地图、常驻抽屉、附件上传后的快捷动作,读的是同一份能力目录。我们不希望三个地方各说一套,最后用户看到的和模型能做的对不上。
七、边界不是一句「抱歉」
以前模型遇到做不了的事,会回一段解释。解释本身没错,但用户听完还是不知道能干什么。
现在我们在界面上多做了一件事:只要模型回复里出现「做不到」「不支持」「无法」这类意思,气泡下面会自动出现三张能点的能力卡。
比如用户问「能帮我查一下今天的新闻吗」,模型说做不到,下面会出现:
- 用这篇文章链接做动效短片
- 把已有素材做成讲解视频
- 打开视频翻译功能页
它不是让模型硬答,而是把用户从死胡同里带出来。
同时,我们也把边界写进了系统提示词:不做通用闲聊、实时资讯、写代码、联网搜索、站外内容下载;遇到这些,用一句话说明,再给出最接近的可做项,或者功能页入口。不要长篇解释,也不要假装能做。
产品界面负责让用户看见边界,提示词负责让模型守住边界。两边说的是同一件事,用户才不会觉得「你刚才明明说可以」。
八、让用户知道代价
还有一个容易被忽略的问题:用户不知道做一件事要花多少。
所以现在每张能力卡上都会写计费提示:生成图片 50 积分/张、配音约 200 积分/分钟、数字人讲解视频约 750 积分/分钟、声音克隆 1500 积分/次。不知道精确价格的,就写「按处理时长计费」,不编。
不是所有能力都适合「点一下直接开始」。有些要先补素材,有些要先确认方案,有些会立即扣积分。我们把「需要什么」写在卡片上,让用户在点之前就有预期,而不是扣完钱才发现和想的不一样。
九、任务做完之后,告诉他下一步
一个能力被用完,不代表这个用户的需求结束了。
做完 PPT,用户可能还想要讲解视频;翻译完视频,可能还要提取字幕;换完脸,可能还想增强画质。以前这些「下一步」都藏在用户的脑子里,现在我们在任务完成后直接给出来。
它不是强行推荐,只是把这条流水线接下来还能往哪走,摆在用户面前。
十、我们刻意没做的事
这次改版,我们克制住了几个很诱人的冲动:
- 没有做「功能大全」页。那会把对话产品变成官网,用户还是不知道从哪开始。
- 没有把聊天做成分步表单。对话仍然是主路径,能力卡只是把手,不是轨道。
- 没有发明一套指令语法。用户不应该为了用一个 AI 产品先学一门语言。
- 没有一次铺满二十四个能力。渐进披露比一次性展示更重要。
- 没有继续靠模型的长篇解释来教育用户。解释是补丁,界面才是产品。
十一、写在最后
我们还没有漂亮的数据可以证明这次改版成功。产品还在早期,很多能力也还在补。
但有几件事,至少在方向上变了:
用户开始知道先传素材,而不是对着输入框发呆;开始点能力卡,而不是反复问「你能做什么」;开始在做完之后,顺着「下一步」继续用下去。
以前我们问自己:怎么让这个 Agent 更通用?
现在我们问的是:怎么让用户在三秒内知道,它为什么值得用。
对话是入口,不是说明书。
一个垂直 Agent 最重要的产品设计,可能不是让它看起来什么都会,而是让它诚实地告诉你:我会什么、我需要什么、我做不了什么,以及做不了的时候,你还能去哪。

