
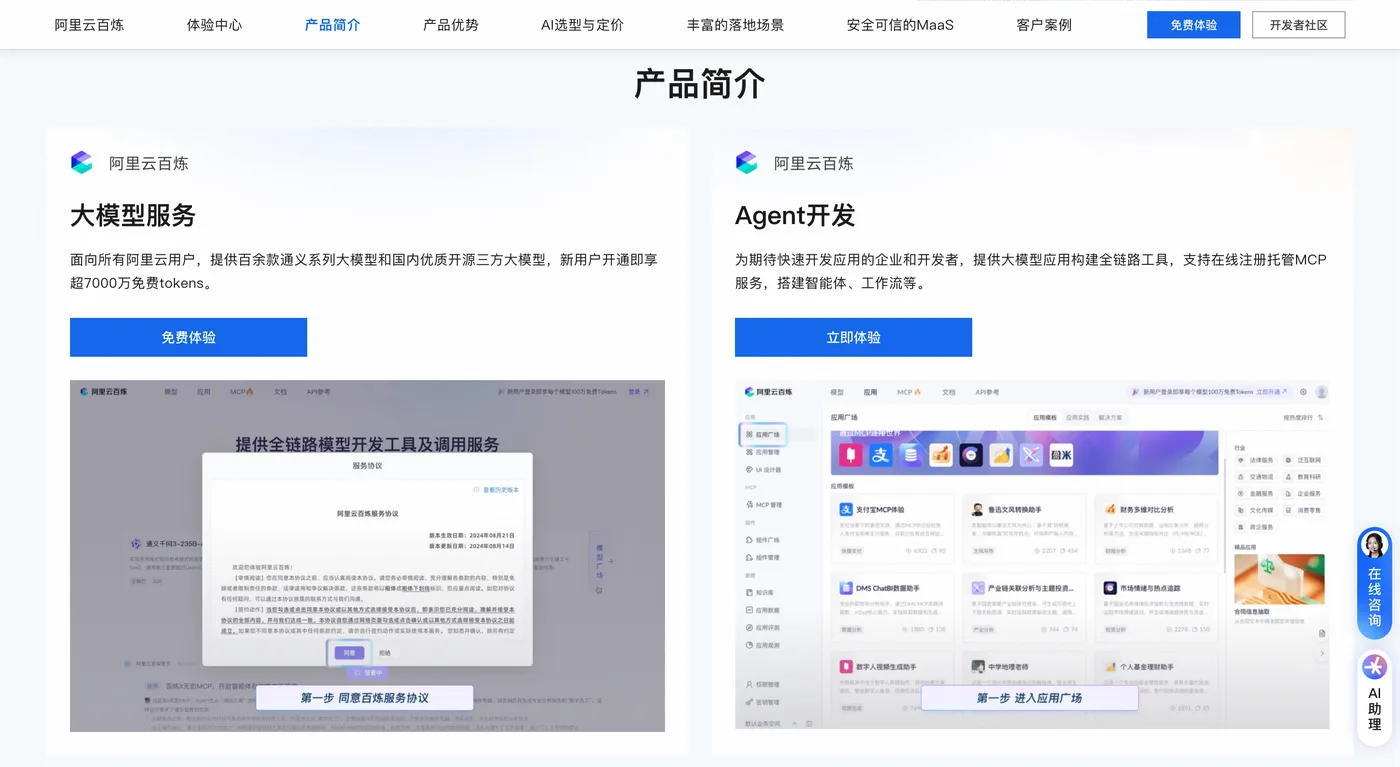
当AI浪潮奔涌而至,智能体时代的帷幕已赫然拉开。通义千问Qwen3.7‑Max,正是阿里云百炼旗下为这场变革量身锻造的纯文本旗舰利器。它并非传统大模型的简单迭代,而是一把开启自主工作流时代的钥匙——跳出被动应答的窠臼,进化为能够驱动复杂长周期任务的智能体基座。以下从技术内核到功能矩阵,从使用入口到计费策略,为您全面拆解这款重磅模型。更多详情请前往阿里云百炼大模型服务平台页面了解。
一、技术架构:万亿参数MoE架构,旗舰质量与推理效率兼得
Qwen3.7‑Max并非传统稠密大模型的粗暴堆叠,它在Transformer基础上引入了高稀疏度MoE混合专家架构,这是其核心竞争力的根基所在。
整体总参数量突破一万亿,预训练阶段汲取多达36万亿Tokens的海量数据,覆盖开源代码库、学术论文、行业文档、百科知识、多语种文本等多元化内容。然而推理时并非全盘激活,仅按需激活约2200亿规模的核心专家参数参与运算,以稀疏激活机制在旗舰级输出质量与推理算力消耗之间达成精妙平衡。
混合注意力机制深度优化,长文本理解与跨段落上下文关联能力提升35%;专家路由算法迭代升级,复杂任务场景下模块匹配精准度提升20%,有效减少无效专家激活;推理引擎底层重构,整体推理速度较上代提升40%,同时Token消耗下降25%。
模型搭载独立扩展思考推理层,开启深度思考模式后先在内部完成完整逻辑推导再输出答案,有效缓解推理跳跃与逻辑断层。针对超长输入场景,注意力计算做了专项优化,抑制信息衰减,使长文档召回更为精准。
与自研真武M890 AI芯片深度适配,算子与硬件指令做针对性匹配,推理延迟最大降低50%,形成芯片、模型、云服务一体化的全栈AI闭环。
如需深入了解架构细节与接入方式,请访问阿里云百炼大模型服务平台页面。
二、核心功能矩阵:六大能力铸就智能体时代底座
Qwen3.7‑Max的功能体系围绕"长周期自主执行"这一核心定位展开,六大能力环环相扣、互为支撑。
1. 长周期智能体与多轮链式工具调用
这是Qwen3.7‑Max最具颠覆性的能力。它专为长周期自主Agent任务深度优化,支持上千次连续工具调用,能够在数十小时内自主判断时机、解析返回结果、循环迭代直至任务闭环。
官方实测场景下,模型可不间断连续运行35小时,完成1158次工具调用,独立执行内核优化任务,全程无需人工介入,实现十倍左右的性能加速,且不出现上下文退化。
自主任务拆解能力成熟:面对"复现一篇AI论文并完成调优"这类复杂目标,模型会自动拆分为多个子任务,生成执行计划,分配资源分步落地。
兼容MCP多智能体协作协议,可对接各类生产力工具,调度多个智能体分工处理跨领域复杂工程,例如从一份需求文档直接输出前后端整套项目加上数据库设计。
闭环自适应优化机制:任务执行过程中持续校验输出结果,发现偏差自动调整策略,形成"执行—反馈—修正"的完整闭环,长周期任务整体完成率提升40%。
2. 百万级超长上下文与长文档深度解析
Qwen3.7‑Max原生支持256K Tokens超长上下文窗口,换算成中文约20万字,可一次性摄入200页PDF合同、一整年财务报表、百万规模项目源代码、整本图书文本。
无需人为对文档做分段切片,完整保留全部上下文逻辑,从根本上避免传统大模型切片带来的上下文割裂、关键信息丢失与逻辑断裂。
依托全局信息做判断,长文本场景事实幻觉错误率下降55%,输出内容可信度大幅提升。
擅长跨章节细节检索、逻辑关联、对比分析,而非仅做摘要提取——法律合同风险审查、财务报表深度推演、学术论文研读、大型技术文档梳理均可胜任。
支持上下文缓存功能,多轮对话与RAG知识库场景开启缓存后,重复输入Token单价大幅降低,缓存命中后输入Token单价可降至原价的十分之一甚至更低,显著控制长期调用成本。
3. 多文件代码工程开发能力
在代码智能体领域,Qwen3.7‑Max处于全球第一梯队,多项公开基准测试斩获高分:Terminal‑Bench 2.0达72.3、SWE‑Pro 60.4、SWE‑Multilingual 78.4、NL2Repo 47.3、SciCode 52.7,支持上百种编程语言。
完整项目一键生成:只需用自然语言描述业务需求,即可从零产出包含架构设计、多份代码文件、依赖配置、测试用例及README文档的完整项目。
仓库级代码理解与重构:能够解析百万行规模项目源码,识别冗余逻辑与潜在Bug,完成跨文件、跨模块的重构迭代。
专业调试诊断:读取完整报错日志,定位代码故障根源,给出可直接落地的修复方案,工程代码运行成功率提升60%。
长周期自主编程:在代码工程智能体场景下,模型可自主编写代码、运行单元测试、定位报错、迭代修复,完成完整工程开发流程。
4. 结构化输出与批量推理能力
原生支持强制JSON结构化输出,能够稳定按照用户指定的JSON格式返回结果,后端程序可直接解析,省去复杂文本清洗与正则提取逻辑。
支持批量推理,一次性处理多条文本任务请求,大幅提升大批量文本处理的并发效率。Batch File与Batch Chat模式均有限时5折优惠。
内置前缀续写能力,适合代码补全、文档续写等场景。
内置联网搜索能力,当任务需要实时信息时可调用搜索工具获取外部资料辅助推理。
5. 专业文本办公自动化能力
针对办公场景深度优化,Qwen3.7‑Max在多文档协同分析、跨文档信息汇总、业务报告自动撰写、大量文本对比分析等任务上表现稳健。
批量读取多份合同文档,提取风险条款、对比不同版本差异,输出结构化报告。
支持PDF、Word、Excel多格式文档读取分析,表格评测SpreadSheetBench达84.5分,能够解析复杂数据表、计算指标、生成可视化图表。
支持自定义自动化工作流,完成文件整理、邮件处理、报告批量生成。
6. 复杂推理与多语种能力
在专业推理基准测试中表现卓越:GPQA Diamond 92.2、Apex 43.5、IFBench 81.2、多语言WMT24++ 85.9、MAXIFE 89.3,在数学、金融、法律、科研等专业领域均有优秀表现。支持超过100种语言,严格遵循用户各类约束条件。
更多能力详情,请参阅阿里云百炼大模型服务平台页面。
三、使用入口与实操代码
Qwen3.7‑Max提供多种接入方式,覆盖从零代码到深度定制的全谱需求。
Web网页端:普通用户最简便的体验渠道,打开网页登录账号,模型列表选择Qwen3.7‑Max即可对话,适合快速验证与简单文档分析。
客户端程序:提供Windows、macOS客户端,安装登录后选择对应模型,支持窗口快捷唤起与多会话并行管理,适合高频办公与代码调试。
API调用:通过Python SDK或兼容OpenAI格式的接口即可接入,以下为可直接运行的基础代码示例:
python
from dashscope import Generation
import os
os.environ["DASHSCOPE_API_KEY"] = "你的API密钥"
messages = [{
"role": "user",
"content": "帮我分析这份项目需求,生成接口设计JSON"
}]
tools = [{
"type": "function",
"function": {
"name": "get_project_info",
"description": "读取项目基础信息",
"parameters": {
"type": "object",
"properties": {
"project_id": {"type": "string"}
},
"required": ["project_id"]
}
}
}]
resp = Generation.call(
model="qwen3.7-max",
messages=messages,
tools=tools,
result_format="message",
enable_thinking=True
)
print(resp.output.choices.message)
关键参数说明:
enable_thinking控制思考模式开关,复杂推理任务开启,简单场景关闭以节约Token
result_format设为message以支持工具调用格式,普通问答去掉tools参数即可降低消耗
调用前需在阿里云百炼平台获取API Key并配置环境变量
CLI命令行工具:支持Token Plan一键配置,适合开发者快速接入本地Agent。查询调用记录可执行:
aliyun dashscope ListCallRecords --Model qwen3.7-max --StartTime 2026-09-01T00:00:00Z --EndTime 2026-09-16T23:59:59Z
详细接入指南请访问阿里云百炼大模型服务平台页面。
四、计费规则与成本优化策略
Qwen3.7‑Max作为纯文本旗舰模型,相比多模态版本在无图片视频场景下具有天然成本优势——不会产生图片、视频折算Token的额外开销。但其计费体系仍需精打细算。
计费模式一览
按量计费:输入原价12元/百万Tokens,输出原价36元/百万Tokens,适合短期验证。
资源包:预付费套餐,一次性购买固定额度Token,单价低于按量计费,适合项目验证与短期集中测试,存在有效期且到期未用额度自动失效。
Token Plan订阅套餐:包月模式,额度可跨多款模型共享,适合长期稳定调用的业务,个人版最低39元/月,可搭配Coding Plan享受专属折扣。
节省计划:面向企业大规模长期调用,采购周期越长折扣力度越高,自动抵扣账单。
抵扣优先级:免费额度 → 资源包 → 订阅套餐 → 全部耗尽后自动切换按量计费。
关键计费避坑要点
该模型只处理文本,若业务包含图片、截图、图表,需提前用OCR提取文字后再交给模型,否则无法处理。
Function Calling工具返回内容同样计入输入Token,长周期Agent任务大量工具返回会持续消耗,需做好预算规划。
开启深度思考模式会增加输出Token消耗,非复杂推理任务务必关闭。
上下文缓存是控制成本的核心武器——显式缓存创建原价15元/百万Tokens,但缓存命中后仅1元/百万Tokens;隐式缓存命中后输入Token单价降至0.1元/百万Tokens级别,在RAG与多轮长对话场景中务必开启。
订阅套餐与资源包不可叠加代金券,部分企业POC专项券可用于购买资源包。
新用户开通百炼可领取超7000万Tokens免费额度(每模型100万),有效期90天,仅华北2(北京)地域生效,建议开启"免费额度用完即停"防止超支。
完整定价详情与规格对比请前往阿里云百炼大模型服务平台页面查看。
五、业务选型:什么场景该用Qwen3.7‑Max?
选型是项目成败的第一道关卡。Qwen3.7‑Max并非万能钥匙,它有明确的能力边界与最佳适配场景。
适合选用的场景:专业深度文本分析(金融财报推演、法律合同逐字审核、长篇学术论文梳理)、大型软件工程(百万级代码重构、系统分库分表改造)、超长自治智能体(长时间连续文档整理、多步骤深度数据复盘)、纯文本高难度推理任务。
不适合选用的场景:任何涉及图片、截图、视频、图表识别的业务——这是Qwen3.7‑Max与Qwen3.7‑Plus的关键分界线,前者为纯文本旗舰,后者才是多模态版本。
与同系列模型的梯度关系:Qwen3.7‑Flash响应最快、成本最低,适合高并发批量简单任务;Qwen3.7‑Plus综合性价比最优,兼顾文本与多模态;Qwen3.7‑Max追求极致纯文本推理精度;Qwen3.8‑Max则是最新旗舰多模态版本,支持文本、图像、长视频输入。
生产环境建议:搭建多模型分层架构——Flash承接绝大多数简单请求,检测到复杂推理时自动切换至Max,兼顾效果与成本。
选型判断与更多对比分析,请访问阿里云百炼大模型服务平台页面获取完整指引。
六、总结
Qwen3.7‑Max,以万亿MoE架构为骨、百万上下文为翼、千次工具调用为魂,锻造出一款真正面向智能体时代的纯文本旗舰。它不追求花哨的多模态噱头,而是将全部算力倾注于文本推理、长任务规划、代码工程、深度分析这些硬核能力之上。对于追求极致纯文本推理质量、搭建复杂Agent系统、处理超长专业文档的开发者与企业而言,它是当下最值得托付的基座模型。
即刻启程,前往阿里云百炼大模型服务平台页面,开启您的智能体开发之旅。

