
TUTORIAL · 存量整理2026.10
一堆散根只能手动点?
不用调模型,也能一键归位
半小时收编一地散根
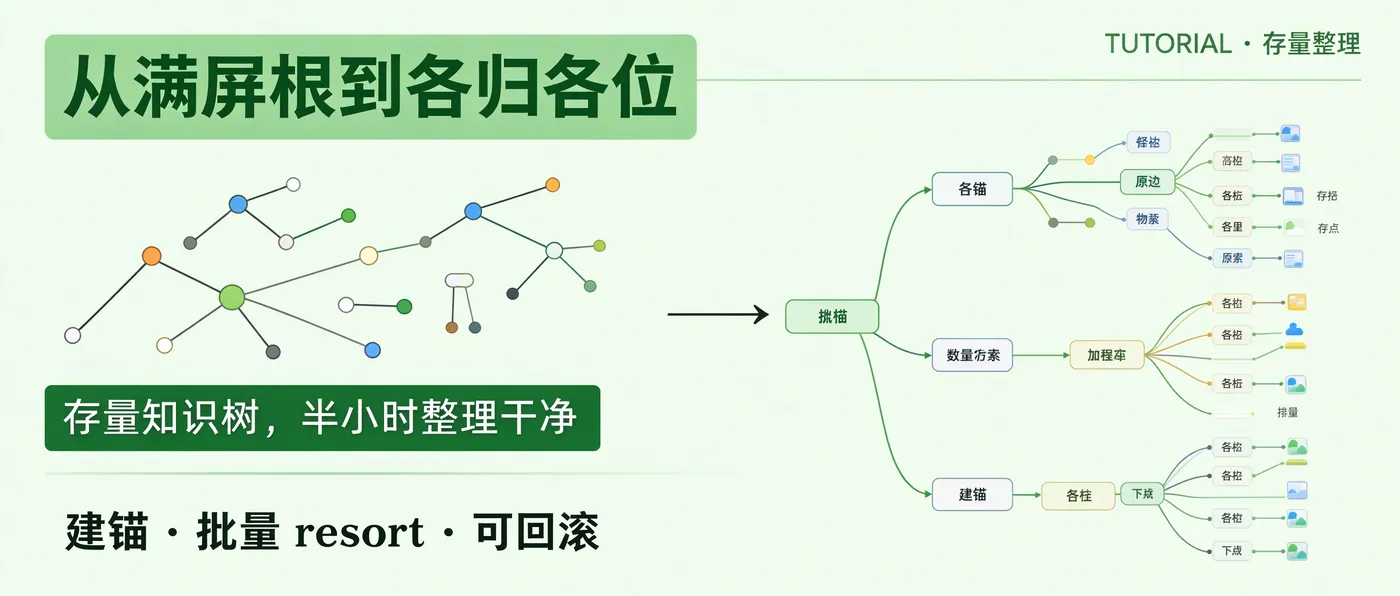
确定性分组 · 先 dry-run · 可回滚
rsrs · Respire
零模型可回滚
📦 3 个重点 + 收尾
👉 滑动
- PART 01先给树做体检看它碎成什么样
- PART 02建锚 + 批量归位纯规则 可回滚
- PART 03顺手用脚本默认 dry-run
- PART ///写在最后几个坑先避开
rsrs extract 有多爽,第二天满屏散根就有多头大
照着抄就行:不用调模型,不用赌运气,还能回滚。
01 · 先说个背景,你大概率也碰上过
WHY · 它到底是从哪儿冒出来的
兄弟们,AI 用到现在,谁还没几个「会话摘要」啊。
我平时 IDE 里一个、终端里一个、聊天框里还有一个,每个 agent 聊完,rsrs extract 都挺懂事地给我生成一条摘要记忆,默认还是 important。我一开始可开心了,觉得这不就是自动记笔记嘛,白捡的。
直到有一天,我打开了自己的知识树。
02 · 然后我就麻了
MESS · 几百条谁也不挨着谁
几百条记忆,整整齐齐地飘在根节点那一层,谁也不属于谁。
你说它是垃圾吧,不是,每条都是我真金白银聊出来的;你说它是资产吧,它全散着,我搜一条得从几百个根里扒。
我最开始还想偷懒,跑了会儿内置的梳理。classify --plan,本地那个,结果显示 proposed 0——好家伙,它压根不做语义归类。想上 classify --tree --auto 呢?得先配分类后端。我就一普通用户,犯不上为这个再挂个模型。
更坑的是 audit,它给我报了个全绿,我一度以为没毛病。
!踩坑提示 🕳
后来才搞明白,orphans 这个指标只管「父 id 悬空」,根节点它压根不算。所以我这棵树碎成渣了,它也说「一切正常」。
03 · 我到底想要什么
GOAL · 让散根各回各家
说白了就一件事
让这几百条散根,各回各家。
按项目、按话题,钻进树里该待的位置。不用我一条条手点,也别让我为了这个去调用什么大模型——我就想安安静静地把存量收拾干净。
04 · 我是怎么搞定的
HOW · 纯规则也能干
后来翻到一份操作手册,才反应过来:这事儿根本不用模型,纯规则就能干,而且可逆。
思路特别朴素:
确定性分组
工作目录 + 关键词
→
建归档锚
一个项目/主题一个
→
一次 resort
批量挂进去
全程先 dry-run,没确认之前一个字节都不写
✦ 不满意怎么办
改回来就是。整条流程不依赖模型、每次都一样,还能还原,主打一个心里有底。
我照着手册走了一遍,大概长这样——
05 · 我用了半小时,说几个真实的瞬间
HANDS-ON · 五个瞬间
照着手册走了一遍,前后大概半小时。下面这五个瞬间,我印象最深。
STEP 01
动手之前先体检
先把家底摸清楚,跑这三条就够:
...bash
rsrs status # data_dir / 条数 / 设备
rsrs resort --status # TIDY 计数(是否需要整理)
rsrs tree-cure # roots 数量 + lone-leaf 挂载建议
最后那行输出我印象最深,它直接把「多少个根、多少个孤零零的叶子」甩我脸上。看完我就知道,这不是小活了。
!踩坑提示 🕳
沙盒里跑记得加 --client-only。还有,先核对 data_dir,别照搬别人的路径,我一开始差点踩。
STEP 02
备份这件事,真别省
动手之前先导一份快照:
...bash
rsrs export <持久目录>/memories_YYYYMMDD.json
手册里特意强调:放持久目录,别扔临时目录。因为本地库没有版本历史,update、merge 这俩操作不可逆。我导完那一刻心里踏实多了,后面再怎么折腾都不慌。
STEP 03
建锚,就是给散根找「户口本」
在目标树根下,一个项目/主题建一个归档锚:
...bash
rsrs remember "<一句话说明此锚用途>" \
--title "会话归档:<某项目>" \
--type context --importance important \
--parent 编程开发 --json
--parent 能用 id、前 8 位或者树名。注意啊——锚绝对不能裸存成根,必须带上它,不然你又亲手造了个新的散根,笑死。
STEP 04
写规则、批量挂、看结果
对每条散根,按「工作目录 → 项目关键词」决定进哪个锚。规则要从具体排到宽泛,具体项目得排在通用词前面,不然会串类。命不中的,全丢进「其他」兜底锚。
然后就是关键的一步,先 dry-run 再落库:
...bash
rsrs resort --spec '<JSON>' --json # dry-run:status=pending, moved=N
rsrs resort --spec '<JSON>' --go --json # 落库:status=ok, moved=N, counter=reset
看到 moved=N 那个数字跟我的预期对上了,我才敢加 --go。
STEP 05
收尾复验,看数字往下掉是真的爽
挂完别急着走,回头验一遍:
...bash
rsrs audit --json # 期望:orphans=0、truncated=0
rsrs tree-cure # 期望:lone leaf 大幅下降 or 归零
rsrs resort --status # 期望:PASS(计数已复位)
rsrs tree --outline --json # 目视各锚下的子条数
我那棵树,roots 从一大坨掉下来,lone leaf 基本清零。舒服。
06 · 顺手教你,我自己就是这么装的
SCRIPT · 懒人版脚本
上面那套手动跑一遍就够了。懒一点的话,手册里还配了脚本,跟 rsrs 同机跑,默认就是 dry-run:
...bash
python tidy_extracted.py # 预览:散根数 / 分布 / dry-run moved
python tidy_extracted.py --go # 确认后落库
它会自己把全流程跑一遍:导出快照 → 找无父的散根 → 按规则分类 → 建/复用锚 → 组 resort --spec → 预览或落库。
用之前,把脚本顶部配置区改成你自己的:
PREFIXES
算作散根的标题前缀(如果导入条目带 session-import 这种 tag,它会优先认 tag,前缀作兜底)。
TARGET_ROOT
归档锚挂在哪个树根下。
ANCHORS
主题对应的关键词规则,最后一条 OT 是兜底,别删。
路径或者环境比较特殊的话:
...bash
python tidy_extracted.py --rsrs <rsrs可执行文件> --client-only --backup <快照路径>
07 · 坦白说,它也有几个坑
PITFALLS · 我踩过的坑
我不藏着,这几个是我踩过、或者手册明确点出来的,你注意下:
1
一定要先 dry-run。resort 默认不写,看到 status=pending, moved=N 再上 --go。
2
resort --go 会顺手把 TIDY 计数复位(counter=reset),这是预期行为,不用再敲一次 --reset。
3
同名不等于真重复。这些摘要常共用一句样板开头,same_title_groups 大多是假阳性,别一看到同名就合并。
4
defrag 报的簇也基本是假阳性。分类根、同句式、同树的相邻枝,一律别并。
5
真要合并重复条,先查子条,合并后立刻把孤儿子条改挂过去,不然又碎。
6
PowerShell 给原生程序传带引号的 JSON 很容易丢引号,稳一点就走 Python 的 subprocess 列表传参。
7
Windows 上 Python 默认编码是 cp1252,打印中文会直接崩,先设 PYTHONIOENCODING=utf-8,或者给标准输出重设一下编码。
8
单批别太大,spec 超 300 条左右就分块。
✦ 回滚也很省心
改挂错了,把子条 resort 改回原父就行;锚空了可以 rsrs forget 软删,rsrs restore 能捞回来。
08 · 有句话得说清楚
SCOPE · 适用范围
这套流程主要治的是存量散根,以及把记忆迁到新库之后、把导入的条目批量归位这两种情况。
如果你的 extract 已经内置了「无父就默认挂某个树根」的加固,那新导入的其实就不会再生散根了——你也就不太用得上这份手册。
手册里也提了一嘴,真想更省事,可以用模型做语义归类(classify --tree --auto),但那得先配分类后端。我这种懒人,还是喜欢上面这套确定性收编:不依赖模型、每次都一样、还能还原。
/// · 你要是也攒了一堆散根,不妨试试
CTA · 半小时的事
治的就是「AI 帮我记得多,但是乱」这个病。
你要是那种导了一堆会话、看着满屏根节点犯愁的人,别一条条手点了,按上面走一遍,半小时的事。
先去跑个 rsrs tree-cure,看一眼你的树有多碎。吓一跳之后,你就会想动手了,哈哈。
我是 百年江湖 随意沉浮,怕什么真理无穷,进一步有进一步的欢喜。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
点赞
在看
转发
THANKS FOR READING
