Java的if是语句,Scala的if是表达式;Java的for是循环,Scala的for是推导式。理解Scala控制流的"表达式思维",是写出地道Scala代码的关键。
如果你从Java转到Scala,写第一个if语句时可能会困惑:为什么if后面没有分号?为什么for循环里有个yield?为什么没有break和continue?
这些困惑的根源在于:Java的控制结构是"语句",而Scala的控制结构是"表达式"。
Java里,if是一条语句,你需要单独声明变量再赋值;for是一条循环语句,用来重复执行代码块;switch是一条选择语句,用来分支执行。而Scala里,几乎所有控制结构都是表达式,都有返回值。
这个设计哲学看似微小,却带来了根本性的差异:你可以用if表达式直接赋值、用for推导式生成新集合、用match表达式替代整段if-else链。控制流不再是"命令计算机做什么",而是"描述你想要什么结果"。
这篇文章从七个层面拆解Scala的循环与判断,帮你建立从Java命令式到Scala表达式式的思维转变。
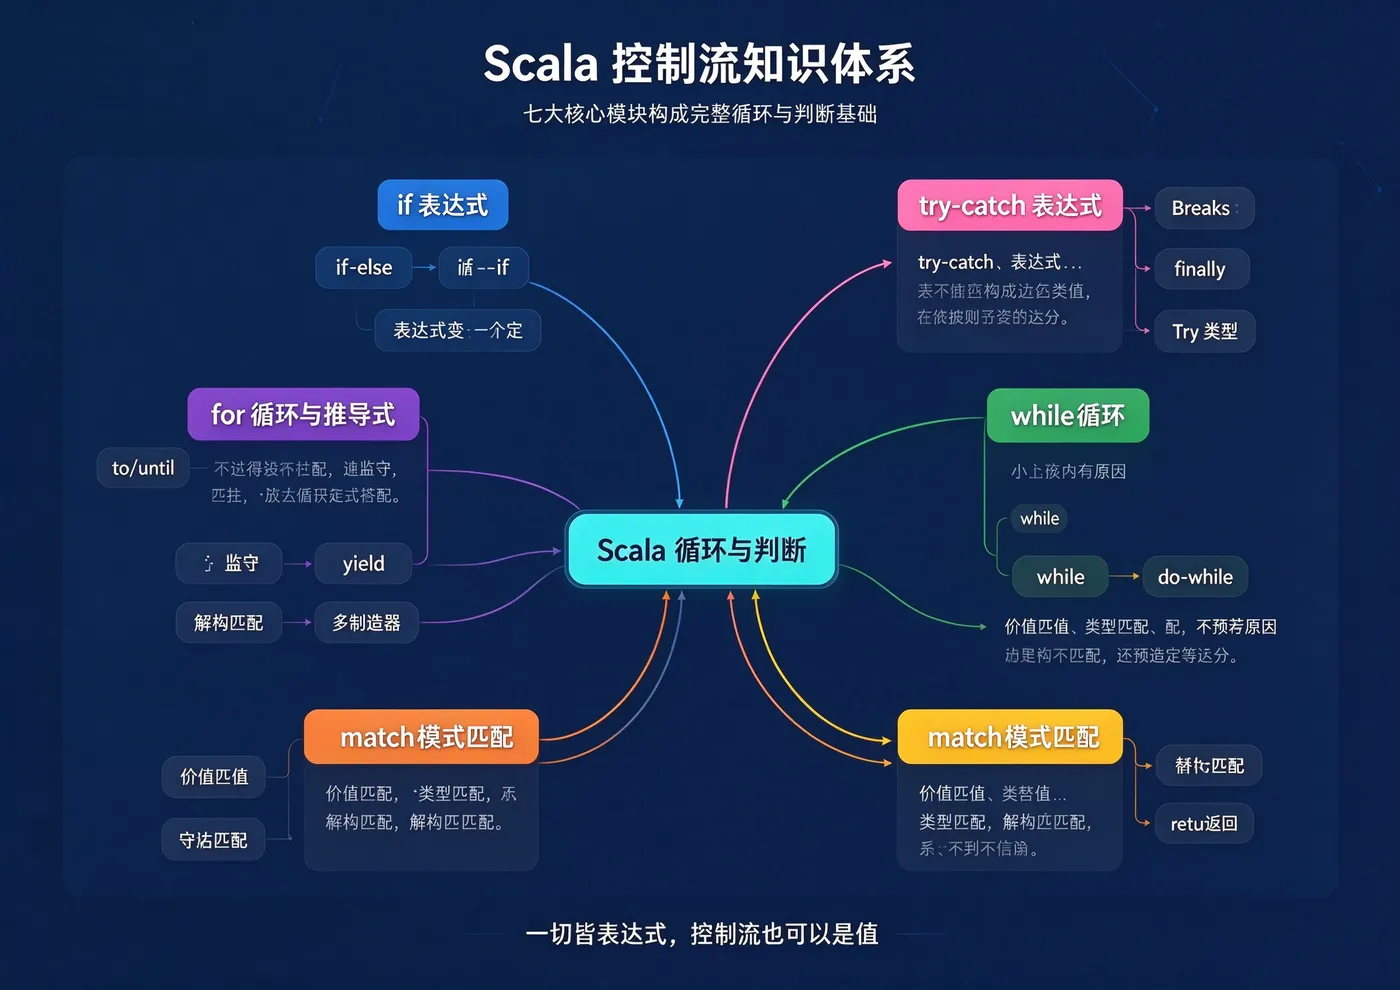
01 if表达式:一切皆有返回值
if是表达式,不是语句
Java里,if是语句,你需要这样写:
// Java: if是语句
String result;
if (x > 0) {

    result = "positive";
} else {

    result = "non-positive";
}
Scala里,if是表达式,直接返回值:
// Scala: if是表达式
val result = if (x > 0) "positive" else "non-positive"
这不是语法糖——这是根本的思维转变。if表达式的结果可以直接赋值、传递、作为函数返回值。
// if表达式作为函数返回值
def classify(n: Int): String = if (n > 0) "positive" else "non-positive"

// if表达式嵌套
val grade = if (score >= 90) "A"
            else if (score >= 80) "B"
            else if (score >= 70) "C"
            else "D"

// if表达式作为参数
println(if (isEmpty) "空列表" else "非空列表")
表达式vs语句的本质区别
| 维度 | Java(语句) | Scala(表达式) |
|---|---|---|
| if | 分支执行代码块 | 计算并返回一个值 |
| for | 重复执行代码块 | 生成新集合 |
| match | 分支执行 | 计算并返回一个值 |
| try | 异常处理 | 捕获异常并返回值 |
| 语句结尾 | 需要分号 | 不需要分号 |
核心原则:在Scala里,能写表达式就不写语句。表达式有返回值,可以组合、可以嵌套、可以传递;语句只是执行副作用。
02 for循环与for推导式
Scala的for比Java强大得多。它不仅是循环,还是推导式(for-comprehension)——可以用来生成新集合。
基础for循环
// to: 包含上界
for (i <- 1 to 5) print(i)     // 12345

// until: 不包含上界
for (i <- 1 until 5) print(i)  // 1234

// 遍历集合
val fruits = List("apple", "banana", "orange")
for (f <- fruits) println(f)

// 带索引遍历
for ((fruit, index) <- fruits.zipWithIndex) {
  println(s"$index: $fruit")
}
守卫(for if)
类似Java的for循环里加if条件:
// 打印1到10的偶数
for (i <- 1 to 10 if i % 2 == 0) println(i)

// 多个守卫
for (i <- 1 to 20 if i % 2 == 0 if i % 3 == 0) println(i)

// 等价写法
for (i <- 1 to 20 if (i % 2 == 0) && (i % 3 == 0)) println(i)
多生成器(嵌套循环)
// 两层嵌套循环
for {
  x <- 1 to 3
  y <- 1 to 3
} println(s"($x, $y)")

// 等价于Java:
// for (int x = 1; x <= 3; x++) {
//     for (int y = 1; y <= 3; y++) {
//         System.out.println("(" + x + ", " + y + ")");
//     }
// }
for推导式(yield)
这是Scala for最强大的特性——用yield收集结果,生成新集合:
// 用yield生成新集合
val squares = for (i <- 1 to 5) yield i * i
// squares: Vector(1, 4, 9, 16, 25)

// 带守卫的推导式
val evenSquares = for (i <- 1 to 10 if i % 2 == 0) yield i * i
// evenSquares: Vector(4, 16, 36, 64, 100)

// 多生成器推导式
val pairs = for {
  x <- List(1, 2, 3)
  y <- List('a', 'b')
} yield (x, y)
// pairs: List((1,a), (1,b), (2,a), (2,b), (3,a), (3,b))
for推导式与map/flatMap的关系
for推导式本质上是map、flatMap、withFilter的语法糖:
// for推导式
val result = for {
  x <- Some(3)
  y <- Some(4)
} yield x + y
// result: Some(7)

// 等价于
val result2 = Some(3).flatMap(x => Some(4).map(y => x + y))
// result2: Some(7)

// 这就是为什么for推导式可以用于Option、List、Future
// 只要类型有map和flatMap,就可以用for推导式
大数据场景提示:Spark的RDD和Dataset都支持map和flatMap,因此也支持for推导式。虽然实际开发中更多直接用链式调用,但理解for推导式的本质,有助于理解Spark转换操作的函数式本质。
03 while与do-while循环
Scala保留了while循环,但不推荐使用——因为while是命令式的、可变状态的,与函数式编程风格相悖。
// while循环
var i = 0
while (i < 5) {
  println(i)
  i += 1
}

// do-while循环
var j = 0
do {
  println(j)
  j += 1
} while (j < 5)
为什么不推荐while?
// 命令式:可变状态,容易出bug
var sum = 0
for (i <- 1 to 100) {
  sum += i
}
// sum: 5050

// 函数式:不可变,声明式
val sum = (1 to 100).sum
// sum: 5050

// 函数式:用递归替代循环
def factorial(n: Int): Int = n match {
  case 0 => 1
  case _ => n * factorial(n - 1)
}
经验法则:在Scala中,优先使用集合操作(map/filter/reduce/fold)和递归,而不是while循环。while只在确实需要循环等待、轮询等场景使用。
04 match模式匹配
match是Scala的switch,但功能强大得多。它支持值匹配、类型匹配、解构匹配、守卫匹配。
基础值匹配
val day = "MON"
val type = day match {
  case "MON" | "TUE" | "WED" | "THU" | "FRI" => "weekday"
  case "SAT" | "SUN" => "weekend"
  case _ => "unknown"
}
// type: "weekday"

// match是表达式,可以直接赋值
val result = x match {
  case 0 => "zero"
  case 1 => "one"
  case _ => "other"
}
类型匹配
def describe(x: Any): String = x match {
  case i: Int => s"整数: $i"
  case s: String => s"字符串: $s"
  case d: Double => s"浮点数: $d"
  case b: Boolean => s"布尔值: $b"
  case list: List[_] => s"列表,长度${list.size}"
  case m: Map[_, _] => s"映射,${m.size}个键值对"
  case _ => "其他类型"
}

describe(42)           // "整数: 42"
describe("hello")      // "字符串: hello"
describe(List(1,2,3))  // "列表,长度3"
样例类解构匹配
case class Person(name: String, age: Int)

val alice = Person("Alice", 25)

alice match {
  case Person("Alice", age) => println(s"Alice is $age")
  case Person(name, age) if age < 18 => println(s"未成年: $name")
  case Person(name, _) => println(s"Hello $name")
}
守卫(match if)
def classify(n: Int): String = n match {
  case x if x > 0 => "positive"
  case x if x < 0 => "negative"
  case _ => "zero"
}

// 更复杂的守卫
def greet(person: Person): String = person match {
  case Person(name, age) if age < 18 => s"未成年: $name"
  case Person(name, age) if age >= 65 => s"老年: $name"
  case Person(name, age) => s"成年: $name ($age)"
}
匹配集合
val list = List(1, 2, 3)

list match {
  case Nil => "空列表"
  case head :: Nil => s"单元素: $head"
  case head :: second :: rest => s"多个元素,首:$head, 次:$second"
  case _ => "其他"
}

// 匹配元组
val pair = (1, "hello")
pair match {
  case (1, "hello") => "匹配"
  case (x, y) => s"($x, $y)"
}
match的穷尽性检查
如果match的输入是密封特质(sealed trait),编译器会检查是否所有情况都被覆盖:
sealed trait Color
case object Red extends Color
case object Green extends Color
case object Blue extends Color

def colorName(c: Color): String = c match {
  case Red => "红色"
  case Green => "绿色"
  // 如果漏掉Blue,编译器会警告:match may not be exhaustive
  case Blue => "蓝色"
}
对Java开发者的启示:Java的switch只能匹配整数值和枚举,而Scala的match可以匹配任何类型、可以解构对象、可以加守卫。模式匹配是Scala函数式编程的核心工具,在Spark的RDD处理、Akka的消息路由中大量使用。
05 try-catch-finally表达式
Scala的try-catch也是表达式,可以返回值:
// try-catch作为表达式
val result = try {
  "42".toInt
} catch {
  case e: NumberFormatException => 0
}
// result: 42

// 多catch分支
val config = try {
  val props = new java.util.Properties()
  props.load(getClass.getResourceAsStream("/config.properties"))
  props.getProperty("app.name")
} catch {
  case e: java.io.FileNotFoundException => "默认应用"
  case e: java.io.IOException => "IO错误"
} finally {
  println("加载完成")
}
Try类型:更函数式的异常处理
Scala推荐用Try替代try-catch:
import scala.util.Try

// Try[T]是一个容器,要么是Success[T],要么是Failure
val result = Try("abc".toInt)
// result: Failure(java.lang.NumberFormatException)

// 模式匹配处理Try
result match {
  case Success(value) => println(s"成功: $value")
  case Failure(e) => println(s"失败: ${e.getMessage}")
}

// 链式处理
val safeResult = Try("42".toInt)
  .map(_ * 2)
  .getOrElse(0)
// safeResult: 84

// for推导式中使用Try
val combined = for {
  a <- Try("10".toInt)
  b <- Try("20".toInt)
} yield a + b
// combined: Success(30)
06 循环控制:break与continue
Scala没有原生的break和continue关键字。这是设计选择——鼓励用函数式方式替代循环控制。
用Breaks类实现break
import scala.util.control.Breaks._

breakable {
  for (i <- 1 to 10) {
    if (i == 5) break()
    println(i)
  }
}
// 输出: 1 2 3 4
用函数式方式替代continue
// Java: for循环里用continue跳过某些元素
// for (int i = 1; i <= 10; i++) {
//     if (i % 2 == 0) continue;
//     System.out.println(i);
// }

// Scala: 用filter替代continue
for (i <- 1 to 10 if i % 2 != 0) println(i)

// 更函数式的写法
(1 to 10).filter(_ % 2 != 0).foreach(println)
用return从函数返回
def findFirstEven(nums: List[Int]): Int = {
  for (n <- nums) {
    if (n % 2 == 0) return n  // 直接从函数返回
  }
  -1  // 没找到
}
为什么没有break/continue?
Scala的设计哲学是:用集合操作替代循环,用模式匹配替代分支,用Option替代null。break和continue是命令式循环的产物,当你用map/filter/reduce时,根本不需要它们。
// 命令式:用break找到第一个偶数
import scala.util.control.Breaks._
var found = -1
breakable {
  for (n <- nums) {
    if (n % 2 == 0) {
      found = n
      break()
    }
  }
}

// 函数式:用headOption
val found = nums.find(_ % 2 == 0).getOrElse(-1)
后者更简洁、更安全、更易读。
07 与Java循环判断的对比
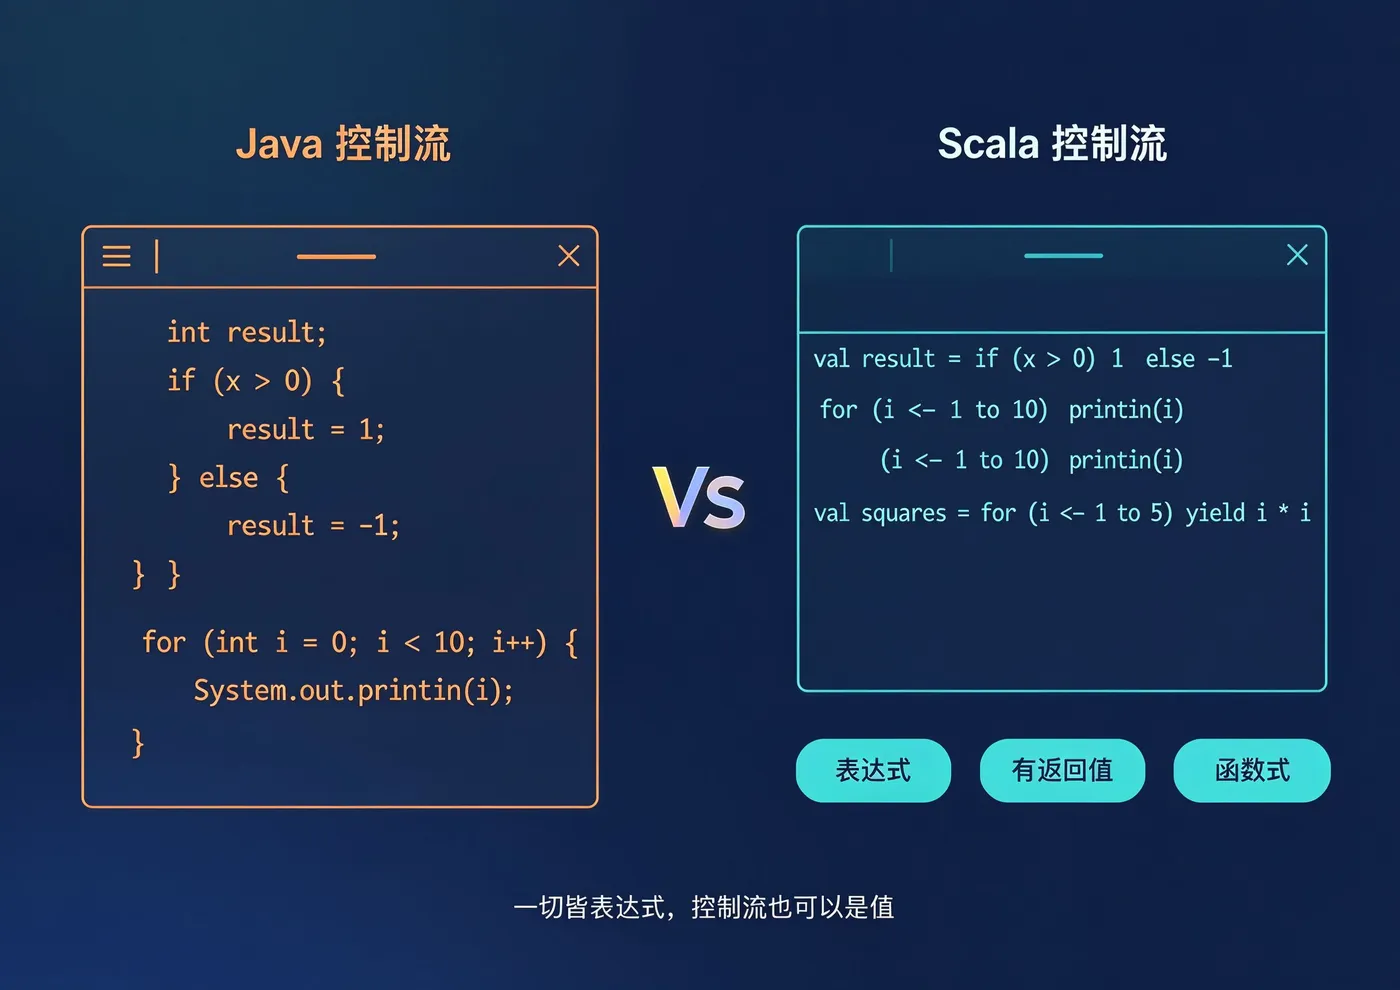
核心差异对比
| 维度 | Java | Scala |
|---|---|---|
| if | 语句,不能直接赋值 | 表达式,有返回值 |
| for | 循环语句 | 循环 + 推导式 |
| yield | 无 | for yield生成新集合 |
| switch | 仅支持整数/枚举 | match支持任意类型 |
| break/continue | 原生关键字 | 无,用Breaks类或函数式替代 |
| try-catch | 语句 | 表达式,有返回值 |
| while | 推荐使用 | 保留但不推荐 |
| 遍历集合 | for-each或Iterator | for推导式 + 高阶函数 |
Java for循环 vs Scala for推导式
// Java: 过滤偶数并平方
List<Integer> result = new ArrayList<>();
for (int i = 1; i <= 10; i++) {

    if (i % 2 == 0) {

        result.add(i * i);
    }
}
// result: [4, 16, 36, 64, 100]
// Scala: for推导式
val result = for (i <- 1 to 10 if i % 2 == 0) yield i * i
// result: Vector(4, 16, 36, 64, 100)

// Scala: 更函数式的写法
val result = (1 to 10).filter(_ % 2 == 0).map(_ * _)
// result: Vector(4, 16, 36, 64, 100)
Java switch vs Scala match
// Java: switch
String type;
switch (day) {

    case "MON":
    case "TUE":
    case "WED":
    case "THU":
    case "FRI":
        type = "weekday";
        break;
    case "SAT":
    case "SUN":
        type = "weekend";
        break;
    default:
        type = "unknown";
}
// Scala: match
val type = day match {
  case "MON" | "TUE" | "WED" | "THU" | "FRI" => "weekday"
  case "SAT" | "SUN" => "weekend"
  case _ => "unknown"
}
Scala 3新语法
Scala 3对控制流语法做了简化:
// Scala 3: if表达式
if x > 0 then
  "positive"
else
  "non-positive"

// Scala 3: for循环
for i <- 1 to 5 do
  println(i)

// Scala 3: while循环
while x > 0 do
  x -= 1

// Scala 3: match表达式
val result = x match
  case 0 => "zero"
  case _ => "other"
写在最后:从命令式到表达式式的思维转变
Scala的循环与判断系统,表面上是语法差异,本质上是编程范式的差异。
Java是命令式语言:你告诉计算机"一步步做什么"——先判断条件,再执行代码块,再循环重复。Scala是表达式语言:你描述"你想要什么结果"——if返回什么值、for生成什么集合、match匹配到什么分支。
这种转变带来三个好处:
- 更少的可变状态:if表达式直接赋值,不需要临时变量;for推导式生成新集合,不需要手动添加元素
- 更强的组合性:表达式可以嵌套、可以传递、可以作为参数;语句只能顺序执行
- 更高的安全性:match的穷尽性检查让编译器帮你发现遗漏的分支;Try类型让异常处理显式化
这些特性不是孤立的,它们共同支撑了Scala的函数式编程范式。Spark的RDD转换链、Flink的数据流处理、Cats的函数式组合——这些框架的核心都是"描述你想要什么",而不是"告诉计算机怎么做"。
学习建议:不要试图一次记住所有语法。先从if表达式和for推导式开始,写一些小练习。当你习惯了"控制结构有返回值"的思维后,再学习match模式匹配和Try类型。循环与判断是编程的基础,但在Scala里,它们不仅是基础——它们是函数式编程的入口。
从Java的命令式循环到Scala的表达式式控制流,不是学习"另一种循环写法",而是学习一种"更声明式、更安全、更组合的思考方式"。当你习惯了用map/filter替代for循环、用match替代if-else链、用Try替代try-catch,你会发现:原来控制流可以这么优雅。