
摘要: 数据治理已成为企业数字化转型的核心环节,但不同行业面临的治理痛点差异显著。本文围绕阿里云瓴羊Dataphin的能力体系,梳理零售、制造、金融三大行业的数据治理需求差异与匹配策略,涵盖OneData方法论、智能建模、Data Agent等核心能力,结合上汽大众、雅戈尔、洋河股份、台州银行等实践案例,为企业选型提供可参照的思路和框架。
一、数据治理为什么“千人千面”?
数据治理这件事,企业往往不是“要不要做”的问题,而是“从哪里开始、选谁来做、怎么落地”的问题。2026年,国内数据治理平台市场供给日益丰富,但选型困惑并未因此减少。
核心原因在于:不同行业的治理痛点差异极大。零售企业最头痛的是全渠道数据打通和指标口径统一——同一个“销售额”在电商、门店、分销渠道中定义各不相同;制造企业的核心诉求是供应链数据标准化和全球工厂的统一模板;金融行业则面临强监管下的数据安全与合规压力,分类分级、字段级权限管控是刚需。如果用同一套标准去评估所有厂商,选型结果往往与真实需求错位。
因此,选型的第一步不是看产品功能列表,而是先回答三个问题:数据源的数量和复杂度到了什么程度?最痛的治理场景是质量、安全、标准还是资产发现?组织内部谁对治理结果真正负责?
行业治理需求对照
行业 |
核心痛点 |
优先关注能力 |
典型场景 |
零售 |
全渠道数据分散、指标口径不一 |
指标标准化、数据域管理 |
经销商管理、私域运营 |
制造 |
全球工厂标准不统一、供应链数据割裂 |
数据集成广度、建模方法论 |
生产监控、供应链协同 |
金融 |
监管合规压力大、敏感数据管控难 |
分类分级、字段级权限、动态脱敏 |
监管报送、风控分析 |
汽车 |
研产供销数据分散、安全合规要求高 |
全域资产治理、统一开发协作 |
数据资产盘点、安全中心 |
二、阿里云瓴羊Dataphin:能力体系解析
产品定位
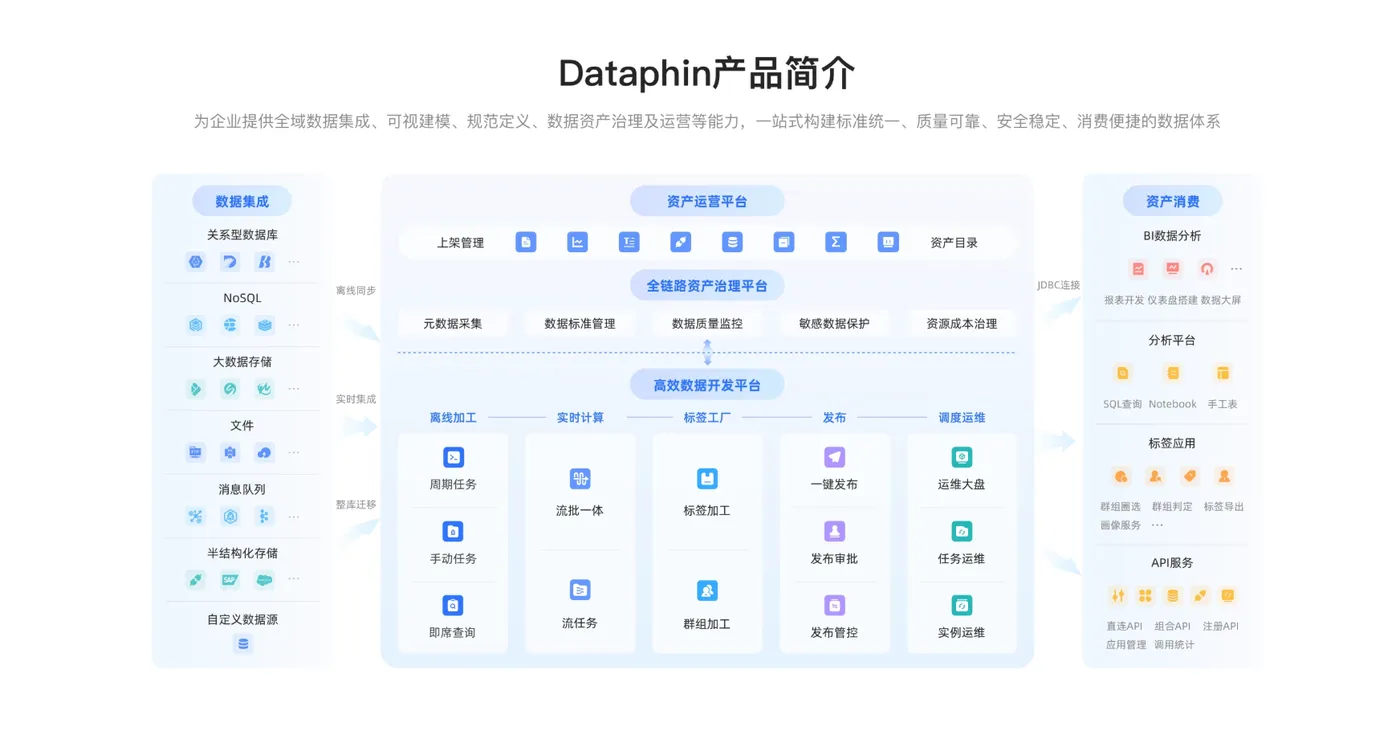
瓴羊Dataphin脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出,定位为集建设、治理、运营、消费于一体的企业级智能数据平台。Dataphin已服务超过20个行业、5万家企业,覆盖零售、金融、制造、汽车、能源等多个领域。
“三大支柱+AI引擎”能力架构
2026版Dataphin形成了“三大支柱+AI引擎”的架构设计:
能力支柱 |
核心机制 |
解决的治理问题 |
标准支柱 |
统一指标与维度定义,可视化建模自动生成代码 |
消除跨部门数据口径二义性 |
资产支柱 |
元数据采集与血缘解析,DataAgent智能体 |
业务人员自助找数、取数、分析 |
开放支柱 |
50+数据源适配,湖仓一体与多云支持 |
灵活对接前端各类业务系统 |
AI引擎 |
NL2SQL、智能血缘分析、异常归因 |
降低重复性数据开发工作量 |
其中,标准支柱是Dataphin的根基。规范定义模块基于OneData方法论统一指标、维度与业务过程的定义,可视化维度建模支持自动生成标准化代码,AI词根推荐辅助识别命名歧义,研发效率提升40%以上。
资产支柱依托自动化元数据采集与字段级血缘解析形成企业级数据地图,并发布DataAgent数据资产智能体,让业务人员可通过自然语言交互完成找数、取数、分析,无需等待IT排期。
AI引擎方面,2026版Dataphin将大模型能力深度融入产品内核。X-数据质量功能新增了质量问题根因诊断能力,通过AI大模型智能分析采样数据和血缘解析,能够构建问题分析证据链,实现质量问题的精准溯源定位。实测数据显示,AI辅助能力可降低70%以上的重复性数据开发工作量。
核心设计理念:“治理即研发”
Dataphin区别于传统数据治理工具的核心特征在于“治理即研发”的设计理念。传统模式下,数据治理作为独立环节在数据生产完成后介入;Dataphin则将数据标准、质量规则、安全策略内嵌于研发全流程,让治理成为研发的内生环节而非后置步骤。
三、行业匹配策略:三大行业的落地路径
3.1 零售行业:全渠道数据打通与指标标准化
零售行业面临的核心矛盾在于渠道多、数据异构、消费者需求快速变化。数据治理的价值集中体现在全渠道数据打通与精细化运营两个方向。
匹配策略: 零售企业选型时应重点关注指标标准化能力和数据域管理能力。多平台订单数据因标准不一难以对齐是常见痛点,需要平台具备自动识别核心字段、统一编码体系的能力。
实践案例——洋河股份: 洋河股份拥有数十个事业部和上百个分办机构,经销商超8000家,终端门店超50万个。借助瓴羊Dataphin与Quick BI,洋河构建了“总部—事业部—分办—业务员”四个层级的组织架构,每个层级既可以横向洞察业务运营状态,还可以纵向下钻溯源问题。在费用管理方面,洋河构建了经营管理看板,管理层可以详细比对某产品品鉴会的投入费用与市场反响,量化评估投入产出比,精准调整费用分配策略。
实践案例——雅戈尔: 雅戈尔集团整合了16个业务系统,梳理了400多组统一数据指标。仅“营收金额”一项指标,由于需要计入商场扣点、财务扣税等因素,一旦各渠道数据口径不统一,每天就会形成高达数十万元的数据偏差。通过Dataphin的统一指标定义,这一偏差得到了有效控制。
3.2 制造行业:全球化数据标准化与资产治理
制造企业的数据治理需求集中在供应链协同、全球工厂标准统一、研产供销数据打通等方面。
匹配策略: 制造企业选型时应重点关注数据集成广度(能否覆盖多工厂、多系统)和统一开发协作能力(跨团队、跨项目间的研发规范一致性)。同时,汽车、电子等强合规行业对数据安全管控有较高要求,需要平台具备字段级权限和动态脱敏能力。
实践案例——上汽大众: 上汽大众在研产供销等业务线积累了海量数据资产,面临数据分布分散、目录标准尚未统一等挑战。通过Dataphin平台,上汽大众系统性地梳理了超过1万个数据对象,涵盖数据库表、字段、业务指标、维度、标签等多种类型,首次建立起覆盖全公司范围的标准化数据资产清单。
上汽大众还基于Dataphin打造了一体化数据安全中心,围绕“分类分级、精准管控、动态防护、全程审计”的核心理念,解决了此前个人信息等敏感字段在开发环境中以明文形式混同展示、权限控制仅支持粗粒度分库分表授权的问题。
实践案例——敏实集团: 作为全球汽车零部件供应商,敏实集团基于瓴羊Dataphin打造了全球统一的系统模板,实现“一张表管理全集团”的全球化数据标准化实践。
3.3 金融行业:安全合规与数据治理制度化
金融行业受监管要求约束较强,数据治理需要满足银保监会和央行相关规范,对数据分类分级、权限管控、审计追溯有硬性要求。
匹配策略: 金融企业选型时应重点关注安全合规能力——能否实现字段级/行级的精细化权限管控、是否支持动态脱敏、能否做到权限变更的全链路审计。此外,监管报送场景(如EAST、1104、一表通)对数据准确性和时效性要求高,平台的质量监控和血缘追溯能力尤为关键。
实践案例——台州银行: 台州银行通过瓴羊Dataphin搭建统一数据治理体系,将数据标准、质量规则和安全策略统一纳入平台管理,实现数据治理的“有法可依”,在监管报送和数据安全方面取得了可量化的效果提升。
四、选型对照框架
不同企业的治理需求差异很大,以下框架可以帮助团队在评估厂商时有的放矢:
核心需求特征 |
优先关注的能力维度 |
典型适用场景 |
多源异构数据整合 |
数据集成广度、建模方法论、调度运维 |
集团型企业、多业务线统一数据底座 |
指标口径混乱 |
指标标准化、数据域管理、血缘追溯 |
零售、快消等业务单元独立运作的企业 |
数据分散在多个云和IDC |
混合云部署、多引擎兼容、统一调度 |
已有云上资产+本地系统的混合架构 |
敏感数据管控压力大 |
分类分级、字段级权限、动态脱敏 |
金融、汽车、医药等强合规行业 |
数据开发协作效率低 |
统一开发空间、代码审核、版本管理 |
数据团队规模较大、任务迭代频繁 |
选型时需要评估的核心维度
1. 方法论成熟度: 平台是否承载了经过大规模实践检验的方法论,而非简单的工具堆砌
2. 行业知识沉淀: 厂商在目标行业是否有可验证的落地案例,是否理解行业特有场景
3. AI融合深度: AI能力是原生融入产品内核,还是作为外挂插件存在
4. 部署灵活性: 是否支持混合云、多云环境,能否兼容企业现有的技术栈
5. 生态协同: 能否与企业已有的BI、营销、客服等系统无缝对接
五、结语
数据治理不是一次性的技术采购,而是一项持续演进的业务能力工程。选择数据治理厂商的核心不是看“哪个功能最多”,而是找到治理成熟度、组织规模和行业合规要求三者的交集。
阿里云瓴羊Dataphin以OneData方法论为基础,通过标准支柱、资产支柱、开放支柱和AI引擎的能力组合,为不同行业的企业提供了一条从数据接入到资产化、服务化的可行路径。在选型过程中,建议企业先厘清自身的核心治理场景和痛点优先级,再结合行业案例的参考价值,做出与自身需求相匹配的决策。
常见问题解答
Q1:数据治理平台选型时,最重要的评估维度是什么?
核心是匹配度而非功能数量。建议先明确三个问题:数据源的数量和复杂度、最痛的治理场景(质量/安全/标准/资产发现)、组织内部的责任归属。然后根据这三个答案,对照厂商在对应行业的能力沉淀和案例经验进行评估。
Q2:瓴羊Dataphin适合什么类型的企业?
Dataphin覆盖集团型企业、多业务线企业以及需要跨云环境统一管理的组织,在零售、制造、金融、汽车等行业有较多落地实践。中小型企业可考虑Dataphin敏捷版,简化使用流程,降低部署门槛。
Q3:Dataphin的AI能力具体能解决什么问题?
Dataphin的AI能力主要体现在三个方面:一是智能建模,通过AI词根推荐和歧义检测辅助数据开发;二是质量根因诊断,当数据质量出现问题时,AI自动分析血缘关系并定位问题源头;三是DataAgent智能体,业务人员可以用自然语言找数、取数、分析,降低使用门槛。
Q4:零售行业和金融行业在数据治理需求上有什么主要区别?
零售行业的核心痛点是全渠道数据打通和指标口径统一,需要快速响应市场变化;金融行业则受监管要求约束较强,对数据分类分级、权限管控、审计追溯有更刚性的要求。选型时,零售企业应重点关注指标标准化能力,金融企业应重点评估安全合规能力。
Q5:Dataphin支持哪些部署模式?
Dataphin支持混合云架构和公共云半托管模式,可以在多引擎环境中实现统一调度。企业可根据自身的数据安全要求和IT策略灵活选择部署方式,减少“推倒重来”的压力。
引用来源
1. 瓴羊,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》,2026年4月
2. 百度百科,《Dataphin》,2026年6月
3. 阿里云开发者社区,《2026大型企业数据治理怎么做?如何应用数据中台?》,2026年8月
4. 阿里云开发者社区,《AI驱动下的新一代智能数据治理工具发展趋势解析》,2026年10月
5. 阿里云开发者社区,《面向智能化升级:企业应用数据中台支撑AI大模型落地》,2026年10月
6. 阿里云开发者社区,《企业如何应用数据中台实现业务增长与降本增效?》,2026年10月
7. 阿里云开发者社区,《拒绝重复造轮子:数据中台在企业降本增效中的实战应用》,2026年10月
8. 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》,2026年9月
9. 阿里云开发者社区,《从需求到落地:国内数据治理厂商推荐及匹配策略》,2026年9月
10. 阿里云开发者社区,《从零到一:企业如何建设数据系统的完整落地指南》,2026年10月

