
让 Data Agent 少做填空题,多做选择题,是提高分析可靠性的一条重要路径。
这里的“填空”,是让模型在执行任务时,自行补齐企业的指标定义、数据关系和计算规则;“选择”,是在已经整理、验证的知识上,判断用什么、怎么组合。
两种方式都可能做对。但在复杂环境里,需要临场补齐的前提越多,整条任务链上的不确定性就越难控制。一处关系推断错了,后面的 SQL 还是可以正常运行,报告还是可以条理清晰,但结果会偏离事实。
“少做填空题,多做选择题”之所以更容易可靠地完成,是因为出题之前,信息已经被整理过,大大降低了 Data Agent 做对事情的复杂度。
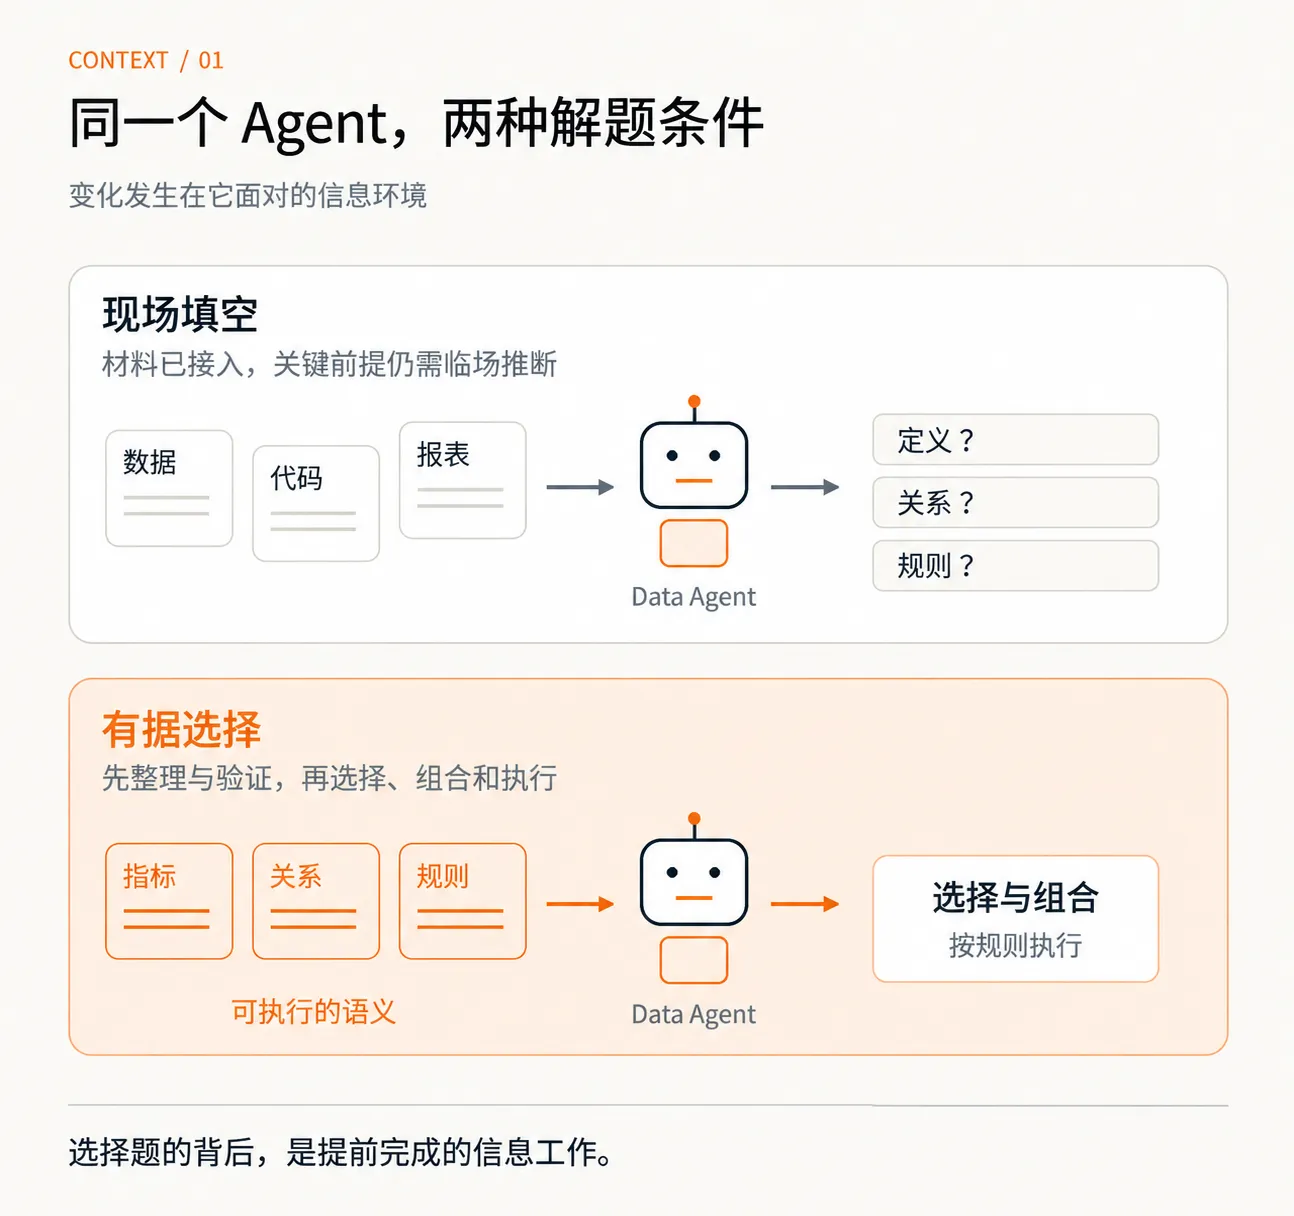
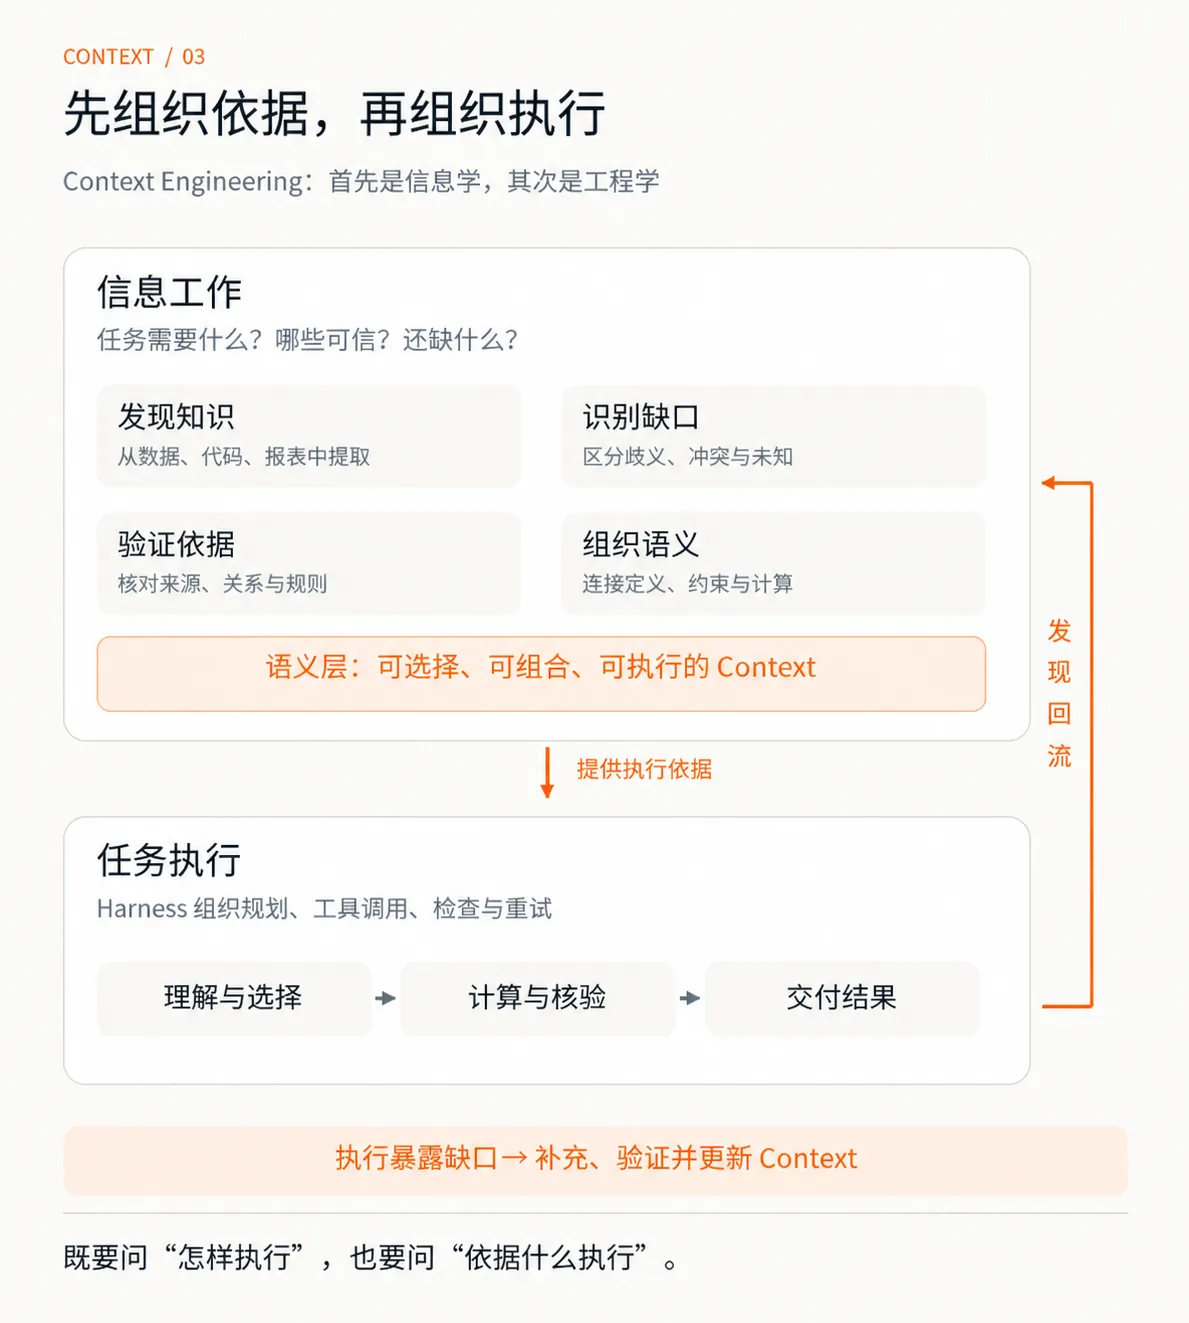
所以,我有一个判断:Context Engineering,首先是信息学,其次是工程学。先弄清系统知道什么、缺少什么,以及依据什么作判断,再讨论任务怎样规划,工具怎么调用、执行和重试。
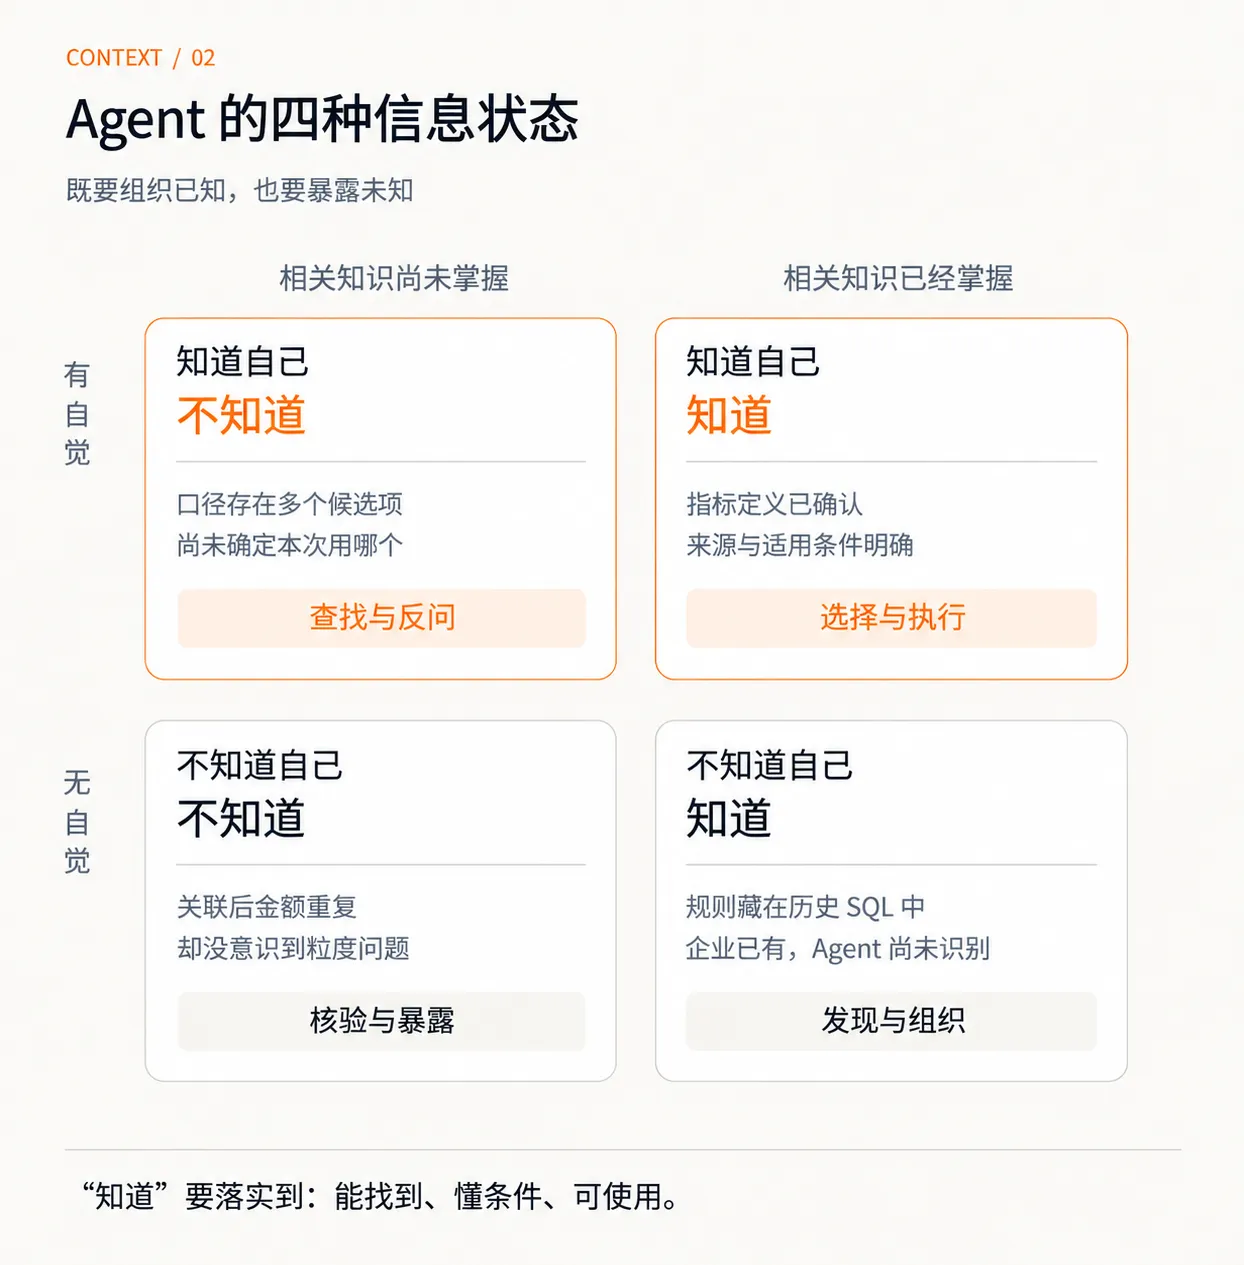
这可以用四句话展开:你知道你知道什么,你不知道你知道什么,你知道你不知道什么,你不知道你不知道什么。
看起来绕,却对应了 Data Agent 工作中四种很具体的信息状态。
你知道你知道什么:有依据,才能有选择
假设系统已经掌握“净销售额”的定义:哪些订单计入,退款怎样扣除,按什么时间归属,以及可以按哪些维度分析。
用户问销售趋势,Agent 就可以选择这个指标,组合时间和渠道维度,再按确定的计算规则执行。
这是一种很好的 Data Agent 求解状态。
我们不妨把“知道”说得再具体一点:知道口径有哪些、在哪里,知道它适用于什么情况,也知道如何执行。
只知道指标的名字,还不够。文档里写着“净销售额等于销售额扣除退款”,但没有说明退款按发生时间扣减,还是回溯原订单,执行时仍然无法生成正确的 SQL。这也是语义平台之所以如此强调“定义即研发、研发即服务"的原因。
一张整理好的宽表、一段引用范围清楚的 Excel 公式,也往往具备这样的条件:模型可以在局部范围里顺利计算,是因为粒度、关系和规则已经被准备好了。
但当 Data Agent 开放给业务人员使用之后,由于 Agent 的灵活性,基于宽表的问数往往难以满足需求,因此在开放的数据环境里,针对不同的问数需求针对性去人工维护不同的 SQL 模板,这根本就不可行,这条路径只能 Demo,不能生产。
因此,真正的选择题,选项背后要有完整到足以支撑当前任务的依据。把几个猜测列出来,再让模型自己选一次,不会自动提高准确性。
能回答好一道已经准备好的题,与能在复杂现场持续回答好问题,这中间还有很长一段工作。
你不知道你知道什么:企业有答案,Agent 没拿到
用户问收入,Agent 在订单表里找到金额字段,求和后得到一个数字。用户发现,它与财务报表对不上。
继续查找,才发现财务报表的 SQL 里还有收入确认时间、税额处理和特定订单的排除规则。
答案早就存在,只是没有进入当前任务的 Context。
这在企业里并不难理解。很多知识已经写进代码、报表和历史处理流程,却没有被整理成明确的知识。企业拥有它,当前执行任务的 Agent 却不知道它在哪里,也不知道它与眼前的问题有关。
比如,两套系统里的客户编码不能直接对应,历史代码中已经有映射规则。Agent 如果只看两张原始表,就可能重新推断关联,漏掉一部分客户。
这类问题,如果每次都要重新发现、重新解释、重新补充,已有知识就会反复变成填空题,回答难以稳定,Agent 下一次未必能找到同一份依据。
Context 是 Agent 的工作现场。企业里存在的知识,只有被找到、被理解,并进入当前任务,才真正成为这个现场的一部分。
所以,Context 建设有大量工作是发现和梳理企业知识,让已有知识变得可用,让 Agent 的求解条件得到明显改善。因此,自动化发现和梳理企业知识的能力就显得非常重要。
你知道你不知道什么:把缺口变成可以回答的问题
Agent 已经找到了支付销售额、发货销售额和财务确认收入,知道三者的差异,但用户只问“这个月收入怎么样”。
缺口很明确:这次任务应该采用哪一种口径?
于是 Agent 可以反问:“你想看支付表现、发货表现,还是财务确认的收入?”
反问也是选择题。它能问得准,是因为前面已经完成了信息整理。用户作出选择,模糊意图就变成了后续执行的明确约束。
另一个例子是区域同比。系统发现区域划分调整过,就需要确认:按各年的区域归属比较,还是把历史数据重算到今年的区域?如果需要重算,还缺哪份映射关系?
这里既有选择,也有需要继续补齐的信息。
人与 Agent 交互的过程中,天然存在“我以为你懂我”的情况,Agent 要能够意识到缺什么,以及这个缺口会影响哪一步。
Agent 能不能反问,反映了 Agent 对企业 Context 的熟悉宽度和深度,懂得越多,自然对需求的理解就更全面,对于需求边界的确认点就会越清楚,自然需要跟用户确认的信息就越多。
“知道自己不知道什么”的前提是“知道自己知道什么”,这就是老员工往往能提出高质量问题的原因。
你不知道你不知道什么:无知,才是最大的风险
比明确的缺口更麻烦的是:Agent 以为自己已经知道。
订单表是一笔订单一行,明细表是一件商品一行。Agent 关联两张表后,直接汇总订单金额。同一笔订单有三件商品,金额就可能被重复计算。
SQL 正常运行,结果也不为空。如果核验只检查语法和运行状态,这个错误可能一路通过。Agent 没有意识到,还需要检查关联前后的计算粒度。
再比如“活跃会员”。模型看到了登录记录,就按登录行为计算,却没有发现当前分析采用的是一定时期内发生购买行为的定义。
登录和购买都可能构成合理口径。危险在于,Agent 没有意识到这里需要作出选择,已经把一种口径解释当成了业务事实。
有些填空,Agent 不自觉地就已经填上了错误答案。
这是目前 Agent 犯错的核心原因(其实人犯错也是这个原因)
Perfect decisions need perfect context,高质量的决定离不开高质量的信息。但真实工作里,Context is never complete。
Agent 必须在不完备中工作是一个必然,因此任务准确率必然无法做到 100%;
Agent 必须不断识别自己的信息边界这是一个必然,因此必然需要不断拓宽自己的信息边界。
比如,通过不断观察任务完成率和任务准确率来识别自己完成任务的信息边界;比如,通过不断提升语义平台的定义能力,覆盖更多的业务场景来拓宽自己的信息边界。
但这里有一个非常大的障碍就是用户怎么发现 Agent 处于“不知道自己不知道”的状态里,从而能够主动采取干预动作,否则岂不是“一个敢说,一个敢信”,欢迎大家评论区里留言讨论。
从信息学出发,语义层应该怎样建设?
前面讨论的四种信息状态,也给语义层的建设提出了要求:企业已经知道的事情,要让 Agent 找得到、用得上;还没弄清的事情,要能发现缺口、继续补齐;工作中确认过的知识,要留下来,供后续任务使用。
首先,是把企业已有的知识整理出来,形成第一版语义,这是 Data Agent 能快速上岗的关键。
数据表里有对象和结构,代码里有计算和处理规则,报表里有已经在使用的业务口径。语义层要把这些分散的线索联系起来,弄清一个指标怎么算、数据之间是什么关系,以及不同名称和定义之间有哪些差异。
这些工作可以由机器先做一轮,形成第一版语义,再把有冲突、有歧义的地方交给人确认。
“知之为知之,不知为不知,是知也”,暂时没有弄清楚的,也要明确标出来,否则,看起来配置齐全了,实际上只是把模型的猜测换了一个地方存放。
其次,整理出来的知识,还要能用于执行。
比如,净销售额的定义,不能只停留在“销售额扣除退款”这句话上。它要对应到实际数据,说清退款按什么时间归属、按什么粒度计算、能按哪些维度分析,以及相关数据怎样关联。这样,Agent 选中指标和维度后,语义引擎才能按确定的规则计算。
企业知识不能停留在文档里,还要变成 Agent 可以调用的系统能力。
这也是我认为:语义平台是分析决策 Context 里知识密度最高的表达方法的原因。它把定义、关系、约束和计算组织在一起,Agent 使用一个指标时,可以同时获得正确使用它所需的知识,不必每次都从文档和代码中重新寻找、解释和组装。语义层让已经确认的事情不再被反复猜测,让分析工作更有依据。
然后,有了这些知识,Agent 才能更清楚地判断,当前任务还缺什么。比如,业务口中的指标名称,背后对应几种数据口径,需要在具体需求里明确选择哪种口径,这就让 Agent 知道什么时候该反问,用户确认之后,口径才能具体落实到这次任务的执行条件里。
最后,Context is alive,这些知识还要随着工作持续更新。
比如,上游业务系统增加了其他业务种类,或数仓模型发生了重构,要能精确知道哪些指标的语义需要保鲜;比如,业务用户在分析不同渠道的销售额时,默认是二级渠道分类,财务用户在分析不同渠道的销售额时,默认是一级渠道分类;再比如,某次分析任务里是按客户所属区域进行分析,不代表以后所有的任务都采用这个口径。
我想通过上面的分享,落进语义平台上,自然会很容易理解为什么我们会持续倡导语义的定义表达能力、语义的执行与性能优化能力,以及我们近期持续提倡的语义自动构建和保鲜能力,以及不久之后我们还会进一步往本体上发展,进一步完善行动语义的表达能力,让企业更多的知识可以被 Aloudata CAN 平台纳管,构建企业自己的“本体模型"
————
让 Data Agent 少做填空题,多做选择题。
Context Engineering 首先是信息学,其次是工程学。
这两条是我们近期在客户落地实践Aloudata Agent 中的最大收获,现在分享给大家。

