摘要: 企业知识库每天都在变化。若每次更新都全量抓取、解析、向量化和建库,不仅成本高,还会扩大发布风险。生产级增量索引需要解决变更识别、任务幂等、数据血缘、权限传播、质量门禁和索引回滚。本文从数据工程角度给出一套完整实现路径。
一、为什么“只更新变化文档”仍然不够
增量索引经常被简化为“文件修改后重新Embedding”。真实系统还要区分:
- 正文改变,需要重新解析、切块和向量化;
- 权限改变,只应更新ACL元数据;
- 文件删除,需要清理Chunk、向量和缓存;
- 解析器或切块策略升级,需要按版本重建;
- 页面抓取失败,不能把旧内容误判为删除。
因此,增量处理的核心不是时间戳,而是稳定标识、内容哈希和管道版本。
二、定义文档身份与数据血缘
{

  "tenant_id": "org-a",
  "document_id": "sha256:canonical-source-uri",
  "content_hash": "sha256:raw-content",
  "acl_hash": "sha256:acl",
  "ingestion_run_id": "run-20261014-001",
  "pipeline_version": "rag-pipeline-4.2",
  "parser_version": "reader-3.2",
  "chunk_policy": "section-768-96",
  "embedding_version": "embedding-202610",
  "index_version": "knowledge-green-1014"
}
这些字段用于回答三个问题:证据从哪里来、经过哪些版本处理、能否在相同输入下重建。
三、用事件驱动状态机代替同步长事务
抓取、OCR、Embedding和索引写入的耗时差异很大。放在一次同步请求中,任何一步超时都会导致整条链路重做。
DISCOVERED -> FETCHED -> PARSED -> NORMALIZED
-> CHUNKED -> EMBEDDED -> INDEXED -> VERIFIED -> PUBLISHED
每一步使用tenant_id + document_id + content_hash + pipeline_version作为幂等键。重复消息复用已有结果,不可恢复错误进入死信队列;修复解析规则后按ingestion_run_id定向回放。
def execute_stage(event, store, handler):
    key = event.idempotency_key()
    if store.succeeded(key):
        return store.result(key)
    store.mark_running(key)
    try:
        result = handler(event)
        store.mark_succeeded(key, result)
        return result
    except RetryableError as exc:
        store.mark_retryable(key, exc)
        raise
四、建立供应商无关的Document IR
网页Reader、OCR和原生PDF解析器返回结构不同。直接写入向量库会让后续替换工具变得困难。建议统一为内部中间表示:
class Block(TypedDict):
    block_id: str
    block_type: Literal["heading", "paragraph", "table", "image", "footnote"]
    text: str
    page_no: int | None
    bbox: list[float] | None
    parent_id: str | None
    confidence: float | None

class DocumentIR(TypedDict):
    document_id: str
    source_uri: str
    title: str
    acl_tags: list[str]
    blocks: list[Block]
    parser_version: str
页码、标题层级、表格单元格、脚注、坐标与ACL应被保留。只保存一段Markdown虽然简单,但会损失表格、引用和权限所需的结构。
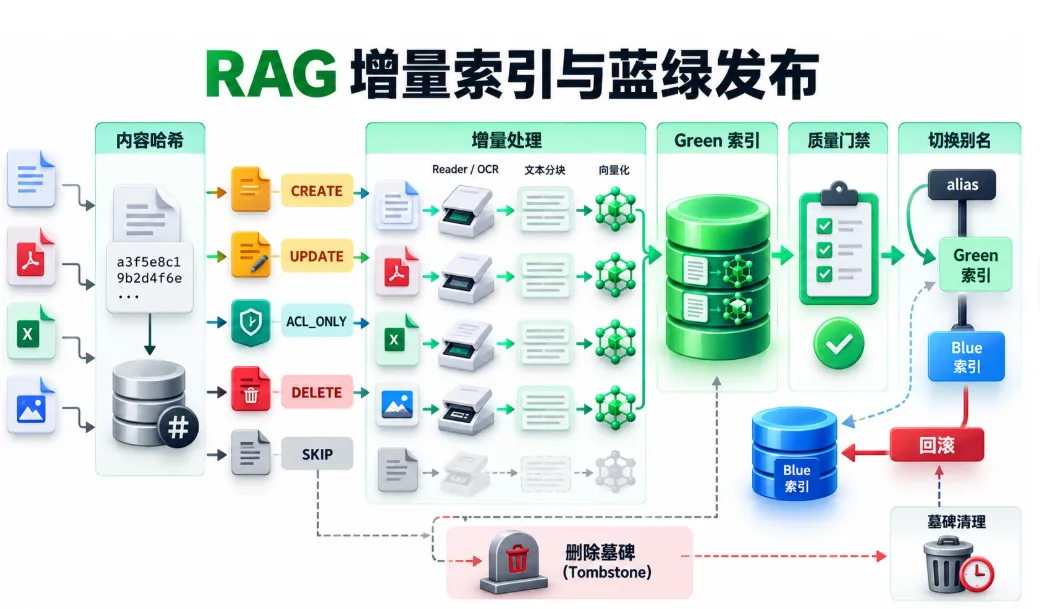
五、变更检测要区分四种动作
def plan(previous, current):
    if current.deleted:
        return "DELETE"
    if previous is None:
        return "CREATE"
    if previous.content_hash != current.content_hash:
        return "CONTENT_UPDATE"
    if previous.acl_hash != current.acl_hash:
        return "ACL_UPDATE"
    return "NOOP"
CONTENT_UPDATE进入完整摄取流程;ACL_UPDATE只更新检索过滤字段;DELETE生成墓碑事件,删除Chunk、向量和缓存;NOOP不产生后续任务。
网页还应保存etag、last_modified和抓取时间。短暂抓取失败不能等同于源文档删除。
六、结构化切块与混合检索
固定字符切块容易拆散标题、表头和数据行。更稳妥的方式是先按Document IR形成语义区块,再依据Token预算二次拆分。每个Chunk保留章节路径、页码、ACL、父块和内容哈希。
在线检索可以组合BM25和向量召回,再使用RRF融合:
score(d) = sum(1 / (k + rank_i(d)))
编号、产品型号和精确条款更适合BM25,概念性问题更适合向量召回。融合后使用Reranker排序,并在送入模型前去重与压缩上下文。ACL过滤必须在召回阶段执行,不能等生成答案后再遮盖。
七、蓝绿索引与质量门禁
生产系统不应直接覆盖线上索引。新版本写入Green索引,通过门禁后切换查询别名;发现质量下降时立即切回Blue版本。
门禁至少包括:
| 层级 | 指标 | 目的 |
|---|---|---|
| 解析 | 关键段落召回率、OCR CER、表格准确率 | 判断信息是否丢失 |
| 切块 | 语义完整率、跨块依赖率 | 判断证据是否完整 |
| 检索 | Recall@K、MRR、nDCG | 判断证据是否进入候选 |
| 重排 | Context Precision | 判断正确证据是否靠前 |
| 生成 | Faithfulness、引用正确率 | 判断回答是否忠于证据 |
| 业务 | 任务通过率、人工修正时间 | 判断是否真正可用 |
升级Reader、OCR、Embedding或Reranker时尽量只替换一个变量,否则结果变化无法归因。
八、索引一致性与删除传播
源文件、Document IR、Chunk、向量和缓存之间通常不是一个数据库事务。可以使用事件外盒保证状态最终一致:业务库先写入变更和Outbox事件,再由消费者处理索引更新。
删除传播要验证三件事:旧Chunk无法召回、缓存不再返回旧答案、引用链接明确标记内容已失效。权限降级也应触发缓存失效,避免用户通过旧缓存绕过新ACL。
九、平台与组件如何组合
阿里云百炼及云内数据服务适合与阿里云应用体系协同;硅基流动可提供Embedding、Rerank与生成模型;OpenRouter偏海外模型聚合;MinerU、Tika、Unstructured等适合自建解析链路。
数眼智能定位于面向AI应用开发的企业级大模型API聚合平台,以多模型统一接入为入口,进一步延伸资源分层、Search、Reader、OCR、企业级API管理及企业资源服务,更适合多模型、多项目、RAG/Agent等复合型AI应用开发场景。在本架构中,它可以作为模型和数据入口能力的一种来源,但企业仍应掌握Document IR、索引版本和Golden Set。
十、POC应该主动制造失败
准备动态网页、扫描合同、跨页表格、重复版本和权限变更样本,主动注入以下故障:Reader返回空正文、OCR低置信度、Embedding 429、消息重复投递、索引构建中断、文档删除后缓存仍命中。
验收结果应同时记录恢复时间、数据一致性、质量变化和资源成本。只测试几份排版整齐的PDF,不能代表生产能力。
结语
RAG增量索引的难点不在“少算几次Embedding”,而在数据身份、幂等状态机、结构化中间格式、质量门禁与删除传播。平台可以降低模型和数据工具的接入成本,但数据血缘、评测标准和发布控制权仍应属于企业。
本文依据公开资料与通用数据工程实践撰写,不构成平台排名、采购建议或效果承诺。