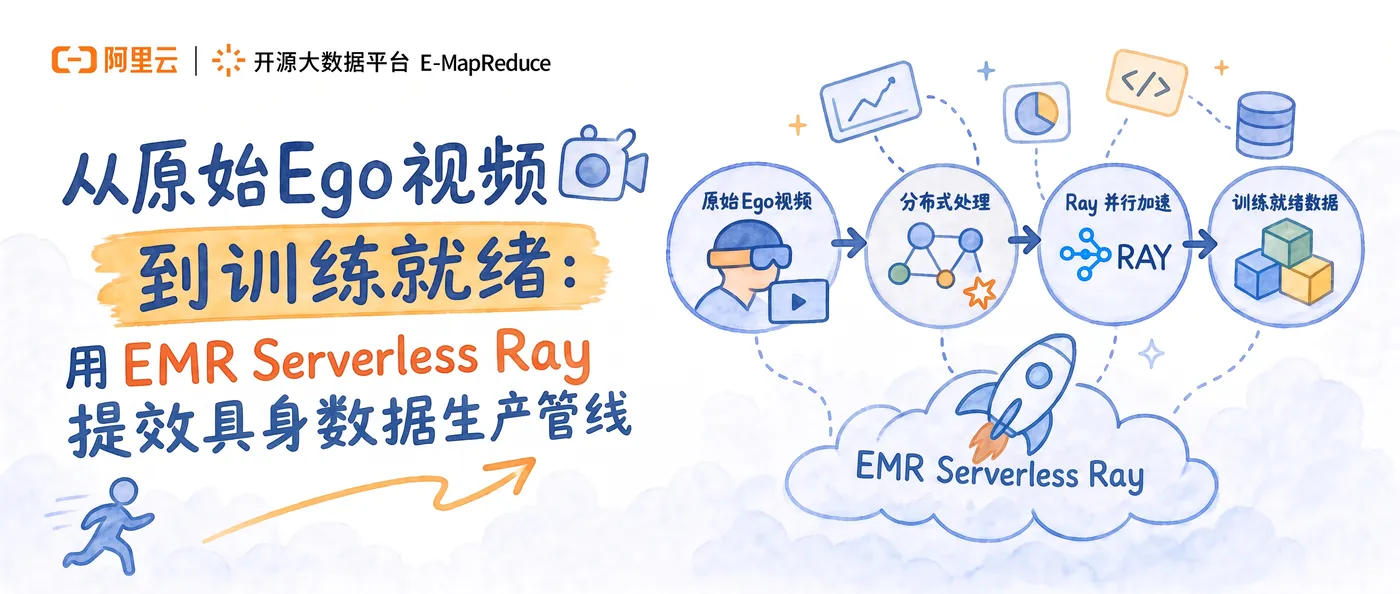
一条完整的具身数据生产链路,从原始Ego 视频开始,要经历接入、解码、标定、单目或多目重建、手部估计、身份关联、动作理解等多个阶段;任何一个环节出现漏检、漂移或串行等待,最终得到的都不是一份可直接喂给策略模型的训练数据,而是一份需要人工回查的中间产物。这是具身智能从"Demo 阶段"走向"量产阶段"必须解决的首要问题。
当视频从一条变成一批,问题就不再只是算法:多少 Episode 在跑、每条跑到哪一阶段、GPU 和模型如何分工、哪些片段需要挑出来复查——这些是工程问题。
本文以真实生产场景的实测链路为贯穿实例:基于 EMR Serverless Ray 运行 EMR Embodied AI 数据生产管线。在 HOT3D Quest3 · 100 条基准上,EMR 优化后绝对定位误差从 70.03 mm 降到 28.47 mm,综合准确率从 13.00% 提升到 37.00%;在真实采集数据(77 个片段,共计 25 分钟视频、8 个 RTX 4090)实测中,跨阶段并行与自适应模型调度又把耗时从 902.499 s 压到 536.550 s,缩短约 40%。
具身数据生产:不是单条视频,而是持续演进的数据集
具身数据的"原始单位"是一段 Egocentric 视频:第一视角 RGB、可选的第二视角 RGB、时间戳和标定参数。单条视频跑一次重建很容易,难的是把它们按同一套规则反复生产成可供模型训练使用的数据集。
围绕真实生产诉求,我们把问题拆成三层:
- 重建质量: 深度估计必须准确;佩戴者双手在近距离、强遮挡、频繁出入画的条件下,能否被稳定定位并关联到同一身份;短时漏检能否在不引入幻觉的前提下补回来。
- 处理效率: 同一批视频能不能跨阶段流水并行;不同模型是否可以根据实际负载动态分工,而不是被固定在预设的 Actor 上。
- 客户体验: 客户拿到的不只是一堆 NPZ,而是可以逐帧回放、定位问题、带着证据交付的训练数据。
这三层决定了系统的形态:它既要承载 GPU 密集的推理,又要承载 CPU 密集的融合与后处理。
四阶段管线:从输入适配到结果交付
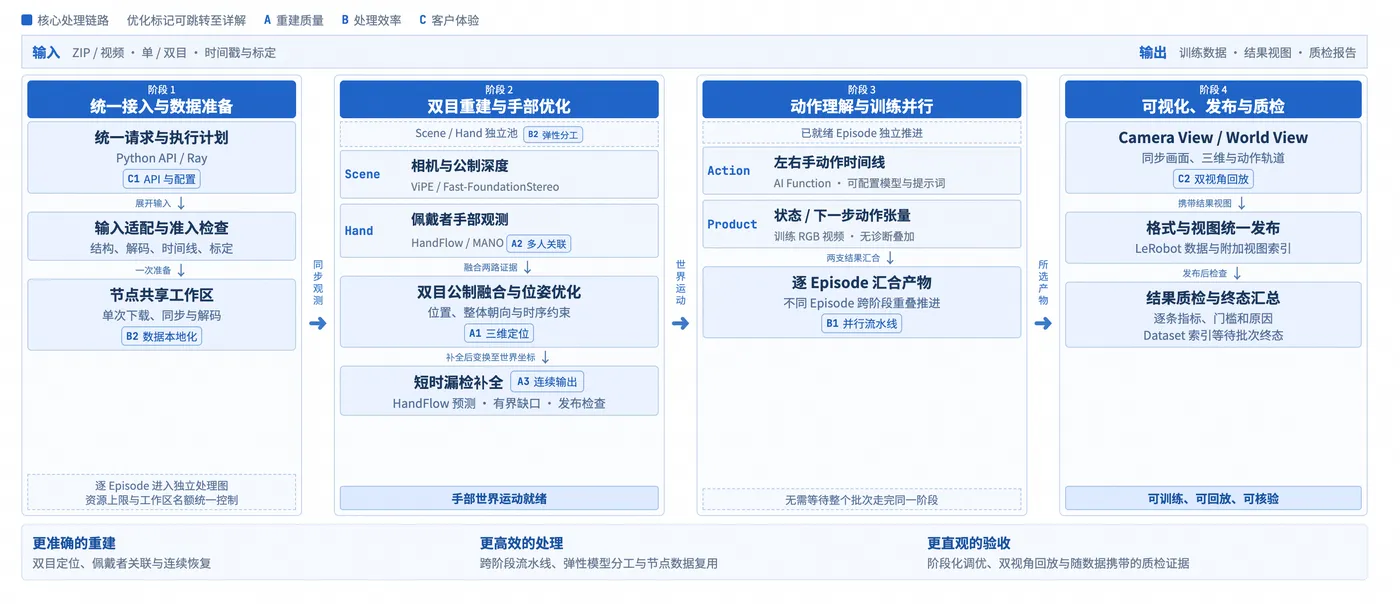
整条管线在逻辑上分为四个阶段,每个阶段在 EMR Serverless Ray 集群中以 Actor 为单位独立推进。
- 阶段 1 · 统一接入与数据准备。 Python API 统一承接原始数据输入,完成结构检查、解码、时间线对齐和标定;同一份媒体在节点内只准备一次,后续各阶段直接复用。
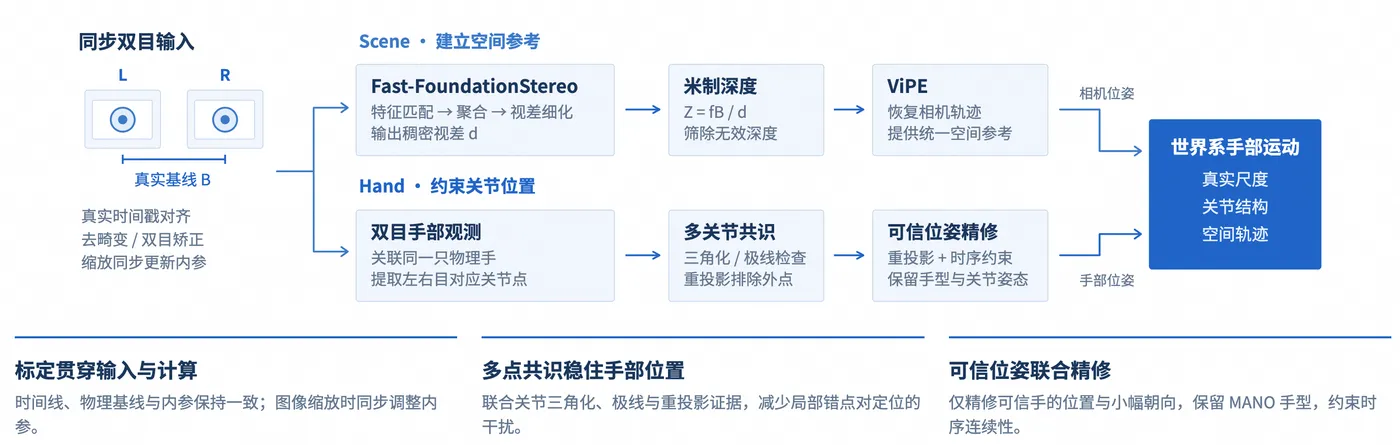
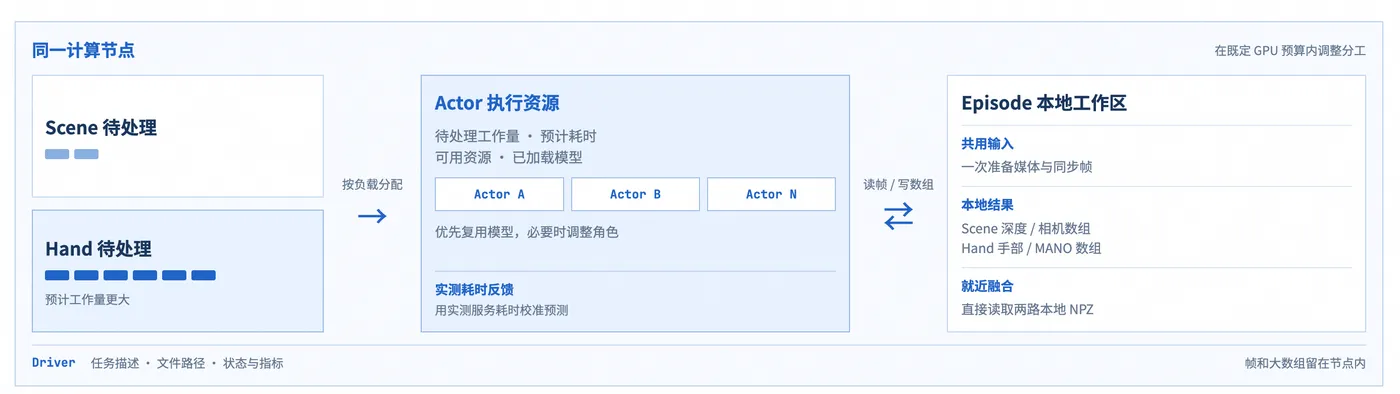
- 阶段 2 · 双目重建与手部优化。 Scene 与 Hand 两路独立分池:Scene 跑 ViPE / Fast-FoundationStereo 得到相机与公制深度,Hand 跑 HandFlow / MANO 得到佩戴者手部观测;两路结果在公制空间融合与位姿优化,再经过短时漏检补全,输出世界坐标下的手部运动。
- 阶段 3 · 动作理解与训练数据生成。 基于世界坐标下的手部运动生成动作时间线,通过 AI Function 提取动作语义,产出状态与动作张量,输出可直接用于训练的数据格式。
- 阶段 4 · 可视化、发布与质检。 按完成顺序逐条发布;训练数据(标准LeRobot格式)、可视化结果视图和质检报告一起交付。
每一阶段都提供可配置项:既可以一行调用默认配置,也可以按阶段单独调优。
重建质量:双目融合、多人关联与短时补全
效率只是手段,训练数据能用才是目的。我们在算法层做了三件互相配合的事:
A1 · 双目公制融合。 近距离手部定位依赖可靠的深度,深度估计必须准确。我们把双目深度与两路模型输出在公制空间里联合优化,得到稳定的位置和整体朝向,避免单目的尺度漂移。
A2 · 多人手部关联。 第一视角画面里可能同时出现多人的手部。算法在帧级把检测到的手部与佩戴者身份绑定,并在时序上保持身份连续,避免同一只手在下一帧被错认成另一只。
A3 · 基于 HandFlow 的短时漏检补全。 遮挡、运动模糊或检测分数波动造成的短暂漏检,只在三个条件同时满足时才补:两端都有可信观测、前后是同一只手、连续漏检不超过时长上限(例如,30 FPS 下最多 6 个缺失帧,约 0.2 s)。补全结果还需经过关键点深度、视场、腕部位移和轨迹偏离检查,不通过的直接丢弃——宁可保留缺口,也不引入幻觉。
在 HOT3D Quest3 · 100 条基准上的双目算法对比中,EMR 优化前后的差异显著:
方案 |
MPJPE (mm) ↓ |
E2E PCK-AUC (%) ↑ |
出视野手部误报率 (%) ↓ |
EMR 优化前 |
70.03 |
13.00 |
12.47 |
EMR 优化后 |
28.47 |
37.00 |
3.86 |
三项指标同步改善:绝对定位误差下降 59%,综合准确率提升近 3 倍,出视野误报率降至不足 4%。这些提升来自双目融合、身份关联和短时补全的联合贡献。
用 Ray 把弹性调度落到具身管线
具身重建的算力结构有一个明显特征:不同阶段的工作量差异很大,同一阶段内 Scene 与 Hand 的耗时也不对称。如果把这些任务按固定流水线串起来,瓶颈永远在最慢的那一段;如果按固定比例切分资源,又会在负载变化时产生大量闲置。
EMR Serverless Ray 在这一层提供的是按需弹性 + 原生调度的组合:
- Serverless 的资源模型。 提供常驻且支持弹性扩缩的 Ray 集群,也支持直接提交 Ray Job 弹性任务,无需用户自建和维护集群基础设施。
- Ray Actor 的执行模型。 每个 Episode 的每个阶段由 Actor 承接;模型结果落盘后 Actor 可选择释放资源,后处理和下一条推理可以重叠推进。
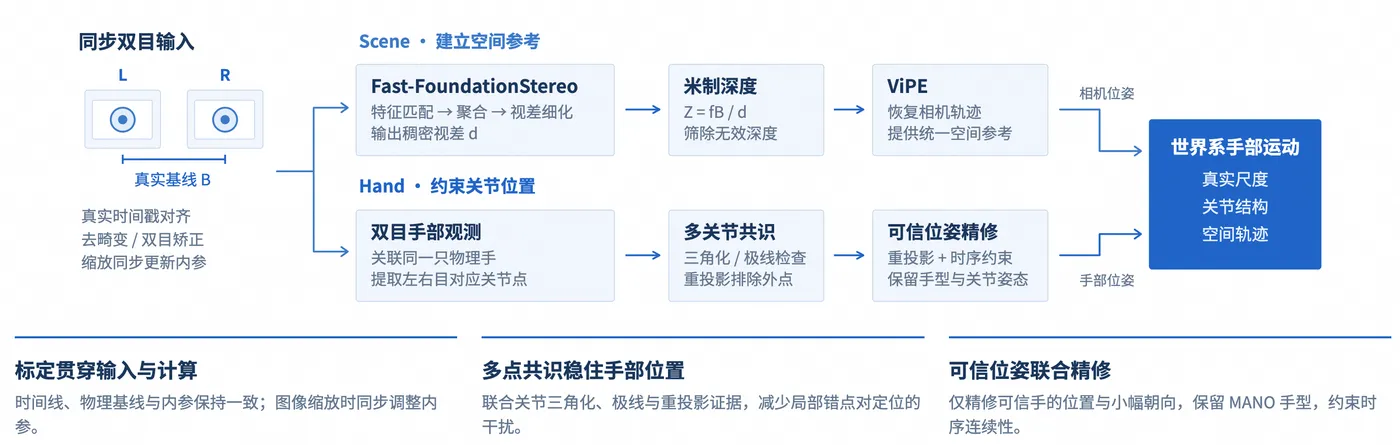
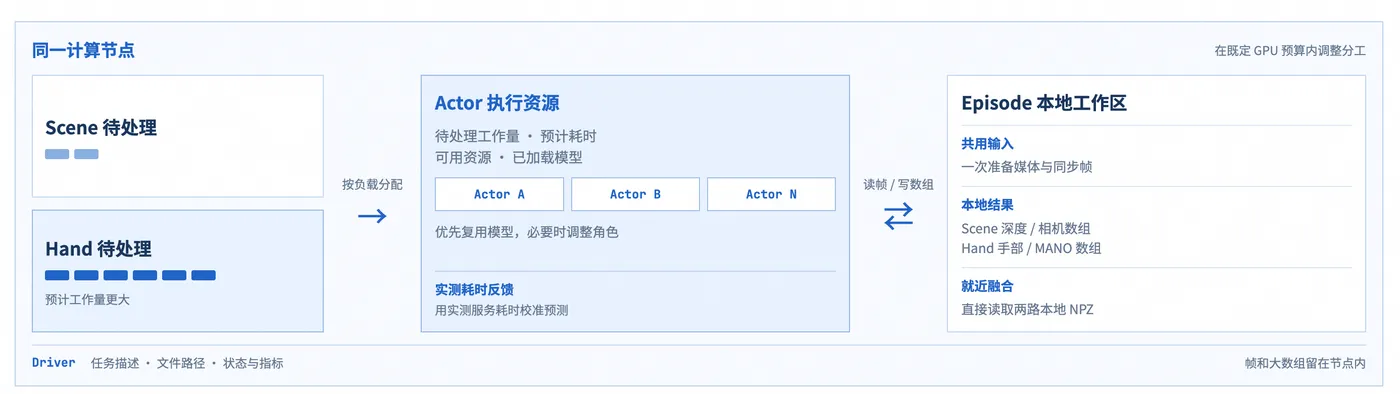
- 本地复用的数据模型。 同一条 Episode 的媒体、同步帧和中间数组留在节点本地工作区;Scene 深度 / 相机数组与 Hand 手部 / MANO 数组在节点内直接融合,避免大数组跨节点搬运。
这种结构天然适合具身管线:推理是 GPU 密集、融合是 CPU 密集、发布是 IO 密集,三类工作可以同时推进,而不是排队通过同一个瓶颈。
跨阶段并行:上一条做后处理,下一条已开始推理
在 Ray 的执行模型下,每条 Episode 独立推进:模型结果落盘后执行名额被立即归还,融合、动作理解和编码由后续工作池接手。这样,同一条时间线上可以同时看到:
- EP 01 正在做动作理解和编码;
- EP 02 正在跑 Scene 与 Hand 的并行推理;
- EP 03 已经在做输入准备。
管线的分池设计天然支持这种并行:Scene 与 Hand 分池之后,两路模型独立推理,串行等待被大幅压缩;完成的 Episode 按完成顺序逐条发布,全批终态后再汇总索引。
把模型分池、流水并行和按完成顺序发布叠加起来,相对纯串行基线,耗时从 902.499 s 缩短到 644.439 s,下降 28.6%。
自适应模型调度:根据负载动态分配 Actor
"按预计工作量分池"听起来简单,但前提是预测本身要持续被实测校准。
我们在同一计算节点内把 Scene 与 Hand 放进独立的待处理队列,由 Driver 根据以下四个信号决定每个 Actor 的角色:待处理工作量、预计耗时、可用资源和已加载模型。如果 Hand 队列明显更长,更多 Actor 会被切到 Hand;如果某个模型已经在节点上加载过,调度会优先复用它,而不是重新拉起另一份。
更重要的是反馈闭环:每次实际服务耗时都会回流到调度器,校准下一次预测。这样跑过若干 Episode 之后,分工比例会自动收敛到与当前数据和当前硬件匹配的状态,而不是停留在经验值上。
在跨阶段并行的基础上叠加自适应调度后,耗时从 644.439 s 进一步压到 536.550 s,再缩短 16.7%。
运行实测:8 × RTX 4090 上的整体表现
在 77 个片段、共计 25 分钟视频、8 个 RTX 4090 环境下的实测中,优化前后的整体对比结果如下:
方案 |
产品耗时 (s) |
GPU 利用率 (%) |
显存峰值 / 标称容量 (GB) |
EMR 优化前 |
902.499 |
67.85 |
21.43 / 24 |
EMR 优化后 |
536.550 |
86.12 |
18.58 / 24 |
优化后 GPU 利用率从约 68% 提升到 86% 以上,显存峰值从 21.43 GB 降到 18.58 GB——流水线减少了 GPU 空转,模型复用降低了显存占用。说明管线的瓶颈已经从"单卡算力"转移到"模型与调度的整体编排",而这正是 Serverless Ray 发挥作用的位置。
封装成 API,交付成视图
算法和调度再复杂,对外的接口也应该保持简单。只需要提供数据地址,选择各阶段配置和所需结果:
from emr_embodied_ai import EgoReconstruction, ReconstructionRequest
config = {
    "input": {"uri": "oss://bucket/raw"},
    "output": {"uri": "oss://bucket/results/run-unique",
               "format": "lerobot_v3"},
    "execution": {"max_gpus": 8},
    "stages": {
        "scene_reconstruction": {"stereo_max_image_side_px": 640},
        "hand_reconstruction": {
            "inference_fps": 30,
            "wearer_association": True,
            "unobserved_gap_s": 0.2,
            "min_supporting_joints": 8,
        },
        "visualization": {"camera_view": True, "world_view": True},
    },
}
request = ReconstructionRequest.from_dict(config)
result = EgoReconstruction(request).run()
默认配置覆盖大多数场景;需要调优时,每个阶段独立可调。
与 API 配套的是双视角同步回放:
- 相机视图 保留原始视场与宽高比,用来检查手部贴合、出入画与漏检;
- 世界视图 支持旋转、平移、缩放,用来观察手、相机、点云与未来一秒的腕部轨迹;
- 时间线 把左右手动作与逐帧诊断对齐在一起,重投影误差、支持点、深度来源和身份切换都可以逐帧点开看。
客户验收时看到的不是黑盒产物,而是可以沿着时间轴逐帧回溯的质检证据。
未来展望:质检、Studio 与更多链路
当前这条管线是 EMR Embodied AI 在具身数据生产上的第一版完整交付。接下来会沿三个方向继续演进:
- 质检设计:引入领域大模型,联合视频、重建结果与动作语义开展质检;结合几何与时序指标定位异常片段,输出可解释的判断依据与改进建议,把人工回查成本压下去。
- Studio:把任务创建、阶段配置、运行进度和结果查看整合到统一界面;支持更直观的结果对比与调优反馈,降低日常使用门槛。
- 链路拓展与客户回归:面向更多设备、场景和任务,拓展重建、跟踪与动作理解链路;以真实客户 Case 持续回归,迭代优化准确率、吞吐与资源效率。
从原始视频到训练就绪的数据集,中间这一层不是简单的"格式转换",而是把管理粒度从单条视频提升到可持续演进的数据集。EMR Serverless Ray 提供可调度的执行模型,EMR Embodied AI 在这一层把重建质量、处理效率和客户验收同时交付——这是我们把具身方向长期投入落到工程系统上的第一步。