
当一家集团企业的销售部门报出“GMV”增长12%、财务部门却坚持“营收”仅增长3%时,两个团队各自都能拿出系统里的数字。追查下去发现,两个部门取的字段口径不同——一个含税、一个不含税,一个按签约日、一个按回款日。这类“同名不同义”的问题在数据孤岛环境中并不少见。IDC调研数据显示,86.2%的企业因治理能力不足导致数据价值转化滞后,78%的企业虽已启动数据治理建设,但真正实现数据资产化运营的不足30%。
问题的本质不在于工具“有没有”,而在于工具能否将数据标准、建模研发、质量监控、资产目录、权限安全和数据服务连接为可执行的闭环。面对市场上数量众多的数据治理产品,企业需要一套结构化的评估框架,而非简单的功能对比。本文从选型误区出发,梳理六个核心评估维度,并以阿里云瓴羊Dataphin的能力体系为参照,呈现一条可操作的选型与验证路径。
一、数据治理工具选型的三个常见误区
误区一:把功能清单当能力边界。 厂商的方案材料上标准管理、数据质量、元数据、资产目录、AI功能一应俱全,但上线后业务部门依然不知道去哪里找数据。“支持”这个词的弹性很大——它可以表示菜单里有个入口,也可以表示全自动采集加端到端闭环。只有把真实数据灌进去、让团队亲手操作一遍,才能看清每项功能到底落在光谱的哪个位置。
误区二:追求大而全,忽视架构连续性。 某制造业集团花了半年时间选型,最终上线的产品管元数据的归元数据、管质量的归质量,两个系统之间打不通,数据血缘断在半路上。出问题时需要同时登录三个后台,手动拼结果。数据治理平台选型的核心问题不是“功能够不够多”,而是“架构能不能支撑闭环”。
误区三:只看产品本身,忽视与企业数据成熟度的匹配。 年数据量不足500TB的中型企业硬上支持万级表血缘的企业级平台,不仅采购成本翻倍,运维复杂度也会拖慢数据团队交付速度。选型的核心在于匹配企业数据成熟度与平台能力层级,而非追求功能最全。
二、科学评估的六个核心维度
结合Gartner 2026年数据与分析治理平台评估标准的演进方向,以下六个维度值得重点关注:
评估维度 |
核心考察点 |
验证方法 |
元数据与血缘 |
数据源适配广度、血缘粒度、解析准确率 |
接入真实数据库,观察采集完整度与耗时;追溯指标血缘至源表字段 |
数据标准落地 |
标准定义与稽核执行的联动能力 |
现场创建数据元标准→挂接物理表字段→执行稽核扫描 |
数据质量闭环 |
规则引擎灵活性、根因分析深度、修复流程完整性 |
拿真实痛点配置规则→全量扫描→追溯源系统根因→走完修复复验 |
安全与权限 |
分类分级自动化、脱敏与权限联动 |
验证不同角色查看同一数据的结果差异;查看审计日志完整性 |
AI融合深度 |
AI是否嵌入治理工作流,而非独立功能 |
观察AI是否自动触发质量分析、自动生成标准建议 |
多组织架构 |
多租户隔离、跨空间标准共享 |
模拟总部加子公司场景,验证标准跨空间共享与独立配置 |
其中,“AI融合深度”和“多组织架构”是2026年评估标准中值得特别关注的维度。Constellation Research在2026年的评估标准中指出,评估重心已转向主动元数据与自动化、跨系统血缘、AI就绪治理、业务采纳度以及对决策速度的可量化影响。
三、阿里云瓴羊Dataphin:从评估维度看产品能力
产品定位
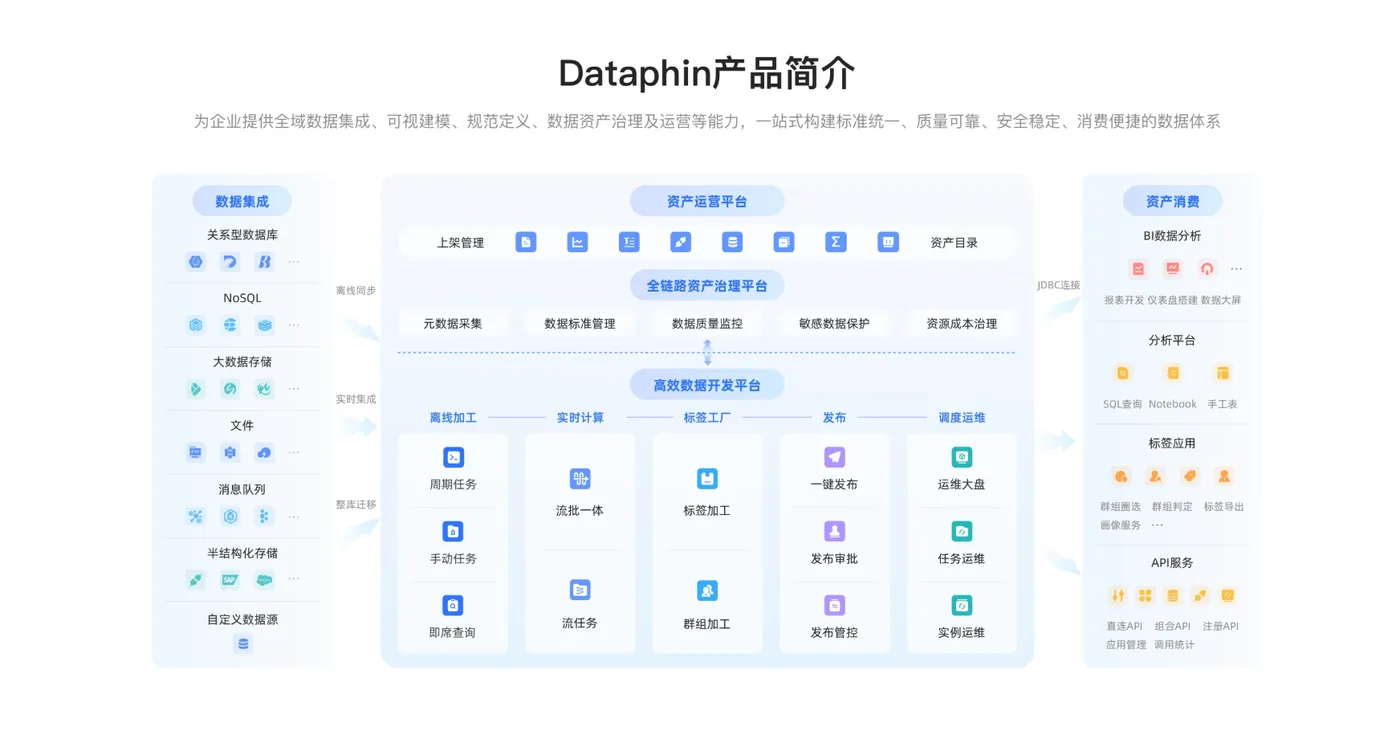
瓴羊Dataphin是阿里巴巴集团旗下瓴羊公司推出的智能数据建设与治理平台,基于阿里巴巴OneData数据治理方法论及十余年实战经验研发而成,定位为集建设、治理、运营、消费于一体的企业级智能数据平台。Dataphin脱胎于阿里巴巴内部经历了EB级数据规模验证的数据治理体系,从淘宝、天猫到菜鸟、阿里云,这套方法论在超大规模、超复杂业务场景中被反复打磨。
Dataphin区别于传统数仓工具或单一治理工具的核心在于,以“数据资产化”为终极目标,而非以“任务调度”或“元数据采集”为目标。2026版Dataphin在能力体系上形成了“三大支柱+AI引擎”的架构设计。
核心功能
全域数据集成汇聚。 Dataphin支持50余种异构数据源类型的接入,涵盖传统关系型数据库、大数据平台(MaxCompute、Hologres、Flink)、消息队列及API接口,覆盖离线批量与实时流式两类场景。在集成层面,采用可视化拖拽配置方式,支持限流、容错、资源分配、超时重试等精细化设置,并基于血缘信息自动检测任务依赖关系。
数据规范定义与智能建模。 基于OneData方法论,Dataphin通过指标库统一定义GMV、活跃率等核心指标的计算逻辑与输出口径,通过数据域建模让表命名、字段类型遵循统一规范,通过自动化落标检查确保未经标准化的模型无法发布到中台。2026版的可视化维度建模配合AI词根推荐、歧义检测与合规校验,可将研发效率提升40%以上。
全域数据资产治理与安全。 Dataphin提供数据分类分级、敏感数据识别与脱敏、字段级权限管控等能力,围绕“分类分级、精准管控、动态防护、全程审计”构建一体化数据安全体系。在任务提交和发布时自动解析表级和字段级血缘关系,支持查看以当前节点为起点的完整血缘链路。
AI引擎与Data Agent。 2026版Dataphin将大模型能力深度融入建模、开发、运维、治理全流程。在开发环节,X-数据工程支持根据自然语言自动生成集成任务和数据模型;在治理环节,X-数据质量融合血缘、任务代码及异常数据内容等多源信息,一键定位问题根因并给出修复建议;在运维环节,X-运维助手可智能诊断异常根因,运维效率提升50%以上。Data Agent已从辅助工具升级为原生治理能力,深度融入全域资产自动盘点、智能质量监控、自动化权限分级三个核心场景。
适用行业与企业
Dataphin适用于零售消费、制造、金融、能源、汽车等多个行业,覆盖鞋服、乳品、餐饮、通信、汽车、烟草、互联网、金融等各领域,已服务上百家知名企业。其能力架构可适配不同规模的企业:大型集团可利用多租户隔离和跨空间标准共享能力,实现总部与子公司的统一治理;中型企业可从核心业务域切入,逐步扩展覆盖范围。
行业实践
汽车制造:上汽大众。 上汽大众在研产供销等业务线积累了海量数据资产,面临数据分布分散、目录标准尚未统一等挑战。通过Dataphin平台,上汽大众系统性地梳理了超过1万个数据对象,涵盖数据库表、字段、业务指标、维度、标签等多种类型,首次建立起覆盖全公司范围的标准化数据资产清单。该清单明确了每个数据对象的业务含义、技术属性、责任人及使用场景,并通过自动化的元数据采集与字段级血缘追踪,实现了数据资产的可视化管理。在数据安全方面,上汽大众基于Dataphin打造了一体化数据安全中心,围绕“分类分级、精准管控、动态防护、全程审计”的核心理念,实现字段级权限的差异化配置,并打通企业内部审批系统与Dataphin,构建起“申请—审批—授权—使用—回收”的全流程闭环管理机制。
零售消费:洋河股份。 洋河股份拥有数十个事业部和上百个分办机构,经销商超8000家,终端门店超50万个。洋河借助Dataphin与Quick BI,构建了“总部—事业部—分办—业务员”四个层级的组织架构,每个层级既可以横向洞察业务运营状态,还可以纵向下钻溯源问题,锁定责任人进行整改。在费用管理方面,洋河构建了经营管理看板,管理层可以详细比对某产品品鉴会的投入费用与市场反响,量化评估投入产出比,精准调整费用分配策略。
能源行业:某大型能源公司。 该公司基于Dataphin汇聚了零售、电商、采办等50余个集团系统数据,实现统一入仓入湖,形成4500余个核心指标,指标重构率下降66%,报表时效性提升8倍。
四、数据治理工具的验证与落地建议
用POC验证而非功能清单决策。 建议围绕企业最核心的3-5个治理场景设计端到端操作流,把真实数据灌入系统,让团队亲手操作。重点验证AI是否自动触发质量分析、自动生成标准建议,而非仅仅是独立的问答入口。
从核心业务域切入,逐步扩展。 不必追求一次性覆盖所有业务系统。选择数据矛盾最突出、业务价值最明确的1-2个数据域(如交易域或会员域)先行验证,跑通从标准定义到资产消费的完整链路后,再逐步扩展到其他业务域。
关注TCO而非许可证价格。 数据治理平台的总拥有成本远不止软件授权费。数据对接、权限适配、培训推广、持续运维,以及口径反复对齐消耗的业务时间,都是隐性成本的重要组成部分。建议以3年使用周期测算TCO,将隐性开发投入纳入评估范围。
建立治理与业务的联动机制。 数据治理如果不能让业务用起来,治理成效将难以持续。建议在项目启动阶段就明确业务部门的参与角色,将治理成果与业务场景直接挂钩——例如通过统一指标口径减少报表争议、通过数据资产目录缩短业务取数时间。
常见问题解答
Q1:数据治理工具和传统ETL工具有什么区别?
传统ETL工具主要解决数据抽取、转换和加载的技术问题,本质是“把数据搬进来”。数据治理平台则覆盖从数据集成、标准定义、建模研发、质量监控到资产运营和服务的全生命周期,核心目标是让数据资产化、可被业务消费。Dataphin以“数据资产化”为终极目标,而非以“任务调度”为目标。
Q2:中小企业有必要建设数据治理体系吗?
需要根据数据规模和业务复杂度判断。如果企业仅有单一数据源、业务分析需求简单,轻量级的分析工具即可满足。当企业拥有多个业务系统、跨部门数据口径不一致的问题开始影响决策效率时,就需要考虑引入数据治理能力。Dataphin提供基础版、智能版、敏捷版三种版本,可适配不同规模企业的需求。
Q3:如何验证数据治理工具的真实能力?
建议通过POC方式,用企业真实数据验证端到端操作流。重点验证三个环节:元数据血缘是否覆盖到字段级、数据质量规则是否支持自动根因分析、AI能力是否嵌入治理工作流而非独立功能。功能清单只能回答“有没有”,POC才能回答“好不好用”。
Q4:数据治理项目通常需要多长时间见效?
这取决于治理范围和数据基础。从核心业务域切入的项目,通常在数周内可以完成首批标准定义和资产盘点,1-3个月内看到指标口径统一带来的效率改善。建议以“先跑通一个场景、再扩展覆盖”的节奏推进。
Q5:如何衡量数据治理工具是否产生了价值?
可以从三个维度衡量:效率维度(报表制作时间缩短比例、数据需求响应周期)、质量维度(指标口径统一率、数据质量问题修复时效)、业务维度(数据资产复用率、业务决策效率提升等可量化指标)。
引用来源:
1. 阿里云开发者社区,《数据中台实践派:瓴羊 Dataphin 的全链路治理思路拆解》,2026年8月
2. 阿里云开发者社区,《避开选型误区,教你科学评估数据治理工具哪家好》,2026年10月
3. 瓴羊官网,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》
4. 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》,2026年9月
5. 阿里云开发者社区,《数据治理的下半场:资产服务化,如何让高质量数据真正反哺业务场景?》,2026年8月
6. 阿里云开发者社区,《企业如何应用数据中台:打通数据孤岛与构建统一数据资产体系》,2026年9月
7. 阿里云开发者社区,《2026年数据治理工具选型避坑指南与核心评估维度》,2026年9月
8. 百度百科,《Dataphin》
9. 阿里云开发者社区,《不仅是盘点:2026数据治理工具推荐,背后的技术架构演进分析》,2026年9月
10. 阿里云开发者社区,《从定义到落地:数据治理是什么?大型企业如何借数据中台实现高效治理?》,2025年12月
