测试工程师必备:源码并发风险扫描 Skill 来啦!

简介: 实际项目里,测试同学往往很难提前判断 哪些接口需要压测 ,也识别不出 哪些接口潜藏并发风险 。 大多都是线上出了故障之后,才后知后觉去补性能压测。缺的不是工具,而是 白盒层面的前置识别手段 ——流量一冲高,各类并发问题就容易集中爆发。 那么:我们 能不能让 AI 直接读源码,提前把并发隐患挖出来,而不是等线上出了问题才来补救? * 一、黑盒模式的 4 个常见问题 在没有白盒扫描之前,团队里最常见的 4 类痛点: 1. 并发风险靠经验判断 哪些接口存在并发隐患、需不需要做压测,大多是资深测试或者产品凭经验来定。新人很难识别出来,很容易漏掉风险点。 黑盒功能测试很难挖到代码层面问题

实际项目里,测试同学往往很难提前判断哪些接口需要压测,也识别不出哪些接口潜藏并发风险。

大多都是线上出了故障之后,才后知后觉去补性能压测。缺的不是工具,而是白盒层面的前置识别手段——流量一冲高,各类并发问题就容易集中爆发。

那么:我们能不能让 AI 直接读源码,提前把并发隐患挖出来,而不是等线上出了问题才来补救?

*

一、黑盒模式的 4 个常见问题

在没有白盒扫描之前,团队里最常见的 4 类痛点:

1. 并发风险靠经验判断

哪些接口存在并发隐患、需不需要做压测,大多是资深测试或者产品凭经验来定。新人很难识别出来,很容易漏掉风险点。

  • 黑盒功能测试很难挖到代码层面问题

接口功能跑通不代表就安全。像共享变量处理不当、锁设计不合理、缺少幂等这些问题,普通功能用例基本测不出来。

  • 风险暴露太晚,修复代价更高

很多并发 bug 平时跑正常,只有大促、活动高流量的时候才会爆发。等到线上出事再改,成本和风险都很高。

  • 和开发对齐缺少依据,沟通费劲

就算测试直觉觉得这块逻辑有隐患,也拿不出一份清晰的风险清单,很难推动开发提前整改,沟通全靠口头说

*

二、我的方案:源码并发风险扫描 Skill

针对这些痛点,我开发了一个并发风险扫描 Skill。

核心能力:读取项目源码做白盒分析,挖掘潜在并发风险点,输出风险问题清单、对应测试场景,以及给开发的整改建议。

拿到结果后,测试同学可以:

✅ 针对性验证:按清单里的测试场景做并发/压测验证
✅ 同步开发前置修复:把风险清单直接丢给开发,提前改
✅ 减少被动救火:把并发类缺陷尽量拦截在上线前

*

三、Skill执行流程

 text
本地项目源码
 ↓
Skill 白盒分析
 ↓
并发风险识别
 ↓
风险清单 Markdown 
 ↓
测试场景 + 开发整改建议

执行原理可以拆成三步理解:

1. 读代码:在有权限的前提下,扫描指定接口 / 模块 / 项目源码;

2. 挖风险:识别共享状态、锁/事务、幂等、竞态等常见并发隐患模式;

3. 出报告:输出Markdown格式的报告,包含概览、结论、问题详情、验证方法、修改建议。

*

四、操作步骤

1、拉取项目

本方案基于代码扫描做风险识别,前提是你需要拥有项目代码权限。把对应项目代码拉到本地后,再执行后续操作。

git clone 项目地址

2、Skill 下载与安装

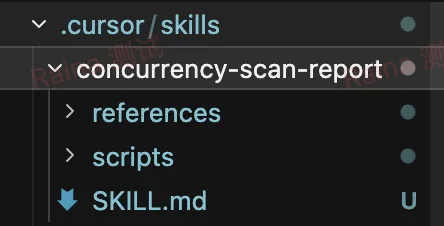
将 Skill 文件夹复制到你当前 AI 工具对应的 skills 目录,例如:

  • Cursor:.cursor/skills
  • Claude:.claude/skills

具体目录以你使用的工具为准。放好后,在对话中 @ 引用该 Skill 即可调用。
有能力的小伙伴可以参考思路自行改造;需要现成 Skill 包和详细教程的,可以到【Raina的AI&测试实战圈】获取~

3、Skill 执行(两个实战案例)

下面用两个案例讲清楚:单接口扫描 和 项目/模块扫描。

*

五、案例实践

案例 1:单接口并发风险扫描

适合已经怀疑某个接口有问题,或者准备对某个核心接口做压测前的「白盒预检」。

输入:

指定单个接口 / 对应源码路径,让 Skill 对该接口相关实现做并发风险分析。
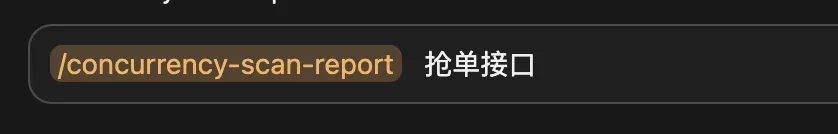
执行过程:

Skill 读取相关源码 → 做白盒并发分析 → 生成 Markdown 风险报告。
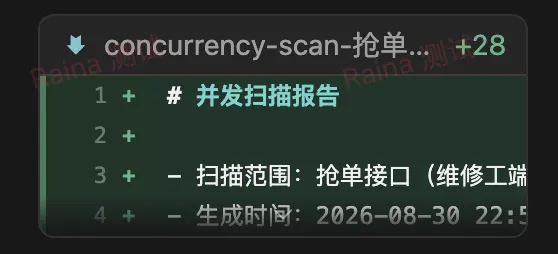
输出:

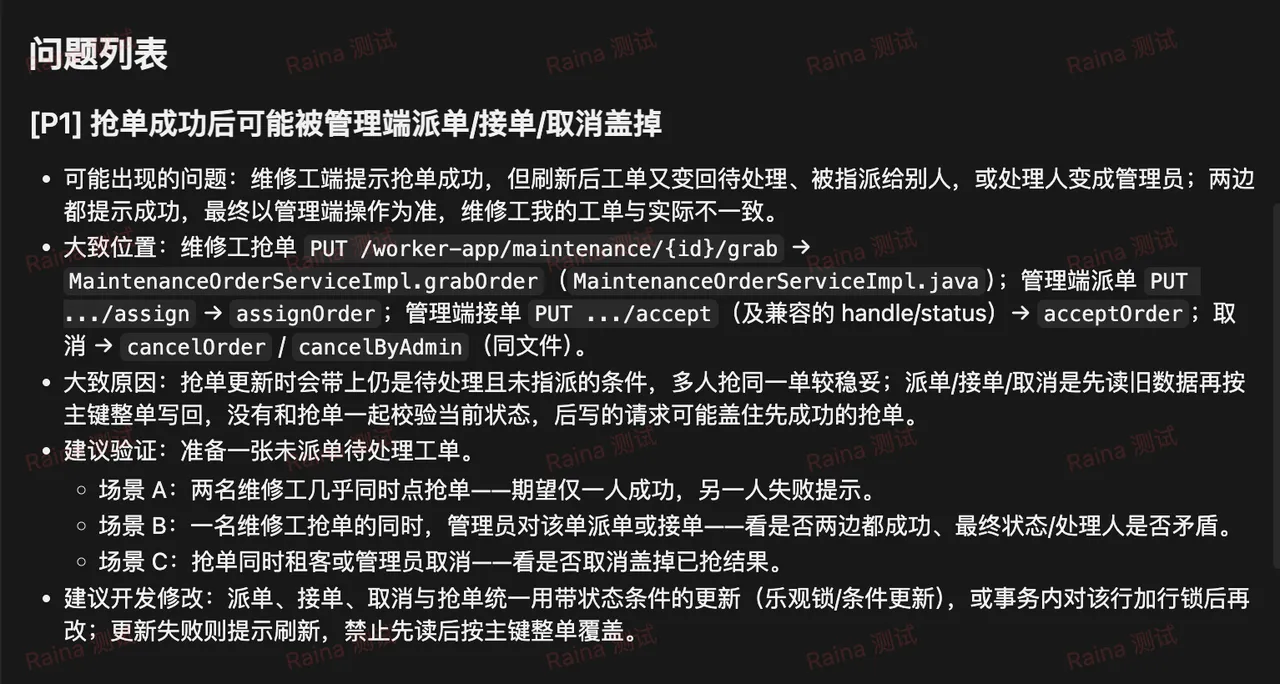
产出一个 Markdown 文件。报告里通常包含:

1. 概览:扫描范围、生成时间、语言、文件数
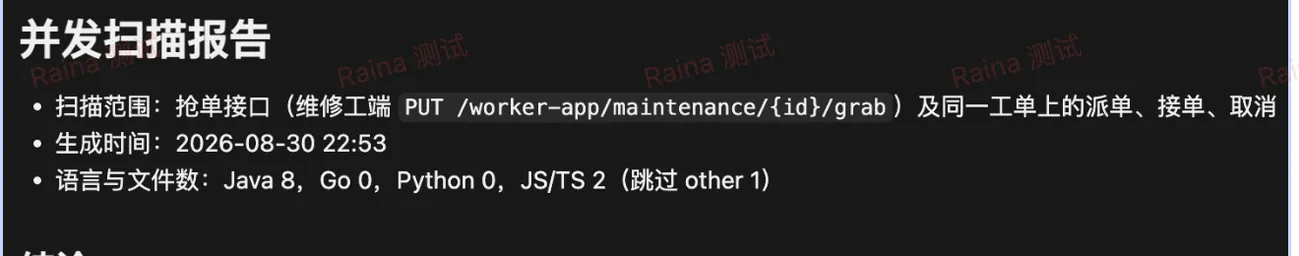
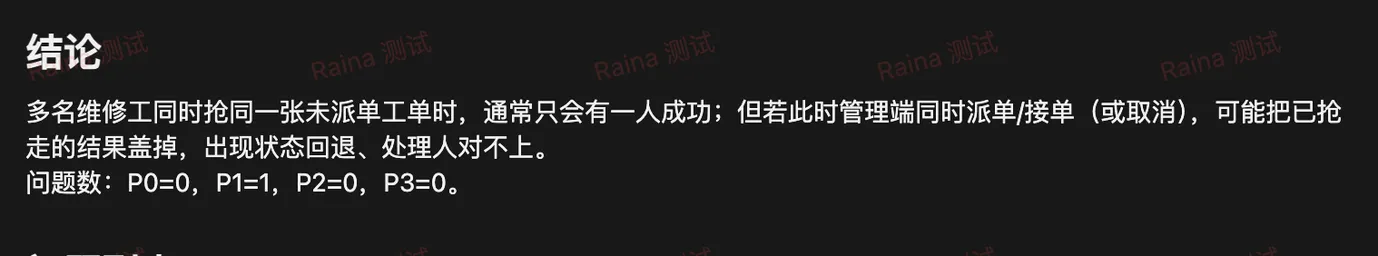
  • 结论:整体风险判断(要不要重点压、优先修哪里)

  • 详细问题列表(重点阅读):
  • 可能存在的问题是什么
  • 代码大致位置(方便溯源、给开发看)
  • 大致原因

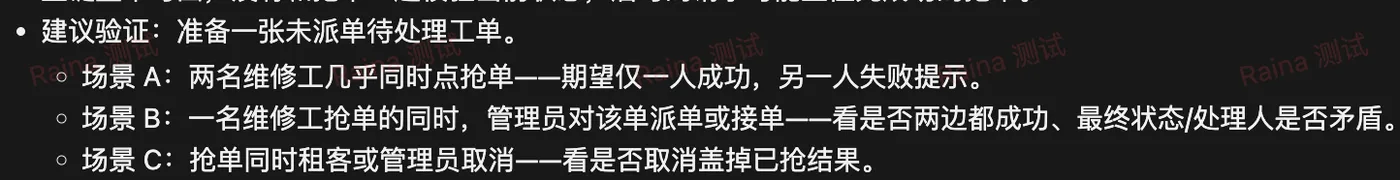
  • 测试如何验证(很关键:告诉你怎么复现/验证并发问题)

  • 给开发的修改建议

这部分最实用的价值在于:不只是告诉你「可能有问题」,还会告诉你怎么测、怎么让开发改。

*

案例 2:项目扫描 / 模块扫描

适合版本提测前做一轮「并发隐患摸底」,或者中小型项目想快速过一遍风险面。

提醒:如果项目体量很大,不建议直接全仓扫描,否则 token 消耗会比较大。优先按模块 / 核心业务包缩小范围会更稳。

输入:

指定项目根目录,或某个业务模块路径,发起扫描。
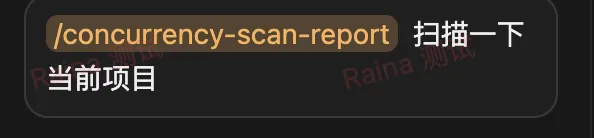
执行过程:

Skill 在指定范围内批量分析源码 → 汇总并发风险点 → 输出统一 Markdown 清单。

输出:

同样产出 Markdown 报告。中小型项目上,往往能一次扫出不少问题点——包括你平时功能测试很难直接想到的竞态、共享状态、幂等等风险。
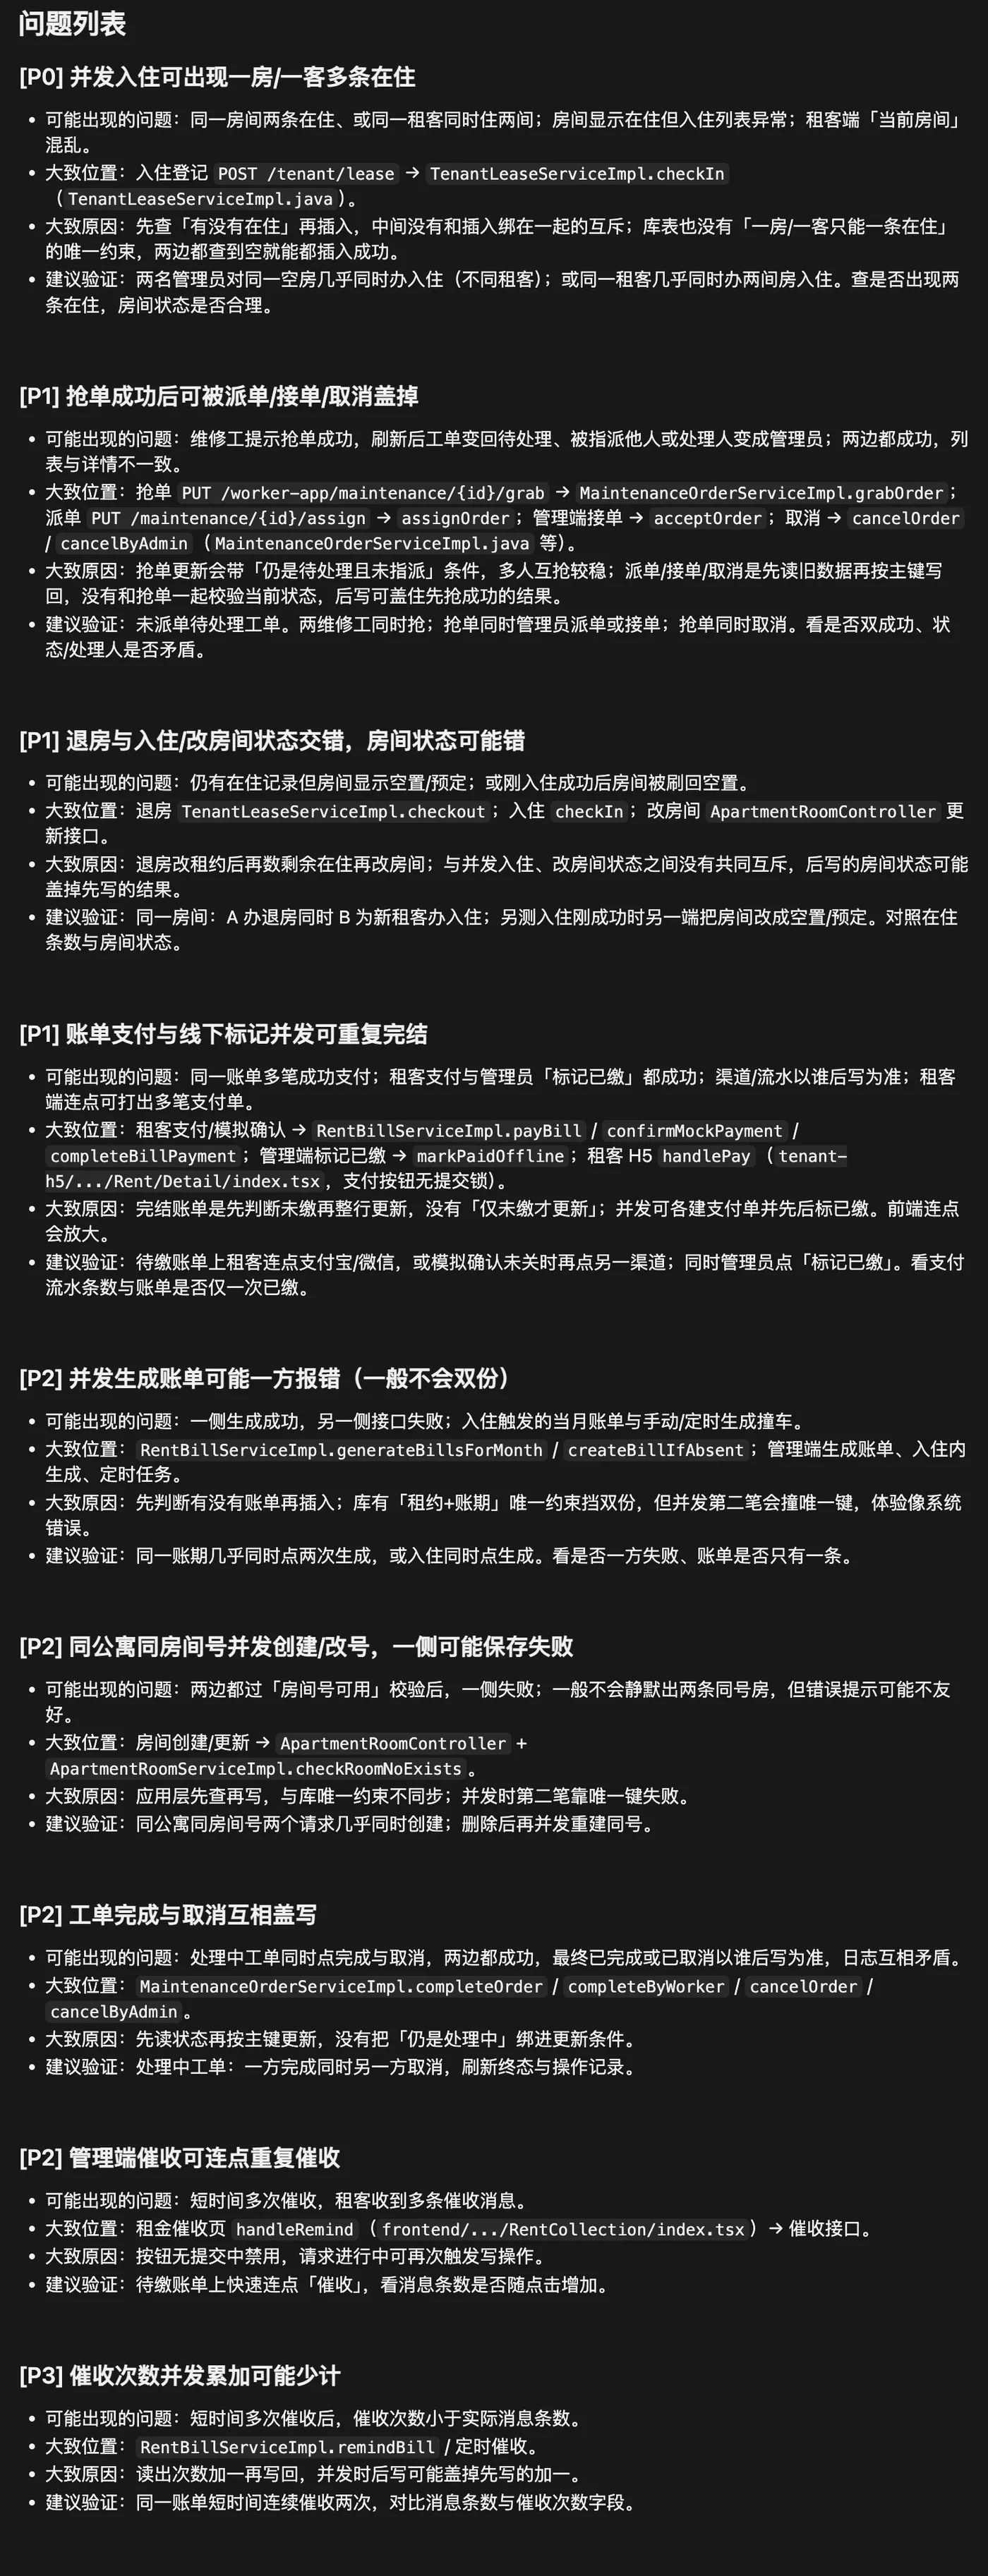
拿到清单后,建议测试同学按优先级拆:

1. 高风险:先同步开发修,再补并发验证

2. 中风险:纳入压测候选接口清单

3. 低风险:记录备案,大促/高峰前复核

*

六、小结

并发问题最头疼的,往往不是测不出来,而是压根不知道该重点测哪里。

这套源码并发风险扫描 Skill,核心思路就是: 通过白盒扫描先输出完整风险清单,再据此确定压测范围与验证场景,让测试从事后被动救火,转变为上线前的前置风险拦截。

既支持单接口精扫,针对重点接口做深度排查;也支持模块整体扫描,对整块业务做全面风险摸底。扫描产出的报告,既可以用来指导我们做测试、压测验证,也可以直接给到开发,作为整改修复的依据。

以上是今天分享的内容。 Skill及详细教程已整理在【Raina的AI&测试实战圈】知识星球,跟着步骤操作就可以上手。感兴趣的小伙伴可以加入了解哦~
目录
相关文章
|
22天前
|
缓存 IDE Java
Git Worktree 深度实战:从底层原理到 Java 开发效率翻倍指南
Git Worktree 是 Git 2.5 引入的高效多分支开发方案:单仓库、多工作目录,共享对象库,隔离工作区。告别频繁 stash/checkout、重复 clone 和编译中断,大幅提升并行开发效率,尤其适用于紧急修复、多版本维护与代码评审等场景。
100 1
|
22天前
|
SQL 分布式计算 Serverless
EMR Serverless Spark 推出 Spark 4.0,加速湖仓架构下的数据处理升级
Spark 4.0 通过引入 VARIANT 半结构化数据类型、原生 SQL UDF 和增强的 PySpark 生态,显著提升了湖仓一体架构下的查询性能、SQL 表达能力与 Python 工程效率;阿里云 EMR Serverless Spark 已全面支持该版本,企业可开箱即用这些能力,无需运维集群或处理兼容性问题,加速数据处理升级。
139 0
EMR Serverless Spark 推出 Spark 4.0,加速湖仓架构下的数据处理升级
|
22天前
|
缓存 运维 Java
Maven 私服怎么搭:从安装到配置settings.xml 以及托管、代理、聚合仓
私有化部署后接 Maven:建 HOSTED/PROXY/GROUP,配 settings.xml 与 pom.xml,完成 resolve、deploy,并处理 401/409。
|
22天前
|
人工智能 前端开发 Java
GLM 5.3 与 DeepSeek V4.1 相继上线:Java 工程缺的从来不是模型
智谱GLM-5.3与DeepSeek V4.1 Flash等新模型密集迭代,能力跃升显著:编程、长程任务、多模态与推理全面增强。但模型强≠代码可用——需工程层封装(如需求分析、接口设计、全栈生成)才能落地Java项目。
|
22天前
|
人工智能 缓存 自然语言处理
AI Agent 交付物验收:Evidence Pipeline 自动验收链路工程实现
本文深度拆解AI Tutor Engine的Rubric自动验收流水线,涵盖Evidence采集、三重门控(Precheck/CI直判/LLM语义评审)、确定性聚合等全链路,厘清“证据存在”与“证据通过”的本质区别,明确当前能力边界及与业界方案的定位差异。(239字)
99 0
|
22天前
|
弹性计算 定位技术 云计算
笔记越记越多,为什么反而更难找?Trilium 把它们长成一棵树
Trilium 是把笔记组织成任意深度树形结构,并允许同一篇笔记出现在多个位置的个人知识库。通过阿里云计算巢部署,实测约 71 秒即可得到可访问的 Trilium,无需手工安装 Docker、配置容器和持久化目录。
|
22天前
|
SQL 中间件 关系型数据库
没人改代码接口却超时|我给数据库加了四道防线
从交易接口零星超时、优化慢 SQL 却不见效切入,讲清数据库是共享资源池,重查询会饿死交易;给出入口、语句、负载、实例四道隔离防线,拆解超时、资源组、中间件路由与熔断做法,并附负载分级表与隔离验证。
|
22天前
|
人工智能 决策智能 云计算
把一份教材变成会讲、会问、还能动手玩的课堂 —— OpenMAIC
OpenMAIC 接手从主题或材料到完整互动课堂的生成过程。通过阿里云计算巢部署,实测约 1.5~2 分钟即可打开,无需自己安装 Docker、配置反向代理和开放访问入口。
|
22天前
|
数据采集 人工智能 自然语言处理
从0到1:一家南阳小公司的GEO实战记录
通过GEO(生成式引擎优化)策略,三个月内将核心关键词在AI对话平台中的引用率从0跃升至67%。案例验证:小企业可借高质量、本地化、结构化知识内容,绕过传统SEO资源壁垒,成为大模型可信信源。(239字)
|
22天前
|
Web App开发 人工智能 安全
Personal Agent 是什么?为什么大厂都抢着做?连 DeepSeek Bot 都来了。。
Personal Agent 是什么?为什么大厂都在抢着做?跟 OpenClaw、WorkBuddy 等 AI 有什么区别?一文带你搞懂 Muse、Dots 等 Bot,实际体验 Grok Bot,真的好用么?
324 0
Personal Agent 是什么?为什么大厂都抢着做?连 DeepSeek Bot 都来了。。