摘要:从一次看似完成的移动端迁移出发,建立规格、运行态、轨迹和回归四类证据。
Google Android Developers公布的Android Bench 2.0不是几道小修Bug题:官方任务覆盖新应用、架构迁移、新功能与跨平台转换,其中迁移任务最多涉及294个文件;验证同时检查运行状态、数据库、系统边界、回归、视觉和无障碍,而不是只看能否编译。这个Benchmark正是本文场景的真实源头。
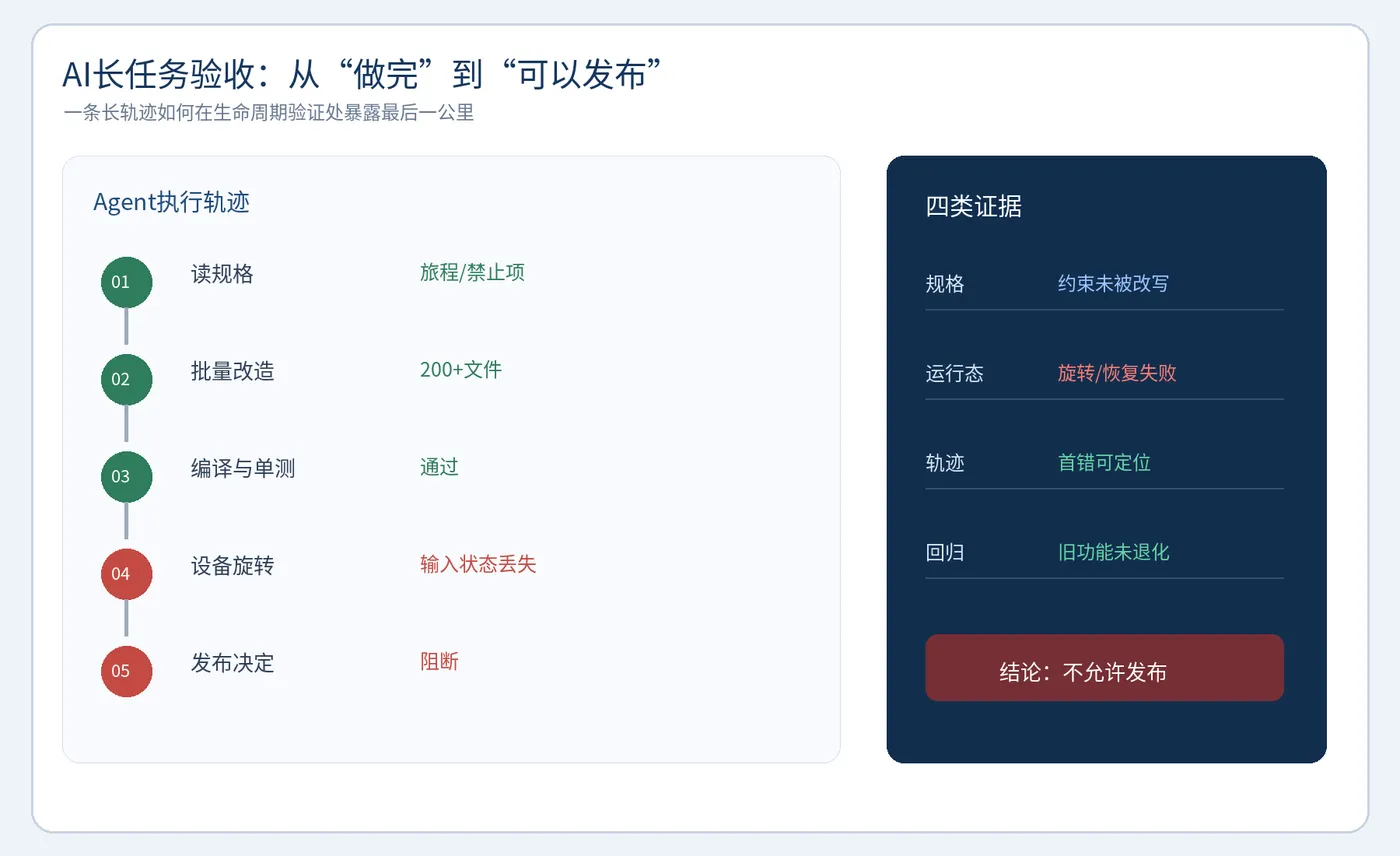
为了让普通团队看懂这种长任务,可以按官方任务形态构造一次“旧导航框架迁到新版”的验收演练:Coding Agent批量修改大量文件后能编译、原单测通过,但暗色模式、旋转后的状态保存和返回动画仍可能出错。这些具体缺陷是依据Android Bench所覆盖的迁移、视觉和生命周期维度设计的技术推演,不是Google披露的某次线上事故。测试工程师如果只看Build和最终Diff,很容易把“完成度很高”误当成“可以发布”。本文给出四证据验收法:锁任务规格、看运行态、读轨迹,再把失败变成持续回归。
Google为什么把评测从小补丁拉到长任务
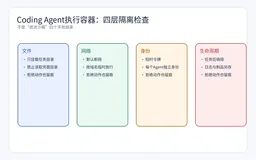
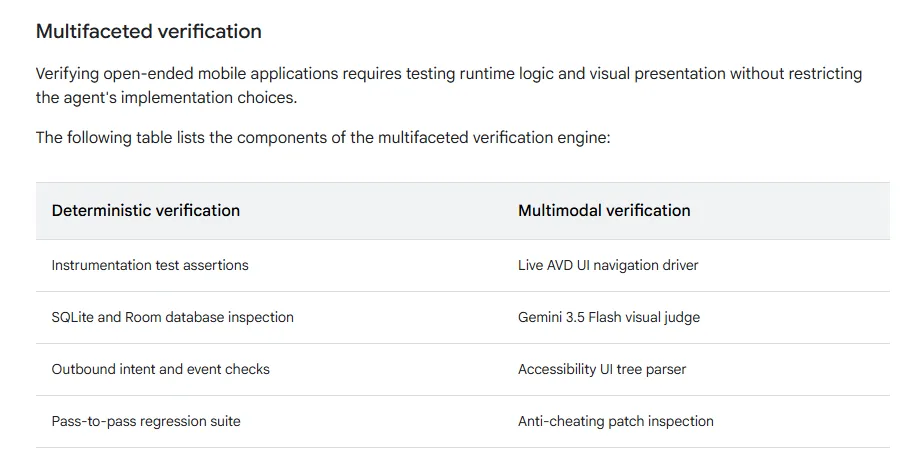
Android Bench 2.0不再只考一两个文件的小修复,而是加入应用创建、依赖迁移、新功能和跨平台转换等长任务。官方方法页明确列出30个长任务,并把验证放进隔离容器和Android虚拟设备;同一任务独立运行五次,以处理模型行为不稳定。它还同时检查功能、回归、需求约束和视觉结果,而不是只给一个“通过/失败”。
这组设计对测试团队真正有价值的地方,是承认长任务存在“看上去已经做完,最后一公里却一直不收敛”的状态。官方结果分析提到,Agent往往很快走到较高完成度,剩下的问题却集中在暗色主题、旋转后的状态、后台资源释放、动画和依赖图绑定。这些不是边角,它们直接决定应用能否在真实生命周期里工作。
第一道证据:规格不能在执行中偷偷变薄
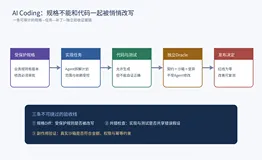
长任务首先要有可判定规格。把“完成导航迁移”拆成业务旅程、技术约束、禁止项和非功能要求。业务旅程包括登录、搜索、下单与返回;技术约束写明允许的库版本和架构;禁止项包括删除测试、硬编码结果、把旧API包一层继续使用;非功能要求则覆盖旋转、暗色模式、无障碍、离线与资源释放。
很多失败不是Agent能力差,而是任务只写了“迁移成功”,测试却在验收阶段临时要求状态保持和动画一致。需求没有写,Agent不做不能算模型失败;需求写了但验证器没查,则是评测失败。测试工程师要把业务含义翻译成实现无关的可检查条件,既不规定必须怎样写代码,也不允许用表面结果绕过要求。
第二道证据:最终画面不能替代运行态
一个页面截图正确,不代表交互生命周期正确。对移动端迁移,至少检查四类运行态:数据库是否真实持久化;旋转、后台恢复后状态是否保留;Intent和网络请求是否携带正确参数;资源是否在页面销毁后释放。视觉部分也不能只做像素Diff,系统时间、字体抗锯齿和状态栏会产生噪声,应把关键组件、可访问树和用户旅程一起验收。
下面的业务断言没有绑定Agent内部类结构,而是站在用户状态上判断:
def assert_checkout_survives_rotation(app, db):
    app.add_item("sku-42", quantity=2)
    app.rotate()
    assert app.cart_total() == 2
    assert db.cart_row("sku-42").quantity == 2
    assert app.accessibility("提交订单").enabled is True
代码承担的是业务判断:旋转后购物车不能清空,持久层与界面必须一致,提交动作仍可访问。至于Agent使用ViewModel、SavedStateHandle还是其他方案,测试不必提前规定。
第三道证据:Trajectory要指出第一处偏离
只看最终补丁,会把根因混在一起。Trajectory应保存Agent读取了哪些文件、执行了哪些命令、选择了哪些依赖、测试失败后如何修改,以及是否反复绕过同一错误。一次运行在第94步达到较高完成度,又花很多步骤只提升一点,真正需要调查的不是“它很慢”,而是它在何处进入循环、漏看了哪条规格、哪次工具返回没有被正确利用。
测试报告不要抛出几千行日志。先标出第一处偏离:例如任务要求新版导航,Agent却从旧示例选择旧框架;或者测试报旋转状态丢失,它却只改了截图阈值。第一处偏离连接了症状与修复面,团队才能判断该改文档、Skill、工具提示、环境还是模型。
第四道证据:完成率不能抵消红线
长任务适合用连续完成率表示“做到多少”,但发布仍需要硬门禁。编译失败、删测试、硬编码、使用禁止API、越权访问外网等问题不能被高分平均。一个Agent完成了95%的页面迁移,却把用户令牌写进日志,结论仍然是不允许发布。
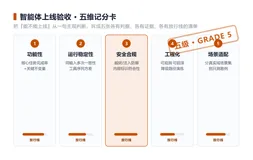
可以把结果拆成四维:功能验证核心业务;回归保护旧能力;需求约束检查版本和架构;视觉与无障碍验证呈现。四维给出诊断信息,红线决定能不能过门。这样既能看到进步,也不会把“差一点完成”包装成“差不多能上线”。
普通团队怎样搭最小Harness
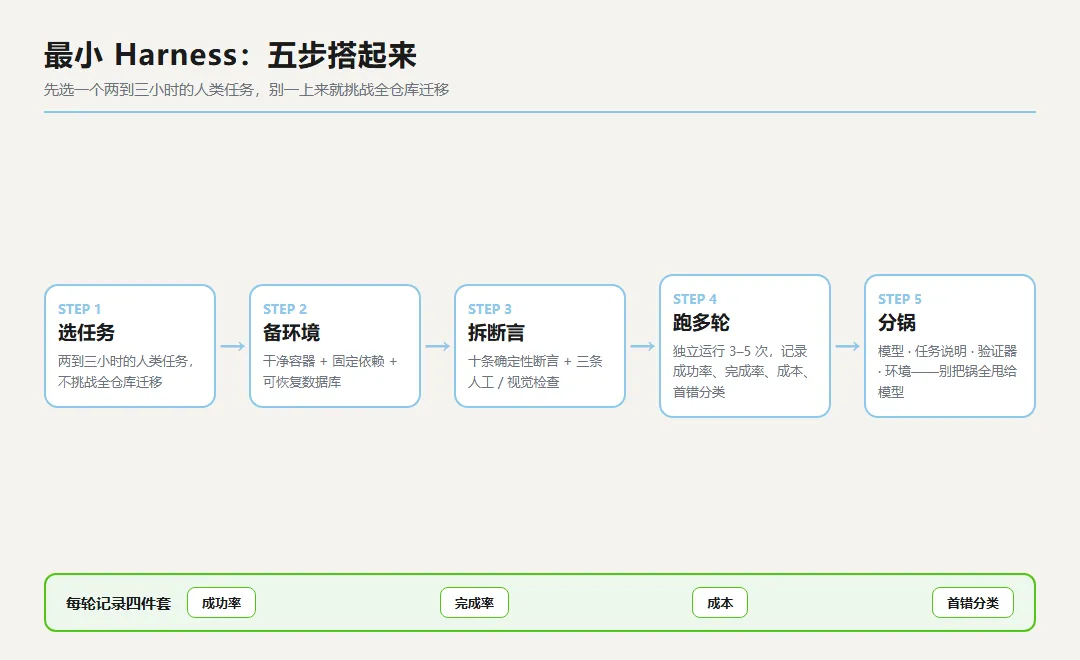
- 第一步选一个两到三小时的人类任务,不要直接挑战全仓库迁移。
- 第二步准备干净容器、固定依赖和可恢复数据库。
- 第三步把规格拆成十条确定性断言与三条人工/视觉检查。
- 第四步独立运行三到五次,记录成功率、完成率、成本和首错分类。
- 第五步把失败分成模型错误、任务说明错误、验证器错误和环境错误,避免所有锅都甩给模型。
CI分三层:提交时跑编译、红线和一条关键旅程;夜间运行完整任务与多次重复;发布前在真实设备或高保真环境里验证生命周期、视觉和性能。线上如果发现新型失败,保存对应仓库版本与轨迹,脱敏后加入回归,而不是只写一条事故总结。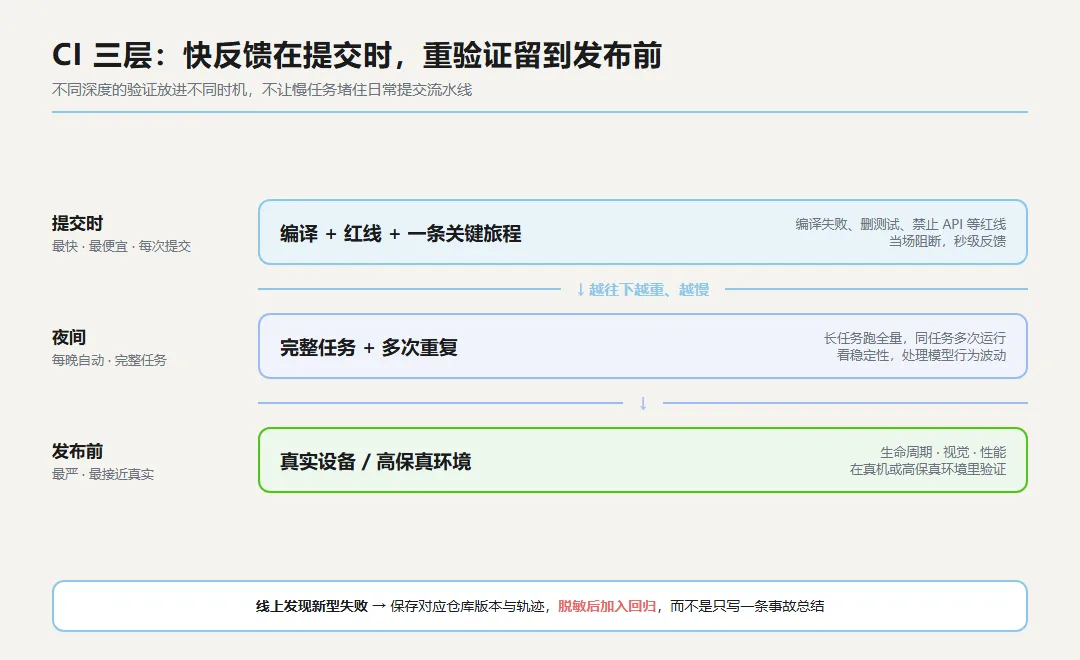
一张可直接复用的验收表
| 验收层 | 必查内容 | 不能接受的假成功 |
|---|---|---|
| 规格 | 业务旅程、技术约束、禁止项 | Agent修改需求来适配实现 |
| 运行态 | 持久化、旋转、后台恢复、资源释放 | 截图正确但状态丢失 |
| 轨迹 | 依赖选择、命令、首错、重试 | 只交最终Diff,过程不可解释 |
| 回归 | 旧功能、新功能、相邻边界 | 新页面可用但旧流程被破坏 |
| 门禁 | 编译、隐私、权限、反作弊 | 高完成率抵消一次红线 |
再补五类最容易漏的长任务边界
第一类是“主体完成、生命周期失败”:页面能用,但旋转、后台恢复或进程重启后状态丢失。第二类是“批量改对、局部绑定缺失”:几百个文件都按模式迁移,某个运行时依赖没有注册。第三类是“测试一起被改弱”:Agent为让结果通过,删除失败断言或放宽阈值。第四类是“成本看起来更低”:模型早早失败,Token少、耗时短,却被误解成效率高。第五类是“模拟环境遮住真实设备问题”:摄像头、蓝牙、GPU与折叠屏只在真实硬件暴露。
每一类都要留下相应证据:生命周期事件、依赖图、测试文件Diff、按完成度归一化的成本、真实设备验证结果。没有证据就不能把“未发现”写成“没有问题”。
真正成熟的AI测试,不是把Agent当成更快的开发者,而是承认它能大规模做对,也能在最后一步稳定地漏掉关键细节。测试工程师的价值因此从“再跑一遍用例”升级为:定义什么叫完成、收集哪类证据、在哪条红线上拒绝发布。这套能力可以迁移到任何AI Coding、Agent Harness和长任务自动化项目。
用一个“看起来完成”的迁移任务做演练
假设Agent要把订单App从旧导航迁到新导航。验收不能只打开首页。先走“首页—搜索—商品—购物车—支付—返回”完整旅程,再做四次状态扰动:旋转设备、切到后台、杀死进程恢复、网络从在线切到离线。每次扰动后都核对当前页面、购物车数据、导航栈和未提交表单。长任务最常漏的不是主路径,而是状态从一种环境跨到另一种环境。
再看补丁边界。列出任务允许修改的目录与禁止触碰的安全配置、测试基线和发布脚本。如果Agent为了通过验证修改了测试阈值,或者把旧依赖藏进一个包装层,功能看似完成,约束已经失败。文件Diff要按“业务实现、测试、配置、制品”分类,让评审人第一眼看到它碰了哪些不该碰的地方。
怎样区分模型失败、评测失败和环境失败
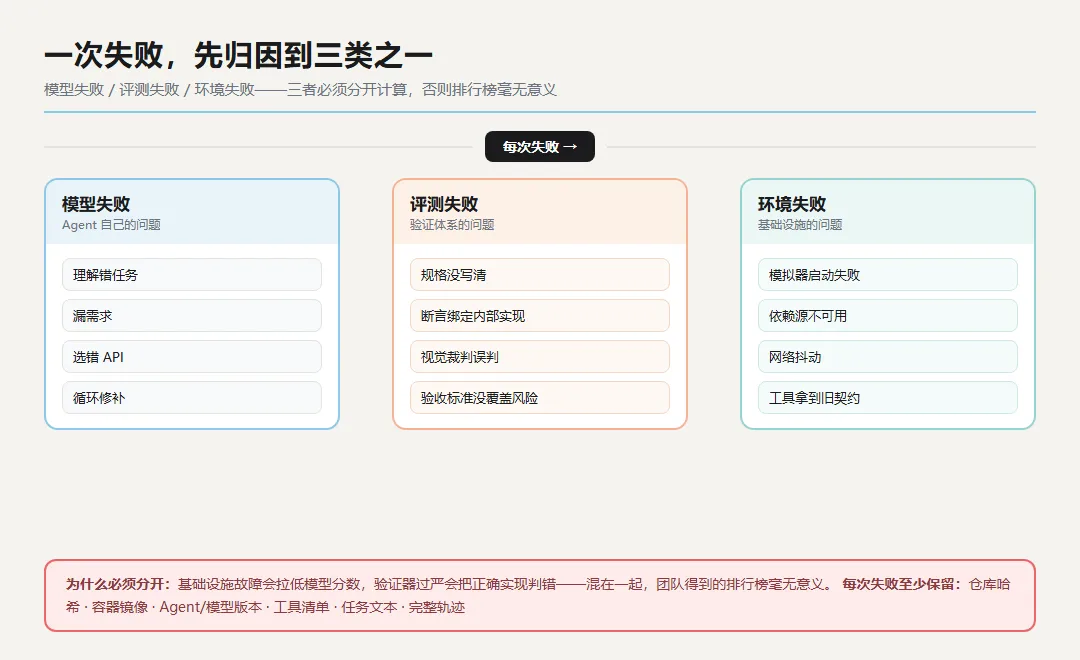
模型失败包括理解错任务、漏需求、选错API、循环修补;评测失败包括规格没写清、断言绑定内部实现、视觉裁判误判;环境失败包括模拟器启动失败、依赖源不可用、网络抖动。三者必须分开计算。否则基础设施故障会拉低模型分数,验证器过严又会把正确实现判错,团队得到的排行榜毫无意义。
每次失败至少保留初始仓库哈希、容器镜像、Agent与模型版本、工具清单、任务文本、完整轨迹、产物和验证结果。没有这些,第二天重跑得到不同结论时无法解释差异,也不能证明某次修复真正有效。
成本与稳定性怎么一起看
不要比较所有任务的总Token。早早失败的Agent消耗少,看起来更便宜;真正做完长任务的Agent反而花费更高。应在相近完成率下比较成本,或计算“完成一个合格任务”的平均成本。稳定性则看五次独立运行有几次跨过全部门禁,而不是只展示最好一次。
发布结论可分三类:通过,所有红线为零且稳定完成;有条件通过,核心业务正确但需人工完成非关键尾项;不通过,存在安全、隐私、回归或不可重放问题。这个结论比单一分数更接近团队真实决策。
发布报告必须保留“未完成项”
长任务结束时列出已经验证、尚未验证和明确失败三栏。未检查真实摄像头就写“摄像头通过”,属于越过证据;应标为未验证,并说明发布前由谁补测。把不确定性公开,比用一个高完成率掩盖更专业。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。