聊天记录搜索找到了一条消息,接下来还要把命中的关键词标出来。常见写法是在消息字符串里插入 <mark>,再赋给 innerHTML。它看起来只增加了一层黄色背景,却同时改变了消息的解释方式:原本只是文字的内容,进入了 HTML 解析器。
以米米商聊为背景,已整理的手机端资料支持按文字关键词搜索聊天记录,并定位上下文;资料不支持把图片或视频内容说成可按关键词搜索。本文只借文字搜索讨论结果展示,不断言产品提供了下文的高亮方式。代码、规则与数据均为独立教学示例,不代表产品源码或已发现的产品问题。
1. 命中关键词,不代表消息可以作为 HTML
假设合成消息是 讨论 <img src=x onerror=alert(1)> 这段标签,关键词是 img。搜索命中之后,读者期待看到原文中的标签文字,而不是生成一张图片。
直接拼接标签再交给 innerHTML,可能改变网页结构,某些输入还会触发事件处理器。只考虑 <script> 是否执行并不足够。MDN 的 innerHTML 文档说明了 HTML 解析与注入风险。
这里需要分清两件事:消息和关键词都是待展示的数据;mark 元素是程序允许创建的结构。让数据始终进入文本节点,让程序决定节点类型。 不让消息决定标签名、属性或事件处理器。
2. 先拆成片段,不返回一段 HTML
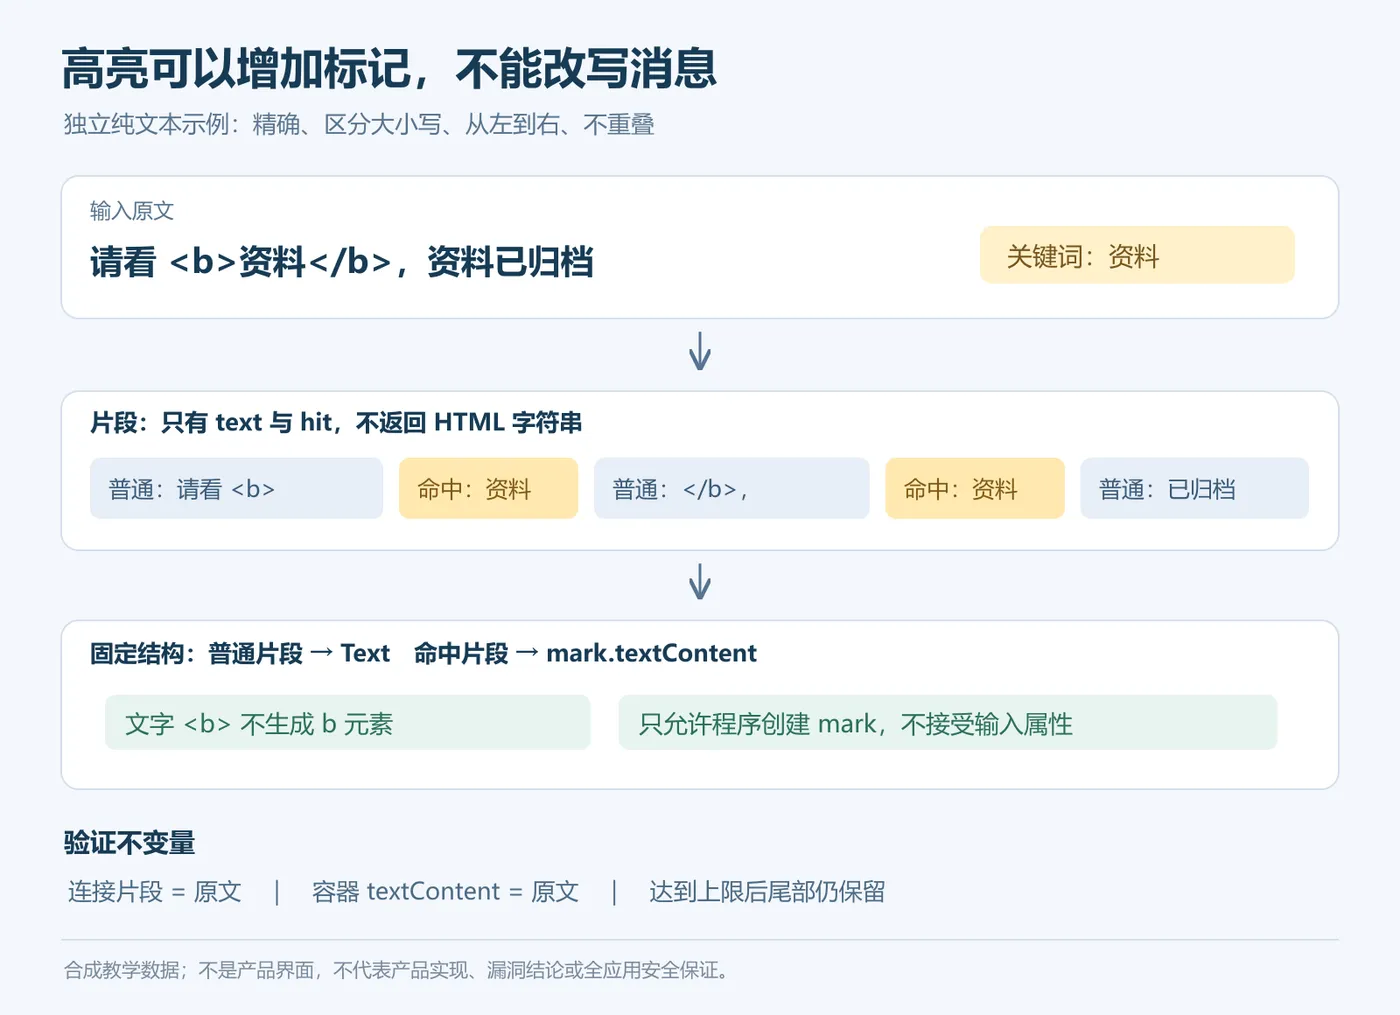
示例采用明确的匹配规则:区分大小写、按完整关键词字面匹配,从左到右选择不重叠的命中。关键词为空时不高亮;限制高亮数量后,剩余内容仍完整展示为普通文本。
| 原文与关键词 | 预期结果 |
|---|---|
资料已收到,资料稍后归档 / 资料 |
两处命中,原文不变 |
a.*b 与 a.*b / a.*b |
点号和星号就是普通字符 |
aaaa / aa |
两处相邻命中,不重复覆盖字符 |
aaa / aa |
第一处命中,最后一个 a 保留为普通文本 |
| 任意原文 / 空字符串 | 完整原文,无高亮 |
片段的数据结构只有 text 与 hit。最重要的不变量是:按顺序连接所有片段的 text,结果必须与输入原文完全相同。高亮不能悄悄删除、替换或重复字符。
function splitLiteralHighlights(text, keyword, limit = 100) {

  if (typeof text !== "string" || typeof keyword !== "string") {

    throw new TypeError("text and keyword must be strings");
  }
  if (!Number.isSafeInteger(limit) || limit < 1 || limit > 200) {

    throw new RangeError("limit must be an integer from 1 to 200");
  }
  if (keyword === "") return [{
    text, hit: false }];
  const parts = [];
  let cursor = 0;
  let count = 0;
  while (count < limit) {

    const start = text.indexOf(keyword, cursor);
    if (start === -1) break;
    if (start > cursor) {

      parts.push({
    text: text.slice(cursor, start), hit: false });
    }
    parts.push({
    text: text.slice(start, start + keyword.length), hit: true });
    cursor = start + keyword.length;
    count += 1;
  }
  if (cursor < text.length) {

    parts.push({
    text: text.slice(cursor), hit: false });
  }
  return parts.length ? parts : [{
    text, hit: false }];
}

function renderLiteralHighlights(container, text, keyword, limit = 100) {

  const parts = splitLiteralHighlights(text, keyword, limit);
  const doc = container.ownerDocument;
  const fragment = doc.createDocumentFragment();
  for (const part of parts) {

    const node = part.hit
      ? doc.createElement("mark")
      : doc.createTextNode(part.text);
    if (part.hit) node.textContent = part.text;
    fragment.append(node);
  }
  container.replaceChildren(fragment);
  return parts.filter(part => part.hit).length;
}
数量上限 100、允许配置的范围 1~200 是教学设计,不是产品限制,也不等于搜索结果总数。输入校验先完成,随后才替换展示节点。异常输入不会把这个容器中的旧内容提前清空。
indexOf 与 slice 在本例中使用一致的 UTF-16 索引,因此可以保持原文。但这不承诺命中一定覆盖完整的用户可见字符:组合附加符号、表情序列与字素簇需要另行约定匹配规则。
3. 用固定的 mark 节点展示命中内容
渲染函数只创建两类节点:普通片段使用文本节点,命中片段使用程序写死的 mark 元素,并通过 textContent 放入文字。即使片段包含尖括号,也不会因为这两步而变成图片、脚本或链接。
createTextNode创建文本节点;textContent写入文本内容。这里的保护来自节点与数据入口的选择,不需要先把消息内容拼成 HTML,再尝试补救。
下面是浏览器演示。把上一段代码先加载到页面,再执行这一段;result 是专门用于消息正文的展示容器。
const result = document.createElement("p");
const source = "讨论 <img src=x onerror=alert(1)> 这段标签";
const count = renderLiteralHighlights(result, source, "img");
document.body.append(result);

console.assert(result.textContent === source);
console.assert(count === 1);
console.assert(result.querySelectorAll("mark").length === 1);
console.assert(result.querySelector("img") === null);
console.assert(result.querySelector("script") === null);
console.log(result.textContent);
预期看到一整段标签文字,其中 img 被标出;DOM 中只有一个 mark,没有消息生成的 img 或 script 元素。这个结论针对本函数的文本展示路径,不代表整个应用的所有入口都已完成安全审查。
replaceChildren 会替换容器的全部子节点,所以不要把头像、按钮、消息操作菜单一起放进这个容器。重复渲染时,函数始终从原文重新生成片段,不能读取上一次的 HTML 再套一层高亮,否则容易产生嵌套标记或错误偏移。
如果消息本来就包含可信富文本,本文的纯文本渲染器会把标签作为文字显示。需要保留格式时,应单独设计受控富文本解析、内容清理和文本节点遍历,不能把这里的输入改成 innerHTML 就宣称同样安全。
4. 高亮数量限制后,尾部原文仍要留下
数量限制解决的是创建过多高亮节点的问题。本例达到上限后,将未处理的剩余原文作为一个普通片段追加;它既不截断消息,也不假装后面已经没有命中。
例如原文 资料资料资料,关键词 资料,上限为 1。返回结果是一段命中的 资料 与普通尾部 资料资料。渲染函数返回 1,只表示实际展示了一个高亮节点;若界面需要总命中数,应使用单独的统计规则,不能拿这个返回值作为搜索总数。
这个上限也不限制原文长度或一次页面上的消息数量。大批结果还需要分页、虚拟列表或其他展示策略。本文没有做性能基准,不据此声称能处理任意规模的数据。
5. 用输入与 DOM 两层验证,而不是只看黄色背景
本例验证分别检查片段和实际节点:片段连起来是否保持原文,命中片段是否等于关键词,数量是否遵守上限;DOM 是否只产生预定的标记节点,重复渲染是否清掉旧标记,标签文字是否仍然只是文本。
| 验证输入 | 要检查的边界 |
|---|---|
| 中文、空字符串、换行与相邻命中 | 原文完整,不漏字、不重复 |
| 正则元字符、尖括号与引号 | 按字面匹配,不解释成模式或属性 |
| 完整表情与两种不同的重音编码 | 精确匹配的范围如实体现 |
| 合成图片标签、脚本标签、实体样式文字 | 不产生输入指定的元素或事件属性 |
| 连续两次使用不同关键词渲染 | 不累积旧 mark,不动容器外的控件 |
| 非字符串输入或非法数量 | 抛错,原展示内容保持不变 |
配套浏览器验证覆盖这些边界,并用固定种子的 500 组组合输入检查原文不变量。它测试的是独立示例,没有接入真实聊天记录、搜索服务或产品客户端;也不是对所有注入方式的穷尽证明。
精确匹配还有展示层面的取舍。Café 中预组合的 é 与由 e 加组合符号构成的序列并不相同。本例不会自动归一化,也不忽略大小写。若检索服务采用了归一化、分词或不区分大小写的规则,前端应拿到对应原文的可靠命中范围,否则可能出现“能搜到但标不出”的现象。
6. 接入搜索结果时,守住原文与容器边界
先核对检索规则与展示规则是否一致,再把原文和关键词交给片段函数。渲染层只接收专用正文容器,使用固定节点类型;点击结果后的上下文定位仍由消息身份与会话身份负责,高亮片段不能代替这些定位信息。
同时检查导出、预览、弹窗和移动端结果列表有没有另一条直接拼接 HTML 的路径。框架自带的文本插值通常有自己的转义机制,但绕到原始 HTML 插入接口时,需要重新评估数据入口,不能把组件名称当成保证。
评估结果时可以抓住两项:展示文本与原文是否完全一致,DOM 结构是否只来自程序允许的节点。前者保证高亮没有改写消息,后者保证消息没有取得决定网页结构的权限。
本文由 AI 辅助整理,独立示例经过本地片段验证与浏览器 DOM 验证。产品背景只使用已整理的手机端功能资料;通用工程建议不代表产品内部实现或漏洞结论。