在Spark里做维度关联,你会用什么?在Flink里做实时聚合,你会用什么?在ETL里做配置映射,你会用什么?答案都是Map。但很多人用了几年Map,对它的认知还停留在"key-value对"。
我在做一个用户画像项目的时候,遇到过一个很隐蔽的bug:一个用Map缓存用户信息的函数,偶尔会抛出NoSuchElementException。一开始以为是数据问题,后来查了半天,发现是Map的apply方法在key不存在的时候会直接抛异常——而我写代码的时候,图省事直接用了map("userId")而不是map.get("userId")。
这个bug让我意识到一个问题:很多人用Map,就只会map("key")、map += (key -> value)这两个操作。但Map真正强大的地方——它的不可变性、它的集合运算、它和函数式编程的配合——大多数人都没用上。
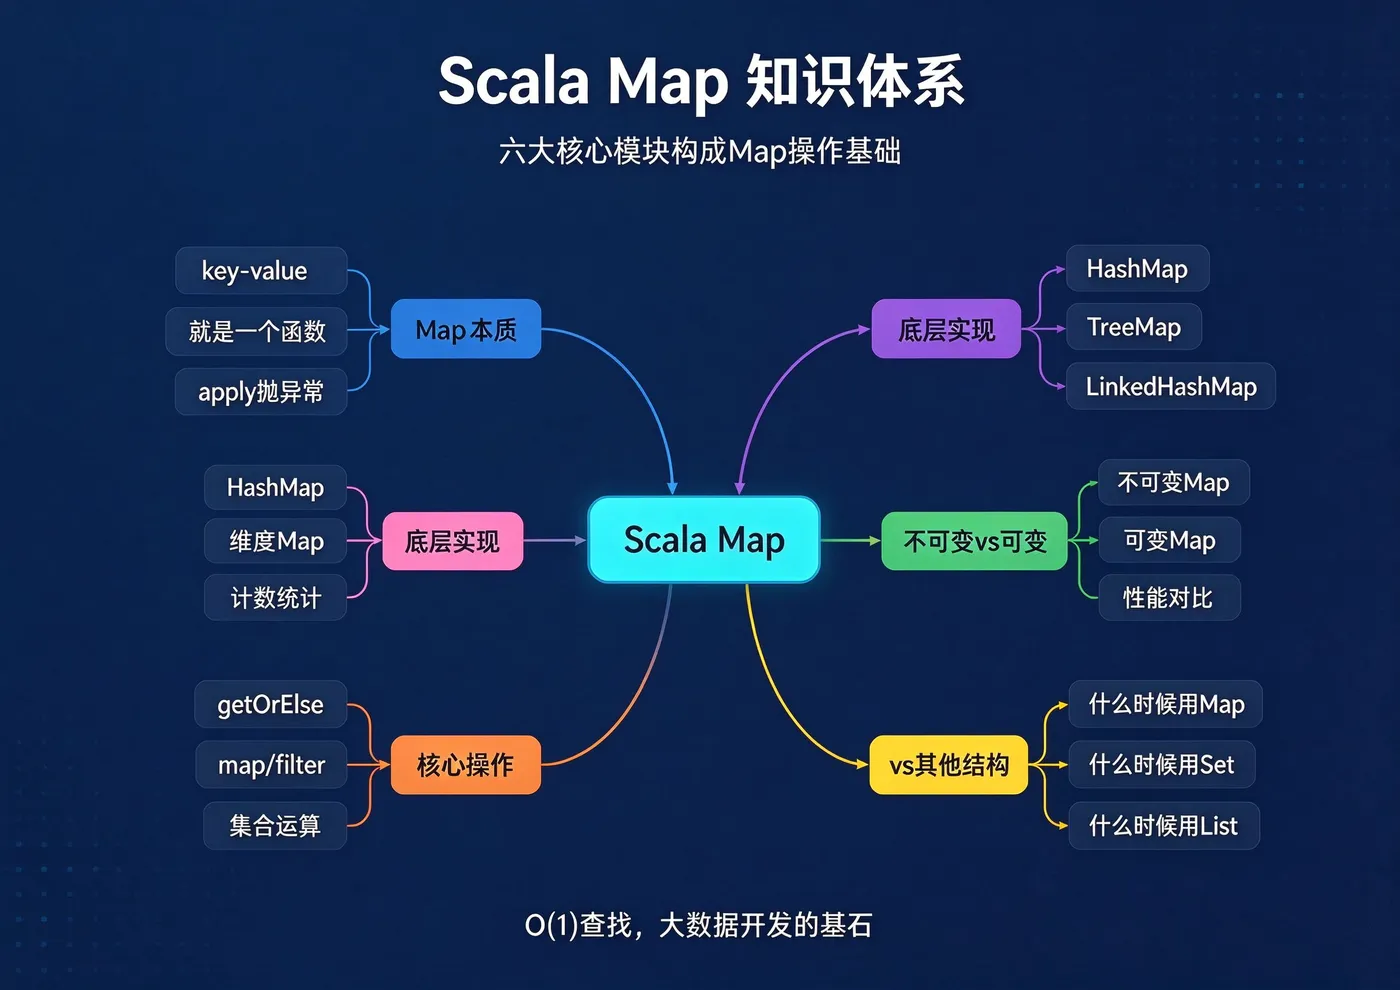
这篇文章不罗列Map有多少个方法——那些官方文档都有。我想聊几个真正值得思考的问题:Scala的Map底层是怎么实现的?为什么getOrElse比apply安全?为什么大数据开发离不开Map?什么时候你该用Map而不是其他数据结构?
先从一个真实的bug说起
假设你要写一个函数:从用户信息Map里取用户名称,如果不存在就返回"未知用户"。
很多人第一反应是这么写:
// 错误写法:key不存在会直接抛异常
def getUserName(userInfo: Map[String, String]): String = {
  userInfo("userName")
}
看起来很简洁对吧?但当userInfo里没有userName这个key的时候,这行代码会直接抛出NoSuchElementException。
为什么?因为Map的apply方法的设计就是这样的——它假设你知道key一定存在,如果不存在就是程序错误,直接抛异常。
正确的写法应该是用getOrElse:
// 正确写法:key不存在有默认值
def getUserName(userInfo: Map[String, String]): String = {
  userInfo.getOrElse("userName", "未知用户")
}
现在不管key存不存在,函数都能正常返回——存在就返回对应的值,不存在就返回默认值。
这就是Map最容易踩的坑:apply方法是不安全的,它假设key一定存在。
很多Java老程序员刚转Scala的时候特别容易踩这个坑——因为Java的HashMap.get(key)在key不存在的时候返回null,不会抛异常。Scala的设计哲学不一样:它不喜欢null,所以它用Option来表示"可能不存在"。
但很多人图省事,直接用apply方法取key,结果就是线上各种NoSuchElementException。
Map不是"带key的列表",它是函数式的映射
很多人对Map的理解停留在"key-value对的集合"。这个理解太浅了。
List是什么?List是"有序的序列"。Set是什么?Set是"数学上的集合"。Map是什么?Map是"函数"——它就是一个从key到value的映射函数。
这不是什么玄学说法,这是Scala的设计。在Scala里,Map本身就是一个函数:
val userMap = Map("name" -> "张三", "age" -> "25")

// Map本身就是一个函数
userMap("name")    // "张三"
userMap("age")     // "25"
看出来了吗?Map就是一个函数——你给它一个key,它返回对应的value。这就是为什么Map的apply方法直接抛异常——因为函数就应该是完整的,你传了一个不在定义域里的参数,当然是程序错误。
这个理解很重要,因为它决定了你该怎么用Map:
- 如果你把Map当成"带key的列表",你就会到处用
apply方法取key,到处抛异常 - 如果你把Map当成"函数",你就会用
get方法,用Option来处理可能不存在的情况
Scala Map的底层实现:和Set是一套体系
很多人不知道,Scala的Map和Set其实是一套东西——Set就是Map的特例。
你仔细想想:Set存的是元素,Map存的是key-value对。Set的元素,就是Map的key。所以Scala的Set底层其实就是Map——Set的元素对应的value都是()(Unit类型)。
// Set底层就是Map
// Set(1, 2, 3) 等价于 Map(1 -> (), 2 -> (), 3 -> ())
这也是为什么Map和Set的实现这么像——都有HashMap、TreeMap、LinkedHashMap。因为它们本来就是一套东西。
HashMap:最常用的Map
val map = HashMap("name" -> "张三", "age" -> "25")
map("name")    // "张三",O(1)
HashMap是最常用的Map实现,底层基于哈希表——你调用get(key)的时候,它会算key的hashCode,然后去对应的桶里找。所以是O(1)。
TreeMap:有序的Map
import scala.collection.immutable.TreeMap

val map = TreeMap(3 -> "c", 1 -> "a", 2 -> "b")
// TreeMap(1 -> a, 2 -> b, 3 -> c) —— key自动排序
如果你需要Map的key是有序的——比如你要按从小到大的顺序输出所有key——那就用TreeMap。它底层是红黑树,查找是O(log n),比HashMap的O(1)慢一点,但key是有序的。
经验法则
| 场景 | 用什么Map |
|---|---|
| 只需要通过key快速查找value | HashMap |
| 需要key按大小排序 | TreeMap |
| 需要保持插入顺序 | LinkedHashMap |
| 数据量很小(十几个key) | 随便用哪个,差别不大 |
不可变Map vs 可变Map:老传统又来了
和List、Set一样,Scala的Map也分不可变和可变两套。
// 不可变Map
val map1 = Map("a" -> 1, "b" -> 2)
val map2 = map1 + ("c" -> 3)   // 返回新Map,map1不变

// 可变Map
import scala.collection.mutable
val buf = mutable.Map("a" -> 1)
buf += ("b" -> 2)              // 原地修改
这个设计哲学和List、Set是一样的:对外暴露不可变Map,内部用可变Map构建。
但Map有个和List不一样的地方——不可变Map的性能其实没那么差。为什么?因为Map的核心操作是get,是基于哈希的O(1)操作。即使你每次add都返回一个新Map,add操作本身也是O(1)(平均情况)。
所以在Map这个场景下,可变和不可变的性能差距没有List那么大。很多时候你直接用不可变Map就够了,不需要特意搞个可变Map来构建。
// 直接用不可变Map就行,不用搞个可变Map
val map = Map("a" -> 1) + ("b" -> 2) + ("c" -> 3)
这也是为什么很多人觉得Scala的Map比List好用——因为不可变Map的性能足够好,你不需要像List那样纠结"我到底该不该用ListBuffer"。
Map的核心操作:不只是get和put
很多人用Map,就只会get、put、containsKey这三个操作。其实Map真正强大的地方,是它和函数式编程的配合。
map:对所有value做转换
val scores = Map("张三" -> 80, "李四" -> 90, "王五" -> 75)

// 给每个人加5分
val boosted = scores.map { case (name, score) =>
  (name, score + 5)
}
// Map("张三" -> 85, "李四" -> 95, "王五" -> 80)
这个操作在大数据处理里太常用了——你有一个Map存着用户的原始数据,你要对所有value做转换,一行代码搞定。
filter:按条件过滤
val scores = Map("张三" -> 80, "李四" -> 90, "王五" -> 75)

// 只保留及格的
val passed = scores.filter { case (name, score) =>
  score >= 60
}
getOrElse:安全地取值
val userMap = Map("name" -> "张三", "age" -> "25")

// 安全取值:key不存在有默认值
val name = userMap.getOrElse("name", "未知用户")
val email = userMap.getOrElse("email", "未填写")
这是最常用的Map操作——安全地取值,key不存在的时候有默认值,不会抛异常。
与Java Map对比
Java也有HashMap,也有TreeMap。那Scala的Map和Java的Map到底差在哪?
- 默认是不可变的:Java里new的HashMap默认就是可变的。Scala里默认的Map就是不可变的。
- 支持函数式操作:Java 8以后虽然也有stream,但写起来很啰嗦。Scala的map/filter直接就是Map的方法,写起来很自然。
- 和集合体系无缝互转:Scala的Map和List、Set之间互转都是一行代码的事。
什么时候该用Map?
这是最常见的困惑。我给一个简单的判断标准:
你要通过一个key快速找到对应的value吗?
是的话,用Map。不是的话,想想是不是该用其他数据结构。
用Map的场景
- 配置映射:key是配置项名称,value是配置值
- 维度关联:key是维度id,value是维度信息
- 缓存索引:key是用户id,value是用户信息
- 计数统计:key是事件类型,value是出现次数
- 分组聚合:key是分组字段,value是该组的数据
不用Map的场景
- 你只关心元素在不在里面:用Set
- 你要按顺序遍历元素:用List
- 你要按位置访问元素:用Array
写在最后
我写这篇文章的时候,特意没罗列Map有多少个方法——因为那些东西官方文档都有,查一下就行。
真正值得花时间理解的是:Map到底解决了什么问题?
它不是"带key的列表",它是一个"从key到value的映射函数"。它用哈希表的O(1)查找,换来了通过key快速找到value的能力。
在大数据开发里,Map无处不在——维度关联、配置映射、计数统计、分组聚合、缓存索引。理解了Map,你就理解了大数据处理里最核心的几个操作:查找、映射、聚合。
很多人用了几年Map,还停留在"new一个HashMap,然后put put put"的阶段。这不是Map的正确打开方式。Map的真正威力在于它和函数式编程的配合——map、filter、getOrElse这些操作,让你可以用声明式的方式处理key-value数据,而不是命令式地遍历、判断、取值。
当你下次要写一个key-value查找的时候,先想想:我是在解决"通过key找value"的问题,还是在解决其他问题?如果是前者,用Map。用getOrElse安全取值,用map做转换,用filter做过滤。