嗨,我是小华同学,专注解锁高效工作与前沿AI工具!每日精选开源技术、实战技巧,助你省时50%、领先他人一步。👉免费订阅,与10万+技术人共享升级秘籍!
现在很多多模态系统,还是“视觉编码器看图、语言模型理解、图像模块负责生成”,中间靠一层层适配器传话。
SenseNova-U1 的野心是换一条路:让同一个原生多模态模型从像素一路走到文字,同时完成理解、推理、生成、编辑和图文交错。
最新的 U1.5-8B-MoT Preview 还把 4K 生图、局部编辑、复杂布局和主体保持推向了更具体的视觉任务。本文只讲它为什么值得关注,以及接入前必须知道的边界。
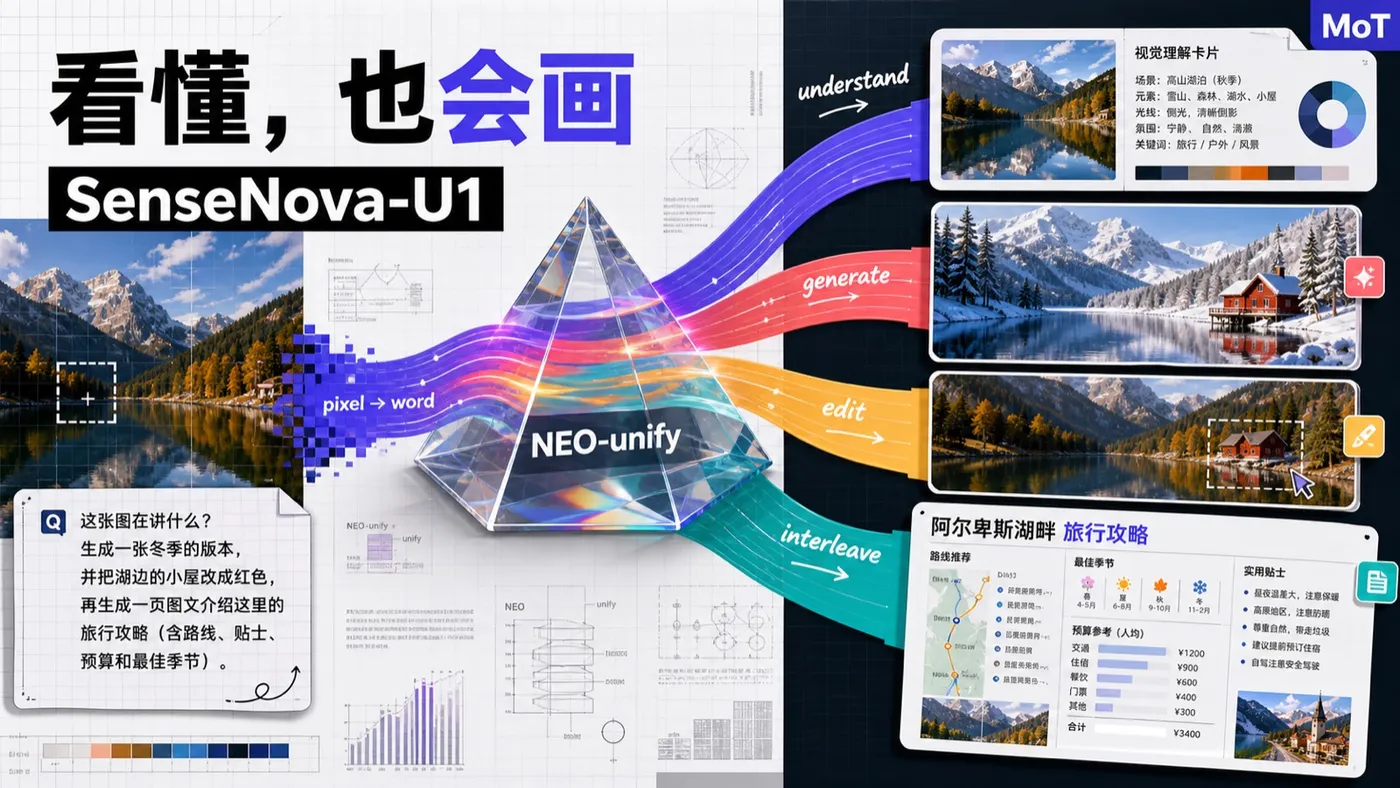
多模态最难的,不是“会看”或“会画”
单独做视觉理解,模型可以回答“图里有什么”;单独做文生图,模型可以把文字变成画面。
真正难的是让同一套系统同时做到:
- 看懂图片里的对象、空间和关系;
- 根据文字和图片一起推理;
- 生成画面时不丢掉语义;
- 编辑局部内容时保住主体和未修改区域;
- 把文字、图片、图表和版式组织成一份可读的信息内容。
如果每个能力都由不同模块负责,模态之间就要不断翻译,语义和像素细节也更容易在中间损失。
SenseNova-U1 到底是什么?
一句话理解:SenseNova-U1 是一个试图把多模态理解、推理和生成统一到单体架构里的开源模型系列。
项目的核心架构叫 NEO-unify。README 的描述是,它从第一性原理出发,减少传统视觉 Encoder、VAE 等模块之间的隔离,让像素与语言信息在更统一的表示里流动,并通过原生 MoT 降低跨模态推理冲突。
这里的“统一”不是把所有任务粗暴塞进一个接口,而是让模型在理解、生成和编辑之间共享更接近的底层信息流。
它和传统多模态拼接路线差在哪?
| 对比项 | 传统模态集成 | SenseNova-U1 的目标 |
|---|---|---|
| 处理路线 | 视觉、语言、生成模块分工,再用适配器连接 | 以 NEO-unify 为核心做原生统一 |
| 信息流 | 图像先转成视觉特征,再多次翻译 | 让像素与文字端到端关联 |
| 任务组合 | 理解、生成、编辑常常是不同管线 | 统一模型覆盖多个视觉任务 |
| 画面编辑 | 容易改变主体或未编辑区域 | 强调语义保持与像素级保真 |
| 内容输出 | 单张图或单段文字为主 | 支持图文交错、信息图和复杂布局 |
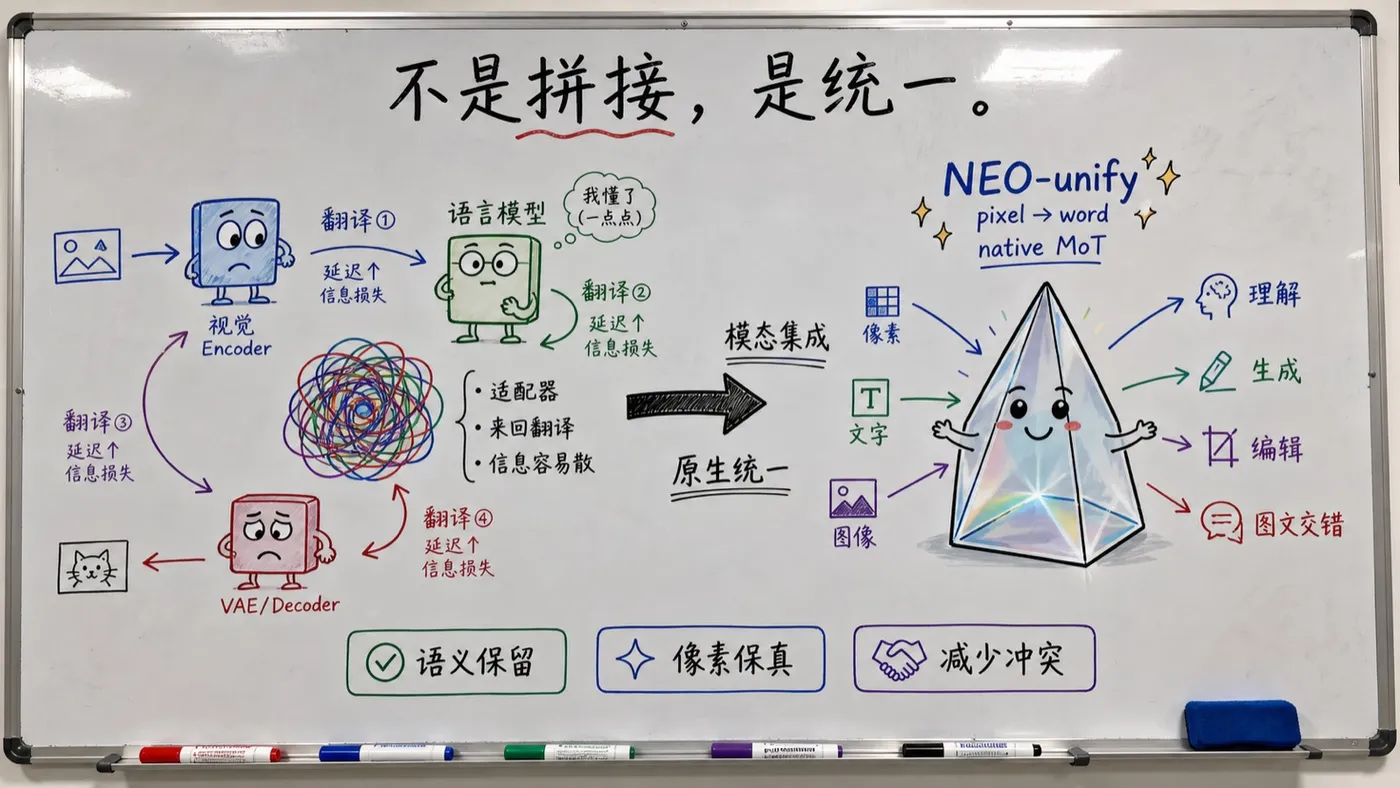
这也是它值得程序员关注的地方:项目不是只增加一个模型能力,而是在尝试减少多模态系统里的“模块胶水”。
一套模型,能做哪些视觉工作?
1. 视觉理解:不只识别物体
它可以对图片进行问答、理解场景、读取菜单或分析视觉关系。项目提供了 VQA 推理示例,输入图片和问题,模型返回文本答案。
2. 文生图:从文字走到画面
SenseNova-U1 系列提供文本到图像能力,重点不只是“画得像”,还包括语义对齐、主体保持和较复杂的场景组织。
3. 图像编辑:改局部,但别把全图改崩
官方示例覆盖换衣服、加物体、改变表情和基于时间、物理、因果推理的图像编辑任务。U1.5 Preview 进一步强调局部细节、真实材质和未编辑区域保持。
4. 图文交错:让内容像一篇完整故事
项目把交错生成列为一个方向:文字和图片可以在同一条生成流里连续出现,适合教程、旅行记录、知识讲解等需要“边讲边展示”的内容。
5. 信息图:把内容组织成可读版式
项目还发布了多版 Infographic 模型,目标是生成和编辑海报、简历、知识插图、演示文稿等高密度信息布局,并支持局部文字、全局风格和全局布局调整。
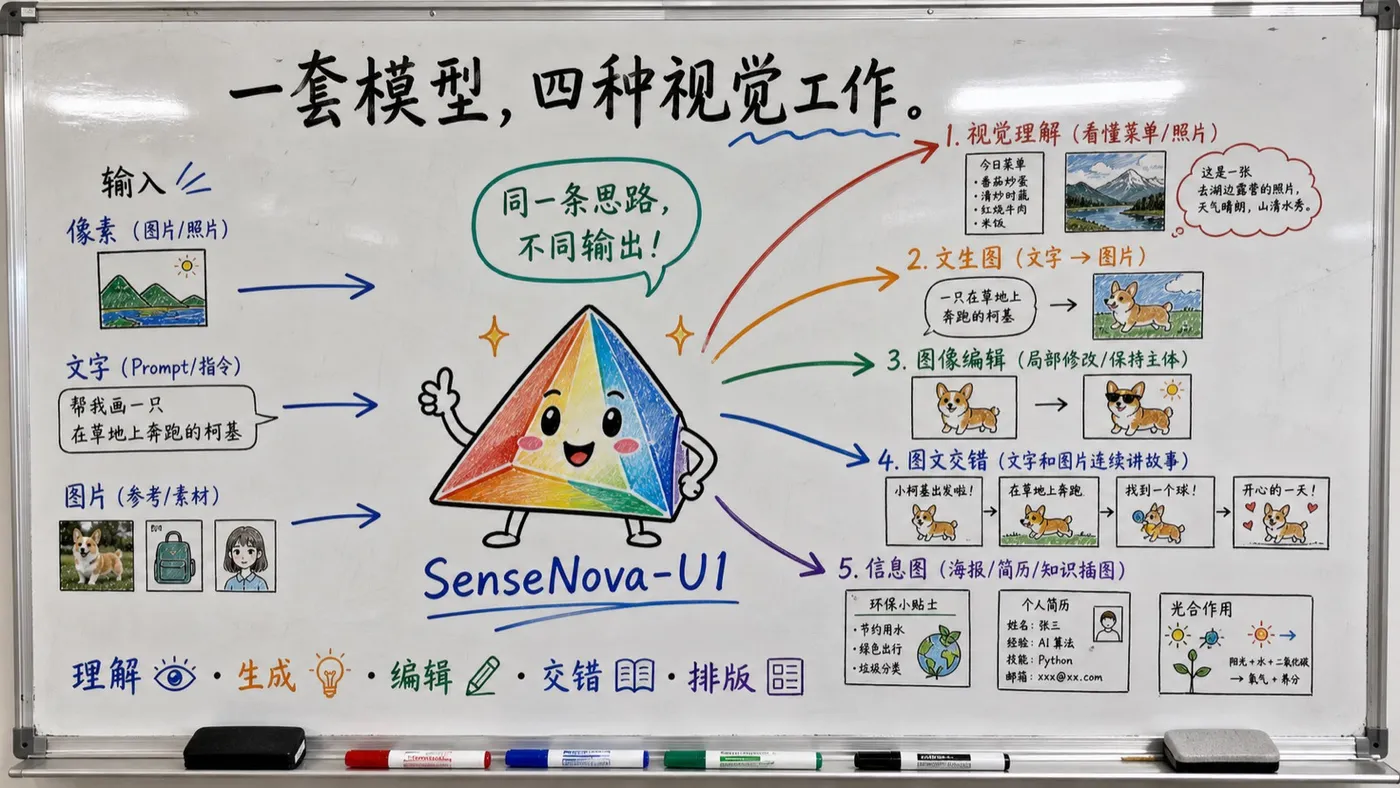
所以它的产品画像更接近“视觉内容工作台的底层模型”,而不是单一的聊天模型或单一文生图模型。
模型怎么选?先看这几个名字
当前仓库列出的开放模型包括:
| 模型 | 适合怎么理解 |
|---|---|
SenseNova-U1-8B-MoT |
8B 级基础统一模型 |
SenseNova-U1-A3B-MoT |
MoE 路线的轻量参数规模 |
SenseNova-U1-8B-MoT-Interleaved |
偏图文交错生成 |
SenseNova-U1-8B-MoT-Infographic-V2/V3 |
偏信息图生成与编辑 |
SenseNova-U1.5-8B-MoT-Preview |
最新预览方向,强调 4K 生图与编辑能力 |
其中 8B-MoT 不等于只有 8B 的全部能力,项目解释为理解参数和生成参数分别约 8B。第一次接入时,不要只看模型名字,应该根据任务选择理解、通用生成、信息图或交错生成版本。
怎么快速体验?
在线体验
项目提供 SenseNova-Studio 在线体验,可以先不准备 GPU,直接验证图片理解、生成和编辑效果:
Transformers 推理
仓库默认使用 uv 管理环境,最小思路是准备模型、图片和问题:
uv sync
python examples/vqa/inference.py \
  --model_path sensenova/SenseNova-U1-8B-MoT \
  --image examples/vqa/data/images/menu.jpg \
  --question "请推荐适合两个人的菜品组合" \
  --output outputs/answer.txt
OpenClaw Skill
如果你已经在做 Agent,也可以关注配套的 SenseNova-Skills 仓库,它把 SenseNova-U1 封装成统一工具调用接口,减少直接处理模型推理参数的工作量。
项目边界与限制
SenseNova-U1 的方向很有想象力,但它并不是“所有视觉任务都已经完美解决”:
- 当前视觉理解上下文长度上限为 32K tokens,超长视觉上下文需要谨慎评估;
- 人体细节、复杂姿态和小尺寸人物仍可能出错;
- 文本生成可能出现错别字、字符变形或排版不一致,提示词写法会影响结果;
- 图文交错生成仍是实验性方向,效果不一定等同于成熟的专用文生图管线;
- 8B 级模型不代表普通电脑一定可以轻松运行,显存、量化和推理模式仍要按具体版本验证;
- “开源 SoTA”等表述来自项目 README,真正用于产品时应复现评测,并用自己的图片集测试。
我的判断是:如果你的应用需要让模型同时理解视觉、生成视觉、编辑视觉,还要把结果组织成信息内容,SenseNova-U1 的统一范式值得研究;如果你只需要普通文生图,直接选择成熟专用模型可能更简单。
后续我会继续拆解它的 NEO-unify 设计、MoT 参数结构和本地推理部署方式。