
在数字化项目落地、AI模型开发、网站业务部署的过程中,算力资源的选择直接决定项目稳定性、开发效率以及整体投入成本。很多开发者、初创团队在初次上云时,很容易混淆 阿里云轻量应用服务器 、 阿里云ECS云服务器 、GPU云服务器以及各类AI云产品的定位,盲目选择高规格实例造成预算浪费,或者选用配置不足的实例导致业务卡顿、模型推理超时。
阿里云构建了覆盖从入门轻量业务、企业通用业务,到大模型训练推理的完整全栈算力体系,不同产品在底层架构、资源权限、计费方式、适用场景上有着明显的区别。本文将完整拆解这四类算力相关产品,从硬件配置、定价体系、性能实测,到服务器初始化、资源监控、模型调用的命令实操进行全面讲解,帮助读者根据业务规模精准选择算力方案,同时梳理使用过程中常见的坑点,给出成本优化策略。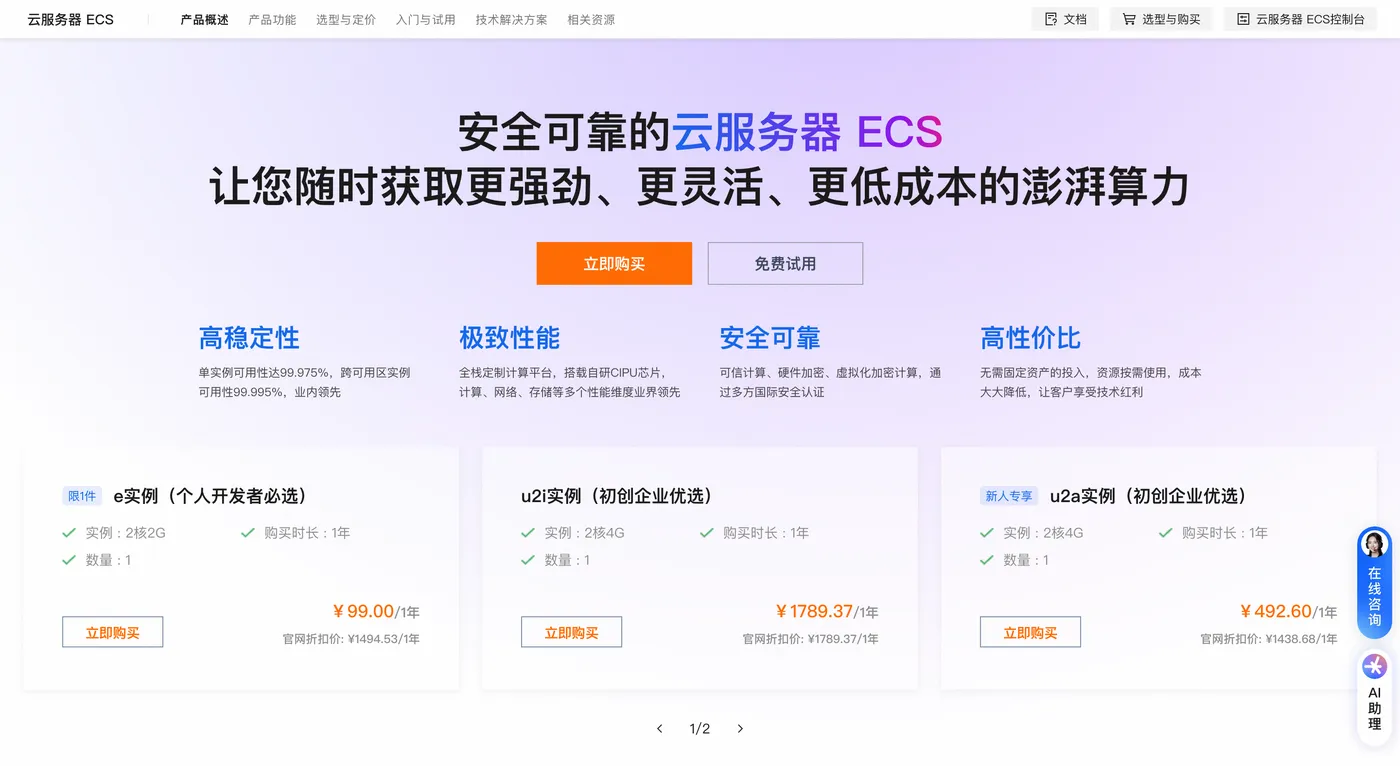
一、轻量应用服务器:入门级轻量化算力,适合新手快速部署
阿里云轻量应用服务器 是面向个人开发者、学生、小型初创项目打造的轻量化算力产品,产品设计思路是屏蔽复杂的网络配置、安全组、VPC组网等底层云资源概念,内置多种应用镜像,用户在控制台点选镜像后,几分钟内即可完成应用部署,不需要手动配置复杂环境。它的底层同样基于虚拟化技术,但是资源打包成套餐形式,套餐包含固定的CPU、内存、ESSD云盘、峰值带宽与每月流量包,计费模式简单直观,非常适合零基础用户上手。
1.1 核心配置与适用场景
阿里云轻量应用服务器 主流入门套餐包含2核2G内存、20GB~50GB ESSD云盘,搭配峰值带宽和每月流量包;进阶套餐有2核4G、4核8G规格,流量包与带宽同步提升。套餐内的带宽属于峰值带宽,流量消耗超出套餐额度之后会限速,这一点和ECS的固定带宽按带宽计费存在本质区别。
适用场景:个人博客、静态网站、小型展示官网、小程序测试后端、代码学习环境、轻量AI应用Demo演示、小型数据脚本定时运行。不适合高并发业务、复杂微服务架构、大规模数据库集群,也不适合大模型训练、高并发AI推理场景。
1.2 价格体系
阿里云轻量应用服务器 存在新用户特惠套餐,入门规格价格低廉,适合短期测试项目。套餐支持月付与年付两种方式,年付方案整体单价更低。因为是打包套餐形式,无法单独对CPU、内存、带宽进行精细化升降配,如果业务负载持续上涨,只能升级整个套餐,这也是它和 阿里云ECS云服务器 最大的差异点。
1.3 实操命令演示
购买实例之后,使用SSH工具远程登录服务器,执行基础系统检查命令,查看CPU、内存、磁盘资源。
# 查看CPU核心信息
lscpu
# 查看内存使用状态
free -h
# 查看磁盘分区与存储空间
df -h
# 查看系统负载,判断服务器资源压力
uptime
部署简单Web服务,安装Nginx,快速搭建静态页面服务:
# 更新软件源
sudo apt update -y
# 安装Nginx服务
sudo apt install nginx -y
# 启动Nginx并设置开机自启
sudo systemctl start nginx
sudo systemctl enable nginx
执行完成之后,在浏览器访问实例公网IP,即可打开Nginx默认页面,整个部署流程简单快捷,这也是轻量应用服务器最大的优势。
二、ECS弹性云服务器:企业通用标准算力,业务长期稳定运行首选
阿里云ECS云服务器 弹性云服务器,是阿里云最基础的企业级计算产品,也是整个算力体系的核心产品。和轻量应用服务器打包套餐的模式不同,ECS的CPU、内存、云盘、公网带宽、网络资源全部独立可配置,用户可以自由组合实例规格,并且支持随时升降配资源,配合VPC私有网络、安全组、快照、弹性伸缩等全套云能力,适配复杂的企业业务架构。底层采用神龙虚拟化架构,硬件资源隔离度高,性能稳定性强,支持包年包月、按量付费、抢占式实例三种计费方式。
2.1 ECS实例规格分类与适用场景
阿里云ECS云服务器 实例划分多个实例族,不同实例族硬件侧重点不同。通用算力型实例,CPU和内存配比均衡,适合绝大多数中小型业务,网站后端、数据库、中间件、业务系统都可以使用;计算型实例CPU性能更强,内存配比偏低,适合高CPU消耗任务,比如批量数据处理、API接口服务;内存型实例拥有更大内存容量,适合缓存服务、内存数据库、大规模数据分析场景。
ECS支持独立挂载ESSD云盘,云盘可以单独扩容,不受实例更换影响。网络层面接入VPC私有网络,可以搭建多服务器集群,内网互通,安全组精细化管控端口访问权限。
适用场景:企业正式线上业务、微服务集群、生产环境数据库、高并发API服务、长期稳定运行的业务系统,也可以作为AI应用的业务后端,用来接收用户请求,转发推理请求到AI算力服务。
2.2 ECS计费模式详解
第一种,包年包月预付费,适合长期稳定业务,单价最低,一次性购买一年或者多年,享受更大折扣。第二种,按量付费,按照CPU、内存、云盘、带宽的使用时长按小时扣费,业务临时扩容、短期测试场景推荐使用,业务停止时可以释放实例停止计费。第三种,抢占式实例,价格远低于按量付费,但是系统会根据资源空闲情况随时回收实例,不适合生产核心业务,适合离线数据处理、模型测试等可以中断的任务。
需要注意隐性成本,公网流量、云盘容量、快照存储都会单独计费,在做成本预算的时候不能只计算实例本身费用。
2.3 ECS实操命令演示
阿里云ECS云服务器 实例登录之后,除了基础资源查看命令,我们可以安装阿里云CLI工具,通过命令行管理ECS实例资源,实现自动化运维。
# 安装阿里云CLI
curl -L [https://aliyuncli.alicdn.com/aliyun-cli-linux-latest-amd64.tgz](https://aliyuncli.alicdn.com/aliyun-cli-linux-latest-amd64.tgz) | tar xz
cd aliyun-cli-linux-amd64
sudo cp aliyun /usr/local/bin
# 配置访问凭证,需要在控制台创建AccessKey
aliyun configure
配置完成之后,执行命令查看当前地域下所有ECS实例信息:
aliyun ecs DescribeInstances
查看实例监控指标,读取CPU使用率:
aliyun cms DescribeMetricLast --Namespace acs_ecs --MetricName CPUUtilization --Dimensions [{
   "InstanceId":"i-xxxxxx"}]
在ECS上部署Python环境,用来开发后端业务服务:
sudo apt install python3 python3-pip -y
pip install flask
编写简易Flask服务,接收HTTP请求,作为业务后端:
from flask import Flask
app = Flask(__name__)

@app.route('/')
def index():
    return "ECS后端服务运行正常"

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=8080)
启动服务之后,在安全组放行8080端口,就可以通过公网IP访问这个后端接口。
三、GPU云服务器EGS:高性能算力载体,大模型训练与推理核心资源
阿里云 EGS GPU云服务器 ,依托神龙架构,搭载NVIDIA系列GPU加速卡,专门面向AI大模型训练、模型微调、视频渲染、科学计算等需要大规模并行计算的场景。普通CPU服务器擅长串行逻辑处理,而GPU拥有海量计算核心,在矩阵运算、向量计算任务上拥有数十倍乃至上百倍的性能优势,是大模型相关开发工作不可或缺的算力资源。EGS支持单卡、多卡集群部署,从单卡小规模模型推理,到万卡超大模型训练集群都可以搭建。
3.1 GPU实例规格与适用场景
不同规格实例搭载不同型号GPU,显存、算力参数差异很大。T4显卡适合轻量模型推理、小模型部署;A10显卡兼顾推理与小规模微调;更高规格显卡拥有更大显存,适合70B以上大模型训练、全参数微调。多卡实例支持NVLink高速互联,卡间数据传输延迟极低,适合分布式训练任务。
适用场景:大模型预训练、模型LoRA微调、本地大模型推理、音视频生成、3D渲染、分子模拟、大规模向量检索任务。
GPU实例的资源成本远高于普通ECS,所以在选型的时候需要严格评估显存需求,避免选购过高规格造成资源闲置。很多开发者会使用抢占式GPU实例来做模型实验,大幅降低测试成本,但是抢占式实例存在被回收风险,生产环境推理业务不建议使用。
3.2 GPU云服务器价格体系
阿里云 EGS GPU云服务器 实例计费同样支持包年包月、按量付费、抢占式三种模式。包年包月长期使用成本最低;按量付费适合临时的模型推理任务;抢占式实例价格最低,但是资源随时回收。GPU实例除了实例本身费用,云盘、公网流量同样单独计费,大模型训练任务会产生大量存储开销,需要预留对应的存储预算。
3.3 GPU服务器实操命令演示
实例创建时选择预装GPU驱动的镜像,登录服务器之后,执行命令查看显卡信息:
# 查看GPU硬件信息,确认驱动安装成功
nvidia-smi
安装PyTorch深度学习框架,验证GPU是否可以被框架识别:
pip install torch torchvision torchaudio
运行Python代码测试GPU可用性:
import torch
print(torch.cuda.is_available())
print(torch.cuda.get_device_name(0))
如果返回True以及显卡型号,说明GPU环境配置成功。接下来可以部署大模型推理服务,安装vLLM推理引擎,加速模型推理:
pip install vllm
启动模型推理服务:
python -m vllm.entrypoints.api_server --model Qwen2-7B-Instruct --tensor-parallel-size 1
服务启动完成后,可以通过HTTP接口发送prompt请求,调用本地部署的大模型。
四、阿里云AI云产品:模型即服务,无需自建算力快速调用大模型
前面介绍的 阿里云轻量应用服务器 、ECS、GPU云服务器都属于底层IaaS算力资源,需要用户自己维护系统、驱动、模型文件、推理服务。而阿里云AI云产品属于上层模型服务,也就是MaaS模型即服务,底层算力由平台统一托管,开发者不需要购买GPU服务器,不需要搭建推理环境,直接通过API接口调用各类大模型能力,包含文本生成、多模态图文理解、代码生成、向量检索等能力。
4.1 AI云产品核心能力与适用场景
AI云产品提供丰富的模型系列,支持文本对话、图像理解、视频解析、代码编写、函数调用等能力。平台内置了模型优化、负载均衡、自动扩缩容机制,并发请求上涨时自动扩容算力,开发者只需要对接API,专注业务逻辑开发,省去硬件运维、模型部署、性能调优的大量工作。
适用场景:业务系统接入大模型对话能力、智能客服、文档解析、AI内容生成、代码助手、图片识别等业务。适合不想投入大量GPU硬件成本,希望快速上线AI功能的项目。如果业务需要私有化部署模型,或者对模型权重有修改微调需求,则需要搭配GPU云服务器自行部署。
4.2 AI云产品计费规则
AI云产品大多采用Token计量计费,输入文本、输出文本都会按照Token数量扣费,部分多模态模型会额外按照图片、视频资源单独计费。平台也提供订阅套餐方案,固定费用获得对应的调用额度,高并发持续调用场景选择订阅套餐成本更加可控。这种计费模式按需消耗,没有闲置资源成本,小型项目、初创项目非常友好。
4.3 AI云产品API调用代码示例
使用Python SDK调用AI模型接口,完成对话请求:
import os
from dashscope import Generation

# 设置API密钥,在控制台获取
os.environ["DASHSCOPE_API_KEY"] = "sk-xxxxxxxxxxxx"

resp = Generation.call(
    model="qwen-max",
    messages=[
        {
   "role":"system","content":"你是专业的技术文档助手"},
        {
   "role":"user","content":"对比轻量服务器、ECS、GPU服务器的差异"}
    ],
    result_format="message"
)
if resp.status_code == 200:
    print(resp.output.choices[0].message.content)
else:
    print(f"请求失败,错误码:{resp.code}, 信息:{resp.message}")
运行代码之后,程序会直接向模型服务发送请求,并且返回模型生成的回答。整个过程没有用到本地GPU资源,算力全部由云端AI服务承载。
五、四类算力产品横向对比与选型方案
很多项目并不是单一算力产品就能完成,更多是组合使用。我们分场景给出选型建议:
场景1:个人博客、静态网站、学习测试环境,业务并发极低。优先选择轻量应用服务器,部署简单,价格低,开箱即用。缺点是资源升降配灵活性不足,不适合业务持续扩张。
场景2:中小企业正式线上业务,微服务、数据库系统,业务会随着发展扩容。优先ECS,可以灵活调整CPU内存,搭配VPC、安全组、快照,构建稳定企业架构。业务的AI能力需求可以直接对接AI云产品API,不需要自建GPU算力。
场景3:需要做模型训练、模型微调、私有化本地大模型推理。选择 阿里云 EGS GPU云服务器 ,根据模型显存需求挑选GPU型号,小规模测试可以使用抢占式实例降低成本。业务前端、API网关可以部署在ECS上,ECS内网访问GPU实例,构建完整AI业务链路。
场景4:快速上线AI应用,不需要私有化模型,开发周期短。直接使用AI云产品MaaS服务,业务后端部署在ECS或者轻量服务器,通过API调用大模型,省去GPU运维工作。
六、性能实测与成本优化实战
本次测评分别对轻量应用服务器、ECS通用实例、 阿里云 EGS GPU云服务器 实例做基础压测。轻量服务器在单线程Web服务测试中表现良好,但是并发请求持续上涨之后,受到流量包和峰值带宽限制,响应延迟明显上升。ECS通用实例在并发压测下稳定性更强,带宽可以固定配置,适合持续稳定流量。GPU实例在大模型推理任务中,推理速度完全取决于显卡显存与算力,显存不足会出现推理卡顿,甚至模型加载失败。
成本优化策略:
第一,区分测试环境与生产环境。测试任务优先使用按量付费或者抢占式实例,测试完成之后及时释放资源,避免持续扣费。生产业务长期稳定运行,优先包年包月。
第二,合理拆分业务,不要把所有业务部署在同一台机器。业务逻辑放在ECS,AI推理需求优先MaaS,私有化模型推理单独 阿里云 EGS GPU云服务器 实例,资源隔离,方便单独扩容。
第三,做好资源监控,编写监控脚本,自动检测服务器负载,闲置资源及时释放。下面给出简单的服务器负载监控脚本:
#!/bin/bash
cpu_load=$(uptime | awk '{print $10}')
mem_used=$(free | awk '/Mem/{printf "%.2f", $3/$2*100}')
echo "当前CPU负载:$cpu_load"
echo "内存使用率:$mem_used%"
第四,存储资源按需选择,热数据使用ESSD云盘,冷数据可以迁移到对象存储,减少高性能云盘的开销。
七、常见踩坑问题与排查指南
问题1: 阿里云轻量应用服务器 流量超出套餐之后网站访问缓慢。排查:轻量是流量包模式,超出流量包会限速,高并发业务不适合轻量,建议迁移ECS。
问题2:购买GPU实例之后,nvidia-smi命令找不到显卡。排查:镜像没有预装GPU驱动,更换GPU官方镜像,或者手动安装对应版本驱动。
问题3:ECS按量付费实例忘记释放,持续产生费用。排查:设置资源告警,当实例长时间CPU负载接近0,触发告警提醒,及时释放闲置实例。
问题4:调用AI云模型API时报错,请求超时。排查:检查网络连通性,API密钥是否正确,同时控制单次输入文本长度,避免单次请求Token过大。
八、总结
阿里云全栈算力体系覆盖了从简单轻量站点、企业通用业务,到大模型训练推理的全部算力需求。轻量应用服务器主打快速上手、低成本,适合入门项目; 阿里云ECS云服务器 弹性云服务器是企业业务基石,资源高度灵活,适配复杂业务架构;GPU云服务器EGS提供高性能并行算力,承担大模型训练微调这类重型计算任务;AI云产品MaaS服务屏蔽底层硬件,直接提供模型能力,快速把AI能力集成进业务系统。项目上云的核心原则,是按需匹配算力,不要过度采购高性能资源造成资金浪费,也不要因为过度压缩配置导致业务故障。在项目规划阶段,梳理清楚业务并发、存储需求、AI模型需求,选择单产品或者多产品组合方案,配合监控脚本持续观测资源负载,动态调整算力资源,就可以兼顾业务稳定性与成本控制。同时熟练掌握SSH、系统资源查看、阿里云CLI、模型调用等相关命令,能够极大提升运维与开发效率,快速定位服务器、模型服务运行过程中出现的各类故障。无论是个人开发者搭建小型项目,还是企业搭建完整AI业务平台,都可以依托这套全栈算力产品,完成从开发测试到正式上线的完整落地流程。
