智能体的分数一半是噪声:给什么信息比用多强的模型更重要

简介: 该研究通过18,240条智能体轨迹实验发现:智能体表现54%方差源于运行噪声,非配置差异;“给什么信息”对性能影响最大,超越模型强度与预算;配置间存在强交互,行为需系统级设计(如验证工具),而非依赖提示词。重新定义智能体为可配置系统。(239字)

一项覆盖 18,000+ 条智能体轨迹的系统实验发现——智能体得分的方差里约 54% 是跑次噪声而非配置差异;在五条配置轴(信息/推理保留/自我验证/预算/模型强度)里,「给智能体什么信息」的效应超过模型强度和运行预算,排第一。
arXiv 2610.01618 · Agents Are Systems, Not Models · 2026-10-01
111.png

arXiv 2610.01618 · Agents Are Systems, Not Models: Rethinking Agentic Evaluation · 2026-10-01
这篇论文做了什么
智能体评测已经从「只看成功率」进化到关注成本、一致性、鲁棒性。但有个盲区:评测普遍把智能体当固定对象看待。实际上智能体是可配置系统——用户决定告诉它什么、让它跑多久、用什么模型,每个选择都影响结果。
研究团队设计了一个受控实验:四个科学任务(天体物理与基因组学)+ 一个基准:智能体必须调用领域专家模型解决任务(通用模型无法凭知识解决),产出与专家模型的参考分数对比。然后沿五条配置轴系统变化:

  1. 给智能体的信息(任务说明的详略) 2. 是否保留跨步骤的推理 3. 被要求自我验证的强度 4. 运行时预算 5. 骨干模型的强度
    每个配置跑多次(共 18,240 条轨迹全部开源),分离信号与噪声。
    四个发现
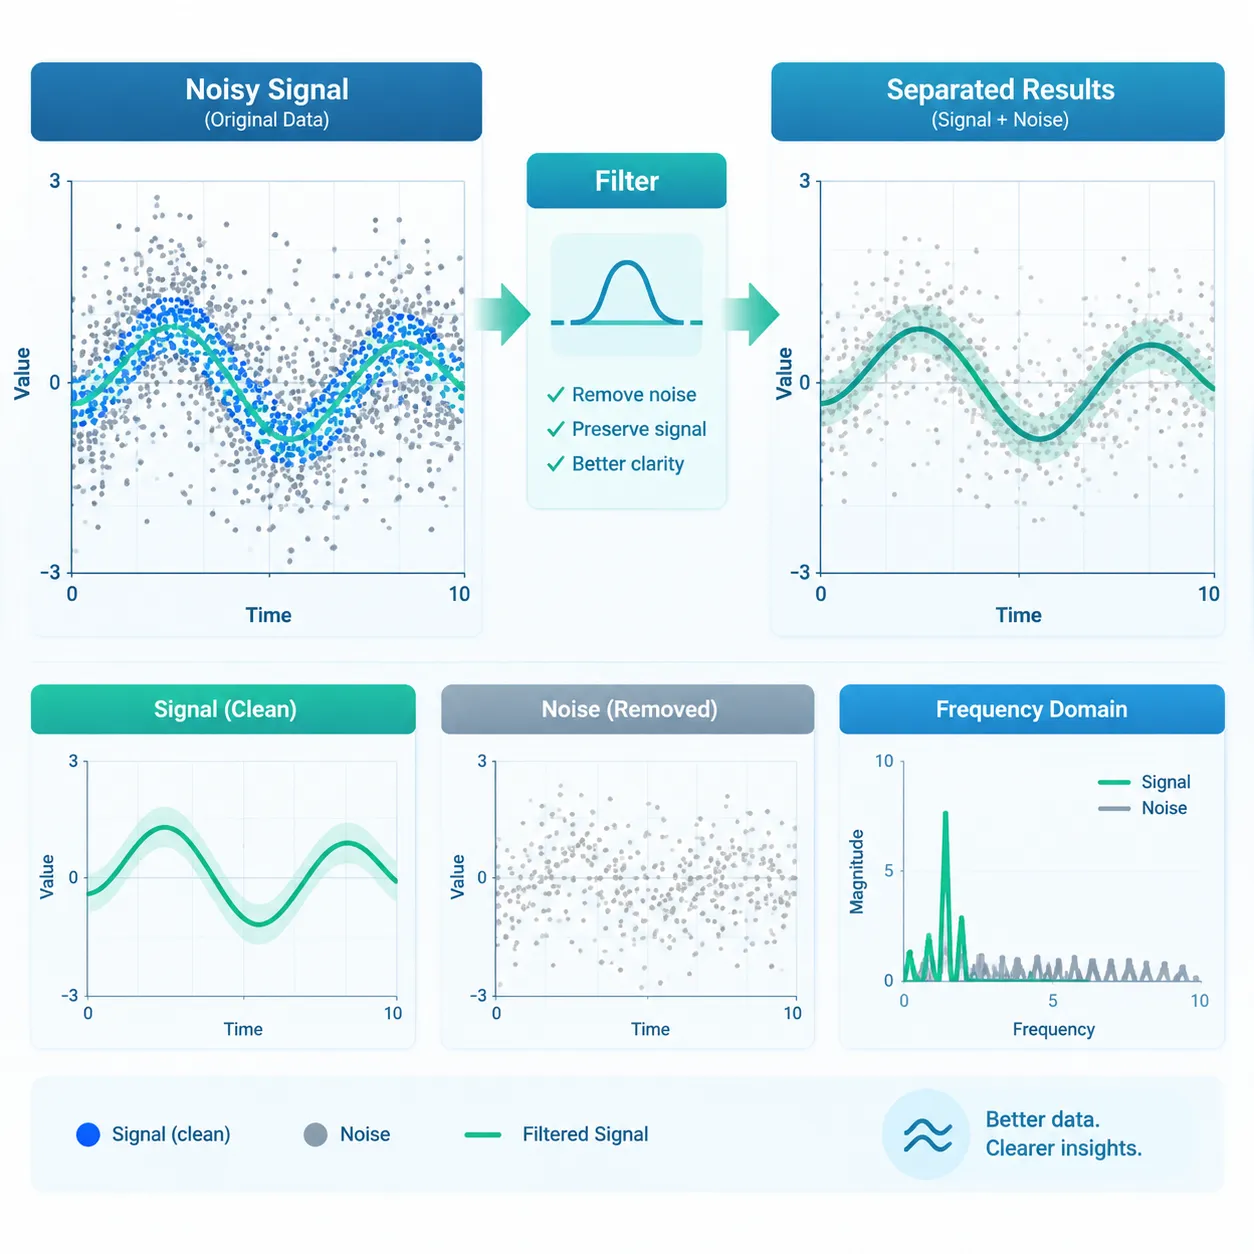
    发现一:智能体的结果天然是噪的。 真实尝试的得分方差里约 54% 是跑次噪声——同一配置跑两次,分数可能差一截。这意味着:不报方差的单次智能体评测基本没有意义;「我们的智能体比你们高 3 分」这类宣称,需要多次运行的置信区间支撑。

发现二:信息轴效应最大,超过模型与预算。 给智能体的信息量对得分的贡献排第一——超过骨干模型强度、超过运行预算。而且信息更足还同时降低成本和运行时间、改善校准(智能体对自己答案的信心更准)。
112.png

发现三:配置轴之间有交互,不能孤立调。 加预算主要在「信息足够」时提升分数——信息不足时加预算甚至降分(智能体拿时间空转)。轴与轴不独立,单独调一轴可能被另一轴卡住。
发现四:有些行为提示词管不动,得靠系统设计。 「自我验证」这类行为,用户在提示词里怎么催效果都有限——但给它一个专门的验证工具,行为立刻显著改变。结论:这类行为应该在系统层设计(提供工具/机制),而不是指望提示词。
为什么这篇值得读

  1. 「智能体是系统不是模型」有了数据支撑——这个论文标题里的论断被 18k 轨迹的实验落地成可操作的结论 2. 给评测者提了醒:跑次噪声占一半方差,单次跑的智能体榜单要重新审视 3. 给构建者提了顺序:与其先纠结换更强的模型,先把「给智能体的信息」这件事做对——这是最便宜的增益来源 4. 行为设计归位:验证类行为交给系统工具而非提示词,这是智能体工程的设计原则
    与 BuddyMe 的经验印证
    这篇的四个发现在我们的工作流实践里都有对应:每步落盘与可回溯(信息轴——任务链中每步给智能体的上下文是设计重点);多轮任务跑多次取稳定结论而非单次判优(噪声发现);验证环节做成显式工序而非提示词叮嘱(发现四——BuddyMe 工作流的验证步骤独立成节点)。每天免费 4500 万 Token 的额度,够把「同一任务多配置对照」这种实验成本打下来——智能体调优先跑对照实验,是这篇给所有构建者最实用的建议。
    BuddyMe 每日免费 4500 万 Token。

目录
相关文章
|
1月前
|
存储 调度 C++
你的记忆系统可能在删「从未被检索过的金子」:因果干预让记忆效用可识别
本文提出因果记忆策略(CMP),直击记忆增强智能体的核心缺陷:未被检索的记忆效用无法识别(检索层正性违反)。创新性地将干预对象从“删除记忆”转向“强制检索”,在SCM框架下实现所有记忆效用的可识别与无偏估计,解决“从未被用≠没用”的误判问题。(239字)
106 1
|
1月前
|
SQL 人工智能 前端开发
Vue3+NestJS实战:纺织行业AI进销存系统架构设计
本文介绍面向纺织行业的AI进销存系统“轻账LightLedger”架构设计:基于Vue3+Element Plus前端与NestJS后端,深度集成批号追溯、多单位换算、委外加工管理,并创新融合DeepSeek大模型实现自然语言智能查询,助力传统ERP升级。
211 2
|
1月前
|
人工智能 自然语言处理 数据可视化
阿里云百炼是什么?如何快速上手百炼AI模型平台?新手0门槛使用指南
阿里云百炼(Model Studio)是一站式AI大模型服务平台,支持通义千问及主流第三方模型,提供OpenAI兼容API、可视化应用构建与工作流编排能力,助力企业快速开发智能体与知识库问答等AI应用。(239字)
|
2月前
|
人工智能 安全 IDE
Qoder 产品负责人张燎原:把 Agentic Coding 装进组织,Qoder助力企业向 AI Native 组织的进化
9月22日云栖大会,阿里ATH事业群Qoder负责人张燎原带来《把Agentic Coding装进组织》主题演讲。Qoder由通义灵码升级而来,已服务超800万开发者,提出“Agentic Coding Platform for Everyone”新定位,聚焦交互简化、人机协同与企业落地,助力企业迈向AI Native组织进化。
414 2
|
3月前
|
人工智能 安全 BI
AI Agent量化评估:LLM-as-Judge、人工标注、A/B测试全解,智能体多维评测实践21.0
本文系统阐述AI Agent评估迭代体系,提出“LLM-as-Judge+人工标注+A/B测试”三位一体评测方法,覆盖功能准确性、服务性能、运行安全、成本损耗四大维度,构建数据层—评测层—分析层—迭代层四层架构,实现从离线初筛、精准校准到线上验证的闭环优化,助力Agent从Demo走向企业级稳定落地。
515 3
|
2月前
|
人工智能 运维 IDE
阿里云Qoder CN最新活动:开通专业版或高级版,首月Credits翻倍,续费加赠1000Credits
本文聚焦阿里云Qoder CN 2026年9月限时Credits加赠活动,面向个人版专业版、高级版、旗舰版月付用户,推出首月额度翻倍、续费/升级额外加赠1000 Qwen专属Credits的双重算力补贴。完整拆解活动时间窗口、适用边界、加赠额度明细与30天生命周期管理规则,帮助符合条件的用户在窗口期内完成理性订阅决策,低成本从免费体验向AI生产环境平滑迁移。
|
1月前
|
内存技术
一直免费3.8FLASH的话,能不能把订阅会员的积分往后延长,不然我们很吃亏啊,我买了几个高级订阅
用户反馈:3.8版FLASH长期免费,但高级订阅会员积分未同步延期,导致已购会员权益缩水,呼吁延长积分有效期以保障付费用户权益。
|
1月前
|
人工智能 IDE API
Qoder CN AI 编程智能体全解析:产品线划分、Credits 计费规则与 CLI 命令实操教程
在软件研发节奏不断加快,AI智能体从单纯代码补全走向全流程工程任务执行的时代,面向编码与办公场景的一体化AI产品正在改变研发人员的工作模式。Qoder CN,读作/ˈkoʊdər/,中文口语近似“抠的儿”,就是原通义灵码完成品牌升级之后推出的新一代AI智能体产品系列,产品不再局限于IDE内代码补全,把能力边界拓展到编码开发、桌面办公自动化、数字员工云端任务执行等多元场景,覆盖个人开发者、独立工程师、研发团队以及大型企业的不同诉求。产品划分免费社区版、多档个人付费版本,同时提供团队版、企业标准版、企业专属版,不同档位拥有不同Credits资源配额,支持BYOK自带密钥接入第三方大模型,兼容多款主
262 1
|
1月前
|
IDE 安全 测试技术
阿里云Qoder CN技术手册:全仓库代码解析、IDE集成与API接入教程
综合来看,新版Qoder CN服务平台核心价值在于端到端自主编码Agent能力,四层云原生架构兼顾任务调度、跨文件代码理解与安全管控,支持多端接入、插件扩展、私有化部署,适配软件研发、工程重构、自动化测试等场景。在实际使用时,合理划分工作空间,配置任务轮次上限,坚持人工审核代码变更,平衡研发效率、代码安全与调用成本。作为面向产研场景的编码智能体平台,它可以大幅降低大型项目重构、批量编写测试代码的工作量,帮助研发团队释放重复编码工作,专注于业务方案设计。
318 0
|
1月前
|
人工智能 弹性计算 自然语言处理
QoderWake——从桌面里的Agent到工作现场的数字员工
9月23日云栖大会,阿里Qoder产品专家耿欣发布《QoderWake:从桌面Agent到工作现场的数字员工》。该产品以“岗位角色、身份工位、培训教学、接入IM、连通系统、记忆成长”六步法,打造可入职、能履职、会进化的数字员工。已创建超10万个数字员工,服务2000+企业,助力构建人机协同的“超级组织”。
369 0

热门文章

最新文章