
很多人刚接触数据建模时,最容易被各种“层”绕晕。有人说数据建模要分概念模型、逻辑模型、物理模型;有人又说数仓要分ODS、DWD、DWS、ADS;真正进入项目以后,还会听到客户主题域、交易主题域、供应链主题域。
于是很容易把它们理解成一套从上到下的层级。其实不是。真正需要先分清的是两条线:主题域、概念模型、逻辑模型、物理模型,解决的是“业务怎样逐步翻译成数据结构”; ODS、DWD、DWS、ADS,解决的是“数据进入数仓以后怎样逐层加工”。 前者是建模抽象层次,后者是数据加工层次。把这两条线分开,很多建模问题才真正开始变清楚。
一、主题域:不是先分表,而是先给业务世界划边界
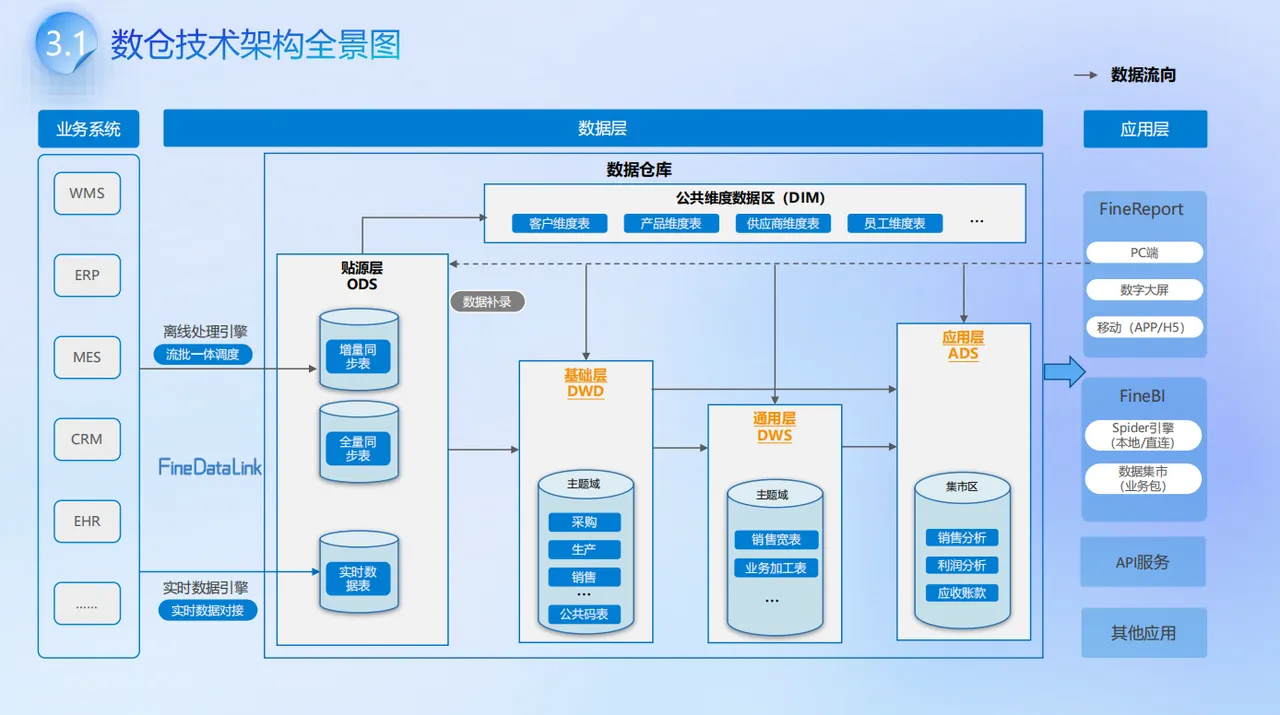
很多项目所谓的“建模”,第一步就是把ERP、CRM里的表全部盘出来,再按照来源系统分目录。ERP一组,CRM一组,WMS一组。这其实还不是主题建模。源系统告诉你数据来自哪里,主题域回答的是这些数据在业务上属于什么。
例如一家零售企业可能存在:客户主题;商品主题;交易主题;库存主题;供应链主题;营销主题;财务主题。这里最重要的不是名称,而是边界怎么划。
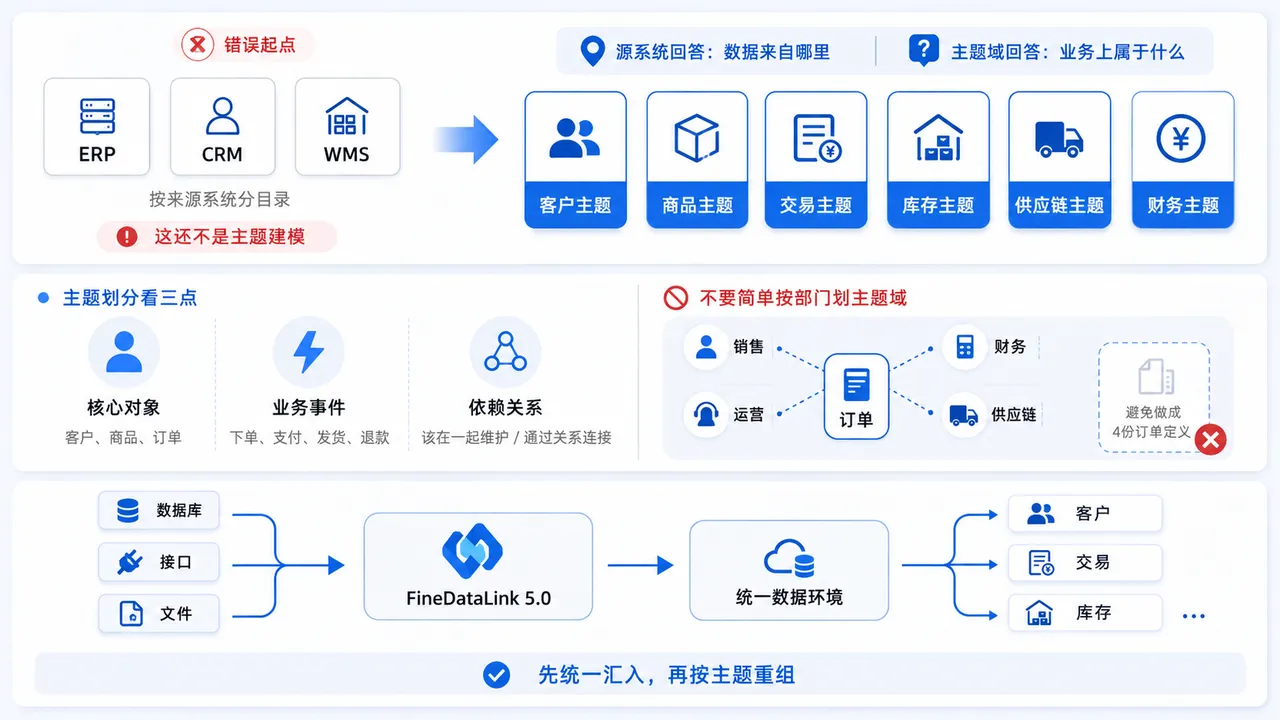
不要简单按照部门划主题域
销售部、财务部、运营部分别建立主题,看起来清楚,实际很容易制造新的数据孤岛。因为“订单”并不只属于销售。销售关心订单金额,运营关心履约,供应链关心发货,财务关心收入确认。
如果每个部门都重新定义一遍订单,最终往往会出现:销售订单数、运营订单数、财务订单数三个数字。 主题域应该尽量围绕稳定的业务对象和业务过程建立,而不是照搬组织架构。
判断主题域,可以看三个东西
第一是核心对象。客户主题围绕客户,商品主题围绕商品,交易主题围绕订单与交易。第二是业务事件。下单、支付、退款、发货、入库,本质上都是业务发生过的事件。第三是主题之间的依赖关系。订单可以关联客户、商品、门店,但客户和商品不应该因为出现在订单里,就全部塞进交易主题。
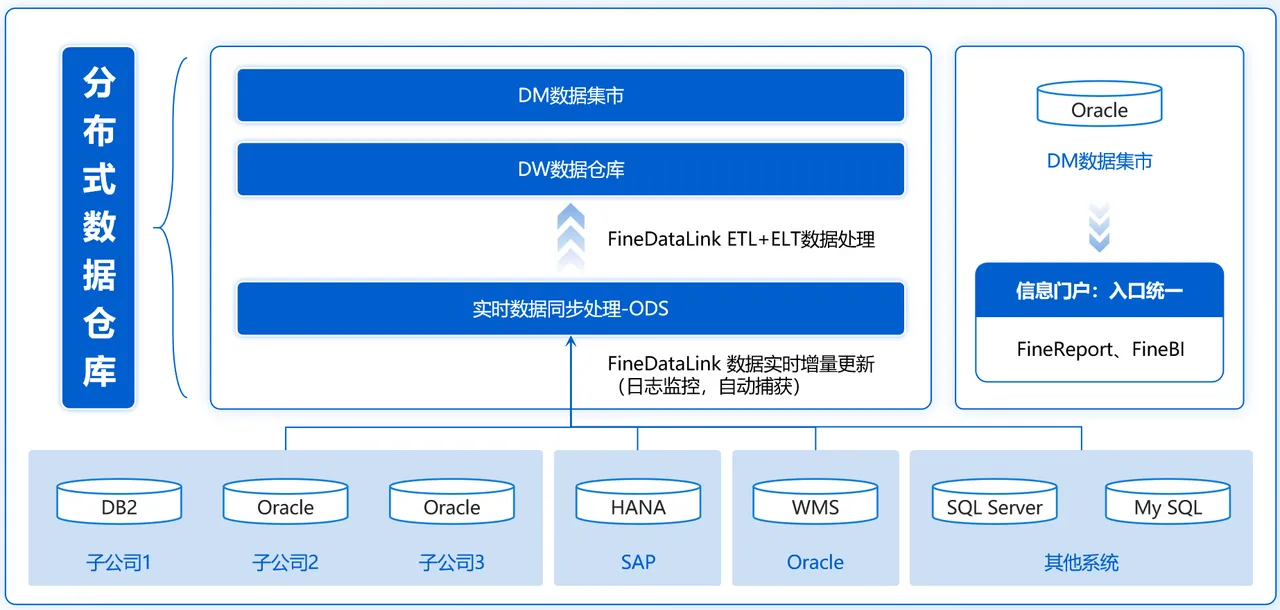
所以主题划分的本质,是寻找:哪些东西应该在一起维护,哪些东西应该通过标准关系连接。 真正实施时还会遇到一个现实问题:主题域是按照业务划的,而底层数据往往按照系统散着放。客户在CRM,订单在ERP,库存又在WMS。
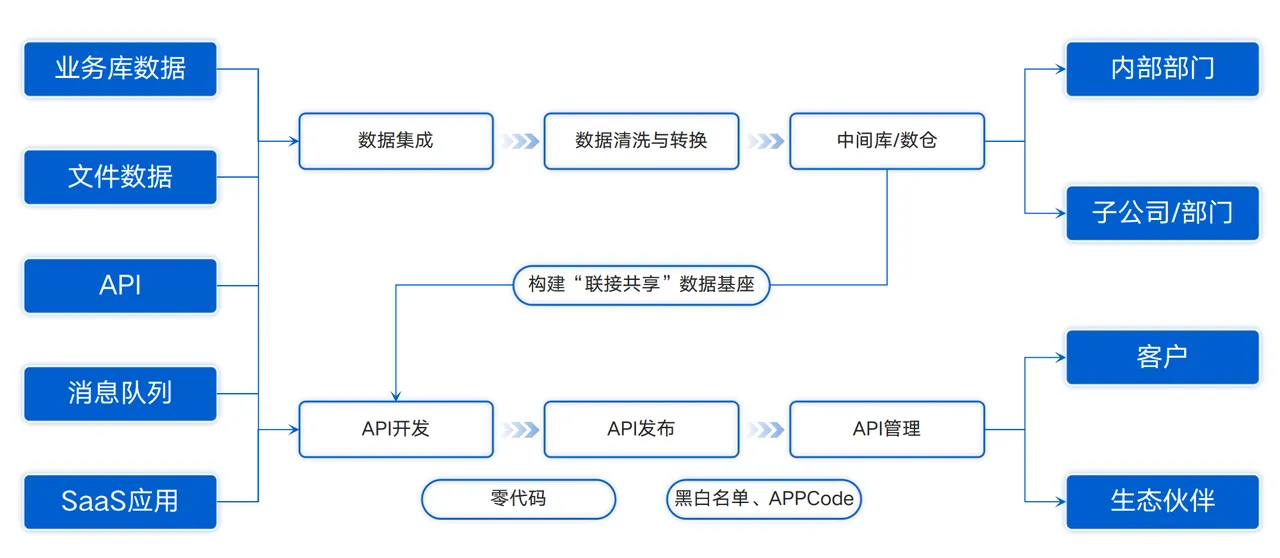
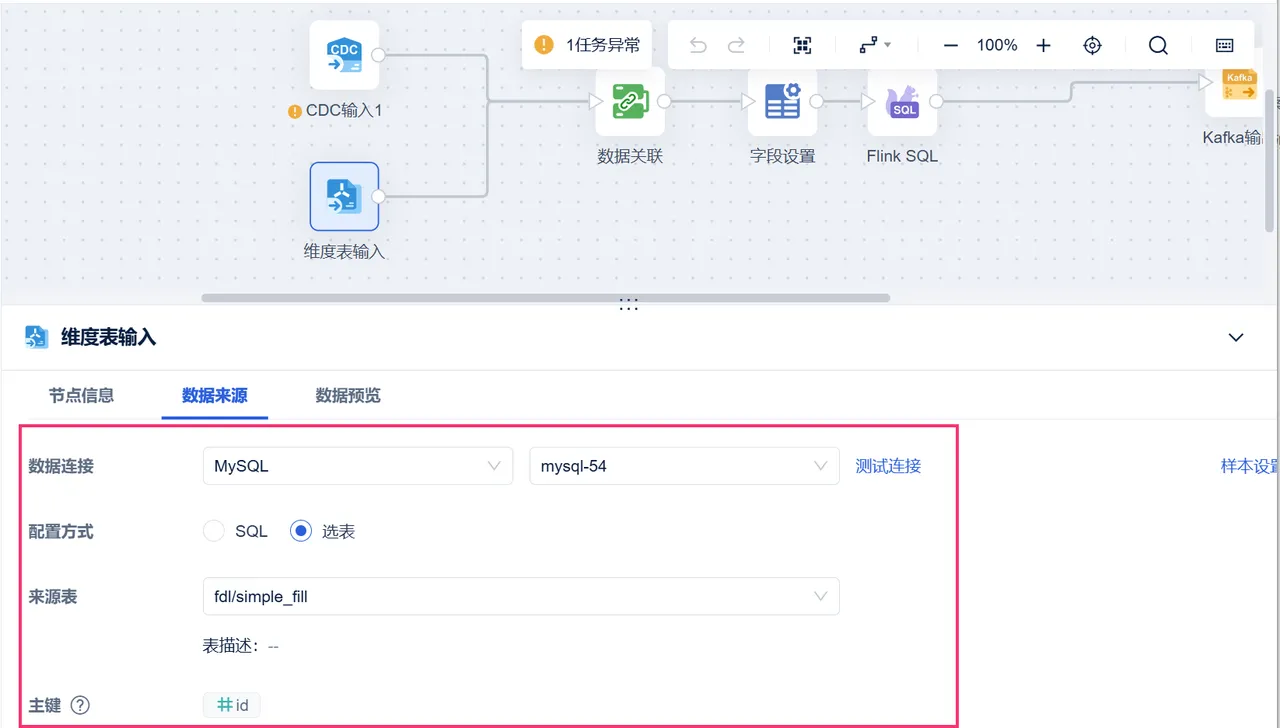
这种情况下,通常会先把数据库、接口、文件等不同来源的数据汇入统一的数据环境,再按照客户、交易、库存等主题重新组织。这样后面讨论的就不再是“ERP里有哪些表”,而是“完成交易主题需要哪些数据”。
二、概念模型:先搞清楚业务里有什么,不急着考虑数据库
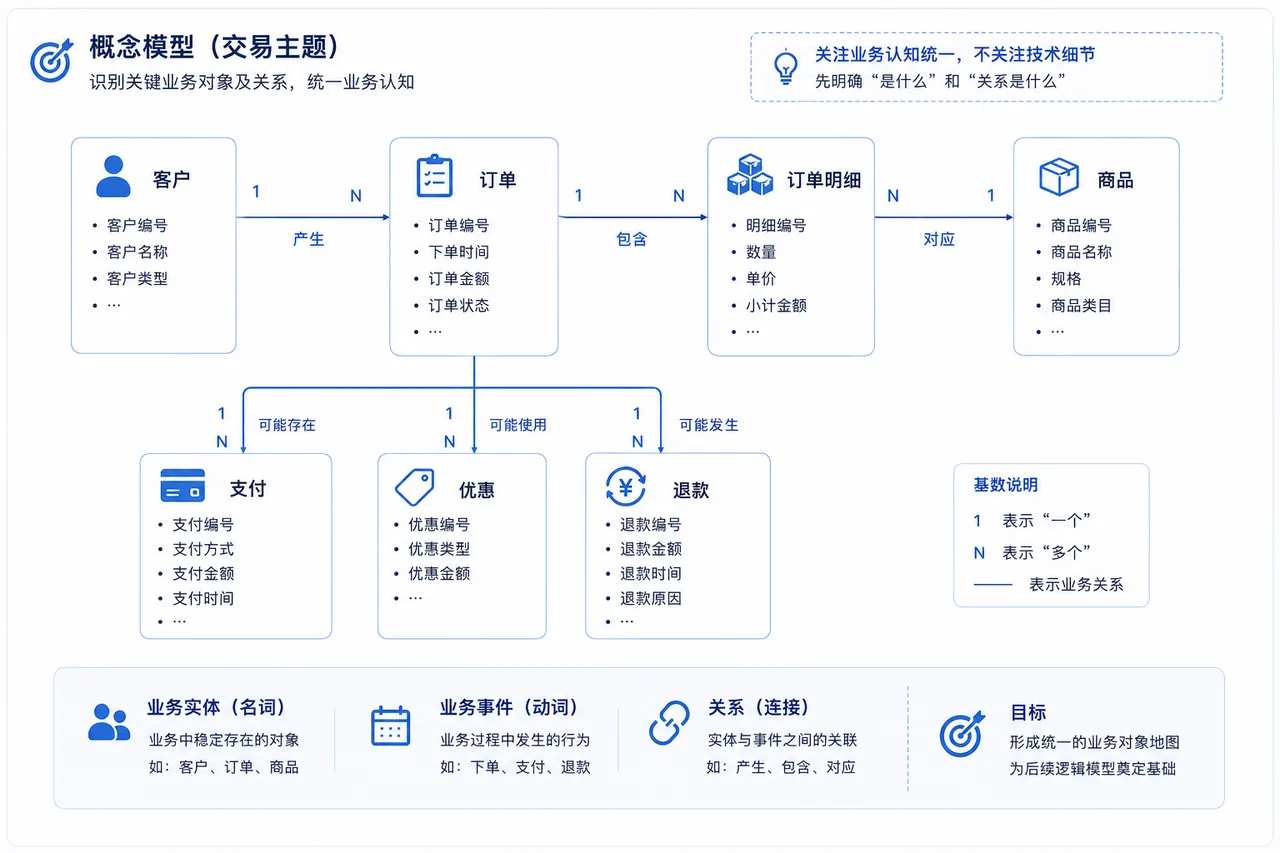
主题域确定以后,第二步是建立概念模型。概念模型回答的是:这个业务领域里,有哪些关键对象,它们之间是什么关系? 以交易主题为例,可以先识别:客户、订单、订单明细、商品、支付、优惠、退款。
然后定义关系:一个客户可以产生多张订单;一张订单包含多条订单明细;订单明细对应具体商品;一张订单可能存在支付,也可能发生退款。
注意,这一阶段一般还不需要纠结:字段叫customer_id还是cust_id;金额用decimal还是double;表放MySQL还是ClickHouse。因为概念模型首先解决的是业务认知统一。
这一步看似简单,实际上非常重要。例如:“客户”到底是什么?注册账号算客户,还是只有发生购买的人才算?企业客户如果存在多个联系人,是一个客户还是多个客户?“订单取消”和“订单退款”是不是同一个业务事件?
如果这些问题没有先统一,后面再精细的数据库设计,也只是把业务分歧固化了下来。所以好的概念模型,重点不是画得多漂亮,而是把三个东西讲清楚:业务实体是什么、业务事件是什么、实体之间是什么关系。 它本质上是一张企业的业务对象地图。
三、逻辑模型:真正决定数据“怎么算”
到了逻辑模型,建模开始从业务语言进入数据语言。这一步需要回答:这些业务对象,怎样组织成可计算的数据结构? 其中最重要的不是字段,而是粒度。
建事实表之前,先写一句“一行代表什么”
例如销售事实表:如果定义为:一行=一张订单 。那么它可以直接分析订单数、订单金额、客单价。但如果要回答:某个SKU卖了多少件?哪个商品贡献了多少收入?不同品类的折扣是多少?订单级粒度就不够。
此时更合理的粒度可能是:一行=一条订单商品明细。 这就是为什么建模时必须先定粒度。因为粒度一旦混乱,指标就很容易被重复计算。 一张表里既有订单级金额,又有商品明细级数量,一张订单有5条明细,那么订单金额很可能被重复5次。
粒度确定以后,再区分事实和维度
事实描述的是发生了什么。例如:销售金额、购买数量、支付金额、退款金额。维度描述的是:这件事是在什么条件下发生的。
例如:客户、商品、地区、渠道、日期、门店。因此一个订单明细事实可能最终形成:时间 × 客户 × 商品 × 门店 × 渠道 → 数量、金额、成本。 这才是分析模型真正的骨架。
还要考虑历史怎么保存
现实世界并不是静态的。客户今天属于华东区,下个月调整到华南区;商品今天属于A品类,半年以后重新分类;门店可能更换所属区域。
此时必须决定:分析历史订单时,是按照当时的归属,还是按照现在的归属?这就是逻辑模型里经常遇到的缓慢变化维问题。
因此一个完整的逻辑模型,至少应该明确:业务粒度、事实、维度、主键、关联关系、历史变化以及指标来源。 到了这里,模型已经开始真正进入数据加工阶段。
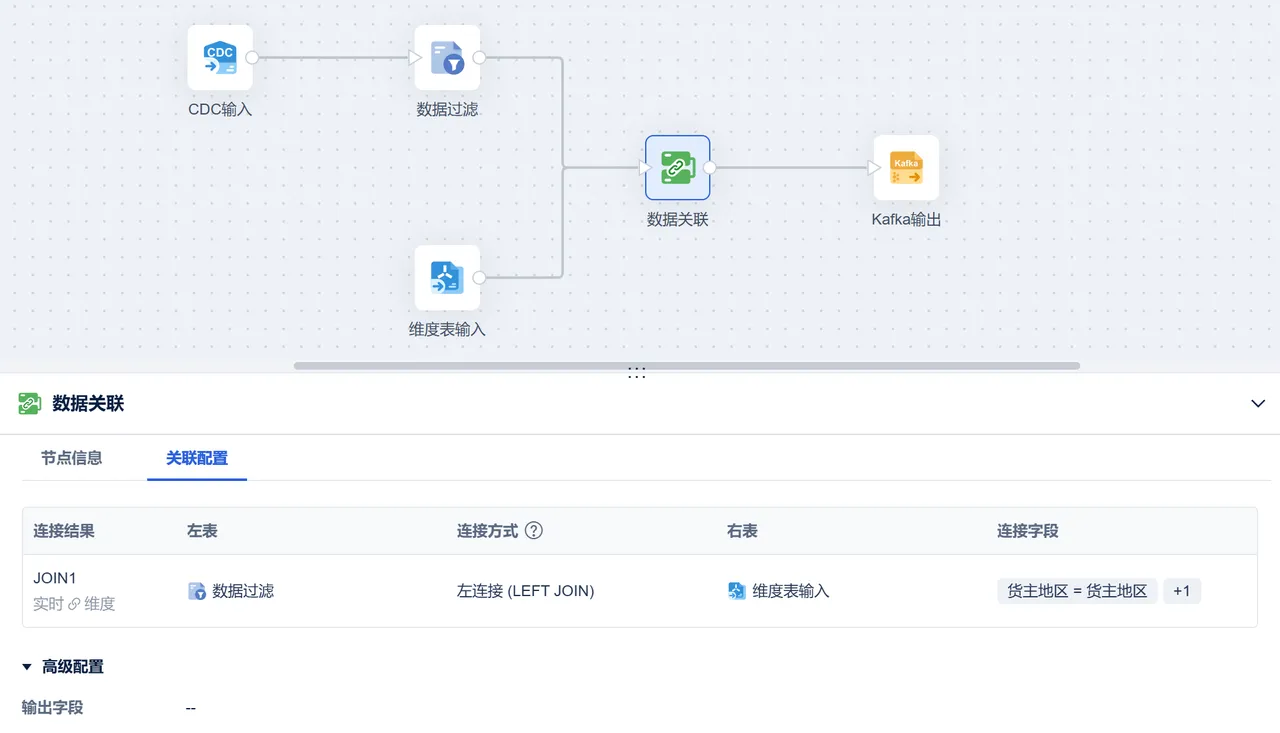
所以这里最重要的一点是:工具负责执行模型,不能替代模型本身。 如果粒度没有定义清楚,再完整的数据加工流程,也只是稳定地产出错误数据。
四、物理模型:不是“建表”,而是决定模型怎样跑得动
逻辑模型设计完成后,还要继续落到具体数据库中。这一步才是物理模型。例如逻辑模型中已经确定:销售订单明细事实表,一行代表一个订单中的一个商品明细。
进入物理模型以后,需要继续确定:表叫什么名字;字段采用什么数据类型;主键如何生成;是否分区;按日期还是业务组织分区;是否建立排序键、索引;全量还是增量更新;历史数据保留多久;数据落MySQL、Doris还是ClickHouse。因此,同一个逻辑模型,在不同数据库中可能会形成完全不同的物理结构。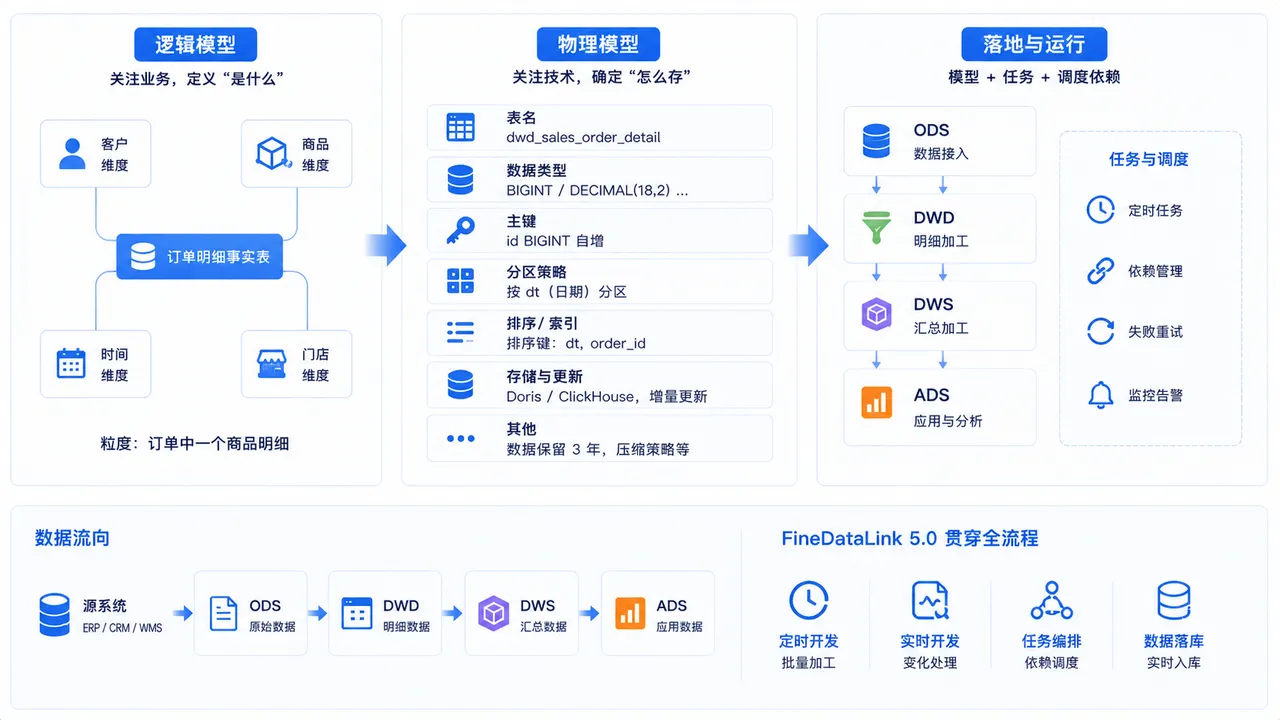
这也是为什么:逻辑模型应该尽量保持业务稳定,物理模型则需要适应技术环境。 如果更换一次数据库,连客户、订单、商品之间的关系都需要重新定义,那之前设计的其实并不是真正独立的逻辑模型。物理模型还有一个经常被忽略的问题:表建出来,不代表模型已经能够稳定生产。
真正上线以后,还需要处理:ODS什么时候进数?DWD什么时候开始加工?上游任务失败以后,下游要不要运行?增量任务失败以后从哪里续跑?字段增加以后哪些任务受到影响?因此落地阶段通常还要把模型、数据任务和调度依赖放在一起看。物理模型真正完成的标志,不是CREATE TABLE成功,而是这张表能够按照业务需要持续、稳定地产出数据。
五、概念、逻辑、物理模型,与ODS/DWD/DWS到底是什么关系?
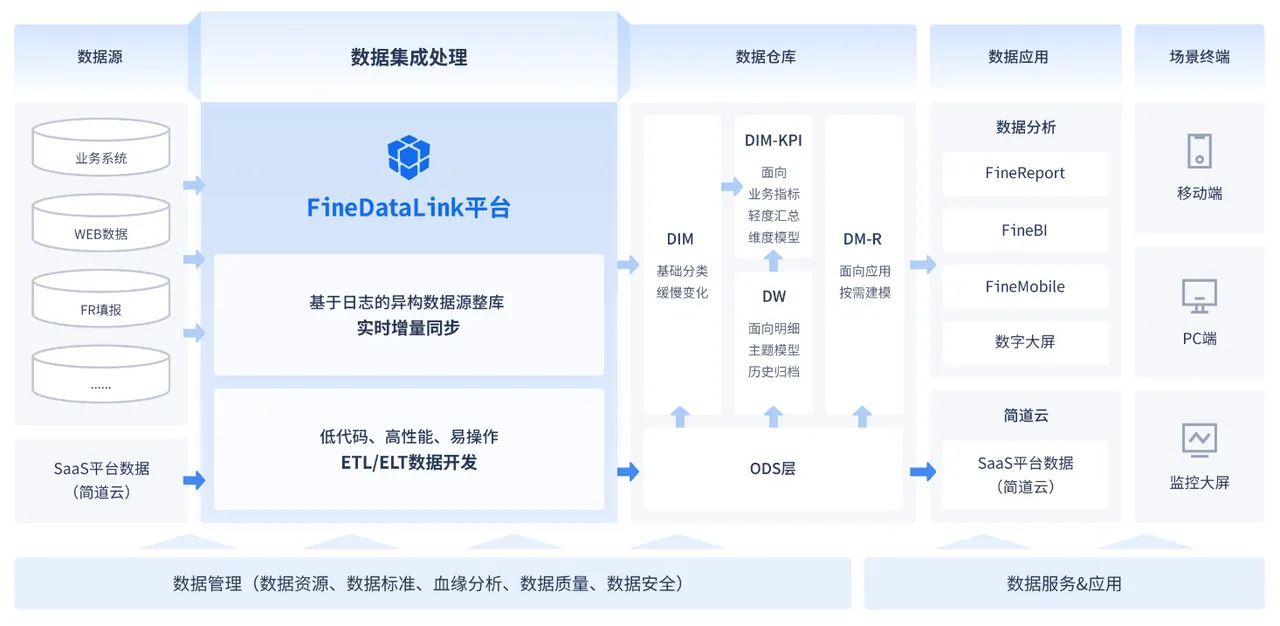
这是整个数据建模里最容易混淆的问题。可以直接记住:概念、逻辑、物理,是模型抽象层次; ODS、DWD、DWS、ADS,是数据加工层次。
两者不是上下级关系。举个完整例子。业务上发生了一件事:客户购买商品。 在概念模型里,我们识别出:客户、订单、商品。到了逻辑模型:可能设计客户维、商品维、订单明细事实。到了物理模型:进一步确定实际表名、字段类型、分区方式和存储引擎。
而同样这批数据进入数仓以后,还会经历:ODS:保留接近源系统的订单原始数据;DWD:完成清洗、去重、编码统一,形成标准订单明细事实;DWS:按照客户、商品、地区等维度进行公共汇总;ADS:针对销售分析、经营看板等场景形成应用数据。
所以逻辑模型并不等于DWD,物理模型也不等于ODS。更准确的理解是:一个模型可能贯穿多个数仓层,而每个数仓层又会存在自己的物理表。
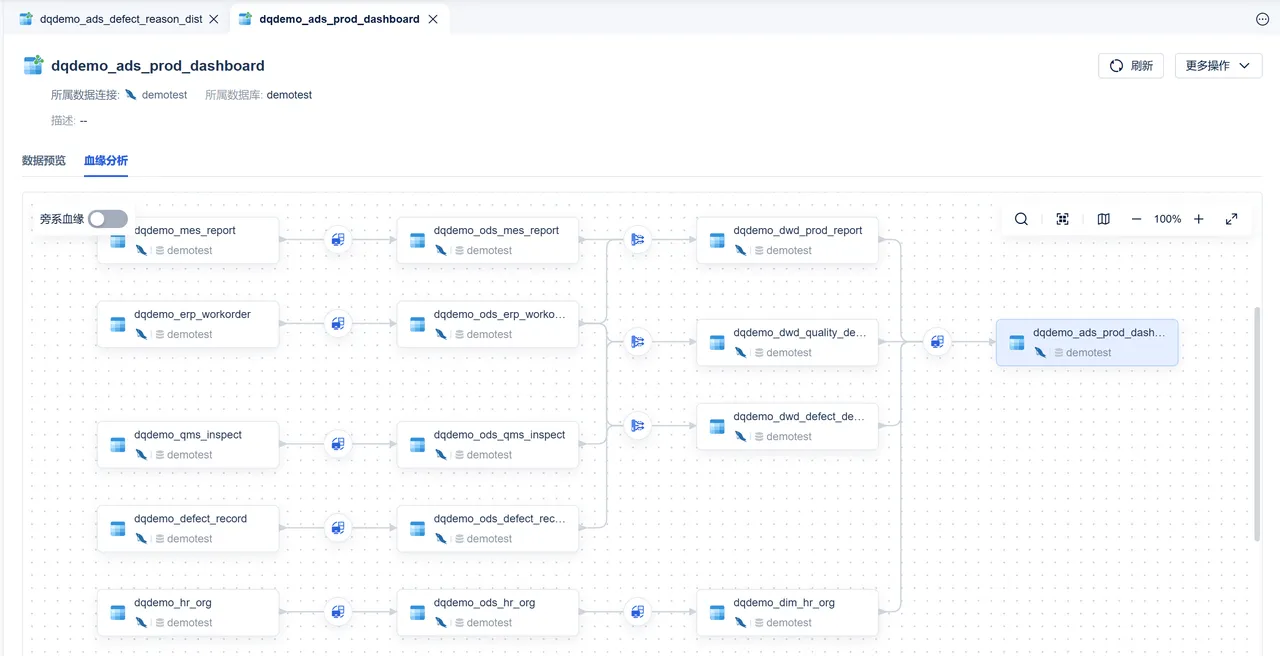
项目做大以后,真正麻烦的往往也不是建一张表,而是这些层之间形成成百上千条依赖:一个DWS指标到底来自哪张DWD表?DWD字段又来自哪个源系统?某张事实表结构变化,哪些ADS会受到影响?
六、一套真正能落地的数据建模顺序
如果企业从零开始建模,可以按照下面的顺序推进。
第一步:梳理业务过程
先回答企业到底发生了什么:获客、下单、支付、采购、生产、发货、回款。不要从数据库表开始理解业务。
第二步:划分主题域
根据稳定的业务对象和业务过程,确定客户、商品、交易、库存等主题及边界。
第三步:建立概念模型
确认核心实体、业务事件和实体之间的关系。这一步主要解决:大家说的是不是同一个东西。
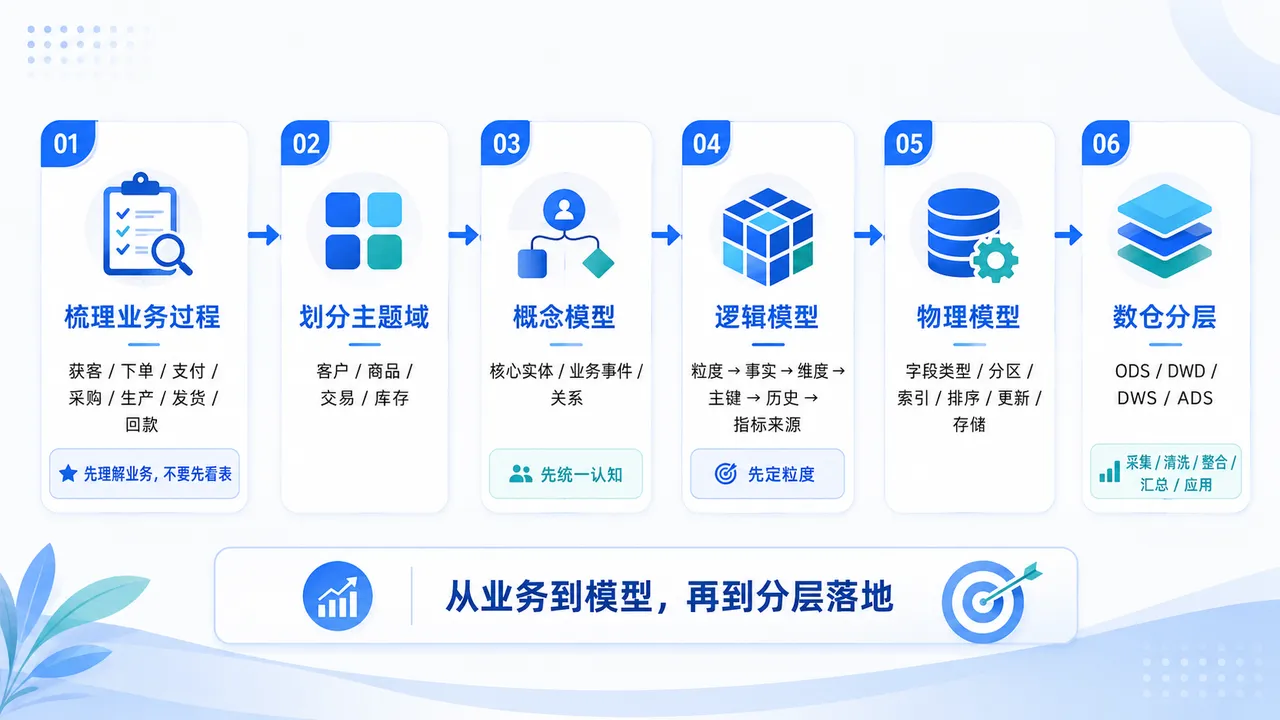
第四步:建立逻辑模型
确定:粒度 → 事实 → 维度 → 主键 → 历史变化 → 指标来源。 其中一定要先定粒度,再讨论字段。
第五步:形成物理模型
根据数据库和实际数据规模设计:字段类型、分区、索引、排序、更新方式和存储策略。
第六步:落到数仓分层
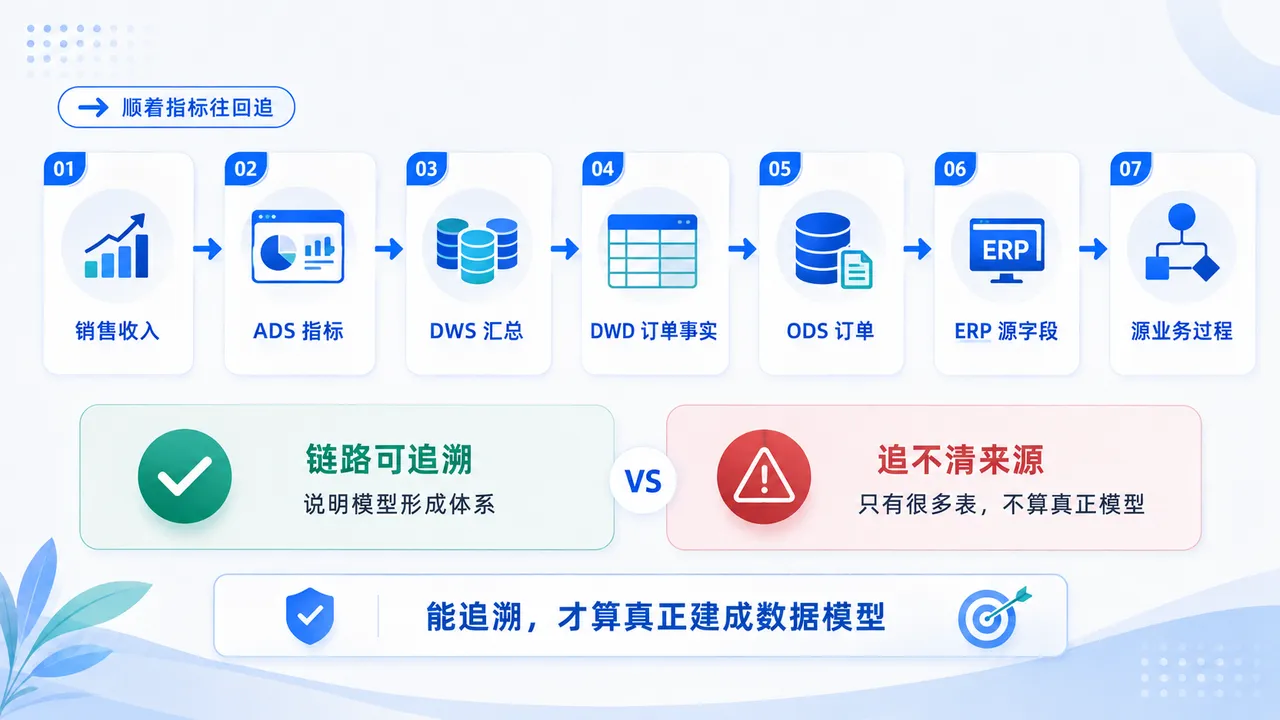
通过ODS、DWD、DWS、ADS等层次组织数据采集、清洗、整合、汇总和应用。最后还要做一次反向验证。随便拿一个经营指标,例如“销售收入”,尝试往回追:销售收入 → ADS指标 → DWS汇总 → DWD订单事实 → ODS订单 → ERP源字段。
如果整条链路能够解释清楚,说明模型真正形成了体系。如果追到中间只能得到一句:“这张表以前的人建的,不知道怎么算的。”那企业拥有的只是很多数据表,还不能算真正拥有了一套数据模型。
结语
数据建模真正难的,从来不是背下几个术语。而是完成一连串翻译:把企业拆成主题,把业务识别成对象,把对象转成数据关系,再把数据关系落成能够持续运行的物理结构。
主题域解决边界;概念模型解决业务认知;逻辑模型解决数据如何组织和计算;物理模型解决数据怎样真正存储和运行;ODS、DWD、DWS、ADS再负责让数据按照不同加工阶段逐步流动。所以评价一个模型设计得好不好,最终不应该只看:表建得规不规范。
而应该继续问三个问题:业务能不能解释清楚? 指标能不能稳定算准? 一旦数据或者模型发生变化,能不能快速知道影响在哪里? 做到这三点,数据建模才真正从“画模型图”,变成了企业长期能够复用的数据基础设施。

