
@TOC
一,前言
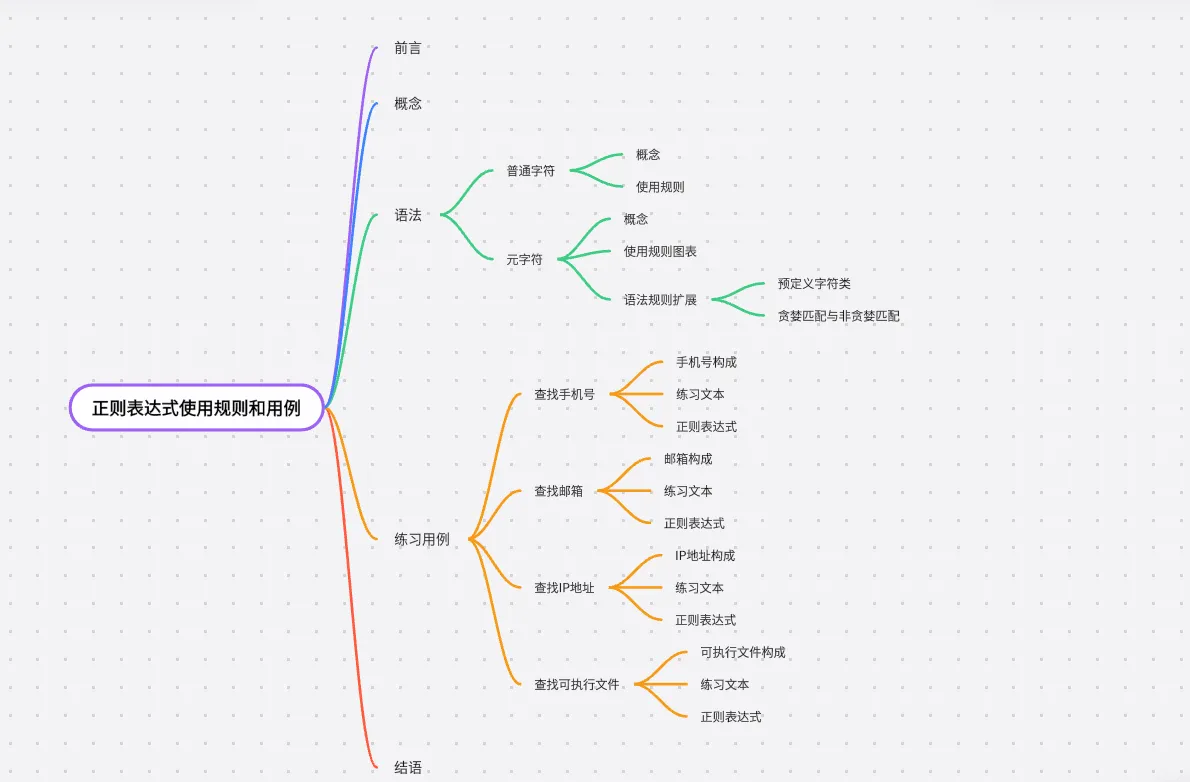
嗨,我是firdawn,最近用 everything 搜索文件时,想要搜索以“git”开头的文件,但是如果直接在搜索框直接输入“git”,却会跳出“git”在文件任意位置的文件,干扰搜索,所以就复习了一下正则表达式的语法规则。本篇文章我将介绍正则表达式的概念,语法图表,还有练习用例。如果你想了解正则表达式的语法规则或是在regular expressions,练习正则表达式却缺少练习用例,本篇文章都可以为你提供一定的帮助。下面是本章的思维导图,那么让我们开始吧。
*[everything]: everything是voidtools开发的轻量化快速文件搜索工具。
二,概念
正则表达式(Regular Expression)是一种强大的文本处理工具,专门用来匹配,查找,替换文本字符串的语法规则,并且用一串特殊符号描述文本的模式。正则表达式的作用就是帮助我们匹配指定规则的字符串。 它的应用场景有:
- 从文本中查找手机号,邮箱,网址,IP地址。
- 判断手机号或者密码输入格式是否正确。
- 批量修改,清理文本,删除多余的空格,删除指定字符串等。
三,语法
正则表达式的语法由「普通字符」和「元字符」组成,元字符是具有特殊含义的符号
我们先看一个简单的正则表达式 abc? ,它就是由特殊字符 ? 和普通字符 abc 组成。表示搜索abc,其中的c出现0次或者1次,也就是可有可无,表示搜索 abc 或者 ab ,只要字符串中包括 abc 或者 ab ,搜索结果中就会被查找到。
3.1 普通字符
3.1.1 概念
普通字符是指没有特殊含义,仅代表自身字面量的字符。正则表达式搜索引擎遇到普通字符时,只会在目标文本中寻找完全相同的字符进行匹配。包括:
- 全部大小写字母和数字:
a-zA-Z0-9 - 大部分可见符号:
!@#%&-=;':",等
字符在绝大多数情况下,如果不属于元字符,那它就是普通字符。
3.1.2 使用规则
正则表达式搜索引擎遇到普通字符时,只会在目标文本中寻找完全相同的字符进行匹配。
3.2 元字符
3.2.1 概念
元字符是正则表达式里具备特殊语法功能的字符,不会匹配它自身符号,如果要匹配元字符自身,需要在前面添加转义字符 \ 用来它自身。元字符可以匹配规则,位置,数量,范围。元字符包括:
.\+*?[](){}|^$3.2.2 使用规则图表
| 元字符 | 使用规则 | 举例 | ||||||
|---|---|---|---|---|---|---|---|---|
| . | 匹配任意单个字符,默认不匹配换行符 \n |
正则表达式 a.b 匹配 axb a1b a#b ,不匹配 a\nb |
||||||
| \ | 两大功能:1. 放在元字符前:取消特殊含义,元字符转为普通字符;2. 放在字母前,构成转义序列 \d \w \s |
\. 匹配小数点, \d 匹配数字(0-9) |
||||||
| + | 前一个单元,重复1次或者多次 | 正则表达式ab+ 匹配 ab ab abb ,不会匹配 a |
||||||
| * | 前一个单元,重复0次或者多次 | 正则表达式ab* 匹配 a ab abb |
||||||
| ? | 两大功能:1.前一个单元重复0次或者1次(也就是可有可无)。2.放在 * / + :表示开启非贪婪模式 |
正则表达式 ab? 匹配 a ab ,<.*?>匹配最小子集 |
||||||
| [ ] | 匹配括号内任意单个字符;如果开头写 ^ 代表取反,匹配非括号内的字符; - 表示字符范围 |
正则表达式 [0-9] 表示数字; [abc] 表示匹配 a 或者 b 或者 c , [^0-9]表示非0到9的字符,也就是非数字 |
||||||
| ( ) | 两大功能:1.将括号内容作为整体,供元字符修饰;2.建立分组,方便后续引用 | (ab)+ 匹配 ab abab |
||||||
| { } | 限定前面单元的重复次数。正则表达式 {n} 表示重复n次, {n,} 表示重复n次及以上, {n,m} 表示重复n到m次 |
ab{3} 表示匹配 abbb ,ab{2,} 表示 abb abbb abbbb 这里b重复的次数要达到2次及以上, ab{2,3} 表示 abb abbb |
||||||
| \ | 表示"或",匹配多个分支中的任意一个分支,并且 `\ | ` 的优先级最低 | `cat\ | dog表示cat`dog ; `ca(t\ |
d)og表示catog`cadog 中间选择t或者d; `I love (Java\ |
Python\ | C++)表示I love Java`I love Python I love C++ |
|
| ^ | 两大功能:1.匹配字符串起始位置。2.在 [] 内部开头出现表示取反 |
^hello 匹配以hello开头的字符串; [^0-9] 表示非0-9的字符,也就是非数字 |
||||||
| $ | 匹配字符串结束位置 | world$ 匹配以world结尾的字符串 |
3.2.3 语法规则扩展
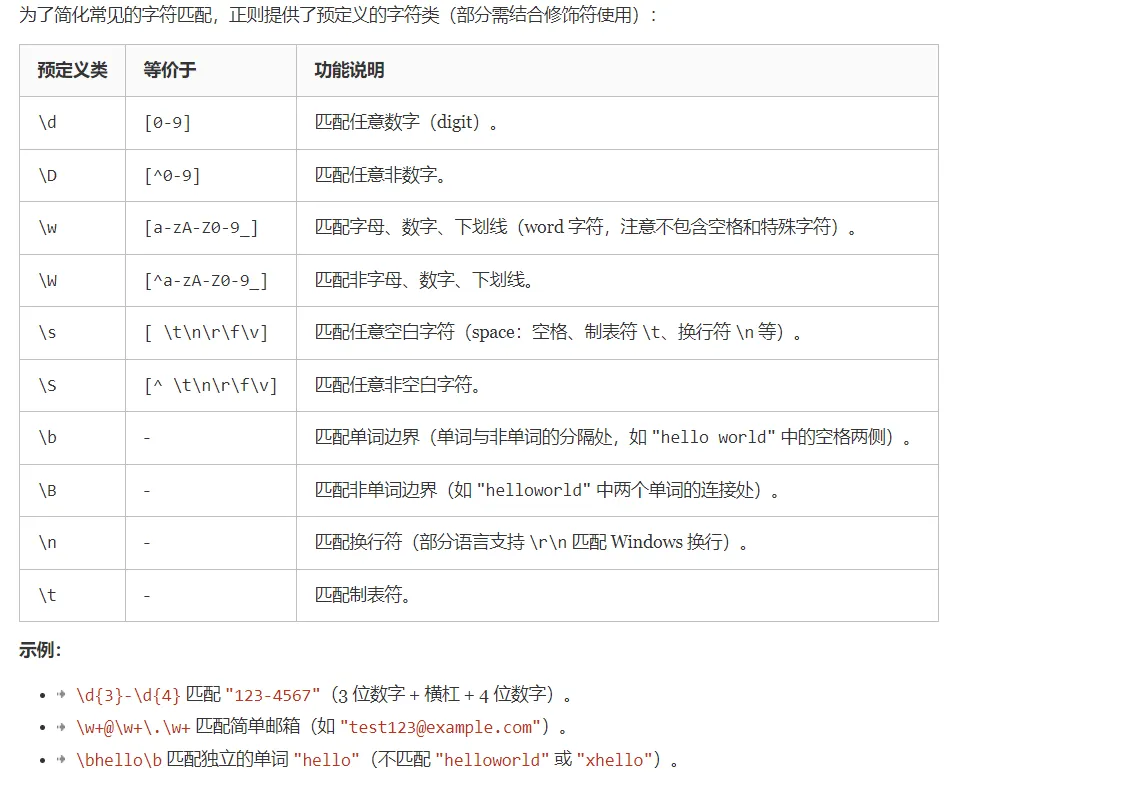
3.2.3.1 预定义字符类
3.2.3.2 贪婪匹配与非贪婪匹配
贪婪匹配:正则表达式中元字符
*+{n,m}默认是贪婪匹配。正则表达式搜索引擎会尽可能匹配最长的符合条件的字符串,也就是满足条件的最大子集。
非贪婪匹配(惰性匹配):正则表达式中元字符*+{n,m}的后面追加元字符?,开启非贪婪匹配。正则表达式搜索引擎会尽可能匹配最短的符合条件的字符串,也满足条件的最小子集。
使用场景1:HTML标签
练习文本:<div>苹果</div><div>香蕉</div>
| 模式 | 正则表达式 | 结果 |
|---|---|---|
| 贪婪 | <div>.*</div> |
<div>苹果</div><div>香蕉</div> |
| 非贪婪 | <div>.*?</div> |
<div>苹果</div> 或者 <div>香蕉</div> |
使用场景2:获取 a.*b 的最小子集
练习文本: a111b222b
| 模式 | 正则表达式 | 结果 |
|---|---|---|
| 贪婪 | a.*b |
a111b222b |
| 非贪婪 | a.*?b |
a111b |
使用场景3:获取 {m,n} 的最小子集
练习文本: abbyby
| 模式 | 正则表达式 | 结果 |
|---|---|---|
| 贪婪 | a.{2.5}y |
abbyby |
| 非贪婪 | a.{2.5}?y |
abby |
四,练习用例
新手练习推荐使用regular expressions,练习方便,右边侧栏还有正则表达式的语法规则介绍及网站准备的练习用例。博主本人也是用这个正则表达式网站练习的。
4.1 查找手机号
4.1.1手机号构成
- 11位数字
- 第1位:固定是1
- 第2位:运营商号段,范围为3-9
- 第3-11位:任意9位数字
4.1.2 练习文本
联系号码:13812345678 备用号12912345678(第二位是2,无效手机号) 老号码:19987654321 短号:135123456(只有10位) 长号:135123456789(一共12位) 带横杠:138-1234-5678 带空格:138 1234 5678 文本穿插:aa13755667788bb 多个号码放一起:13600112233,13900112233 非数字:13a45678901
4.1.3 正则表达式
^1[3-9]\d{9}$
解读:
^:表示匹配字符串的开始位置,确保正则表达式从文本的起始字符开始匹配。1:匹配一个固定的数字字符“1”,用于限定手机号码以“1”开头。[3-9]:匹配一个位于3到9之间的单个数字。该部分用于限定手机号码第二位为3至9,符合中国手机号码的规则(如13、14、15、16、17、18、19等号段)。\d{9}:\d 表示任意一个数字字符(0-9),{9} 表示前面的 \d 重复恰好9次。因此这部分总共匹配9个数字,与前两位共同构成完整的11位手机号码。$:表示匹配字符串的结束位置,确保整个输入内容完全由11位数字组成,不允许有额外字符或空格。
4.2 查找邮箱
4.2.1 邮箱构成
电子邮件地址通常由三部分组成:
- 本地部分(Local Part):位于@符号之前,用于标识用户账户,可包含字母、数字、点(.)、下划线(_)、连字符(-)等字符,但不能以点开头或结尾,也不能连续出现两个点。
- @符号:分隔本地部分与域名部分的固定符号。
- 域名部分(Domain Part):位于@符号之后,表示邮件服务器的域名,通常由字母、数字、点(.)和连字符(-)组成,且至少包含一个点,最后不能以点结尾。
4.2.2 练习文本
user@example.comtest.email@domain.orgadmin@sub.example.netuser+tag@company.co.ukinvalid..email@domain.com(连续两个点,无效)@example.com(缺少本地部分)user@.com(域名以点开头)user@domain(无顶级域)user.name@domain.com.cn12345@abc-def.xyz
4.2.3 正则表达式
^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$
解读:
^:匹配字符串的开始位置,确保从头开始匹配。[a-zA-Z0-9._%+-]+:匹配本地部分,允许字母、数字、点、下划线、百分号、加号和连字符,至少一个字符,可重复多次。@:匹配固定的@符号。[a-zA-Z0-9.-]+:匹配域名部分,允许字母、数字、点和连字符,至少一个字符。\.:匹配一个实际的点(需转义),用于分隔域名层级。[a-zA-Z]{2,}:匹配顶级域名,必须是两个或更多字母,如com、org、net、cn等。$:匹配字符串的结束位置,确保整个字符串完全符合规则,不允许多余内容。
4.3 查找IP地址
4.3.1 IP地址构成
IPv4地址由四个十进制数构成,每个数范围在0到255之间,用点(.)分隔。
- 每个段落值必须为0–255之间的整数。
- 不允许前导零(如010、001等视为非法)。
- 必须有且仅有三个点,将四个数字段分隔开。
- 不能包含非数字字符或空格。
4.3.2 练习文本
192.168.1.110.0.0.1172.16.254.1255.255.255.2550.0.0.0256.1.1.1(超出范围)192.168.01.1(前导零,无效)192.168.1(只有三个段)192.168.1.1.1(五个段)192.168.1.1(末尾有空格)192.168.1.-1(负数)192.168.1.abc(非数字)
4.3.3 正则表达式
^(?:(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)\.){3}(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)$
解读:
^:匹配字符串起始位置。(?: ... ):非捕获组,用于分组但不保存匹配结果。(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?):匹配单个有效段落值,分为三种情况:25[0-5]:匹配250–255。2[0-4][0-9]:匹配200–249。[01]?[0-9][0-9]?:匹配0–199,支持前导零(如01、001等)——但结合整体逻辑,若要求严格无前导零,则需额外限制。
\.:匹配一个点,作为段间分隔符。{3}:前面的段落模式重复三次,对应前三个段。- 最后一个段使用相同的模式进行匹配。
$:匹配字符串结束,确保完整匹配,无多余字符。
注:该正则表达式允许前导零(如010),若需禁止前导零,应使用更严格的版本,例如:
^(?:(?:25[0-5]|2[0-4][0-9]|1[0-9][0-9]|[1-9]?[0-9])\.){3}(?:25[0-5]|2[0-4][0-9]|1[0-9][0-9]|[1-9]?[0-9])$
4.4 查找可执行文件
4.4.1 可执行文件构成
可执行文件通常具有以下特征:
- 文件名以特定扩展名结尾,常见包括:
.exe(Windows)、.app(macOS)、.bin(Linux/Unix)、.sh(Shell脚本)、.bat(批处理文件)等。 - 文件名中可包含字母、数字、下划线、连字符、点号等合法字符。
- 不允许包含空格或特殊符号(如
< > | & %等)。 - 路径可能包含目录结构,但此处仅关注文件名本身。
- 扩展名区分大小写,但在实际系统中常忽略大小写(如
.EXE也可接受)。
4.4.2 练习文本
program.exesetup.apprun.shinstall.batmyapp.bindata.exe.bak(带多个点,可能为备份文件)app.EXE(大写扩展名)script.shbad file.exe(含空格)test@.exe(含非法字符)1234567890(无扩展名)app-.exe(合法,允许连字符)_.exe(允许下划线开头)
4.4.3 正则表达式
^[a-zA-Z0-9._-]+(?:\.exe|\.app|\.sh|\.bat|\.bin|\.cmd|\.ps1|\.jar)$
解读:
^:匹配字符串起始位置。[a-zA-Z0-9._-]+:匹配文件名主体部分,允许字母、数字、点、下划线、连字符,至少一个字符。(?:\.exe|\.app|\.sh|\.bat|\.bin|\.cmd|\.ps1|\.jar):非捕获组,匹配常见的可执行文件扩展名,支持大小写敏感匹配。- 包括
.exe,.app,.sh,.bat,.bin,.cmd,.ps1,.jar等。
- 包括
$:匹配字符串结束,确保完整匹配,无多余内容。
提示:若需忽略扩展名大小写,可使用修饰符
i(如在JavaScript中使用/.../i),或在正则中加入大小写变体,如:^[a-zA-Z0-9._-]+(?:\.exe|\.EXE|\.app|\.APP|\.sh|\.SH|\.bat|\.BAT|\.bin|\.BIN|\.cmd|\.CMD|\.ps1|\.PS1|\.jar|\.JAR)$
五,结语
好啦,今天的正则表达式介绍完毕了,正则表达式需要多练习才能熟练,一定要多练习喔,不然,小心像博主一样,很容易忘记的。



