漏的从来不是主体
做 UGC 平台的内容审核,或者运营一个要大量用二创素材的团队,管线大同小异:机器过一遍敏感内容,人再抽一遍,然后放行。
出事的地方通常在角落。一张图右下角 18 像素的浅灰署名、一段视频全程挂在角上的台标、扫描件页脚的编号,人在盯主体的时候对角落是盲的。而这些恰好是版权和合规纠纷最爱钻的缝。
百炼 CLI 里的 bl vision describe 干的就是这件事:给它一张图或一段视频,加一句提问,它把画面里的文字和标识念出来。我上周拿它做了一组单变量实测,目的是确认它真的在看图,而不是顺着我的问题编一个"有水印"。这篇记录实测过程、两条可以接进管线的动线,以及我自己定的 prompt 模板与验收标准。
本机 bl 2.0.1,命令签名以 bl vision describe --help 的实际输出为准,文中四次判定都是本机实跑的结果。
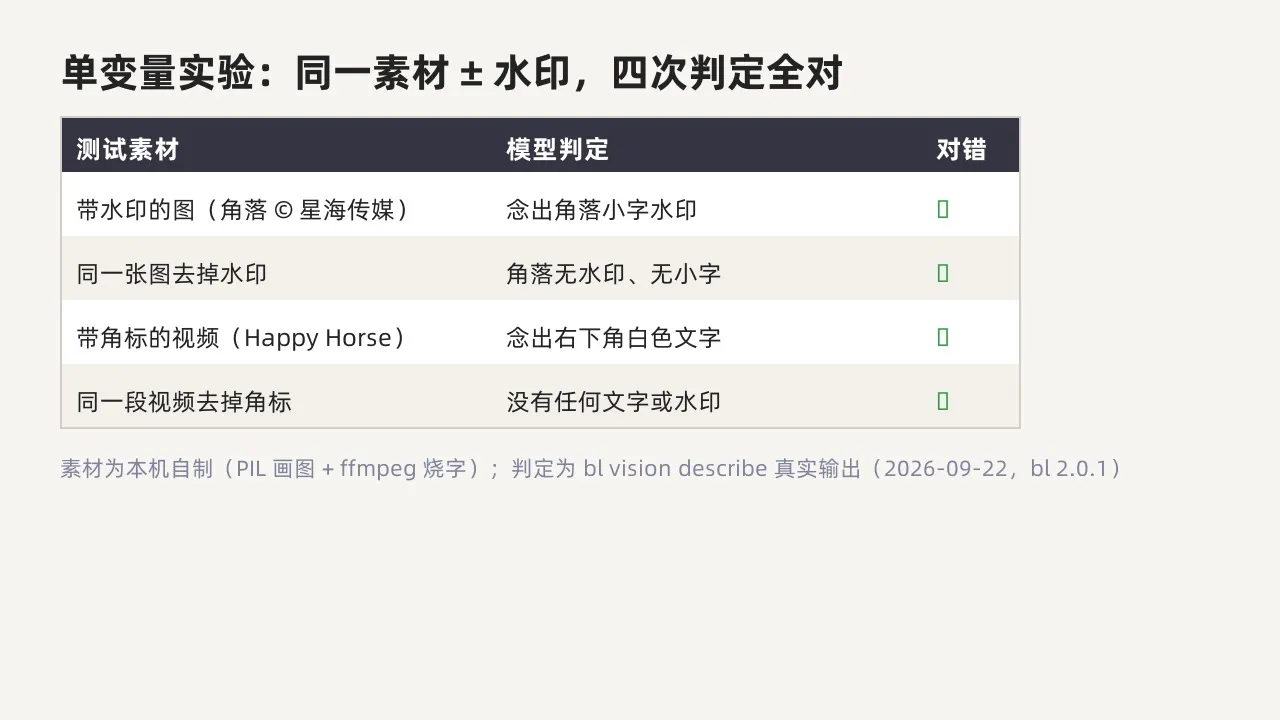
四次判定:带水印和不带水印各问一遍
要证明"真的在看",只问一张图没用。视觉模型最典型的翻车方式不是看不清,是没看也说看了。所以素材我自己做,同一张图做两个版本,同一段视频做两个版本,问同一句话。
图片用 PIL 生成 900×600,右下角埋一行 18 像素浅灰字;对照组是同一张图去掉那行字。视频用 ffmpeg 做 4 秒 640×360 灰底,drawtext 在右下角烧一行白色 22 像素角标;对照组同样去掉角标。
| # | 素材 | 提问 | 判定 | 结果 |
|---|---|---|---|---|
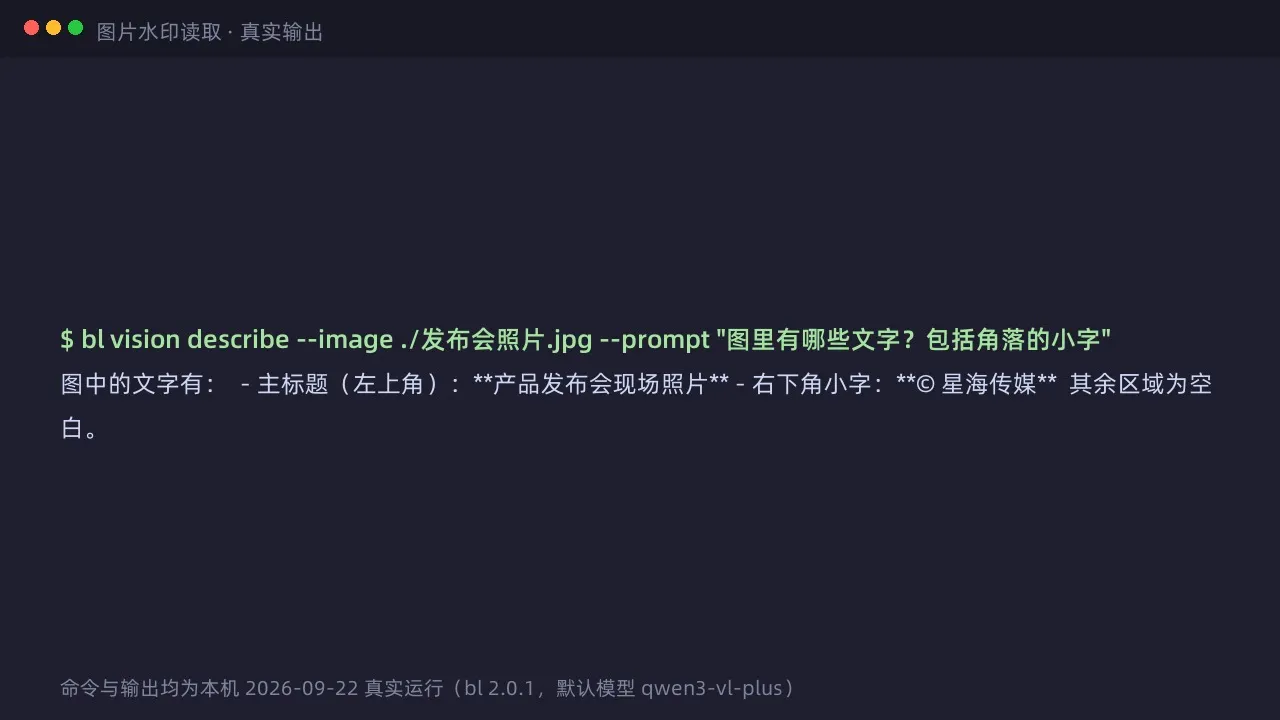
| 1 | 带水印图 | 图里有哪些文字?包括角落的小字 | 念出主标题,并单独点出右下角那行浅灰署名 | 对 |
| 2 | 同图去水印 | 同上 | 只报主标题,明确说角落无水印、无小字 | 对 |
| 3 | 带角标视频 | 视频画面里有什么文字? | 念出右下角白色角标 | 对 |
| 4 | 同段视频去角标 | 视频画面里有什么文字或水印? | 没有任何文字或水印,另附各时段的画面描述 | 对 |
四次判定零次幻觉。对照组的价值就在这里:如果它只会顺着问题往下编,第 2 和第 4 组当场露馅。
接进上传审核管线:一次提问,标签、角标、文字一起拿
图片和视频是同一条命令的两个入口,--image 和 --video 二选一。本地路径直接给,CLI 自己上传,不需要先把素材推到对象存储换外链——这一点对审核管线很重要,意味着素材不必为了"让模型看见"而多落一次盘。
bl vision describe --image ./待审素材.jpg --prompt "图里有哪些文字?包括角落的小字、水印、台标和署名"
bl vision describe --video ./待审素材.mp4 --prompt "视频画面里出现过哪些文字、角标或标识?按时间段分别说"
--prompt 不写也有默认问法,但默认问法拿到的是整体画面描述,不会替你单独点名角落。管线里用,提问必须写死。我按场景固化了三套模板:
| 场景 | prompt 模板 | 拿什么字段做后续动作 |
|---|---|---|
| UGC 上传审核 | "图里有哪些文字?包括角落的小字、水印、台标和署名" | 念出的第三方标识 → 转人工复核队列 |
| 二创素材自检 | "画面里出现过哪些文字和标识?逐个说位置" | 位置 + 内容 → 决定裁剪还是放弃 |
| 扫描件复核 | "把这份扫描件里的所有文字念出来,包括页眉页脚、印章、编号" | 页脚编号与印章 → 与正文台账比对 |
视频那条模板里"按时间段分别说"不是凑字数。视频是按帧和时段理解的,输出里会写"从某秒到某秒画面是什么",让它显式分段,角标出现的区间才有据可查,出了纠纷能拿出时间戳。
批量跑我写的是一个很土的循环,把每个文件的输出落成同名文本,方便后面 grep 和入队:
for f in ./待审/*.jpg; do bl vision describe --image "$f" --prompt "图里有哪些文字?包括角落的小字、水印、台标和署名" > "./out/$(basename "$f").txt"; done
图片和视频要分成两个循环,参数不通用(上面的循环是示意,按自己的目录结构改)。输出落成文本之后,规则层做一件很粗的事:凡是念出了第三方署名、台标、或者"角落无标识"以外的标识描述,一律进人工队列,其余放行。这层规则的召回率不需要高,它的定位是把人从"逐张看"里换出来,让人只看被挑出来的那一小部分。
这一步放在管线的哪个位置
我的建议是放在机审之后、人审之前,作为召回补充,不要拿它替代敏感内容判定。它擅长的是"把画面里的文字和标识念全",不擅长做违规分级,两件事别混在一个环节里。
同一个能力还有第二条落位,跟审核无关:媒体资产库打标。培训录像、活动回放、历史素材,用"画面里出现过哪些字"批量过一遍,把念出来的标题和标识写进检索字段。以前找一段"片头带某某活动名的回放"要靠人回忆和快进,现在能搜。这条动线跑批的风险比审核低,适合先拿它做团队内的第一次落地,把 prompt 模板和输出解析磨稳,再往审核链路上挪。
扫描件复核这条动线
法务和合规同事的日常是合同扫描件、报告截图、盖章页。他们真正要核的往往不是正文,正文人读得过来;要核的是角落章、骑缝、页码、编号这些"对不上就是问题"的东西。
把扫描件复核做成两步:先让 bl vision describe 把全篇文字连页脚一起念出来,落成一份文本;再拿这份文本跟台账里的编号、日期、盖章位置比对。比对失败的不是"模型错了",而是"这份件需要人看",直接进人工队列。
提问里要把要核的东西逐样列出来。我用的模板是"把这份扫描件里的所有文字念出来,包括页眉页脚、印章、编号"。"印章"两个字建议显式写上——真实扫描件我这组实验没测,但前面四组判定用的是同一套逻辑:提问里点名了什么,它才会单独点什么。没写进去的东西被当成图形跳过的可能性不低。骑缝章、手写批注同理。
扫描件还有个自己的变量:纸张底色和章的红色在低分辨率扫描下对比度会掉。所以接入前拿你们自己最差的十份件跑一遍,看漏多少,再决定要不要在扫描环节先把分辨率提上去。
这里有个口径要在文档里写清楚:它念的是"它看到的",不是"事实"。扫描件上如果本来就有一个错别字,它会照念。所以这条动线的定位是第一遍筛子,把明显对不上的挑出来,终审还是人。
接入前的五条验收标准
我给自己定的门槛,团队接入时可以直接抄:
- 对照组必须跑。 拿自己的真实素材做一份带标识、一份不带,问同一句话。两条都对,才算这个能力在你的素材域上成立。
- 小字下限自己标定。 我这次认出的下限是 18 像素浅灰。你的素材是压缩过的手机图、是低分辨率监控截帧,下限就不一样,得自己拿几档字号试出来,写进文档。
- 视频输出必须带时段。 没有时间戳的"有角标"没法追责也没法复核。
- 人工终审不可省。 命中第三方标识、命中编号不一致,一律转人。模型在这里的角色是提高召回,不是替代判断。
- 判定要留痕。 四组对照的原始命令和原始输出存档,写进接入评审材料。半年后有人问"当初凭什么信这一步",能拿得出东西,而不是靠某个人的记忆。
默认模型是 qwen3-vl-plus。想换别的视觉模型加 --model,但换完之后上面五条要重跑一遍——我这组结论只在默认模型上验证过。参数签名不确定时以本机 bl vision describe --help 的输出为准,别照抄博客。
边界,写进接入文档那种
18 像素浅灰这档认得出,再小、再淡、跟背景对比度更低的,不保证。视频端同理:我的测试角标全程在画面上,所以稳;一闪而过的半秒角标不一定抓得住,这类素材别只依赖一次调用。
还有一条容易被忽略:--image 和 --video 是按素材类型二选一的,不要指望一条命令同时吃图和视频。批量管线里先做类型分流,再分发到对应参数。视频格式这边确认过的是 mp4、mov、avi、mkv、webm。
上手
npm install -g bailian-cli
bl vision describe --image 你的素材.jpg --prompt "图里有哪些文字?包括角落的小字"
Key 在控制台密钥管理页创建(地域选华北2 北京),命令文档和安装说明在阿里云百炼 CLI(bl)。团队用的话凭据走统一的密钥设施,别把 Key 写进批量脚本或者提交进仓库。
接入前建议先做一件小事:从你自己的素材库里挑十张已经发出去的图和两段视频,各跑一遍上面那套模板,把念出来的第三方标识跟当时的审核记录对一下。差多少,管线该补在哪一步,看一眼就有数了。