1. 从 Milvus 到 Eagle
曾经,搜索只会匹配文本,你搜"红色连衣裙",它找的是这五个字,如果要检索大量图片,那么就需要先对图片进行全量打标,数据总量难以上规模。而今天,大模型把文本、图像、音频、视频统统编码成了同一高维向量空间里的向量,通过向量近似检索能力,我们终于能直接搜索多模态数据本身。于是检索的形态被彻底改写:以图搜图、以文搜视频、用一句话在数亿段视频里找到那一帧——多模态与跨模态的相似度检索,成了 AI 应用的地基。 大模型的记忆(RAG)、推荐系统的召回、以图搜商品、内容风控、自动驾驶的场景检索,底层跑的都是同一件事:在海量高维向量里,找出最相似的那一批。
而这件事的关键就在性能和性价比。打标方案把复杂度留在数据准备环节,如果向量检索太慢,延迟敏感的场景就无法替代打标方案。如果向量检索方案过于昂贵,对于利润率不够高的业务,就无法拥抱相似度检索的便利。召回率、吞吐、成本,任何一环塌了,上层的 AI 应用就塌了。 性能和性价比,是向量检索这门技术真正的分水岭。
在这条赛道上,Milvus 是绕不开的名字——全球下载量领先、社区最活跃的开源向量数据库之一,是无数 AI 团队构建检索系统的默认起点。正因为开源 Milvus 足够优秀、足够被信任,阿里云在2024年就推出了阿里云 Milvus,把开源软件的能力,做成企业级的稳定、弹性与托管的平台服务。
今天,我们要宣布的是,站在milvus的巨人肩膀上,阿里云 Milvus 再往上迈了一步,正式推出自研内核 EAGLE。
2. 向量检索的性能 SOTA,我们自己造
Milvus 本身是一款非常优秀的开源软件,原生也提供了丰富的索引选择,可以支持全内存的性能型索引,也支持基于SSD+内存的容量型索引。通过数据的各种量化算法,在牺牲部分查询精度的情况下,哪怕是同样的索引算法,我们也有不同的资源规模可以选择。
在完全兼容 Milvus 开源生态的基础上,EAGLE 内核是我们团队结合阿里云的软硬件做了大量深度优化的产物。我们把已有的优化都发布出来,敢跟业界所有向量检索解决方案比比性能,在同等资源、同等召回率的前提下,看看谁的延迟小,谁的吞吐高。
业界的数字游戏,我们太清楚了:同一套硬件,把召回率从 99% 悄悄调到 95%,QPS 翻倍是常事;把测试查询换成结果缓存命中的那几条,吞吐能再翻50倍;把召回率从一次跑法里摘出来、把 QPS 从另一次跑法里摘出来,拼进同一行表格——一份"遥遥领先"的成绩单,就这么诞生了。
一份向量检索的性能数据递到你面前,先问这五个问题。
问题一:召回率呢?而且,是拿真值算的吗?
任何不写召回率的 QPS 都是耍流氓——它可能只是把准确度偷偷卖了换来的速度。更进一步:这个召回率,是拿暴力检索的真实近邻(ground truth)比出来的,还是拿它自己的近似答案自我验证的?后者可以把召回率印成任何数字。没有真值背书的召回率,和没有召回率,是一回事。
问题二:这一行数字,是同一次跑出来的吗?
一行数据里的召回率、QPS、延迟、参数,必须来自同一次测试、同一组参数、同一个并发。最常见、也最难被外行识破的障眼法,就是把高召回率那次的准确度,和低召回率那次的吞吐,拼进同一行。分开跑、拼一行,是这个行业最体面的造假。
问题三:参数敢全部公开吗?
引擎版本、选择的索引类型、搜索候选列表大小、TopK、并发数、副本数、硬件规格、CU——这些参数少一个,数字就少一个分母。一个不敢把参数摊开的 QPS,等于一个不敢说单位的物理量。
问题四:换个数据集,还成立吗?
性能不是一个点,是一条曲线。在单一数据集、单一档位上取到的"最优",往往是精心挑过的那个最好看的点。真正可信的数据,是在多个数据集、多个数据规模、多个 TopK 档位上都站得住的一整片,而不是一根被单独拎出来的针。
问题五:这个数,讲得通物理吗?
向量检索的每一分性能都有它的成本代价,这是算法层面的规律,不因引擎而改变:尤其是深度优化到计算瓶颈的引擎,TopK 从 10 涨到 100,召回率不变,则要使用更大的ef参数,维护更大的候选堆、算更多距离,吞吐必然下降;搜索候选列表扩大若干倍,每次查询的计算量就翻若干倍,吞吐必然同比回落。如果一个数字违背了这些规律——多取十倍结果却几乎一样、候选池翻几番而吞吐纹丝不动——它要么背后有一个违背物理规律的解释,要么它就是假的。违背物理的漂亮数字,比难看的真实数字危险得多。
我们的做法很简单:全部用业界通用的开源基准工具 Zilliz VectorDBBench,选择不同的数据集,每一个数字的参数、配置、脚本全部公开。
3. 全内存方案,快到没有对手
分别基于 BioASQ 10M 和 Cohere 768D10M 的数据集,我们测试了 TopK=10 和 TopK=100 的场景,这种5-100的召回也是我们在客户实际使用中看到最常见的召回量。使用阿里云 Milvus 性能型实例的 AUTO INDEX,就可以获得全内存方案的极致性能。下面我们展示使用阿里云 Milvus 单机性能型实例测试的结果,测试实例为阿里云 milvus 单机性能增强型64CU的实例。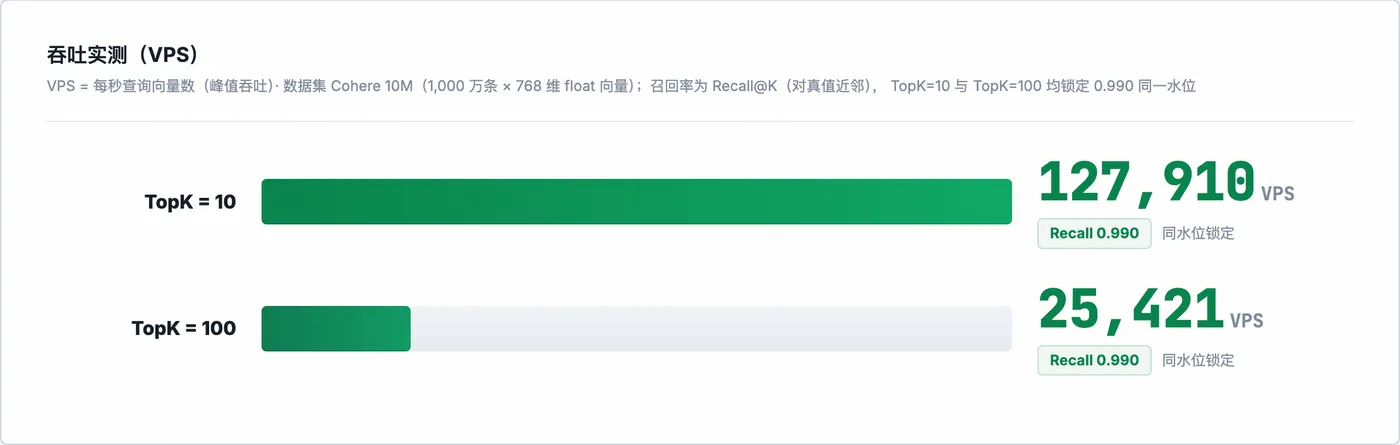
官方榜单以$1000月费为基准,我们选择阿里云 milvus 单机性能增强型32CU的实例,实测得到的结果也放在图表里,同样断层领先: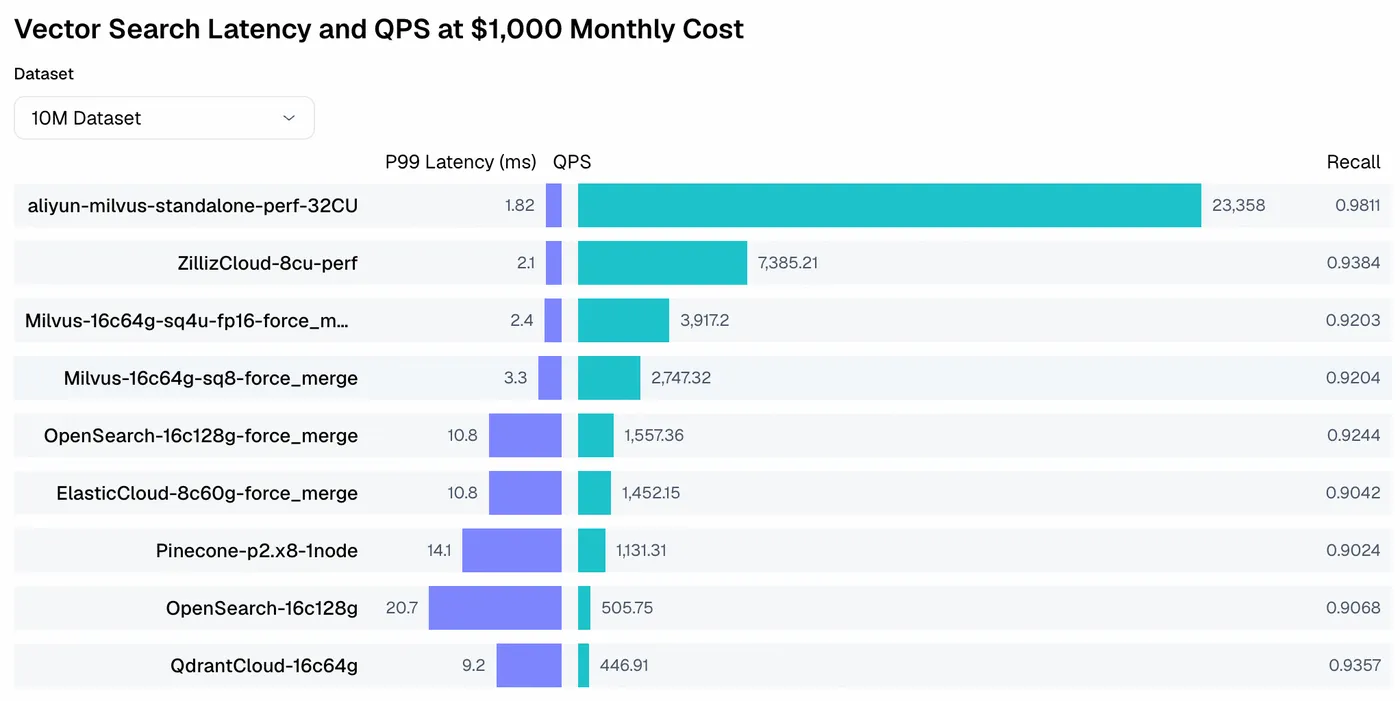
可以看到,阿里云 Milvus 的 EAGLE 内核真正重造了向量检索的性能天花板。
4. 性价比方案,还是快到没有对手
数据从千万涨到亿级,成本压力比性能来得更早。内存在整个系统的成本中占比很高,全内存方案决定了成本会翻十倍。而 DiskANN 索引最初的推出,正是为了能够在数据量上了一个数据集之后,依然能够保持检索成本可控。我们在阿里云 Milvus 的容量型集群和容量型单机版实例的 AUTO INDEX 中,针对容量型的场景,给出了我们的答案。
我们把 DiskANN 和 RaBitQ 做了深度融合改造:用 1bit/4bit 量化把内存里的向量副本压到原来的 1/32,再用图结构的内存重排布,把磁盘上的随机读收敛成顺序读。相比开源实现,吞吐提升 20 倍以上,P99 降到 1/10 以下,QueryNode 内存再省 29%,召回率仍在 98% 以上——这组数字与完整技术拆解,我们之前已经介绍过,现在,我们不妨和商业化的竞品再比比性能。
这里,我们选择 Laion 100M 的数据集。先看看topK=100的常规场景,阿里云 Milvus 三项指标全优: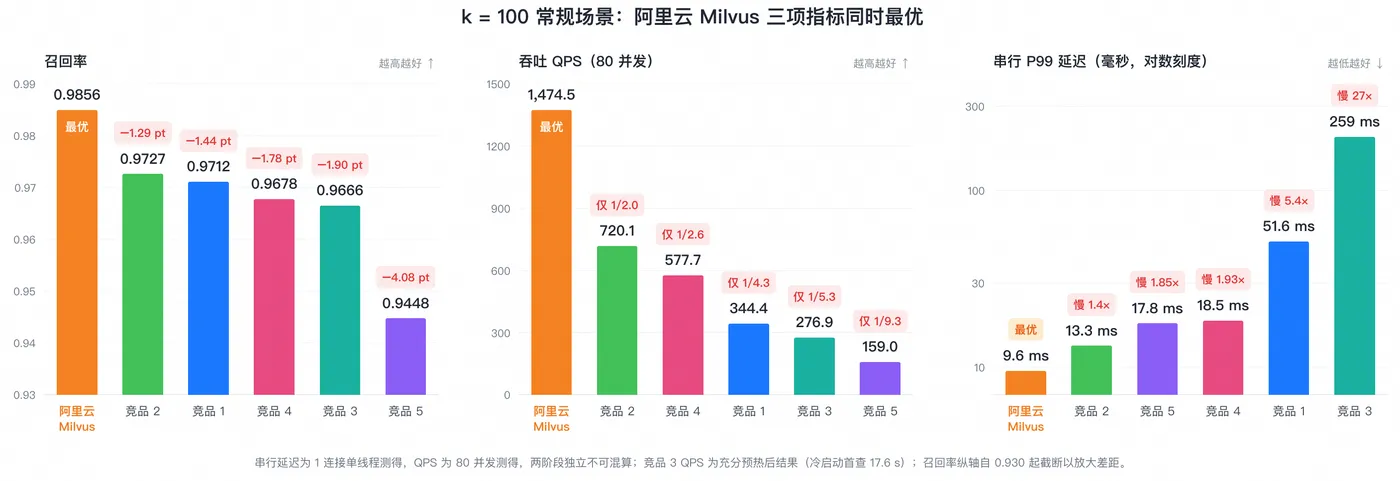
再看看如今火热的大 topK 场景,这在提取训练集、测试集等场景中很常见。我们以 K = 100万为例,竞品们一大半都倒在门槛前,连跑得慢都谈不上,是完全无法支持这样的场景。在仅有的两个竞品面前,阿里云 Milvus 依然在性能方面遥遥领先: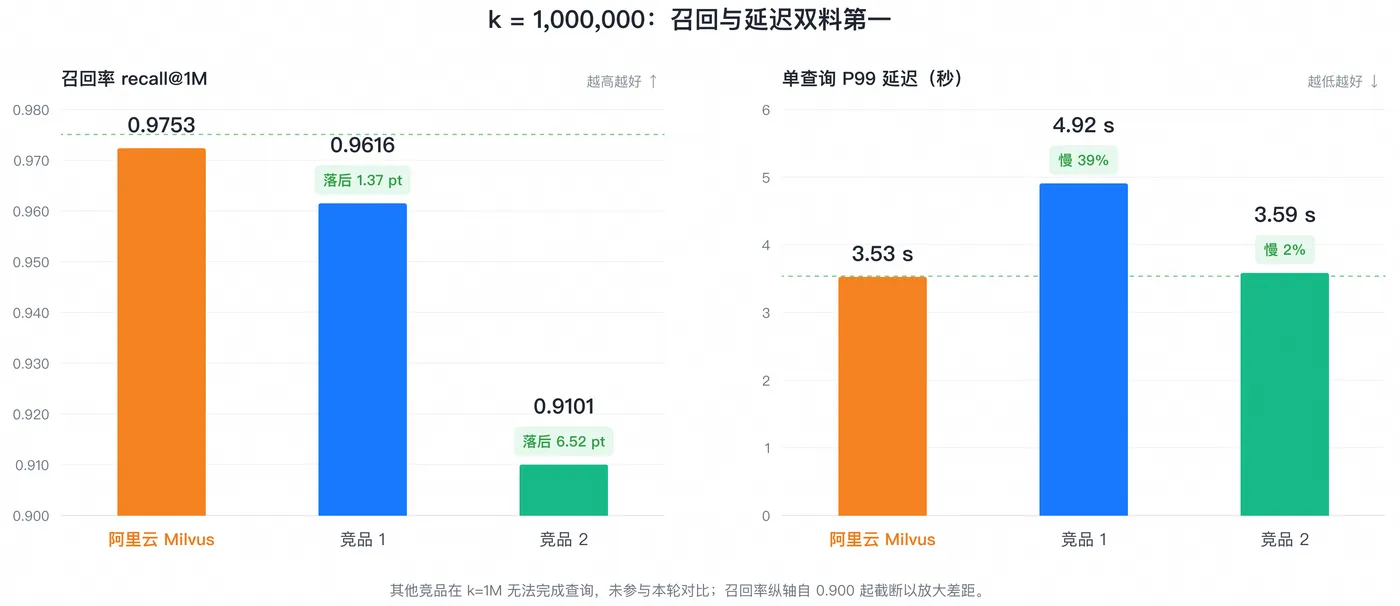
Eagle 的召回率最多领先 6.52 个百分点——在百万级结果集上,意味着多找回约 6.5 万条本该被找到却被漏掉的近邻,同时 P99 延迟最高低 28%。
有人会问:这两个场景能兼得吗?当然可以!开启大 TopK 优化的方式只是一个 collection 属性开关,无需重建索引,无需重新加载,也不影响小 TopK 的性能。
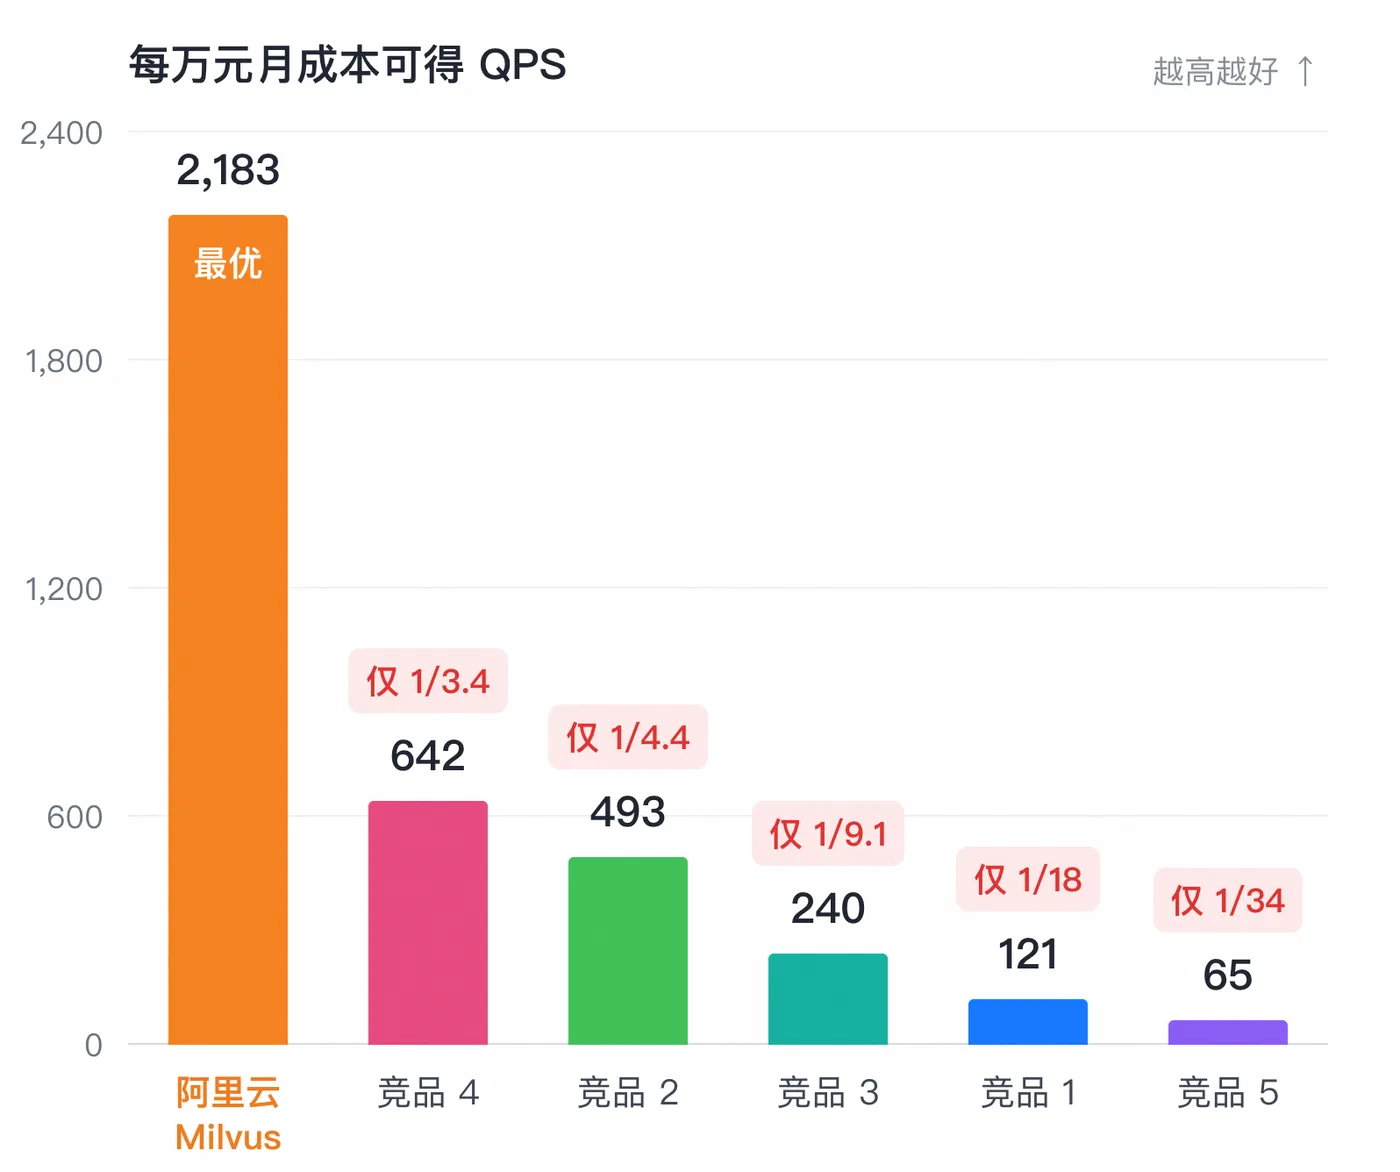
而在如此的数据规模下要实现这样的性能,仅仅需要开通阿里云 Milvus 单机容量型的 32CU 实例,集群计算费用的目录价仅仅需要6752元/月,跟上面的竞品形成鲜明对比: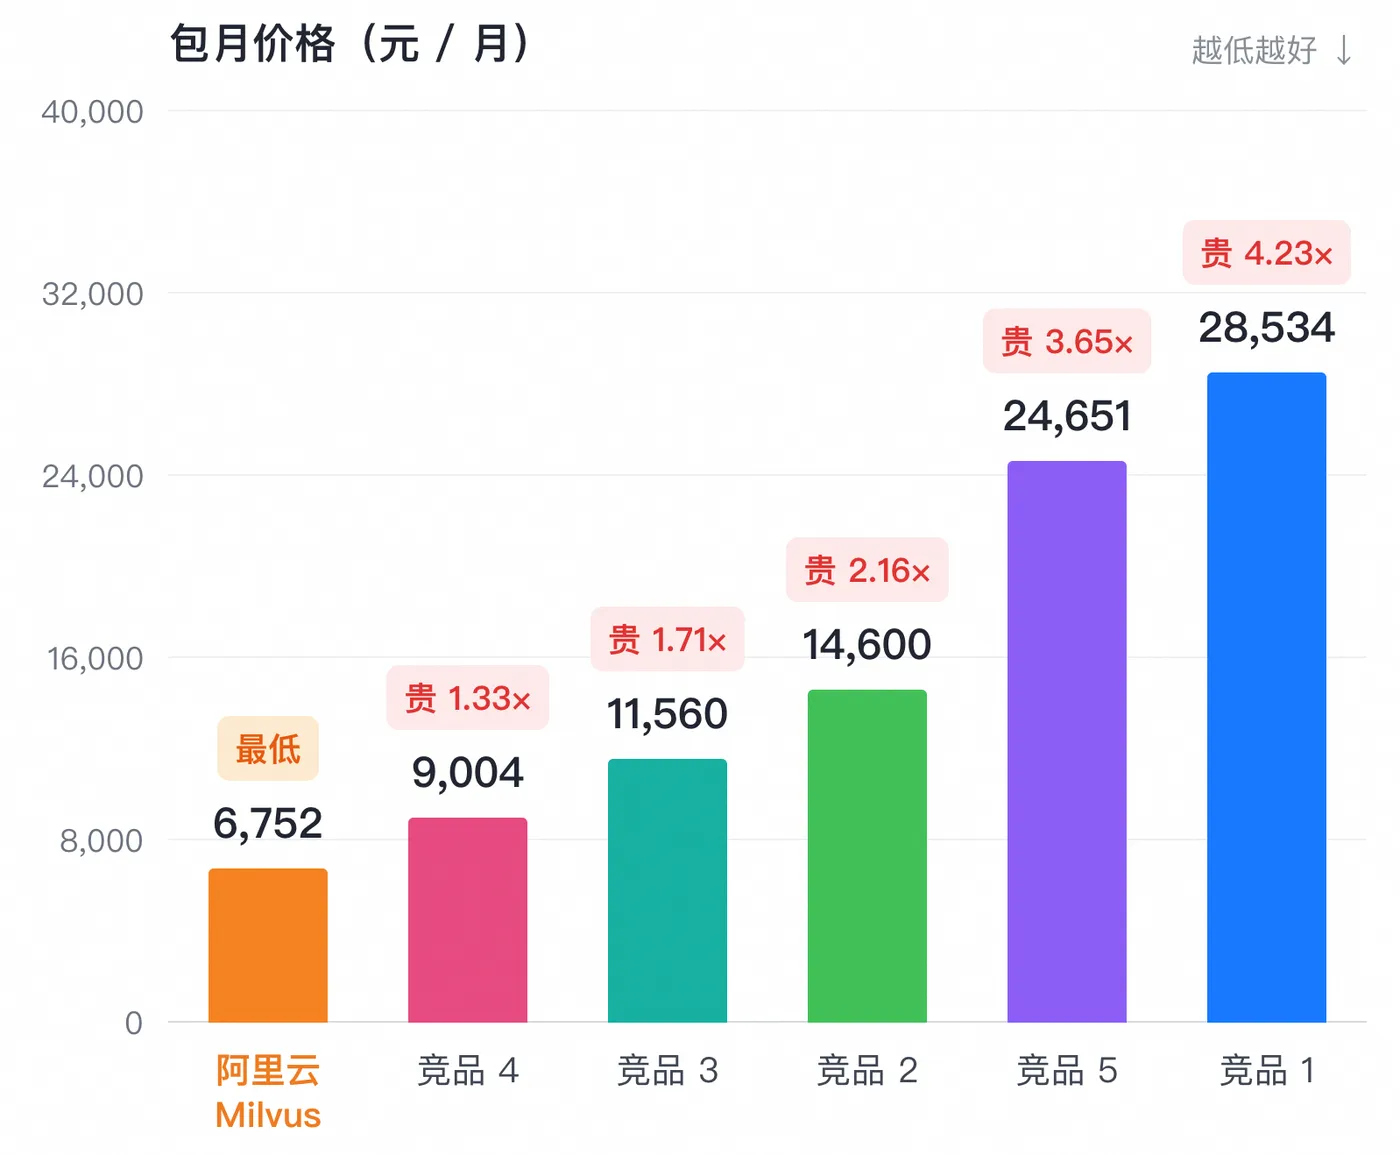
5. EAGLE,永远不会停下
EAGLE 是我们阿里云 Milvus 的长期路线,在AI发展日新月异的今天,向量检索的能力发展同样非常迅速。比如,我们后续还会推出分层存储型集群,进一步提供极致性价比,为十亿以上的数据提供极低成本的向量检索方案。不断优化索引性能,提供更丰富的搜索语义,支持更好的数据时效性,全面提高读写吞吐,都是EAGLE 将投入的方向。
关于更多EAGLE性能优化的技术细节,具体的数据复现方式,我们也会在后续文章中逐步披露。
6. 最后
向量检索"能用就行"的时代结束了,接下来的竞争,是在召回率不退让的前提下,把性能和成本同时逼到极限。而在比谁更强之前,要理解向量检索的三角形:吞吐、召回率、成本。当我们把框架和算法优化到极致的情况下,在向量检索三角形上结合自己的业务选择最合适的产品,才是明智之举。
内存装得下的时候最快,内存装不下的时候还是最快,这是阿里云 Milvus Eagle 1.0 内核交出的答案,我们把它放在这里,也把尺子放在这里,欢迎大家来实测重现。