
本文由 阿里云国际站代理商『翼龙云✈️✈️✈️TG- @Yilongcloud 撰写』如需转载请注明!
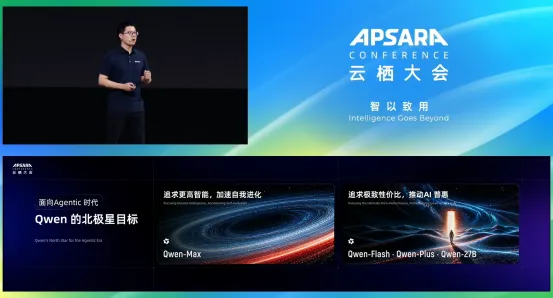
在 2026 年阿里云云栖大会上,通义千问(Qwen)明确了其技术演进的“北极星目标”:向上突破智能上限以通往通用人工智能(AGI),向下扎根工程实践以实现极致性价比。这一双轮驱动战略不仅决定了模型本身的迭代方向,也为企业构建 AI 架构提供了参考。
一、向上突破:以 AGI 为目标的智能上限探索
追求智能上限意味着 Qwen 在算法创新、基座规模及复杂认知任务上持续突破边界,重点提升逻辑推理、多模态理解与自主 Agent 协同能力。
架构深化与 Scaling Law 的新阶段
传统的稠密模型在参数规模跨越千亿后,常面临显存带宽与计算成本的瓶颈。Qwen 通过深化稀疏激活(MoE)设计来应对:
动态路由专家网络:利用门控机制,在控制单次激活参数量的同时,将总参数量扩展至数千亿甚至万亿级。Qwen3-Max 作为旗舰模型,总参数量超过 1 万亿,预训练数据量达 36 万亿 tokens,其 MoE 架构设计实现了训练损失的平滑稳定收敛,无需回滚策略或数据分布调整。PAI-FlashMoE 的多级流水线并行策略使训练效率显著提升,MFU 相对前代提高 30%。 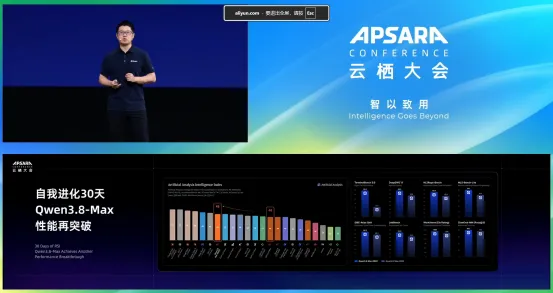
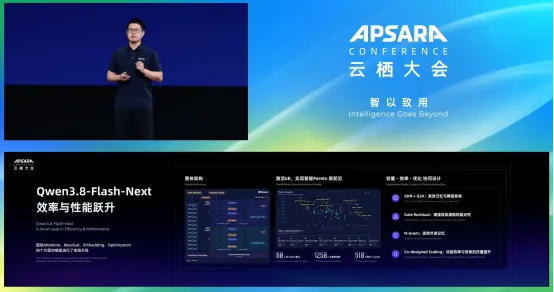
长上下文与动态注意力:Qwen3.8-Flash 采用 GDN(Gated DeltaNet)+ QSA(Qwen Sparse Attention)混合架构,在 1M token 超长上下文下,QSA 的 Attention Kernel 在 Prefill 和 Decode 阶段分别实现最高 7.6 倍和 4.9 倍加速。Qwen3-Max 通过 ChunkFlow 策略实现 1M token 上下文长度训练,吞吐量相较上下文并行提升 3 倍。
强化复杂推理与自主思考
AGI 的核心在于处理非结构化问题时的逻辑推导。Qwen 在后训练阶段引入了系统性的过程监督:
思维链与强化学习融合:引入过程奖励模型(PRM),验证推导路径中每一步的合理性,而非仅关注最终答案。Qwen3-Max-Thinking 在推理基准 AIME 25 和 HMMT 上达到 100 分,展示了测试时扩展(test-time scaling)与工具调用的协同潜力。
Agent 环境交互:模型从文本生成器演变为可感知环境、规划步骤并调用外部 API 的智能体系统。Qwen3-Max-Instruct 在 Tau2-Bench 智能体工具调用评测中得分 74.8,超越 Claude Opus 4 和 DeepSeek V3.1。Qwen3.8-27B 在智能体终端编程能力 Terminal Bench 2.1 中得分 73.0,在智能办公自动化基准 CoWorkBench 上取得 70.7 分,超越 Opus 4.6 Max。
二、向下扎根:追求工程极致与普惠落地
高阶智能必须转化为合理的交付成本,才能进入生产环境。Qwen 的第二大方向聚焦于降低训练与推理门槛。
结构性降本与多尺寸模型矩阵
并非所有任务都需要超大模型。通过知识蒸馏与高质量数据提纯,Qwen 衍生出从 0.5B 到数千亿参数的多种规格。中小参数模型在特定场景下可逼近大尺寸基座的性能,显著降低了算力门槛。Qwen3.8-27B 这款 270 亿参数的稠密多模态模型,在 SWE-bench Pro 上以 61.7 分领先自家更大的 Qwen3.7-Plus(57.6 分),在 GPQA Diamond 科学推理基准上得分 89.2。Qwen3.8-Flash 主模型参数量 125B,每 token 仅激活 6B 参数,训练成本仅为前代的 1/9,API 定价为每百万 tokens 输入 1 元、输出 3 元。
推理系统工程优化
推理成本是企业关注的焦点。Qwen 通过软硬件协同实现加速:
量化与压缩:支持 FP8、INT4/INT8 等低精度量化,在保持精度的同时降低显存需求,提升单卡并发。Qwen3.8-Flash 的 N-gram Embedding 参数可卸载至 Host Memory,通过异步 Prefetch 与模型计算重叠,不长期占用 GPU 显存。
解码算法优化:采用推测解码(Speculative Decoding)与 KV Cache 压缩策略,降低首字延迟(TTFT)并提升 Token 吞吐率。Qwen3.8-Flash 采用 Gated Residual(GR)机制,残差状态支持 FP8 存储,大幅降低访存开销。
三、演进逻辑与生产落地误区
极致智能与普惠落地互为支撑:超大规模基座负责知识沉淀与能力突破,通过蒸馏转化为高能效的中小模型,再从行业应用中收集反馈,推动基座迭代。
在落地实践中,需注意以下误区:
盲目追求大参数:在摘要、分类等常规场景中,中小模型配合 RAG(检索增强生成)往往更具性价比。Qwen3.8-27B 在多项基准上超越更大规模模型的事实表明,架构效率与训练质量比单纯参数量更重要。
忽视工程优化:大模型推理对显存带宽极度敏感,单纯堆砌 GPU 若不配合 PagedAttention 或连续批处理技术,资源利用率将十分低下。
缺乏系统编排:模型权重只是起点,实现高可用服务需依赖弹性的容器集群调度。
四、云端标准化部署架构
支撑 Qwen 系列模型运行的规范方案通常采用分层架构:底层依托 Elastic GPU Service 提供异构算力,编排层则通过 Container Service for Kubernetes (ACK) 保证韧性。
算力层:Elastic GPU Service
选型匹配:千亿级模型精调需高带宽互联的 GPU 实例;中小模型推理则侧重显存容量与性价比的平衡。
硬件加速:利用 Tensor Core 算子加速与显存共享技术提升单节点效率。
目前新增集群优先采用 ACK Managed 托管形态。
弹性伸缩:基于请求队列长度或延迟指标,动态扩缩 GPU 节点与 Pod。
精细化调度:利用拓扑感知调度与 GPU 切分能力,提升资源装箱率,减少显存闲置。
值得注意的是,ACK 的 GPU 自动隔离机制已从“默认启用”变更为“按配置触发”。自 ACK NPD 1.2.35 与 ACK NVIDIA Device Plugin 0.7.0 版本起,GPU 自动隔离默认禁用,需用户显式配置触发条件方可启用。此变更仅适用于 Kubernetes 1.32 及以上版本的集群。
五、常见问题解答(FAQ)
Q1:2026 云栖大会提出的通义千问 Qwen 北极星目标两大方向具体指什么?
答:一是追求模型能力的极致与智能上限,通过大规模 MoE 架构、过程监督模型等技术探索 AGI 路径;二是追求普惠与工程极致,通过小尺寸模型矩阵、量化与高效解码技术,降低大模型在行业的应用成本。Qwen3.5 以 3970 亿参数实现原生多模态突破,API 成本仅为同类产品的 1/18,正是这一双轮战略的典型体现。
Q2:部署和推理通义千问 Qwen 开源系列模型时,推荐使用哪些云产品?
答:底层计算推荐使用 Elastic GPU Service 提供 GPU 算力支持;上层容器化编排推荐使用 Container Service for Kubernetes (ACK)(新建集群建议选择 ACK Managed 模式),以实现资源调度与自动弹性伸缩。
Q3:在企业落地通义千问模型时,常见的技术与认知误区有哪些?
答:常见误区包括:唯参数量论,忽视了中小模型在特定场景的性价比;认为增加算力即可解决所有性能问题,忽视了推测解码、KV Cache 压缩等工程优化;忽视了云原生架构在多实例负载均衡与弹性扩缩容中的必要性。Qwen3.8-27B 以 270 亿参数在多个基准上超越更大模型的表现,充分说明架构设计与训练质量的关键作用。
