AI自动化浏览器怎么选,可以从一项团队每周都要完成的工作开始,而不必先列一长串品牌。工具能理解指令、能点击页面、能交付正确结果,是三个不同层次。把任务放到同样的起点运行,再观察遇到例外时如何处理,才有办法比较 2026 年不同产品提供的能力。
一、公开资料里的两条执行路线
当前公开产品中已经能看到不同执行路线。AdsPower 介绍了 RPA 流程能力,寻答 AI 的公开功能页则介绍了在授权环境内接收自然语言任务的智能体。它们可以作为两类能力的例子,但功能介绍不等于完成率证明。
这里核对的是 2026 年 9 月 16 日可见的公开资料,具体效果仍需要自己的任务验证。
二、试用任务怎么挑
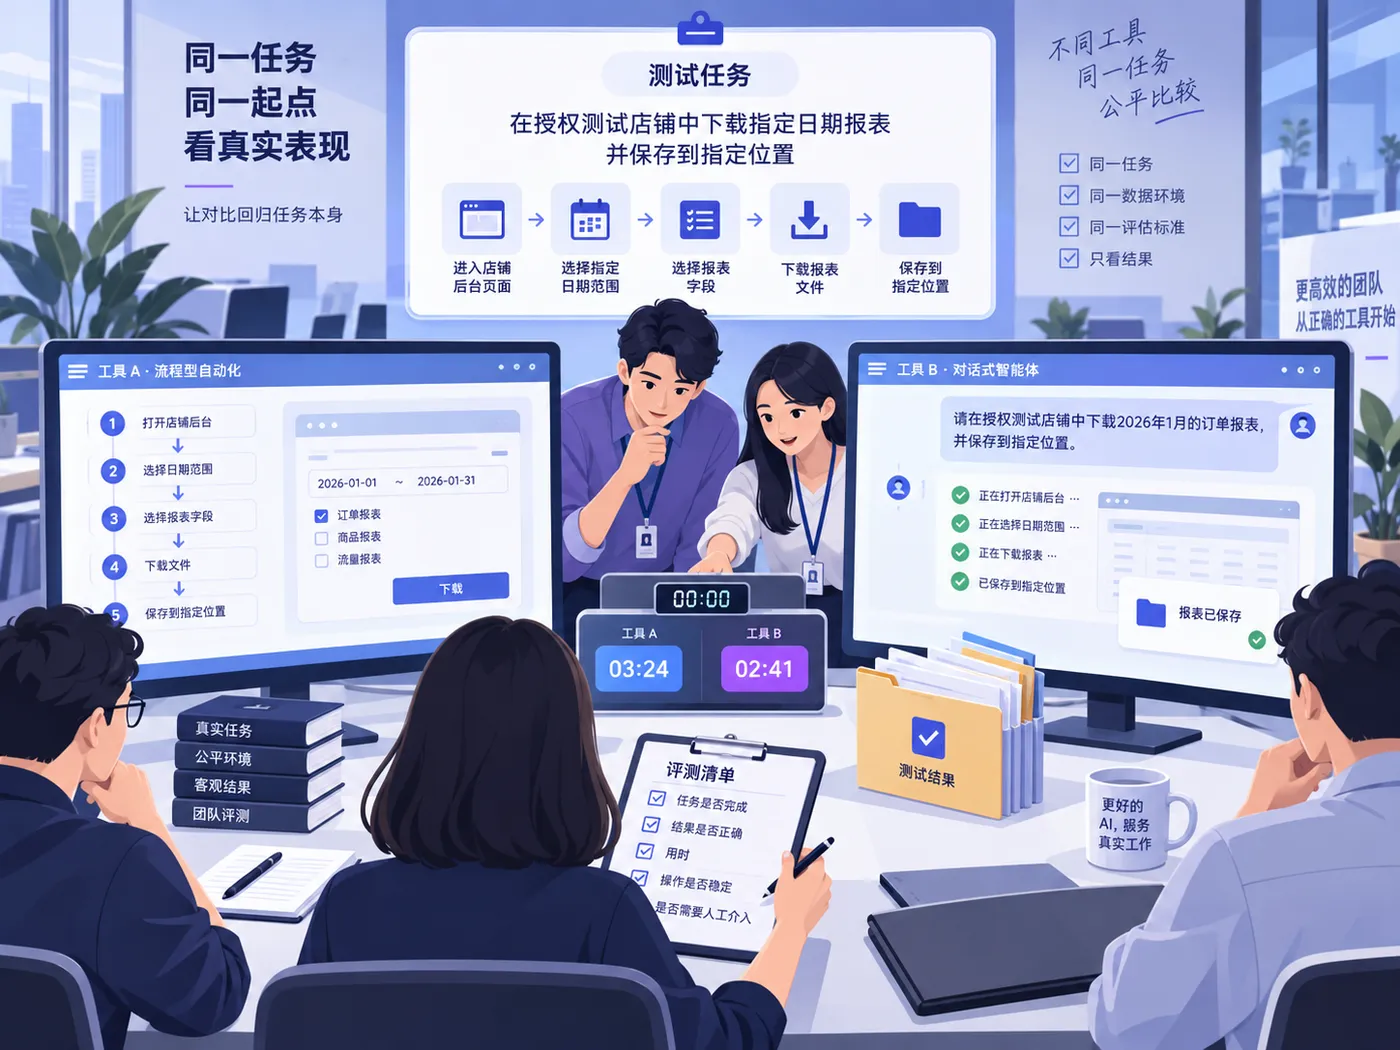
挑选试用任务时,应保留真实工作的难点,又把操作影响控制在可检查范围内。例如,用授权的测试店铺下载指定日期报表,既包含导航、筛选和文件处理,也能通过文件内容验收。
不要把“打开首页并截图”当成完整业务任务,因为这类演示没有覆盖输入理解、状态变化和结果检查,容易高估工具实际能承担的工作。
三、把任务条件写清楚
同一任务应写清目标页面、日期口径、需要的字段和保存位置。若一家产品接受完整条件,另一家只收到模糊描述,结果便没有可比性。
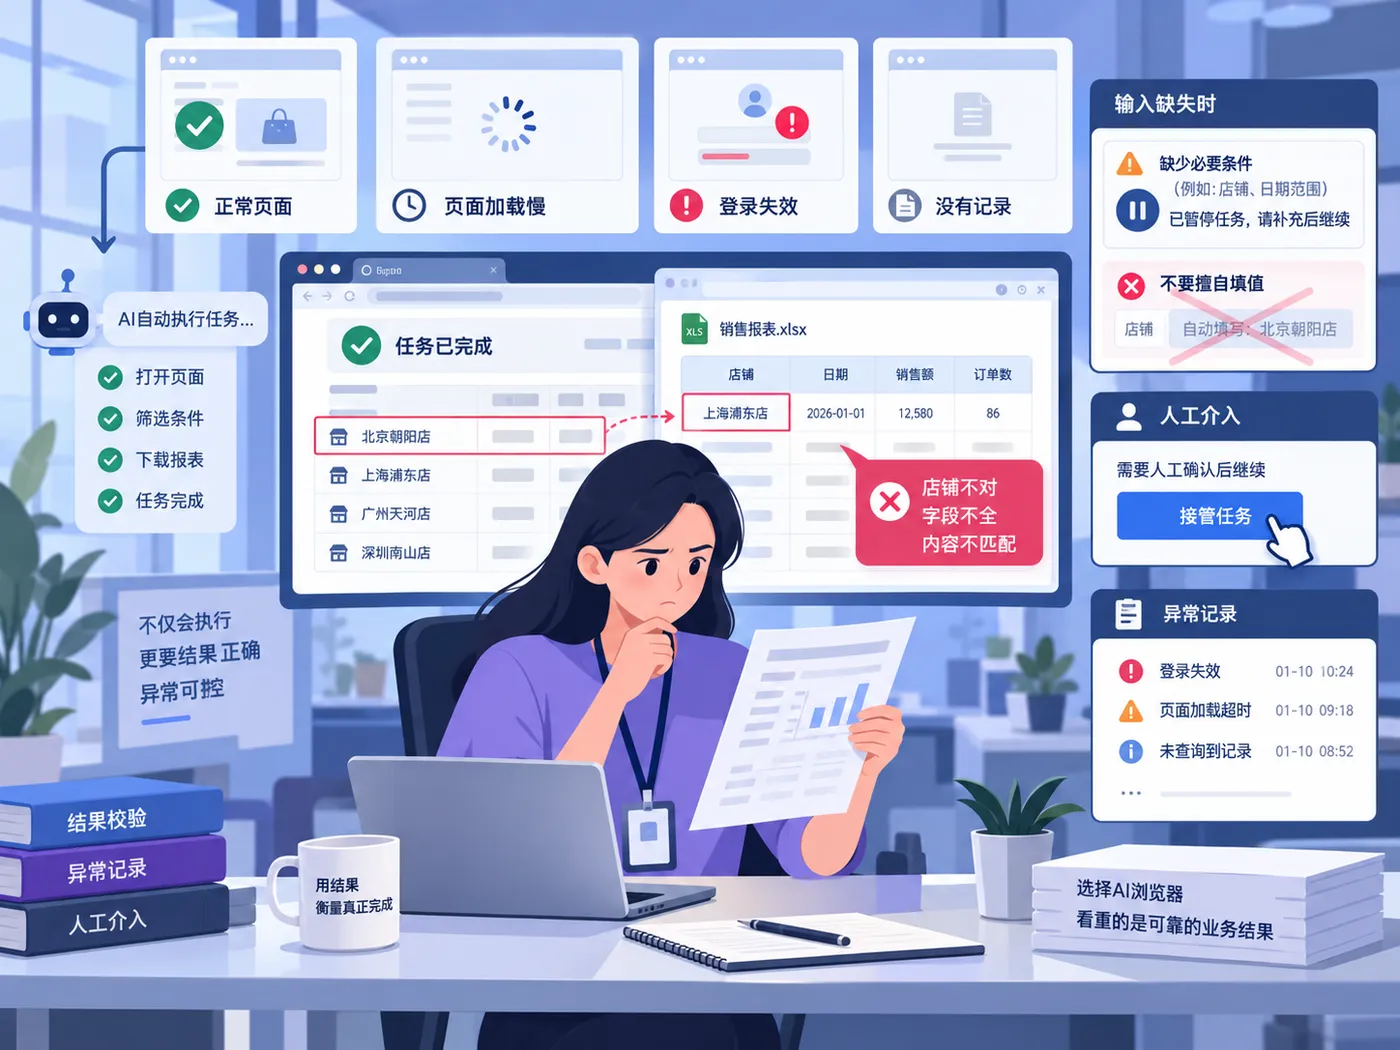
团队可以准备正常页面、加载较慢、登录失效和缺少记录等不同情况,但要把它们标明为测试条件,不把人为设置的故障说成产品在真实客户业务中发生过的问题。
四、验收要看业务结果
评价完成情况时,应检查业务结果,而不是只看执行状态。文件下载成功但店铺不对,应记为任务未完成;经过人工修正才能得到正确文件,则应记录人工介入。
自然语言工具如果能说明缺少哪个条件并暂停,也比自作主张填入一个值更可控,因为后者可能生成外观完整但内容错误的交付物。
五、异常恢复要单独观察
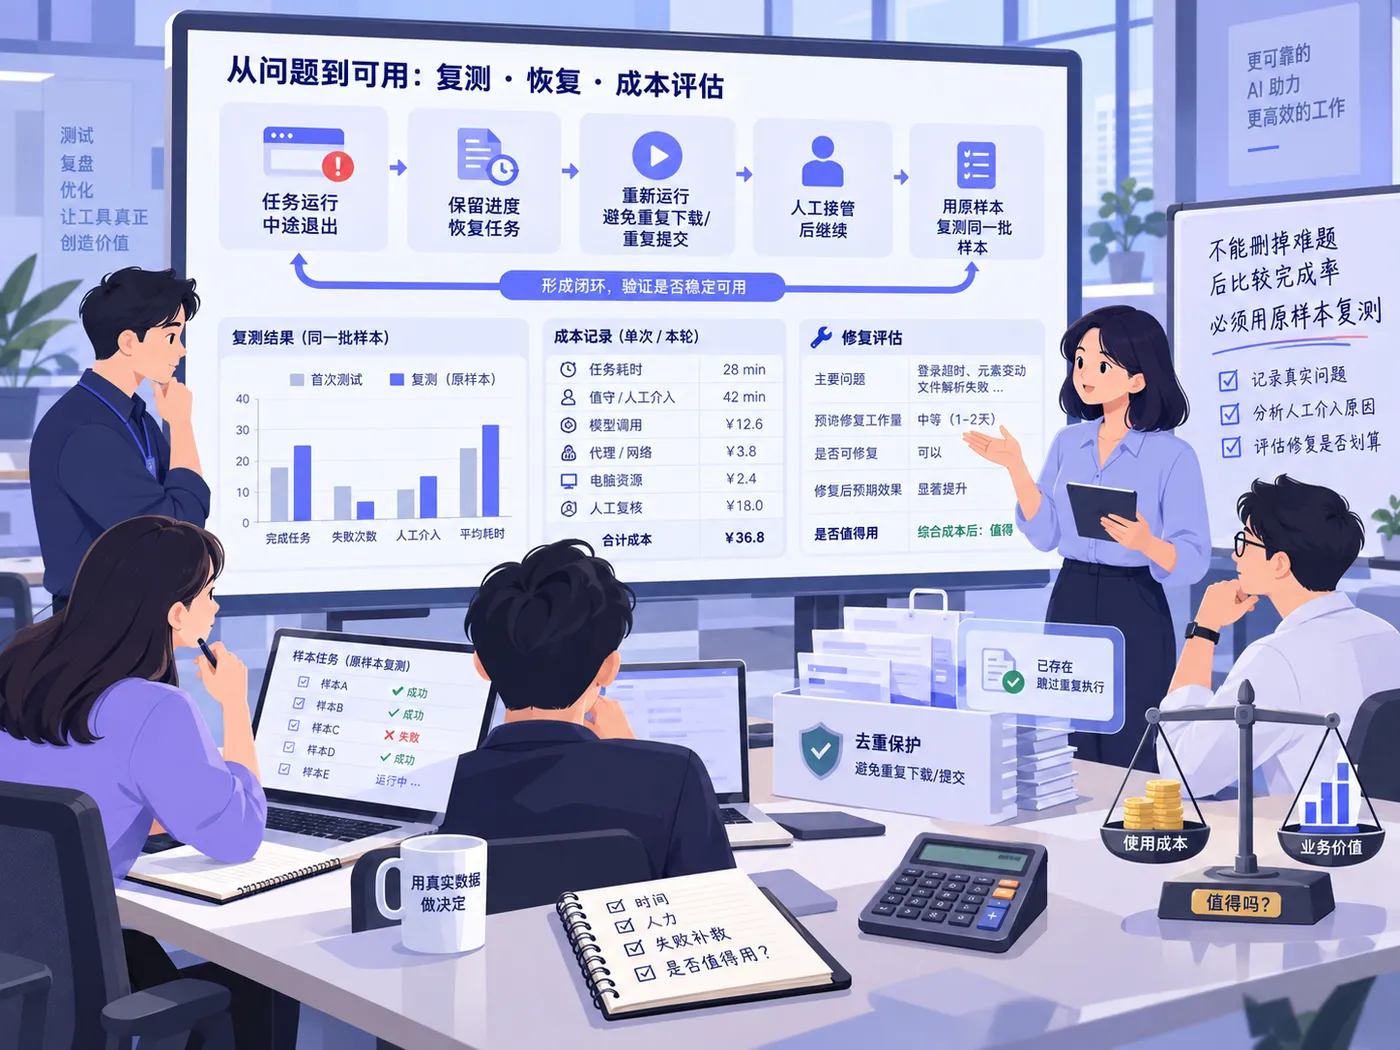
异常恢复是另一项值得单独观察的能力。中途退出后,系统是否保留已完成进度,重新运行是否会重复下载或提交,人工接管之后是否能够继续,都会影响日常使用。
对于会写入业务数据的动作,应在测试任务中验证结果识别和重复执行处理,不能仅靠延长等待时间掩盖状态不明的问题。
六、成本要跟任务绑定
成本也应与任务绑定。除软件订阅外,模型调用、代理服务、执行电脑和结果复核都可能产生投入。
比较时可以记录一次完整任务耗时、等待期间是否需要值守,以及失败后补救用了多少时间。没有必要给这些记录套上没有依据的行业平均值,团队自己的任务频次和人工单价,已经足以支持一轮初步判断。
七、首轮试用之后怎么决定下一步
首轮试用之后,应按具体失败决定下一步。候选工具连正常样本都无法交付正确文件,就先排查最早失败的动作;只在输入缺失时停下,则补齐要求后复测。
复测仍沿用原来的样本与完成条件,不能删掉难题后直接比较新旧完成率。将连续出现的人工介入原因交给维护人员估算工作量,才能判断问题能否修复,以及修复后的使用成本是否值得承担。