1. 引言
介绍 Codex 作为 AI 编程助手在运维场景中的价值,说明为什么运维工程师需要掌握用 AI 编写脚本的方法,以及本文的阅读收益。
2. Codex 与运维脚本基础
简要介绍 Codex 的核心能力,以及运维脚本的常见类型(部署、监控、日志处理、批量操作等),帮助读者建立整体认知。
测试内容:
加粗字体 斜体 删除线 下划线
颜色字体, 文字背景
块级引用
| column1 | column2 | column3 |
|---|---|---|
| 1 | 2 | 3 |
| 21 | 22 | 23 |
3. 环境准备与工具链
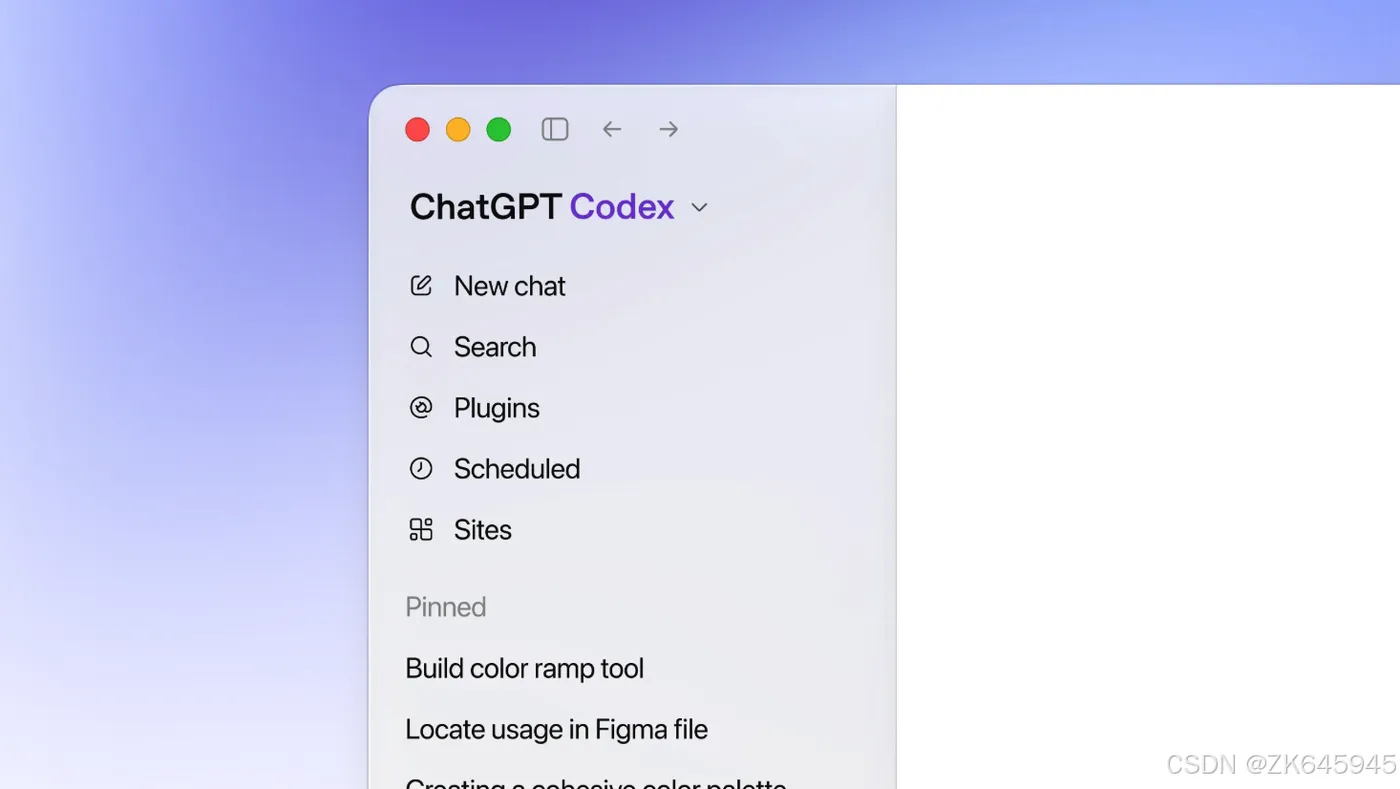
说明使用 Codex 编写运维脚本前需要准备的环境,包括 Codex 的接入方式、常用命令行工具、以及脚本运行环境的配置要点。
4. 实战一:日志分析与告警脚本
通过一个日志分析场景,演示如何用自然语言描述需求,让 Codex 生成日志采集、关键字匹配和告警触发的脚本,并讲解关键代码逻辑。
下面是一个完整的日志分析与告警脚本示例,它读取应用日志文件,统计指定时间窗口内的错误关键字出现次数,并在超过阈值时触发告警通知。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
日志分析与告警脚本
功能:扫描指定日志文件,统计错误关键字出现次数,超过阈值时发送告警。
"""
import re
import time
from collections import Counter
from datetime import datetime, timedelta
========== 配置区 ==========
LOG_FILE = "/var/log/app/application.log"   # 日志文件路径
KEYWORDS = ["ERROR", "Exception", "Timeout"] # 需要匹配的错误关键字
THRESHOLD = 10                               # 告警阈值(次数)
WINDOW_MINUTES = 5                           # 统计时间窗口(分钟)
ALERT_HOOK = "https://hooks.example.com/alert"  # 告警回调地址
def parse_log_line(line):
"""解析单行日志,提取时间戳和消息内容。"""
# 假设日志格式为:2026-08-31 14:30:01,123 ERROR 具体错误信息
match = re.match(r"(\d{4}-\d{2}-\d{2} \d{2}:\d{2}:\d{2})", line)
if not match:
return None, None
timestamp = datetime.strptime(match.group(1), "%Y-%m-%d %H:%M:%S")
return timestamp, line
def analyze_logs():
"""扫描日志文件,统计时间窗口内的错误关键字次数。"""
counter = Counter()
now = datetime.now()
window_start = now - timedelta(minutes=WINDOW_MINUTES)
try:
    with open(LOG_FILE, "r", encoding="utf-8") as f:
        for line in f:
            timestamp, content = parse_log_line(line)
            if timestamp is None or timestamp < window_start:
                continue
            for kw in KEYWORDS:
                if kw in content:
                    counter[kw] += 1
                    break
except FileNotFoundError:
    print(f"[错误] 日志文件不存在:{LOG_FILE}")
    return counter
return counter
def send_alert(counter):
"""触发告警,打印告警信息并调用告警接口。"""
total = sum(counter.values())
print(f"[告警] 最近 {WINDOW_MINUTES} 分钟内检测到 {total} 条错误日志")
for kw, count in counter.items():
print(f"  - {kw}: {count} 次")
实际项目中可在此调用 requests.post(ALERT_HOOK, json=payload)
def main():
"""主流程:分析日志并决定是否告警。"""
counter = analyze_logs()
total = sum(counter.values())
print(f"[信息] 最近 {WINDOW_MINUTES} 分钟内错误总数:{total}")
if total >= THRESHOLD:
send_alert(counter)
else:
print("[信息] 未超过告警阈值,无需告警。")
if name == "main":
main()
运行结果示例:
$ python3 log_alert.py
[信息] 最近 5 分钟内错误总数:23
[告警] 最近 5 分钟内检测到 23 条错误日志
  - ERROR: 15 次
  - Exception: 6 次
  - Timeout: 2 次
关键逻辑说明:
- 时间窗口过滤:通过
timedelta计算窗口起始时间,只统计最近 5 分钟内的日志,避免历史数据干扰。 - 关键字匹配:使用
Counter统计各错误关键字出现次数,命中即计数并跳出内层循环,避免重复计数。 - 阈值告警:当错误总数达到阈值时触发告警,实际生产环境可替换为调用企业微信、钉钉或邮件接口。
- 异常处理:对日志文件不存在等异常做了捕获,保证脚本在异常情况下不会崩溃。
5. 实战二:服务器批量巡检脚本
以批量巡检多台服务器为例,展示如何让 Codex 生成 SSH 批量执行、资源指标采集和结果汇总的脚本,并说明参数化与复用技巧。
下面是一个服务器批量巡检脚本示例,它通过 SSH 连接多台服务器,采集 CPU、内存、磁盘等资源指标,并将结果汇总输出为表格。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
服务器批量巡检脚本
功能:通过 SSH 批量连接服务器,采集 CPU、内存、磁盘指标并汇总输出。
"""
import subprocess
from concurrent.futures import ThreadPoolExecutor
========== 配置区 ==========
SERVERS = [
{
   "host": "192.168.1.10", "user": "ops", "port": 22},
{
   "host": "192.168.1.11", "user": "ops", "port": 22},
{
   "host": "192.168.1.12", "user": "ops", "port": 22},
]
SSH_KEY = "/home/ops/.ssh/id_rsa"   # SSH 私钥路径
TIMEOUT = 10                        # 单台服务器超时时间(秒)
采集命令:一次性获取 CPU、内存、磁盘信息
CHECK_CMD = (
"echo "CPU:$(top -bn1 | grep 'Cpu(s)' | awk '{print $2}')"; "
"echo "MEM:$(free -m | awk 'NR==2{printf \"%s/%sMB\", $3, $2}')"; "
"echo "DISK:$(df -h / | awk 'NR==2{print $5}')""
)
def run_check(server):
"""在单台服务器上执行巡检命令,返回结果字典。"""
host = server["host"]
user = server["user"]
port = server.get("port", 22)
cmd = [
"ssh", "-i", SSH_KEY, "-p", str(port),
"-o", "StrictHostKeyChecking=no",
"-o", "ConnectTimeout=5",
f"{user}@{host}", CHECK_CMD
]
try:
result = subprocess.run(
cmd, capture_output=True, text=True, timeout=TIMEOUT
)
if result.returncode != 0:
return {
   "host": host, "status": "FAIL", "error": result.stderr.strip()}
    # 解析输出为字典
    metrics = {
   }
    for line in result.stdout.strip().splitlines():
        if ":" in line:
            key, value = line.split(":", 1)
            metrics[key] = value.strip()
    return {
   "host": host, "status": "OK", **metrics}
except subprocess.TimeoutExpired:
    return {
   "host": host, "status": "TIMEOUT", "error": "命令执行超时"}
except Exception as e:
    return {
   "host": host, "status": "ERROR", "error": str(e)}
def main():
"""主流程:并发巡检所有服务器并汇总结果。"""
print(f"开始巡检 {len(SERVERS)} 台服务器...\n")
results = []
# 使用线程池并发执行,提高巡检效率
with ThreadPoolExecutor(max_workers=5) as executor:
    results = list(executor.map(run_check, SERVERS))
汇总输出
print("=" * 60)
print(f"{'主机':<16}{'状态':<8}{'CPU%':<8}{'内存':<16}{'磁盘%':<8}")
print("-" * 60)
for r in results:
if r["status"] == "OK":
print(f"{r['host']:<16}{r['status']:<8}{r.get('CPU', '-'):<8}"
f"{r.get('MEM', '-'):<16}{r.get('DISK', '-'):<8}")
else:
print(f"{r['host']:<16}{r['status']:<8}{r.get('error', '-'):<40}")
print("=" * 60)
if name == "main":
main()
运行结果示例:
$ python3 server_check.py
开始巡检 3 台服务器...
============================================================
主机            状态     CPU%    内存             磁盘%
192.168.1.10    OK      12.5    2048/8192MB      45%
192.168.1.11    OK      8.3     1536/8192MB      62%
192.168.1.12    TIMEOUT -       -                -
关键逻辑说明:
- 参数化配置:服务器列表、SSH 密钥、超时时间等均放在配置区,便于按环境调整,无需修改核心逻辑。
- 并发执行:使用
ThreadPoolExecutor并发巡检多台服务器,显著缩短整体耗时,适合大规模集群。 - 命令封装:将 CPU、内存、磁盘采集命令封装为一条 SSH 命令,减少连接次数,提升执行效率。
- 结果解析:通过冒号分隔解析 SSH 输出,统一转换为字典结构,便于后续汇总和格式化展示。
- 异常处理:对超时、连接失败等异常进行捕获,单台服务器失败不影响整体巡检流程。
6. 实战三:自动化部署与回滚脚本
围绕应用发布场景,演示用 Codex 编写部署、健康检查和异常回滚脚本,强调幂等性与失败处理的重要性。
7. 提示词技巧与常见坑
总结向 Codex 描述运维需求时的提示词写法,包括明确输入输出、约束运行环境、要求错误处理等,并列出常见生成错误与规避方法。
8. 安全与合规注意事项
强调 AI 生成脚本在权限控制、敏感信息保护、命令审计等方面的注意事项,避免因脚本缺陷引发生产事故。
9. 总结与进阶方向
回顾全文要点,给出从脚本编写走向自动化平台、运维开发一体化的进阶学习建议。