
过去两年里,“Data Agent” 和 “ChatBI(智能问数)” 是整个大模型应用落地领域最拥挤的赛道之一。
各大厂商、开源社区前赴后继地推出了各种独立的“问数 Agent”:前端套一个炫酷的对话框,中间写一套复杂的编排框架(LangChain / LlamaIndex / AutoGen),底层直连数据库写 Text-to-SQL,最后把折线图、柱状图吐回给用户。
然而,一旦这些产品脱离了精心准备的 Demo 环境,推向企业的真实业务一线,往往会迅速陷入尴尬的冷宫:投入了高昂的研发和维护成本,却几乎没有业务人员深度使用。
为什么会这样?Data Agent 的未来到底在哪里?
本文结合我们从传统 BI 报表、自研 ChatBI 踩坑,到开源 DatI (Data Intelligence) 的完整实践,聊聊为什么我们坚信:传统的单体独立 Data Agent 正在走向死胡同,而“轻量语义网关 + 标准 MCP”才是 Data Agent 演进的终局新解法。
一、传统 Data Agent 为什么走进了死胡同?
复盘传统方案的折戟,根源在于整个行业在解题思路上陷入了四大误区:
1. 宿主割裂:企业不需要第 101 个“孤岛式问数 App”
传统的 Data Agent 试图做“全能巨石系统”——从前端 UI、鉴权、意图识别、SQL 生成到图表渲染全包。
但残酷的现实是:业务人员根本不想为了查两个数,特意打开一个独立的软件或网页去对话!
在当下的企业环境里,员工的工作流高度沉淀在协同软件(钉钉、飞书、企业微信)或桌面助手(Cursor、千问办公、WorkBuddy)中。脱离了业务高频宿主的独立 Data Agent,本质上只是一个高门槛的信息孤岛。
2. 交互局限:停留在“只读看报表”,无法完成业务闭环
绝大部分 Data Agent 只能做只读分析。
但真实的业务场景中,“查”往往只是“改”的前置步骤。例如:客服查到了用户超时未处理的工单,希望顺手改派;财务核对完流水,希望顺手将状态标记为“已对账”。
如果 Agent “只管查、不管改”,业务人员依然要回到老系统手动点鼠标,那这个 Agent 就只能停留在玩具阶段,无法构建轻量级的业务闭环应用。
3. NL2DSL 的封闭牢笼:准确率与灵活性的死结
为了解决大模型直接写 SQL(NL2SQL)的幻觉,许多团队走向了“自然语言转结构化指标 DSL”路线。
然而,DSL 在提升取数准确率的同时,也彻底扼杀了即席分析的自由度。一旦业务提了一个未在指标模型中预定义的复杂多维交叉问题,系统就瞬间瘫痪。
4. 生产级安全“裸奔”:连接池与权限的隐形炸弹
让 Agent 直连生产数据库无异于“火中取栗”:
- 很多团队用 Python/TS 本地脚本直连,缺乏工业级的连接池治理能力,瞬时高并发或长事务极易引发连接泄露,直接打爆核心库;
- 给只读权限无法做增删改轻应用;给写权限又无法防范模型幻觉导致的
DELETE / UPDATE误操作与全表越权。
二、DatI 的破局:Data Agent 的“语义网关”新解法
面对上述死结,我们彻底推翻了“造一个独立 Data Agent 软件”的旧范式,提出了全新的解题思路:
“未来的企业里,不会存在单一全能的 Data Agent,而是成千上万个业务 Agent 需要随时调用数据能力。因此,Data Agent 的终局形态不是一个终端 App,而是一套插拔式的‘数据库语义网关基础设施’。”
这正是开源项目 DatI (Data Intelligence) 的核心定位:专为 AI Agent 设计的企业级轻量数据库语义网关。

核心解耦架构:网关化 + 协议化
- 上层完全放权给宿主(Host Agent):
放弃自建独立前端和封闭对话框。无论用户用的是 Cursor、Claude Desktop、Dify、Coze、WorkBuddy 还是企业内部自建的聊天机器人,都可以作为宿主。 - 底层标准化为 Streamable HTTP MCP 协议:
数据库连接凭证在 DatI 服务端集中托管,终端用户只需分配一个个人 Token。一处配置,企业内所有宿主 Agent 瞬间拥有安全访问生产数据的能力。 - 中间沉淀高可用语义层(Semantic Layer):
负责把异构数据库的表、字段、枚举值与业务术语对齐,为上层 Agent 提供精准的业务上下文召回与受控执行屏障。
三、场景落地:从智能问数到“读写一体轻应用”
当数据库被封装为具备安全防护的语义网关后,Agent 的能力瞬间完成了从“只读查数”到“自主构建轻应用”的质变。
我们用一个 “家庭双人记账与消费多维分析” 的实战案例来演示这种新范式:
1. 平台极简配置(支持 dati-ops skill 自动化配置)
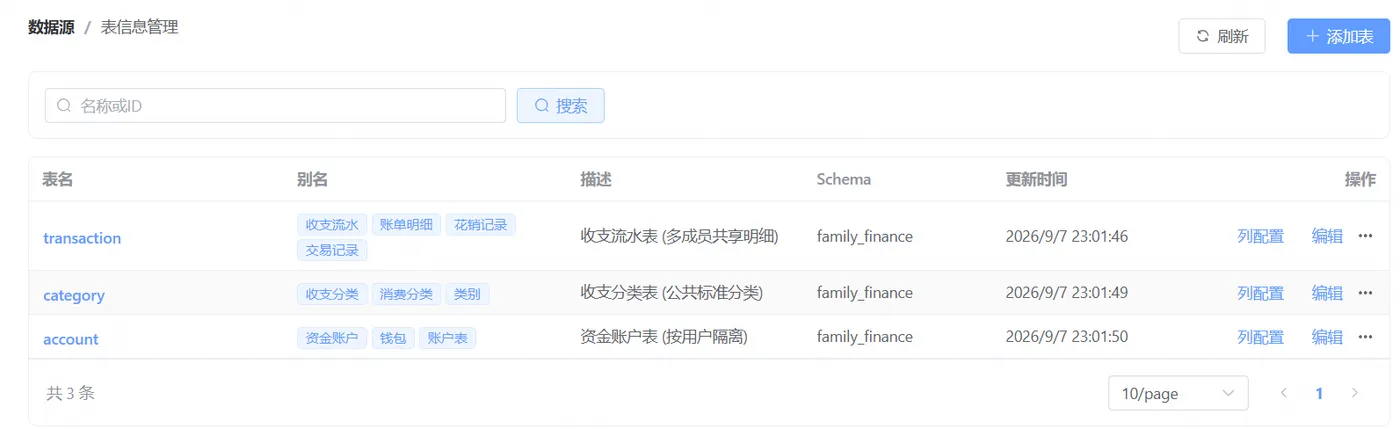
底座包含 3 张 MySQL 表(account 账户表、category 分类表、transaction 流水表):
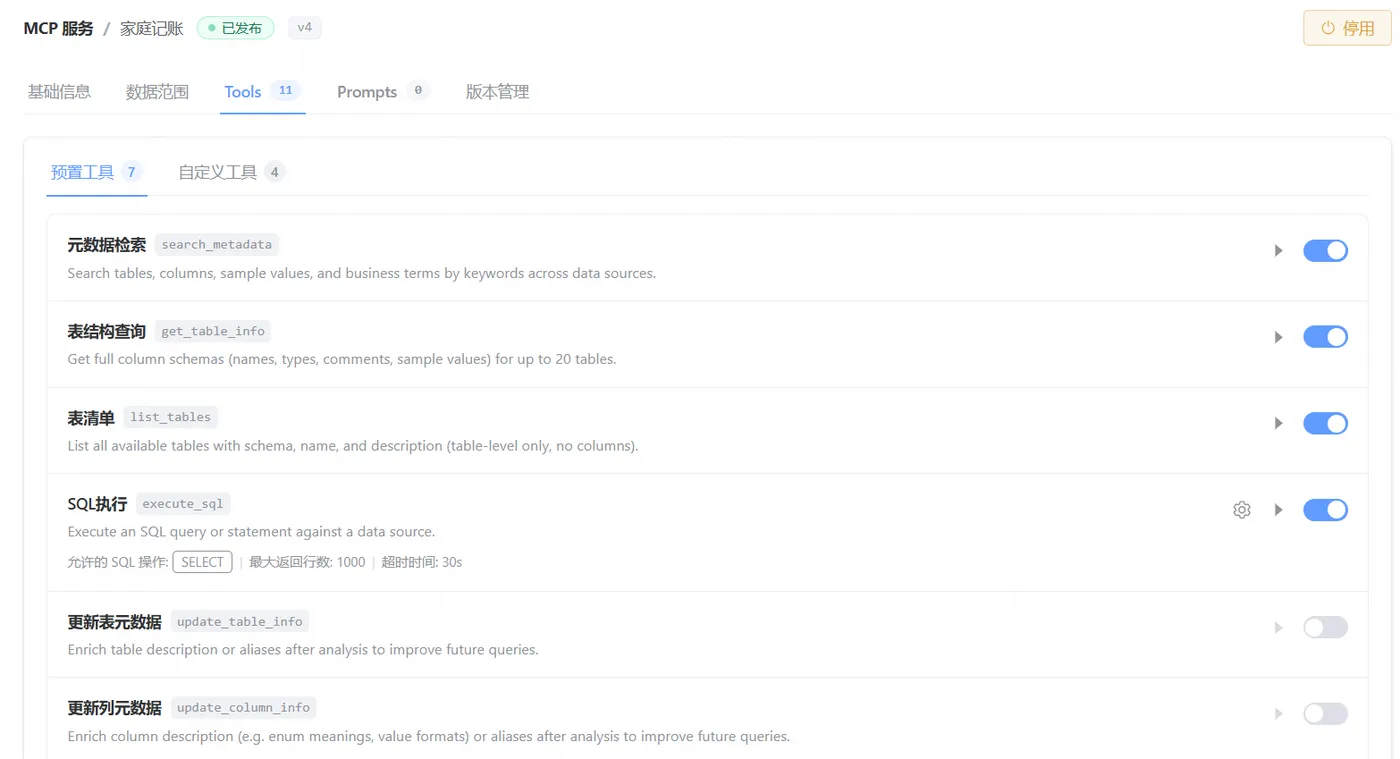
- 开启 4 个预置工具:元数据检索、表清单、表结构查询、受控 SQL 执行(限制仅允许只读
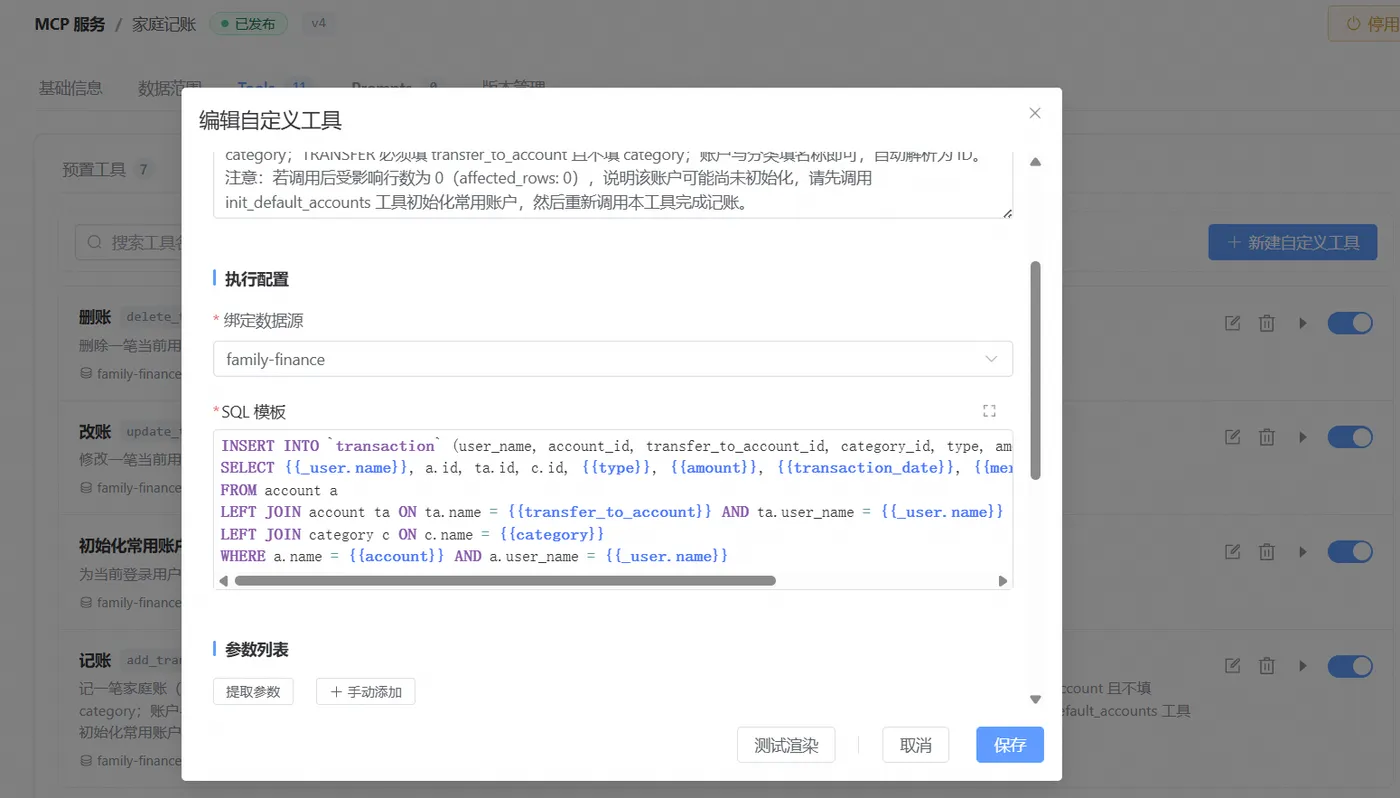
SELECT); - 配置 4 个自定义工具:初始化账户、记账、改账、删除流水。
2. 任意宿主即插即用:复用已有能力
一键生成标准 MCP 服务后,用户 1 在 WorkBuddy 接入,用户 2 在 千问办公 接入:
- 妻子发一张购物小票照片,宿主自带的 OCR 视觉能力 识别出明细,调用 DatI 的“记账”工具安全入库;
- 丈夫在微信端发一句语音“查查我们这个月在餐饮上花了多少”,宿主直接利用 DatI 的预置探索工具,自主生成精准 SQL,秒级输出分析图表。
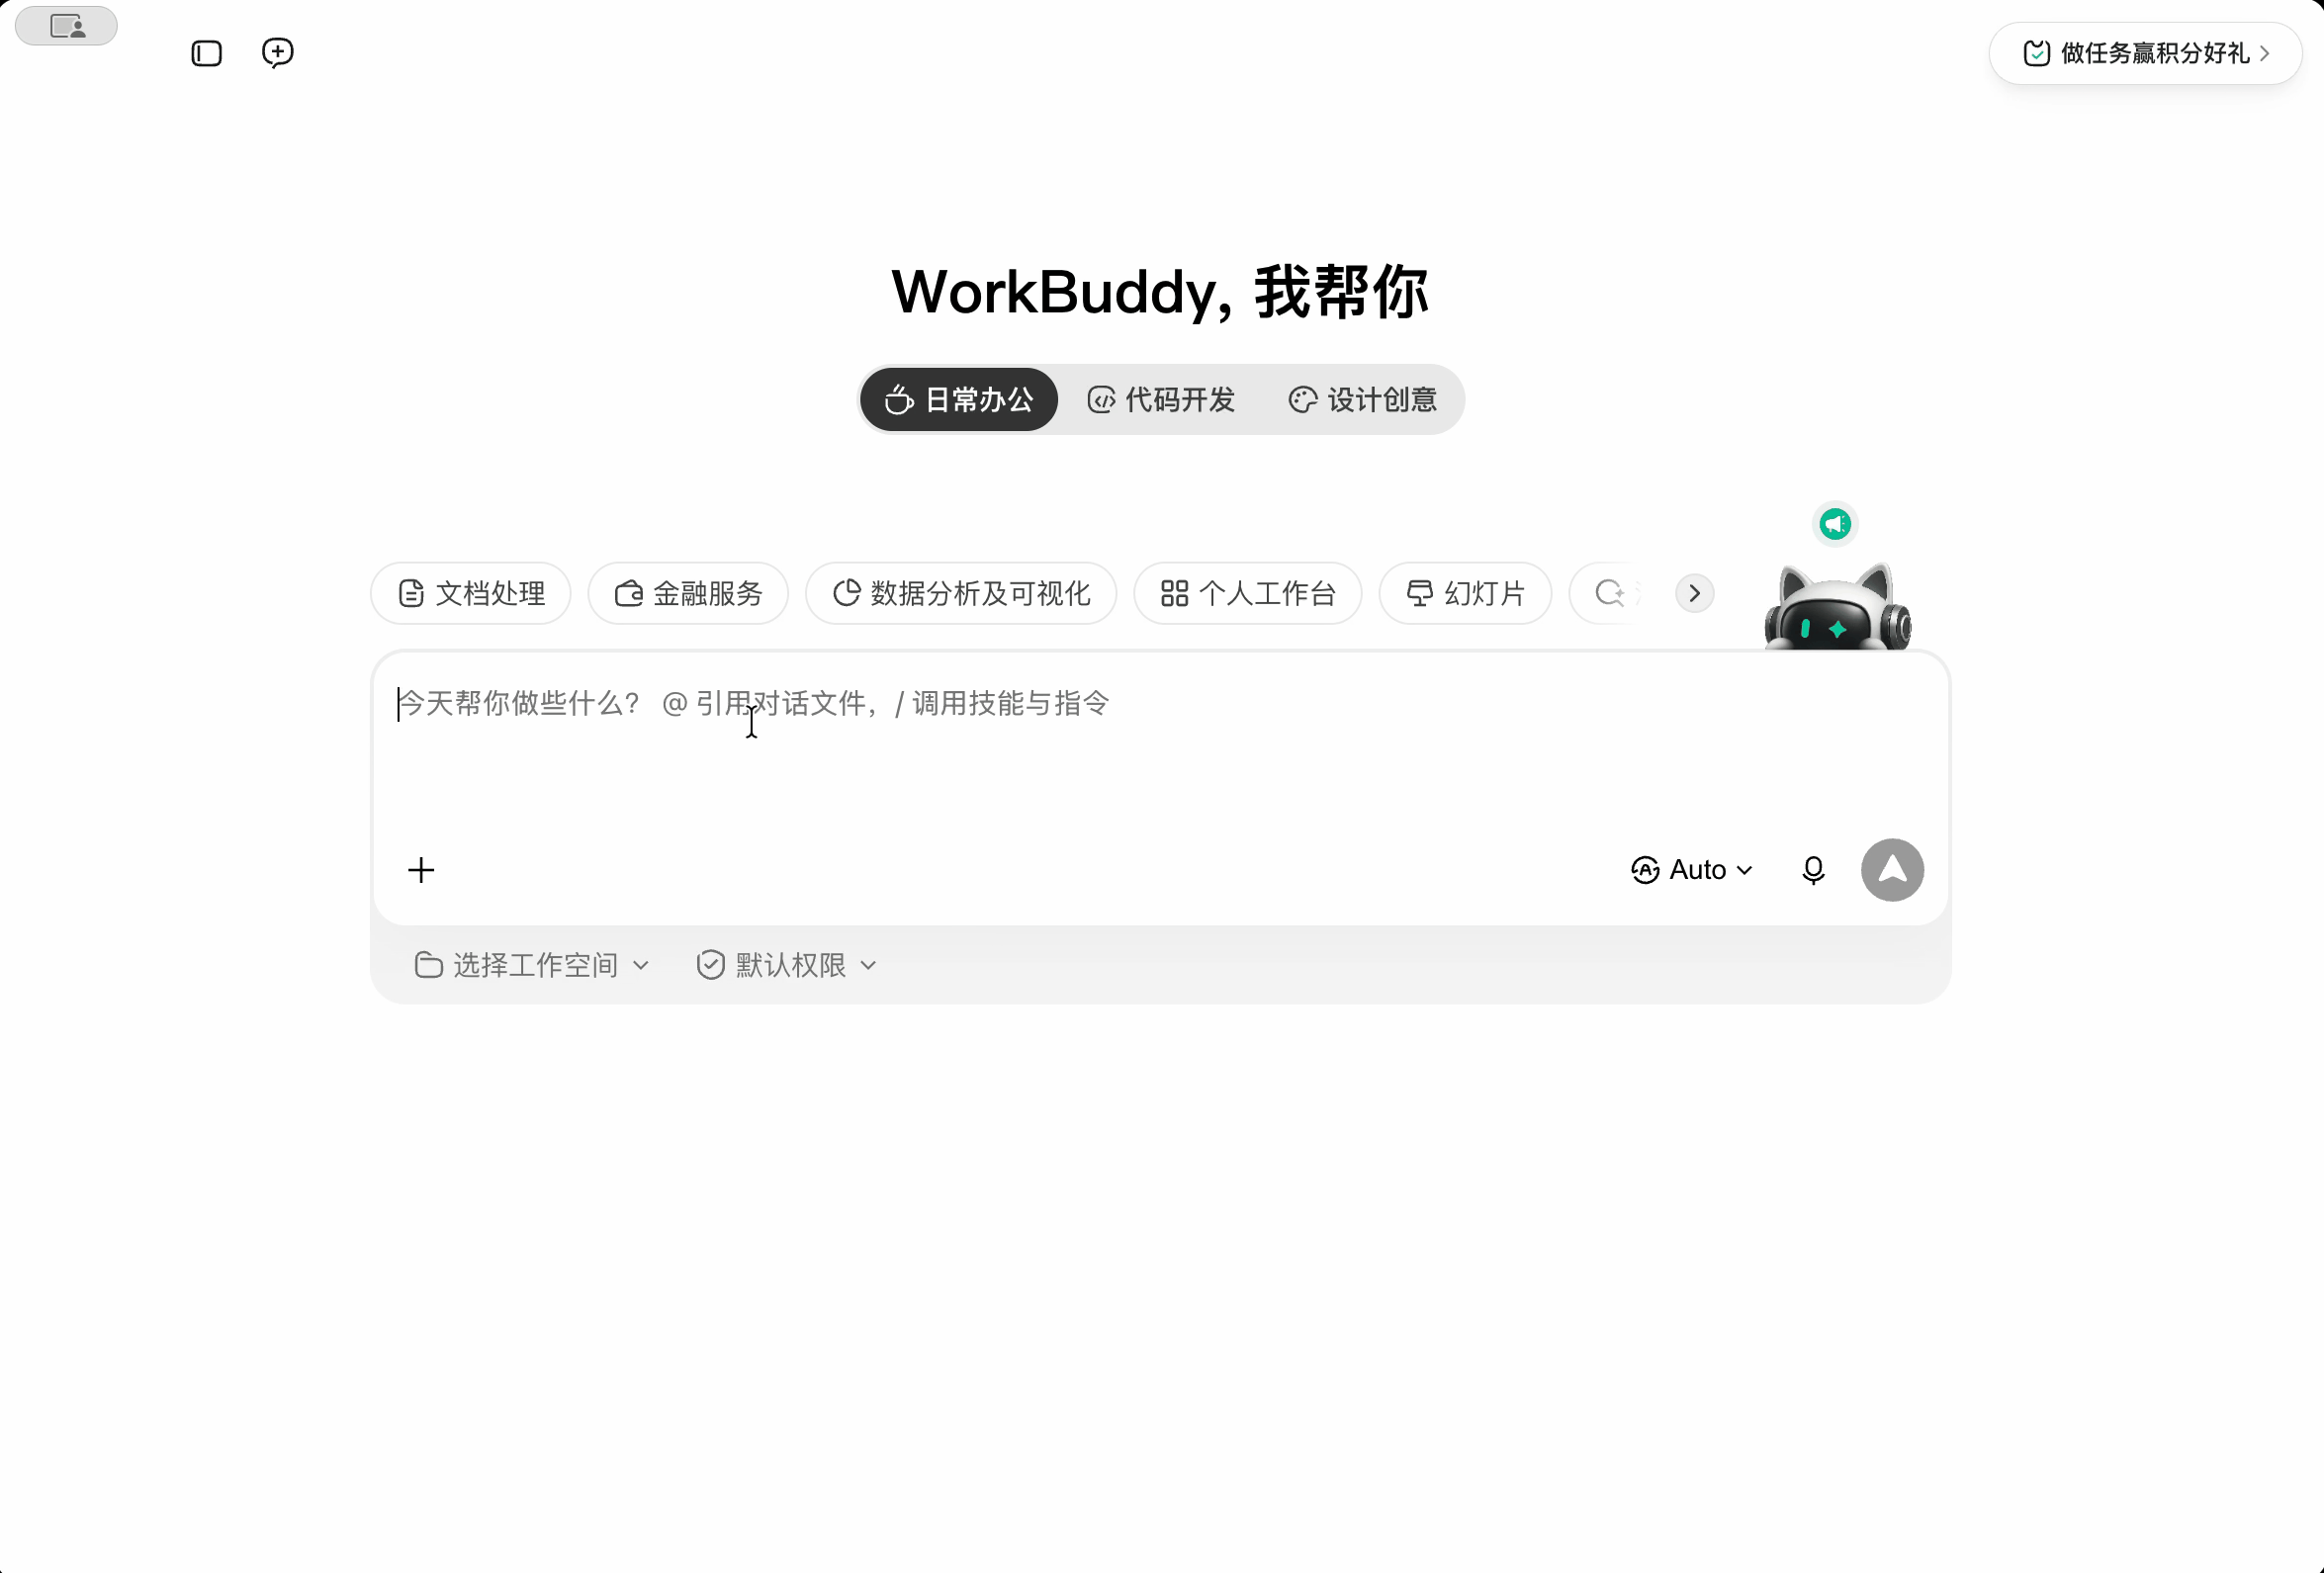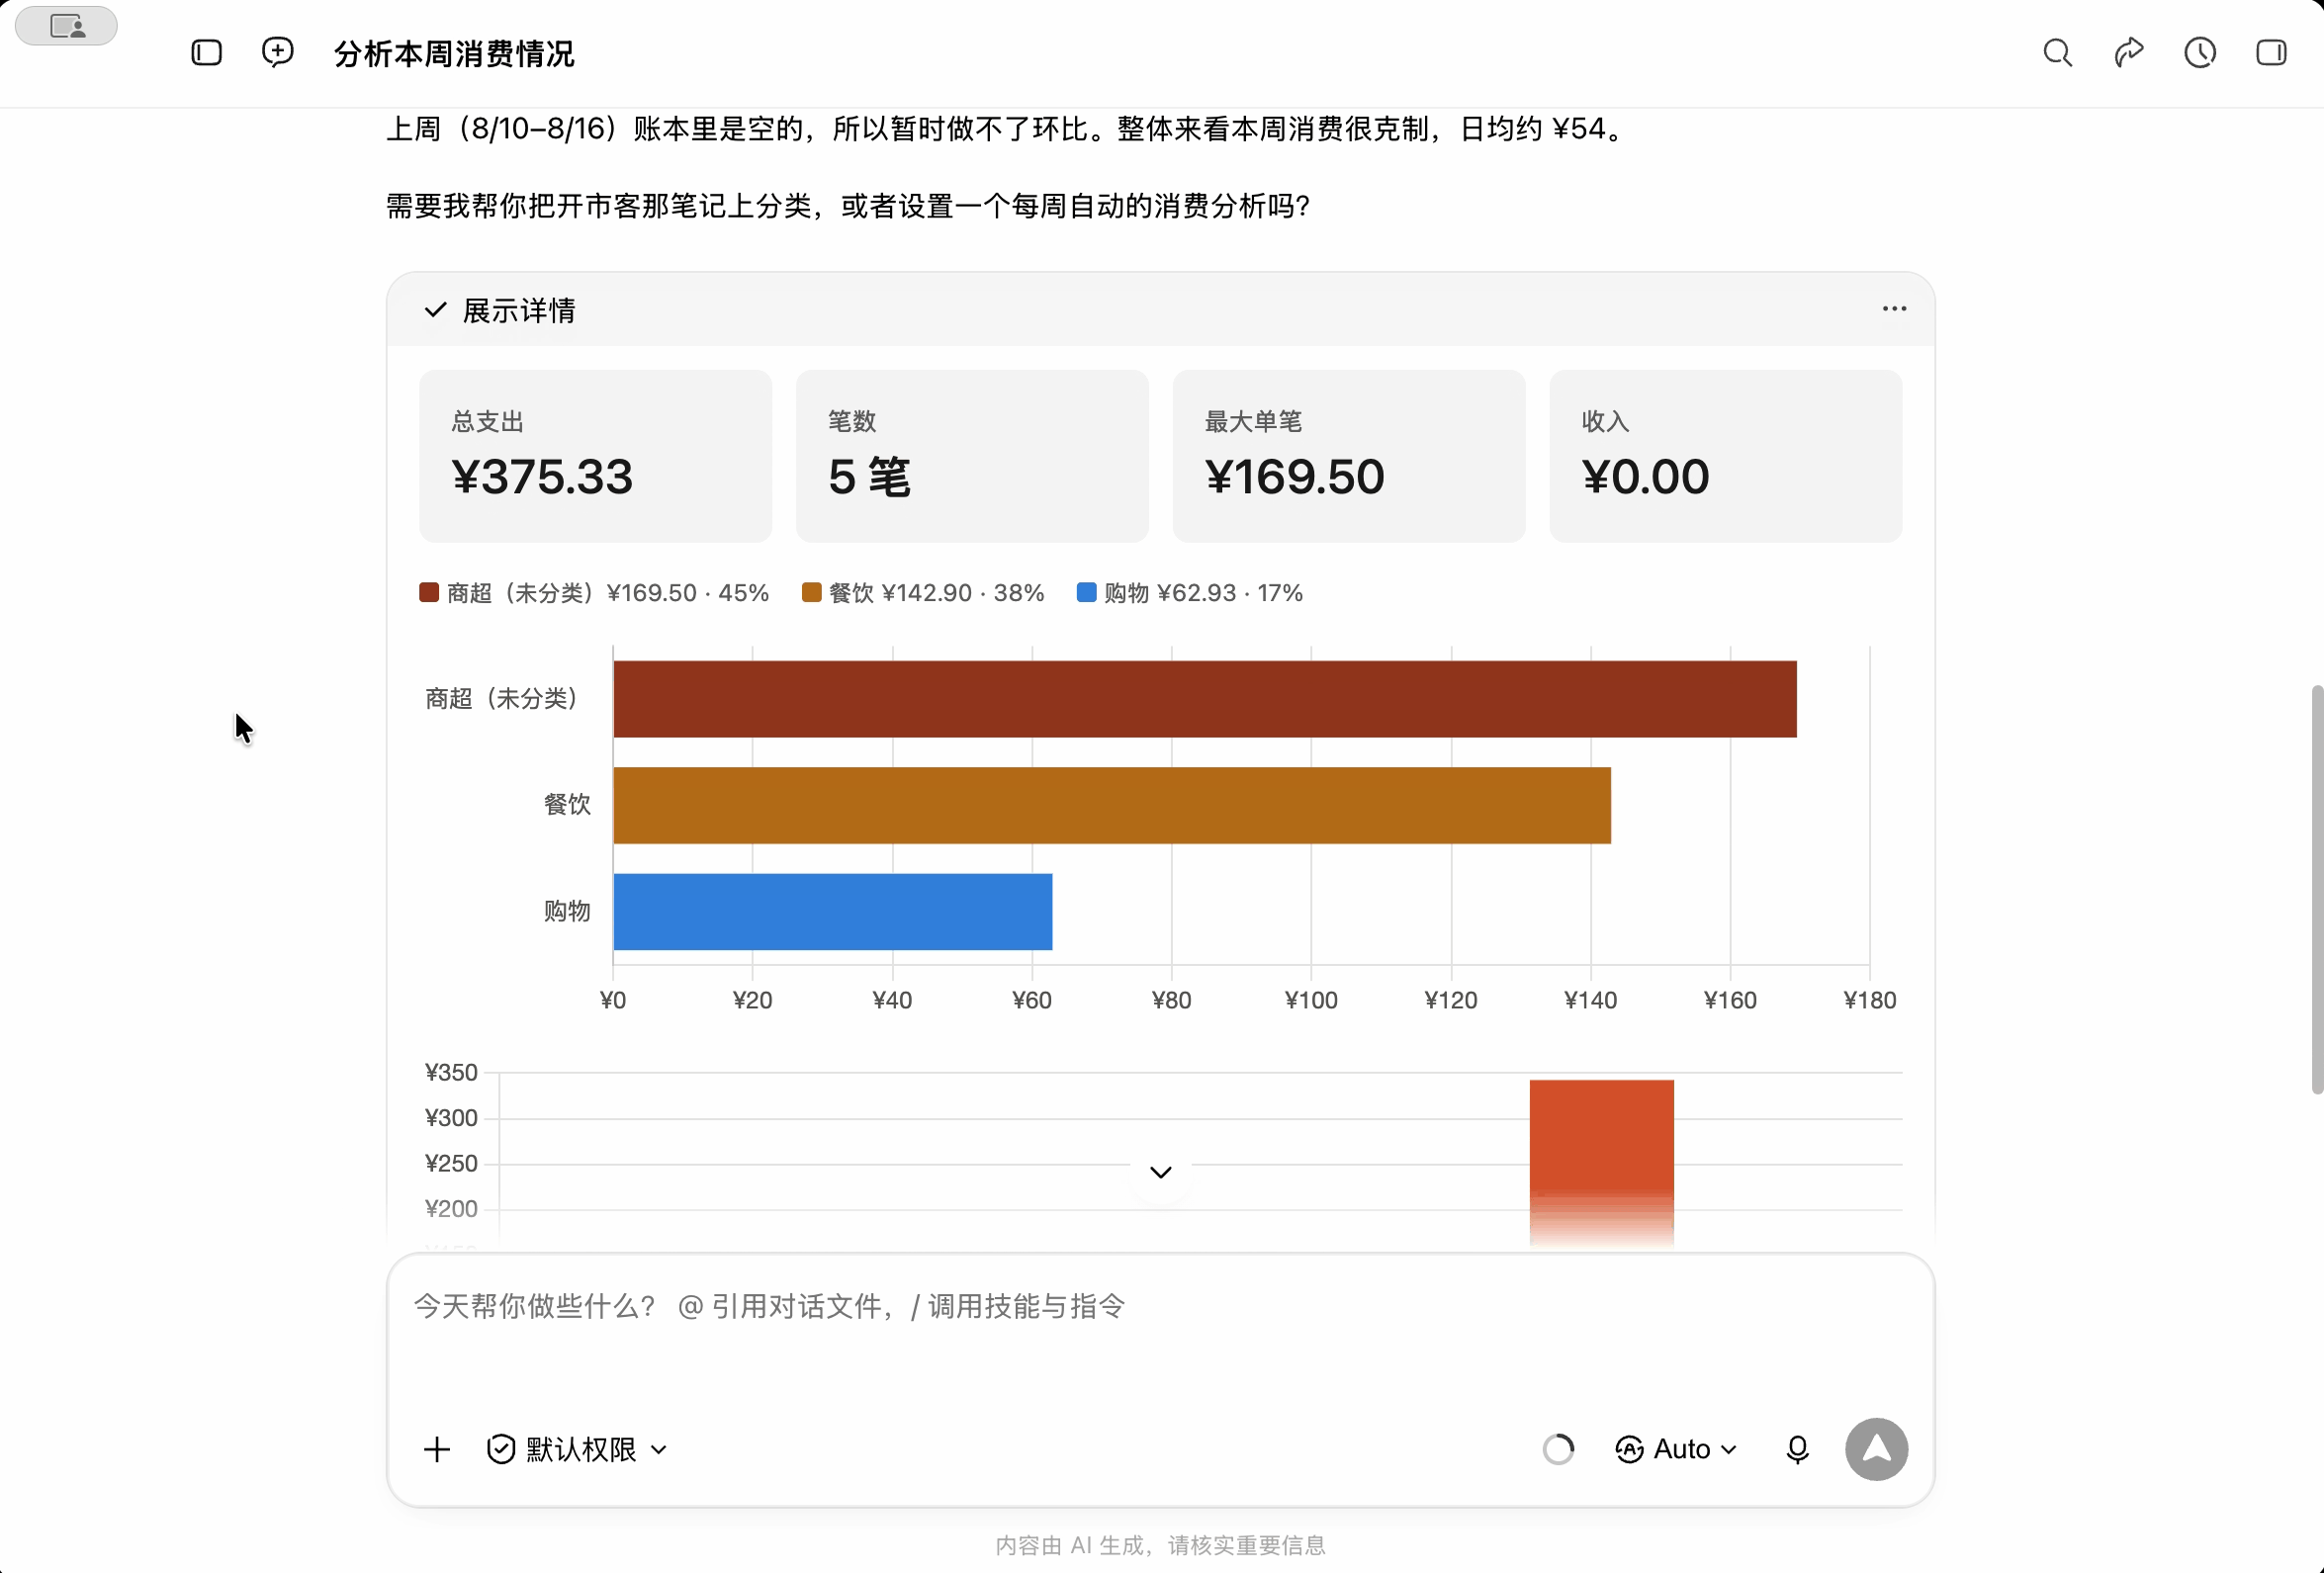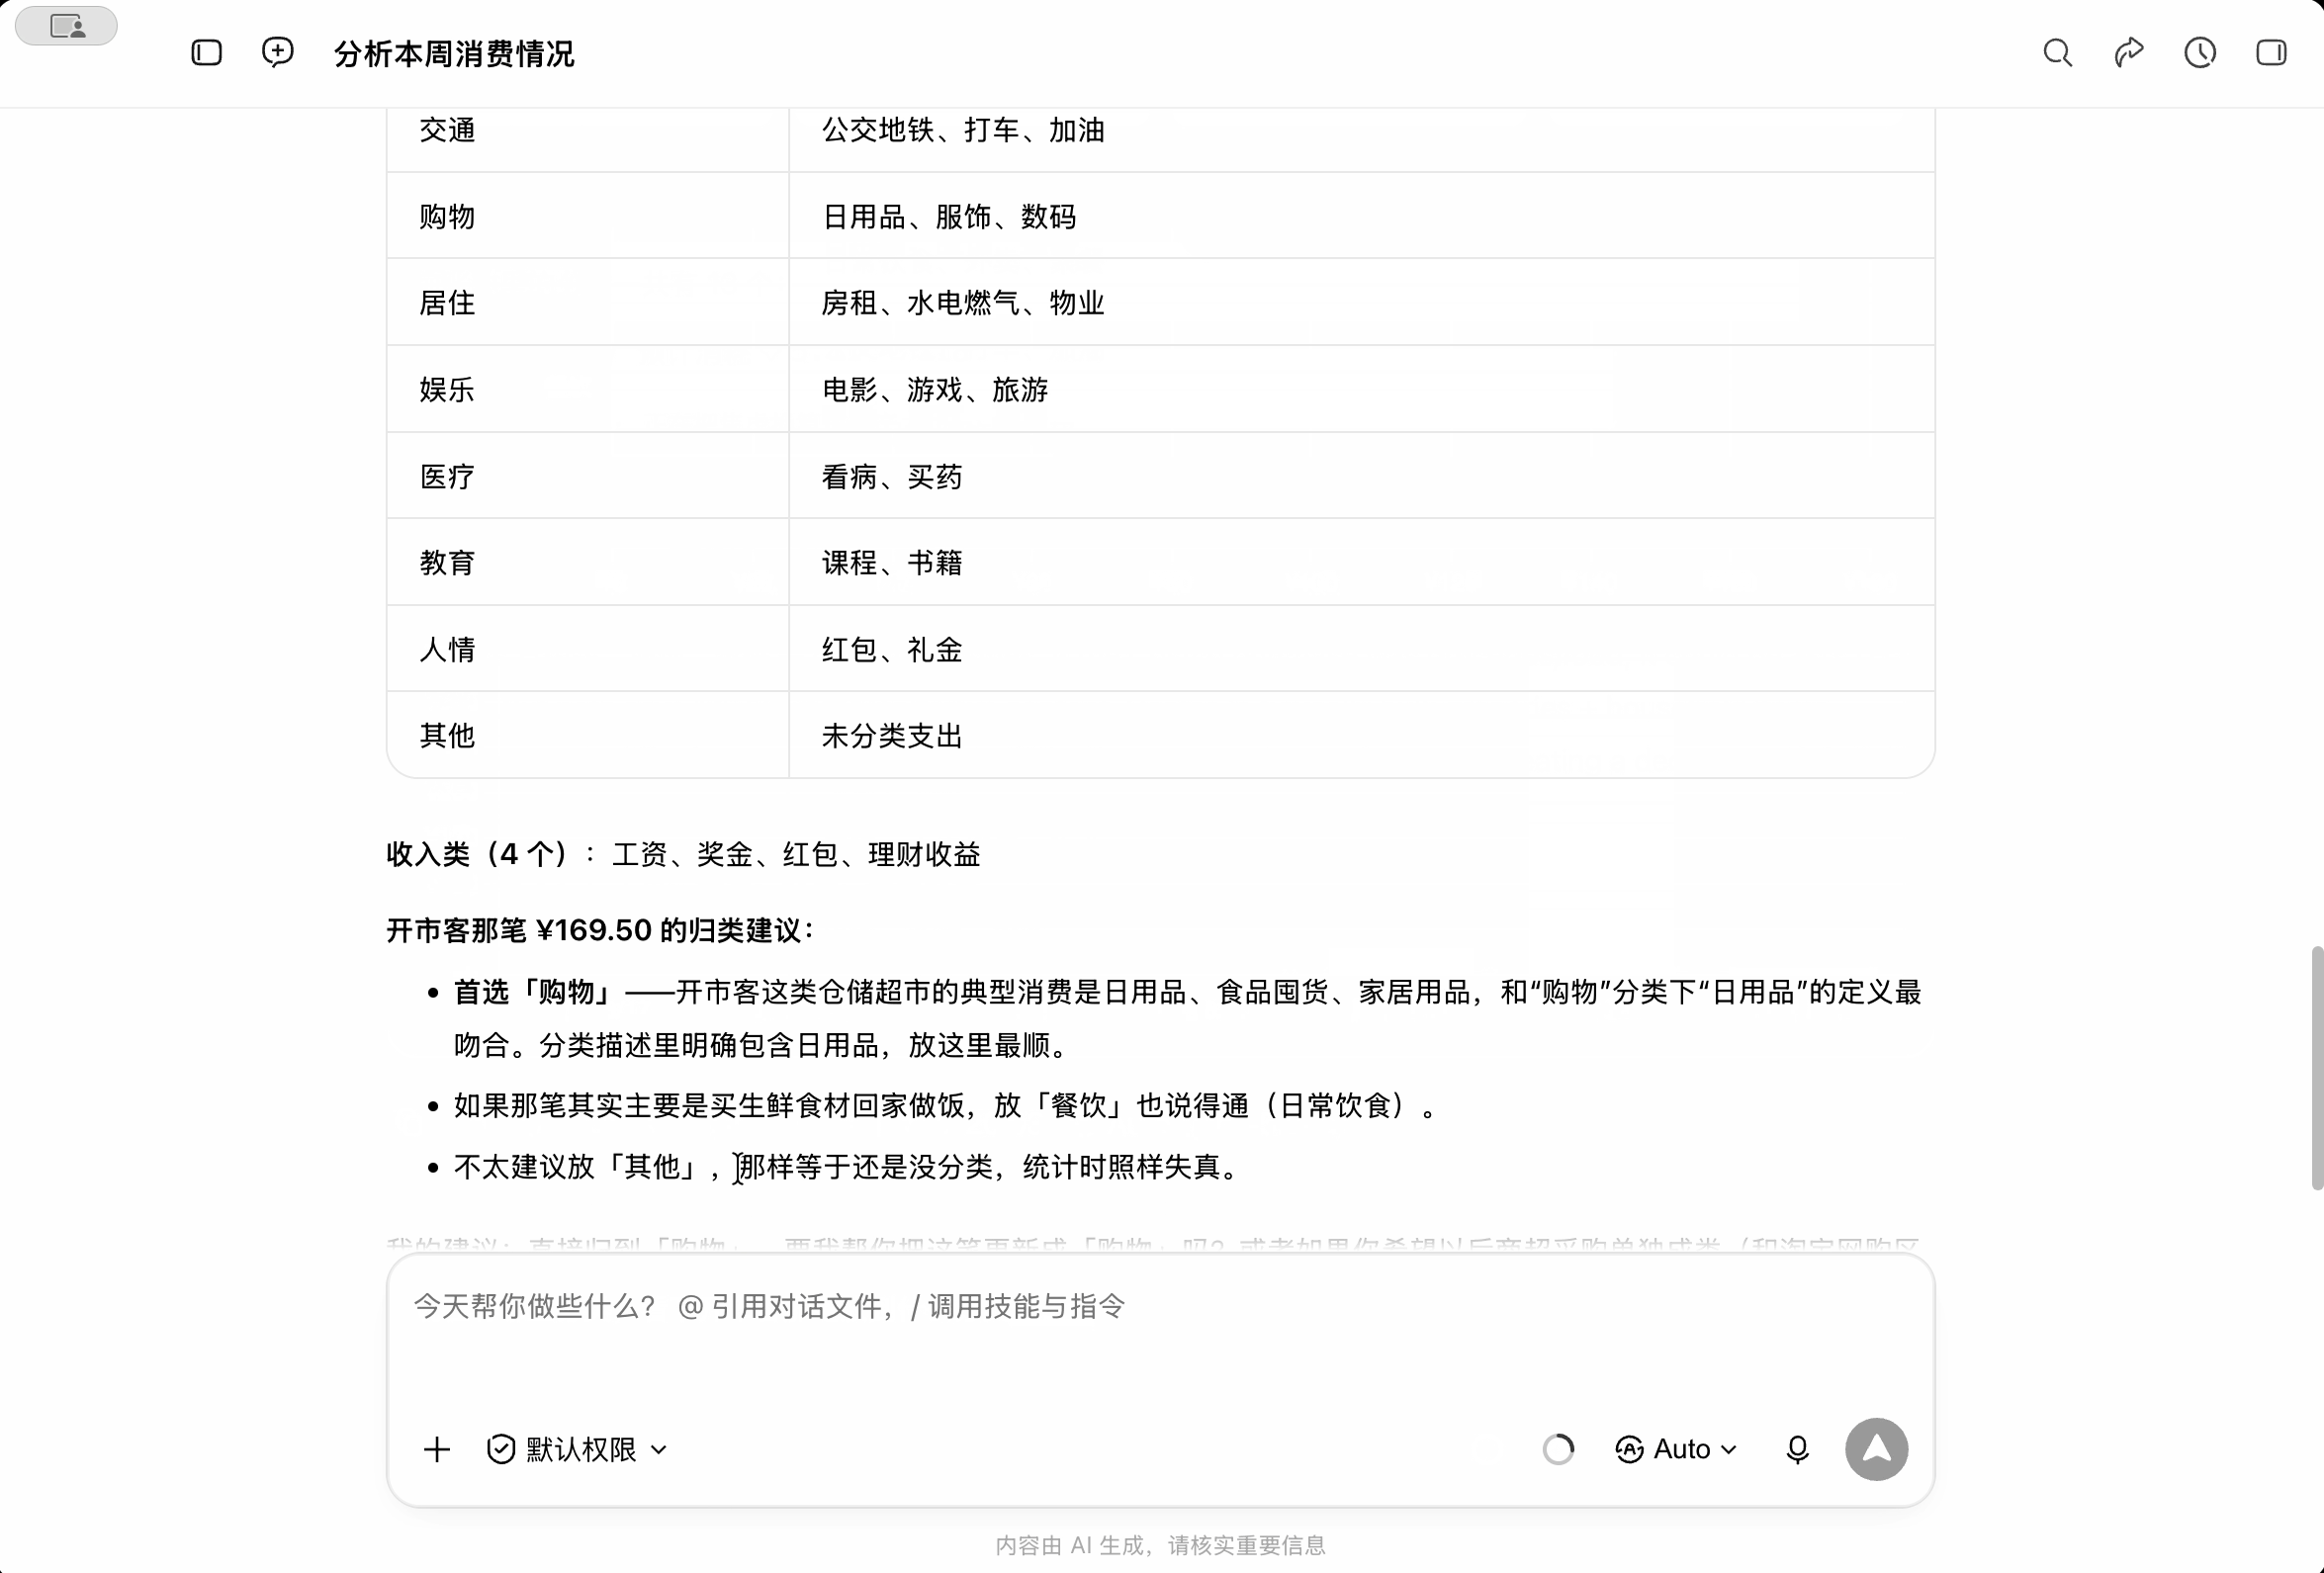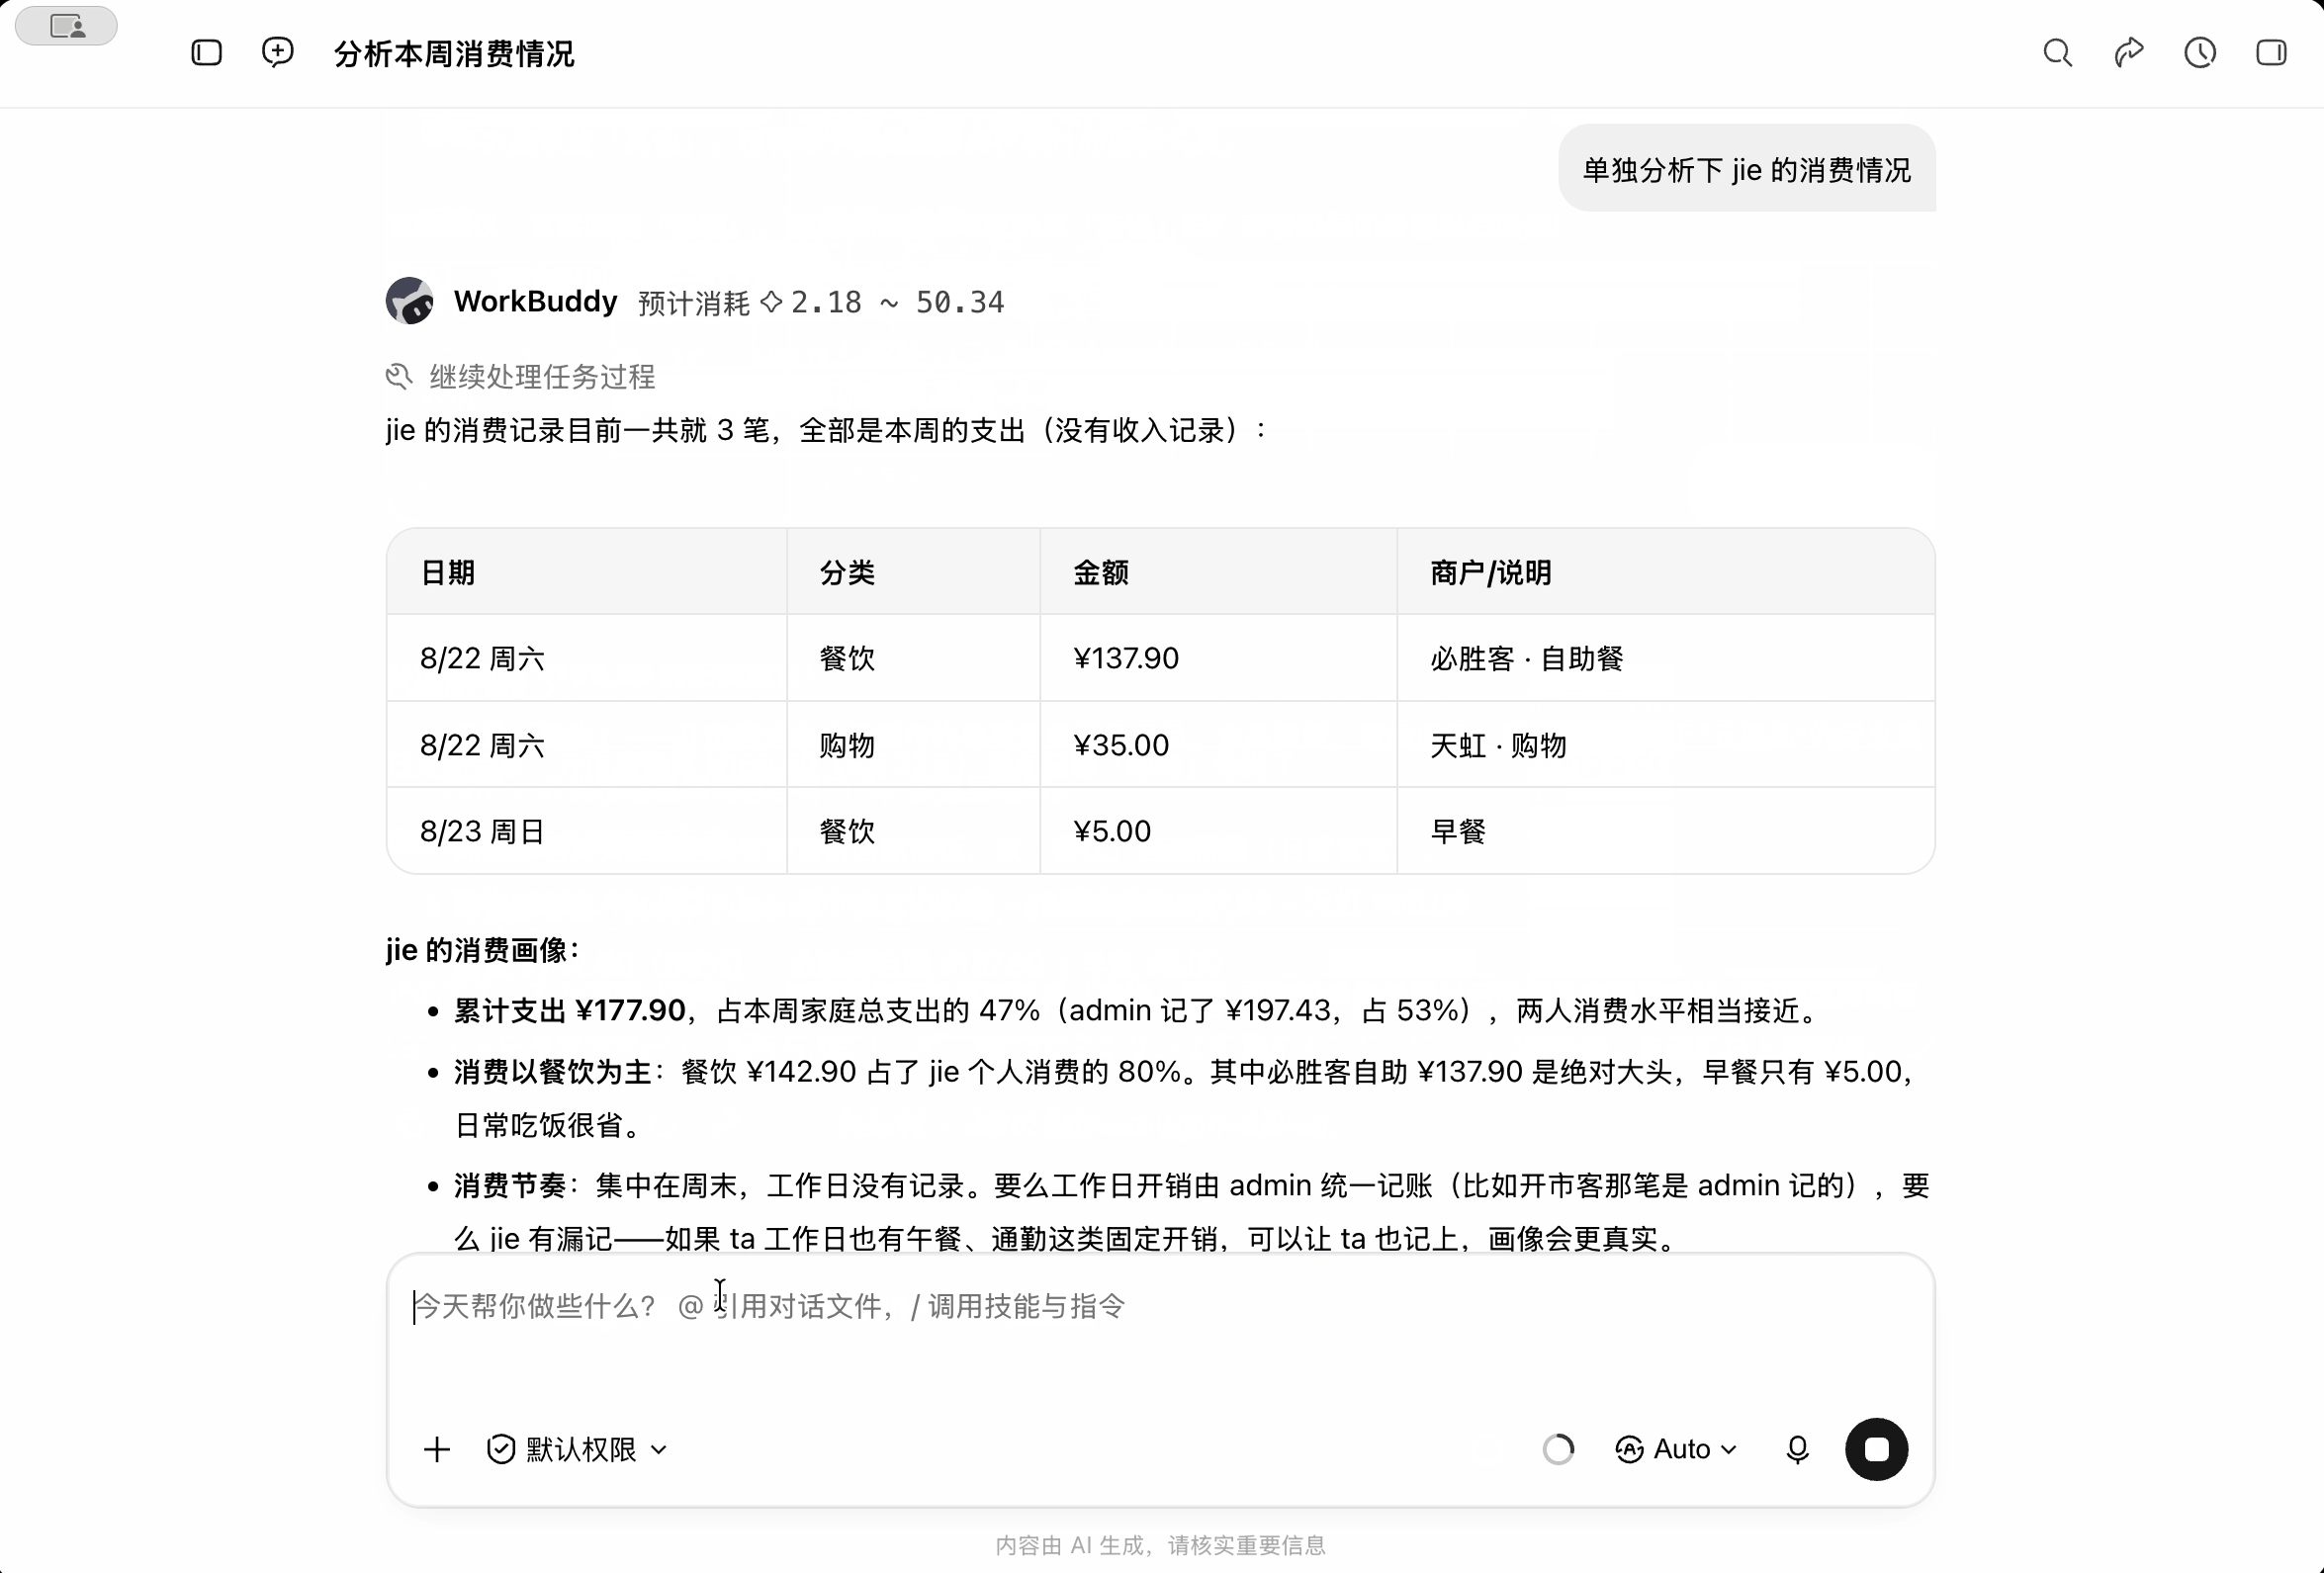
看到了吗?开发者一行前端代码都不用写,也无需开发任何后台管理页面,一个完整的“双人协同记账管理系统”就在两个现成的 Agent 宿主中完美跑通了!
四、核心技术支撑:为什么 DatI 能做到既自由又安全?
要实现这种全新范式,必须在底层攻克“业务语义精准召回”与“高危操作安全熔断”两大硬核课题:
1. Elasticsearch 统一打平与倒排索引召回
大模型写错 SQL,核心在于拿不到匹配的字段和业务定义。
DatI 将数据源中的表结构、列注释、枚举值(如 status=1 代表“生效”)以及业务术语(如“GMV”、“净利”)全部打平,建立 Elasticsearch 倒排索引。
Agent 在生成 SQL 前,只需调用一次关键词检索,就能毫秒级捞出最紧密关联的业务上下文,精准注入 Prompt,彻底终结模型幻觉。
2. 参数化 SQL 模板与行级上下文注入(破除 SQL 注入与越权)
针对涉及写操作或高频复杂统计的场景,DatI 采用参数化 SQL 模板。
模板引擎支持动态语法,最核心的是支持由网关层强行注入会话用户上下文(如 {
{_user.name}}):
UPDATE transaction SET
  {
  {
  #if amount}}amount = {
   {amount}},{
   {/if}}
  {
  {
  #if category}}category_id = (SELECT id FROM category WHERE name = {
   {category}}),{
   {/if}}
  updated_at = now()
WHERE id = {
  {transaction_id}} AND user_name = {
  {_user.name}}
这种机制给 Agent 上了两把“绝对物理锁”:
- 大模型只能提取提取结构化参数填槽,无法篡改 SQL 核心结构;
- 无论大模型如何产生幻觉,底层的
WHERE user_name = {
   {_user.name}}
永远由网关根据当前 Token 身份强制绑定,彻底杜绝了跨租户越权篡改数据的隐患。
3. 坚守 Java 后端底座
很多 AI 项目选择纯 Python/Node.js 实现。但作为企业级数据库网关,稳定是第一生命线。
DatI 后端完全基于 Java + JDBC + HikariCP 构建。工业级的连接池治理、细粒度的事务隔离、完善的超时熔断机制,确保即便在上层 Agent 发起瞬时突发探测或长链路查询时,底层的生产数据库依然稳如泰山。
五、生态位推演:为什么“语义网关范式”就是未来?
回看软件工程的演进史,每一次技术成熟都伴随着“从单体巨石到标准网关”的解耦:
- 从“每个系统自写鉴权路由” ➔ 演进为 API 网关(Kong / Spring Cloud Gateway);
- 从“每个应用自建大模型微调” ➔ 演进为 模型路由网关(OneAPI / LiteLLM);
- 同理,从“每个场景各搞一个单体 Data Agent” ➔ 演进为“统一的数据库语义网关(DatI)”,是不可逆转的必然规律!
| 维度对比 | DatI (语义网关新解法) | 传统的单体 ChatBI | 官方单库本地 MCP | 手工硬编码工具链 |
|---|---|---|---|---|
| 产品形态 | 协议级网关基础设施 | 孤立的大一统 Web App | 本地命令行进程 | 代码工程写死 |
| 适配宿主 | 任意 MCP 宿主(Cursor/千问/飞书等) | 仅能在自己的前端使用 | 仅限单机单用户 | 深度绑定私有框架 |
| 操作边界 | 读写一体(安全支持 CRUD 轻应用) | 仅能只读查报表 | 仅查只读,无防护 | 需自行写代码防御 |
| 语义与安全 | ES 倒排语义召回 + 参数化行级注入 | 绑定重型指标 DSL | 仅裸露 DDL,极易幻觉 | 依赖手动 Prompt 维护 |
| 企业接入成本 | 一处配置,全员 Token 共享复用 | 动辄采购数月,无法打通工作流 | 每台机器重复配置明文凭据 | 维护成本指数级上升 |
六、结语与开源
未来的企业数字化,绝不是由 100 个孤立的 AI 软件割裂开来,而是由统一的数据智能网关为所有业务 Agent 全面赋能。
DatI 做的事情非常纯粹:做好那个最稳固、最懂业务、最安全的数据库语义网关,让大模型真正安全地读写企业数据库。
项目目前已经完全开源,并提供了开箱即用的在线体验环境。我们诚挚邀请所有关注 Data Agent、NL2SQL 和 MCP 生态的开发者一同体验、探讨与共建!
- 🌐 在线体验 Demo:
http://47.99.122.223:18085/(账号:demo/ 密码:demo123) - 💻 GitHub 开源仓库:https://github.com/yimindev/dati




