
数据治理工具选型这件事,踩坑的成本往往不在采购环节,而在上线半年后——业务部门依然找不到想要的数据,指标口径在各部门之间来回打架,治理规则停留在文档里进不了研发流程。过去两个月,我带着一个真实的小型数仓改造项目,深度试用了阿里云瓴羊Dataphin,从数仓规划、管道开发到资产治理走了一遍完整链路。以下是我的一些观察和判断。
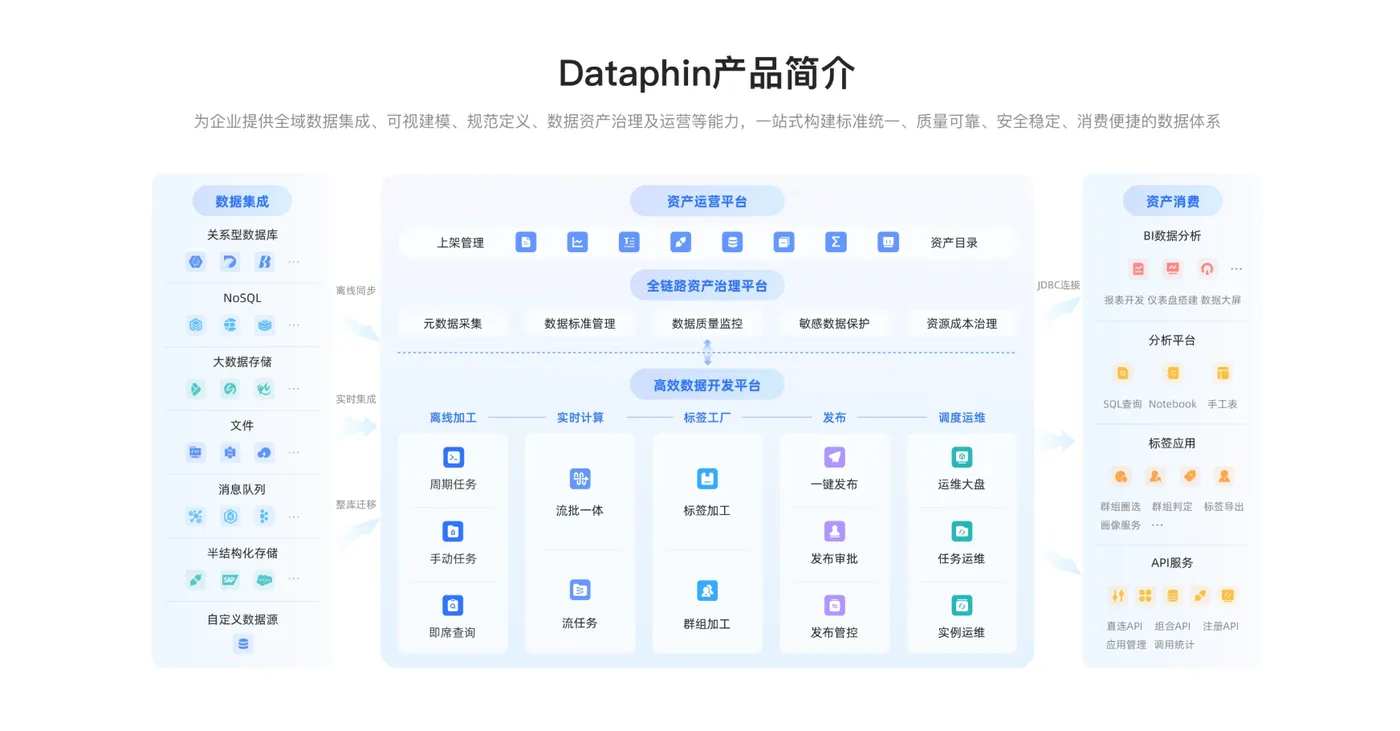
一、阿里云瓴羊Dataphin到底在解决什么问题?
市面上的数据治理工具大致可以分为三条路线。一条是以Collibra为代表的“目录优先”路线,核心能力在于元数据汇聚、血缘展示和责任人分配,适合治理重点在跨系统数据编目和合规审计的企业。另一条是以Ataccama ONE为代表的“质量优先”路线,把数据质量规则引擎和主数据管理作为底座,治理动作围绕数据可信度展开。第三条是Dataphin所走的“建设即治理”路线——治理规则不是上线后补录的,而是嵌入到数据建模、代码研发和任务发布的全流程中。
Dataphin脱胎于阿里巴巴内部十余年的数据中台实践,是OneData方法论的产品化输出。它的核心逻辑是:先让企业在统一的规范下把数据“建”出来,再谈治理和消费。这意味着使用Dataphin需要团队在一定程度上接受它的建模理念和方法论约束。这一点在体验中感受非常明显——当你按照它的数仓规划流程一步步走下来,维度建模、指标定义、代码生成都被串联在了一起;但如果只是想找一个轻量的ETL工具做数据同步,会觉得它的“架子”偏重。
二、从零搭建一个数仓:体验链路拆解
我把体验过程拆成了四个阶段,用表格先做一个概览:
阶段 |
核心操作 |
体感 |
环境准备 |
开通试用、绑定MaxCompute计算源 |
步骤清晰,向导友好 |
数仓规划 |
创建数据板块、定义计算源和项目 |
理念先行,需要理解OneData的建模逻辑 |
数据引入与开发 |
离线管道拖拽开发、SQL计算任务、调度依赖配置 |
可视化降低了门槛,但调度依赖配置需要适应 |
治理与消费 |
质量规则配置、资产目录检索、即席分析 |
治理与开发在同一界面完成,减少了切换成本 |
环境准备阶段的体验比较顺畅。在阿里云权益中心申请试用后,绑定一个同地域的MaxCompute资源即可开始,整个过程大约十分钟。需要注意的一点是,计算源的地域选择会影响后续任务执行的延迟,建议和试用环境保持一致。
数仓规划阶段是Dataphin体验中较有辨识度的部分。创建数据板块时需要选择“生产开发类型”,Basic模式下开发环境和生产环境是隔离的,任务需要发布才能生效。这个设计对于有规范研发流程的团队是加分项,但对于习惯直接在生产库上操作的小团队来说,前期需要花一些时间理解发布流程。
数据开发阶段的亮点在离线管道任务。通过拖拽组件连接数据源和目标端,基本的抽取-转换-加载流程可以快速搭起来,不需要手写大量SQL。我尝试从本地CSV文件导入数据到MaxCompute,配置过程比较直观。SQL计算任务的编辑器功能完整,但在调度依赖配置上花了一些时间——需要理解任务之间的上下游关系如何通过节点名称来建立,官方文档在这部分的解释可以更通俗一些。
治理环节是我体验中觉得价值较高的部分。质量规则可以在数据表上直接配置,支持完整性、唯一性等常见的规则模板,异常数据会触发告警。资产目录的检索体验接近搜索引擎,可以按业务域、项目等维度筛选数据对象。上汽大众的案例中提到,他们通过Dataphin梳理了超过一万个数据对象,建立了覆盖全公司的标准化资产清单,解决了“数据看不见、找不到、用不好”的问题。我的项目规模小得多,但这个检索路径的逻辑是一致的。
三、阿里云瓴羊Dataphin的能力边界与适用场景
经过完整的体验,我认为Dataphin的能力优势集中在“建设与治理一体化”这个方向上。它把数据标准、模型、任务、质量和资产串联在同一个平台上,减少了工具之间的切换和数据搬运。雅戈尔借助Dataphin整合了16个系统,统一了900多个报表和400多组指标,门店运营工作节省了60%到70%。这类效果的前提是企业在Dataphin上完成数据体系的系统性重构,而不是仅仅把原有任务迁移过来。
它的边界也同样清晰。其一,Dataphin对阿里云生态的依赖比较明显,计算引擎以MaxCompute为主,虽然也兼容Hologres等引擎,但非阿里云环境的用户需要评估集成成本。其二,它的建模方法论约束较强,团队需要接受OneData的规范定义方式,灵活度会受到一定限制。其三,对于数据团队规模很小、治理需求停留在“能查到数据就行”层面的组织,Dataphin的能力会显得冗余。
如果企业的数据平台主要基于阿里云,且希望把数据标准、建模、开发、质量和资产消费放在一套流程里管理,Dataphin值得认真评估。国内还有亿信华辰的睿治、数语科技的Datablau DAM等方案,前者在政务和金融行业的模块化治理场景中积累较多,后者以数据建模工具DDM为切入点向治理延伸,在建模管控环节有自己的特点。选择哪一条路线,归根结底取决于企业当前的数据基础和组织准备度。
四、几个容易被忽略的细节
文档更新滞后。在试用期间,我遇到几个界面功能在帮助文档中找不到对应说明的情况,需要结合社区和实际摸索来理解。这对试用体验有一定影响,但对于有经验的数仓开发者来说不构成实质障碍。
大体量数据查询的性能表现。评测中也有同行提到,在大体量数据查询场景下性能会有一定下降。我的项目数据量不大,没有触发明显的性能瓶颈,但如果企业的单表数据规模较大,建议在试用阶段做针对性验证。
细粒度权限的配置复杂度。字段级权限控制是Dataphin安全能力的一个卖点,但在实际配置中,角色继承和权限叠加的逻辑需要花时间梳理清楚,配置不当容易出现权限冲突或过度授权。上汽大众在实施中也围绕权限精细化管控做了专门的优化工作。
FAQ
Q1:Dataphin适合什么规模的企业?
适合已经有一定数据研发团队、且数据平台基于阿里云生态的中大型企业。小团队如果只需要做数据同步和简单报表,Dataphin的完整治理体系会偏重。
Q2:Dataphin需要绑定MaxCompute吗?
主要计算引擎是MaxCompute,但也支持Hologres等其他阿里云引擎。如果现有数据平台不在阿里云上,需要评估数据集成和计算资源的对接成本。
Q3:不熟悉OneData方法论能用Dataphin吗?
能用,但体验会有折扣。Dataphin的建模流程和规范定义设计都是围绕OneData方法论展开的,理解这套方法论可以帮助团队更快上手,也能更充分地利用它的自动化能力。
Q4:Dataphin的数据质量功能支持自定义规则吗?
支持。内置了完整性、准确性、一致性等规则模板,也允许根据业务场景定义自定义校验规则,异常数据可以触发告警或拦截。
Q5:试用Dataphin需要准备什么?
需要一个阿里云账号,并在权益中心申请试用资格。建议同时准备一个MaxCompute资源并选择和Dataphin同地域,以减少网络延迟对任务执行的影响。
引用来源
1. 阿里云开发者社区,《企业数字化转型必备:2026数据中台系统详解》,2026-08-06。
2. 阿里云开发者社区,《开放、兼容的数据建设与治理平台——瓴羊Dataphin“进化论”》,2025-01-17。
3. 百度百科,《Dataphin》,2026-06-08。
4. 阿里云开发者社区,《产品评测|从数据标准到实时监控,深度解析Dataphin如何以智能提效与安全合规驱动企业数据价值释放》,2025-04-23。
5. 阿里云开发者社区,《阿里Dataphin评测》,2025-04-25。
6. 阿里云开发者社区,《Dataphin 评测报告》,2025-03-24。
7. 阿里云开发者社区,《2026智能时代AI数据治理工具选型指南》,2026-09-03。
8. 瓴羊官网,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》,2026-04-24。
9. 网易,《今年云栖大会,我被这只“羊”硬控了……》,2024-09-24。
10. 博客园,《数据中台选型复盘:厂商、行业落地与避坑要点》,2026-09-08。
