
企业做数据平台时,经常会遇到几个问题:已经有 MySQL、Oracle,为什么还要建数据仓库?有了数仓,为什么又要做数据湖?MongoDB、Redis 这些 NoSQL 到底解决什么问题?ClickHouse、Doris 又应该放在哪一层?
之所以容易混淆,是因为它们都和“存数据”有关,但真正解决的问题并不在同一个层面。关系型数据库主要支撑业务交易,NoSQL解决特殊数据结构和访问模式,OLAP数据库负责大规模分析计算,数据仓库解决跨系统数据统一,数据湖承担海量原始数据沉淀,而湖仓一体试图进一步降低湖与仓之间的割裂。
所以判断一种存储技术是否合适,不能只看“能存多少、查询快不快”,而要同时考虑:数据是什么形态、怎样读写、对一致性要求多高、最终拿来做什么。
一、关系型数据库:核心是把每一笔业务“记准确”
关系型数据库最典型的代表是 MySQL、Oracle、SQL Server、PostgreSQL。它按照表、行、列组织数据,并通过主键、外键、唯一约束和事务机制维护数据之间的关系。例如一次订单支付,可能同时涉及订单创建、库存扣减、支付记录写入和账户余额更新。如果库存已经扣减,但支付失败,就会造成业务状态不一致。
因此关系型数据库非常强调 ACID事务。从业务视角理解,就是一组相关操作需要有明确的一致性边界:要么全部成功,要么全部回滚,不能留下“完成一半”的状态。 这也是它适合ERP、CRM、财务、订单、库存等核心业务系统的原因。

但业务数据库主要优化的是:大量用户同时对少量记录进行快速增删改查。 经营分析恰恰相反。查询一个订单状态,可能只读取一条记录;但分析过去三年的客户复购率,就需要扫描大量订单,再按照客户、时间等维度进行关联和聚合。
如果复杂统计长期直接跑在生产库上,分析任务与业务交易就会争抢CPU、内存和IO资源。因此需要区分:业务数据库负责记录业务事实,分析平台负责重新组织和解释这些事实。 真正做项目时,还会遇到一个更现实的问题:ERP在Oracle,CRM在MySQL,生产系统又使用SQL Server。
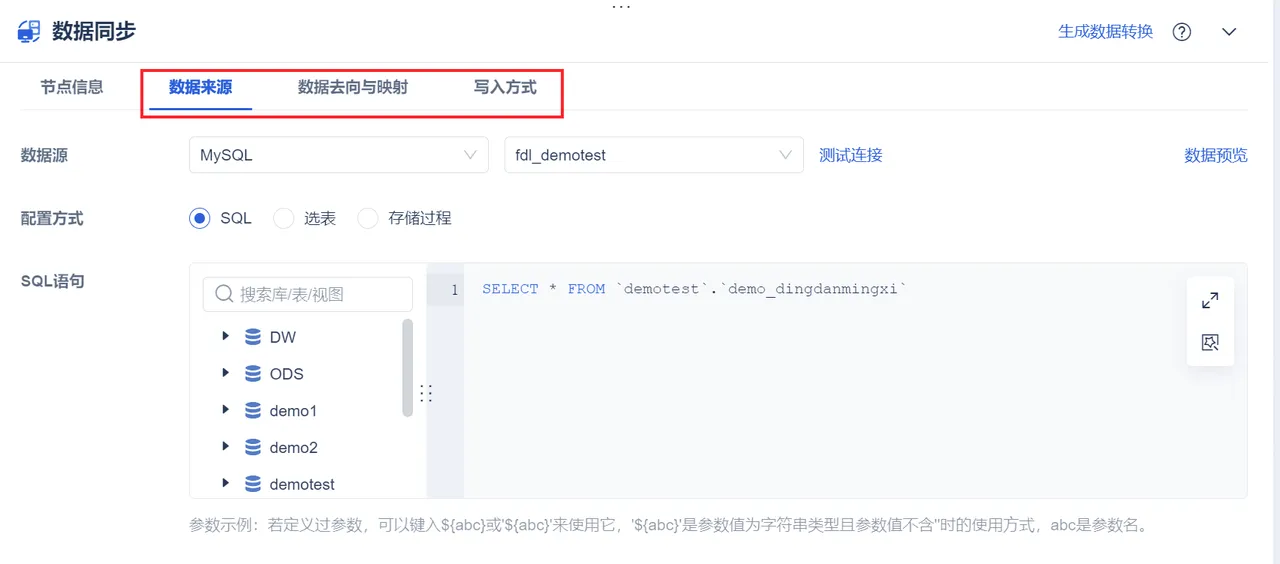
过去做跨系统报表时,常见做法是给不同数据库分别写抽数脚本。系统少的时候还能维护,一旦数据源和同步任务变多,字段变化、增量规则、失败重跑都会逐渐成为日常工作。
二、NoSQL:解决关系模型“不擅长”的那部分数据
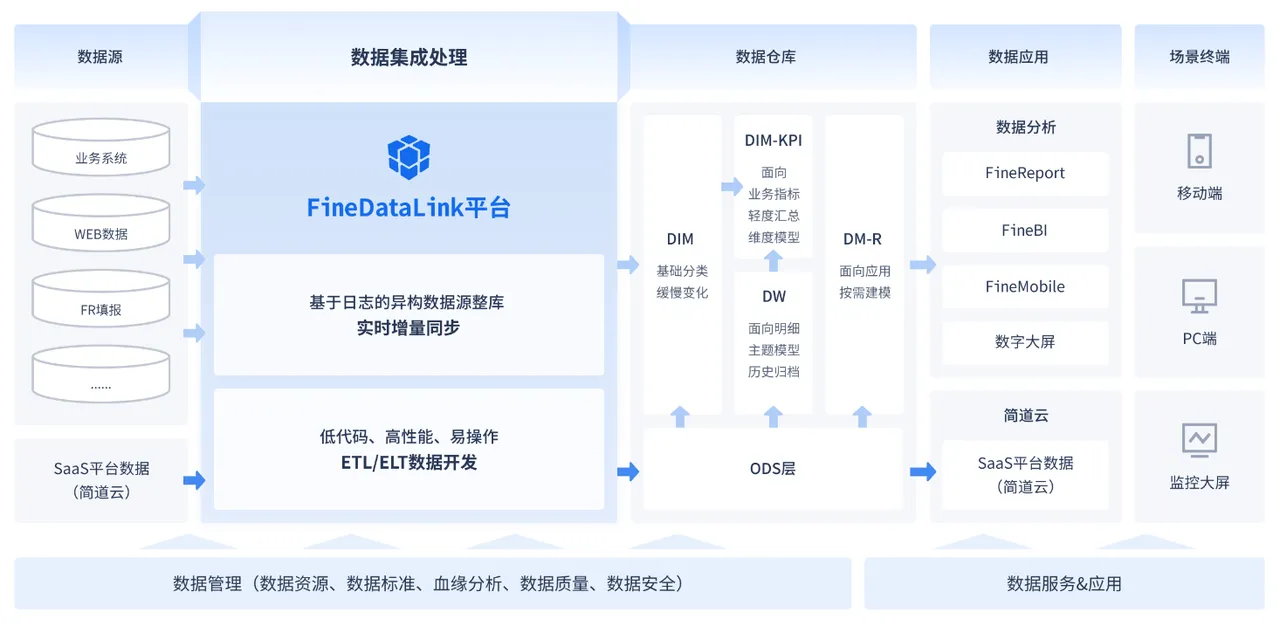
NoSQL并不是一种数据库,而是一类非关系型存储技术。常见的包括:键值数据库,如Redis; 文档数据库,如MongoDB; 宽列数据库,如HBase; 图数据库。
它出现的原因,并不是关系型数据库“不够先进”,而是不同业务的数据结构和访问方式差异很大,统一塞进二维表并不合理。 例如Redis擅长:根据一个Key快速定位一个Value。 商品缓存、Session、计数器、排行榜等场景,往往并不需要复杂关联,却存在大量高频读取。
MongoDB处理的又是另一类问题。例如用户画像中,不同用户拥有的标签、设备和行为特征差异很大。如果使用固定关系表,可能频繁增加字段或者产生大量空值;文档模型允许不同记录保留相对灵活的结构。
所以理解NoSQL的关键不是记住数据库名称,而是先判断访问模式。如果核心需求是强事务、复杂关联和结构化数据管理,关系型数据库依然重要;如果面对Key-Value访问、灵活文档、海量稀疏数据或者复杂关系遍历,NoSQL则可能承担其中一部分工作。
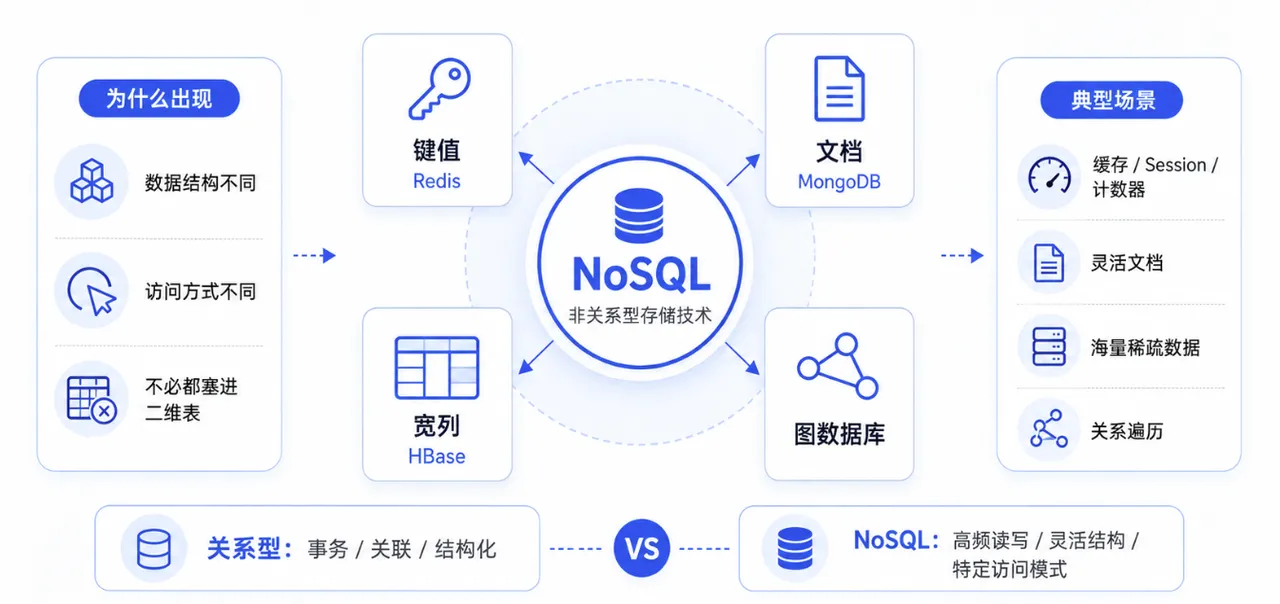
数据库选型匹配的是工作负载,而不是单纯的数据量。 一亿条结构清晰、事务要求很高的订单,并不会因为“数据量大”就天然应该迁移到NoSQL。
三、OLAP数据库:重点是“扫得少、算得快”
如果说业务数据库擅长处理单笔交易,那么OLAP数据库主要面向大规模统计分析。典型场景是:对几亿条订单,按照地区、客户、产品和月份同时汇总收入、数量、毛利和客单价。
这类查询通常具有几个特点:读取的数据很多,真正参与分析的字段较少;修改操作相对少,而过滤、聚合、分组非常频繁。 因此ClickHouse、Doris、StarRocks等分析数据库通常采用列式存储。
假设一张订单表有100列,而报表只计算日期、地区、商品、收入4列。行式存储可能读取大量本次查询用不到的数据,而列式存储可以集中读取真正参与计算的字段。
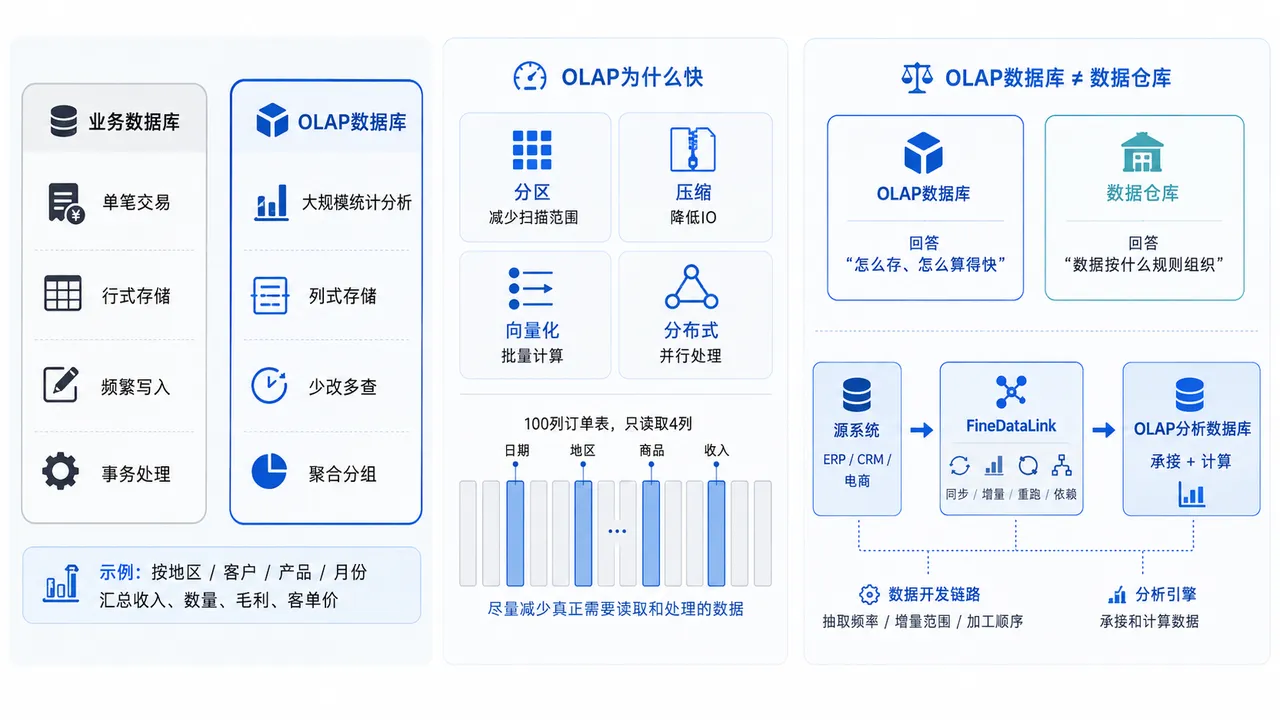
同时,OLAP数据库还会通过: 分区减少扫描范围; 压缩降低IO; 向量化执行批量计算; 分布式节点并行处理。 所以OLAP优化的核心并不仅仅是“机器性能更强”,而是尽量减少一次分析真正需要读取和处理的数据。
但要特别注意:OLAP数据库不等于数据仓库。 OLAP数据库主要回答“数据怎样存、查询怎样算得快”; 数据仓库回答的是“企业分析数据应该按照什么规则组织”。
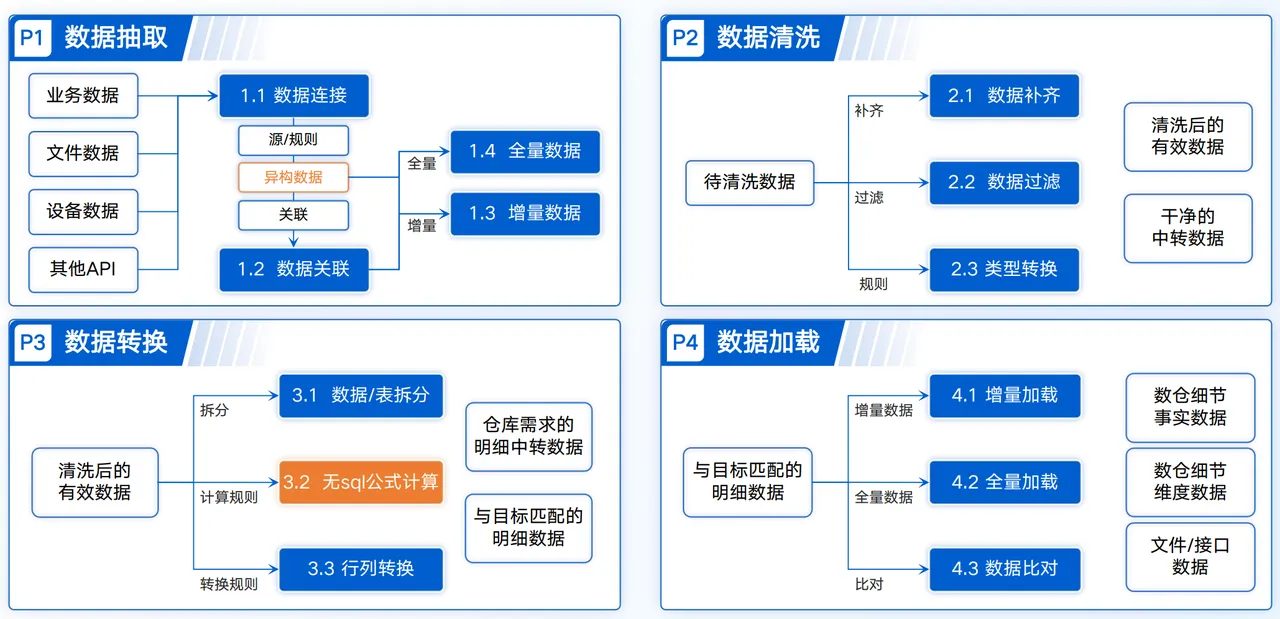
例如企业把Doris作为分析引擎后,真正麻烦的往往不是建表,而是每天怎样把ERP、CRM、电商等系统的新增数据稳定送进来。实际维护中,订单可能每10分钟同步一次,客户每天刷新,部分大表只同步当天增量,还要处理失败重跑和任务依赖。
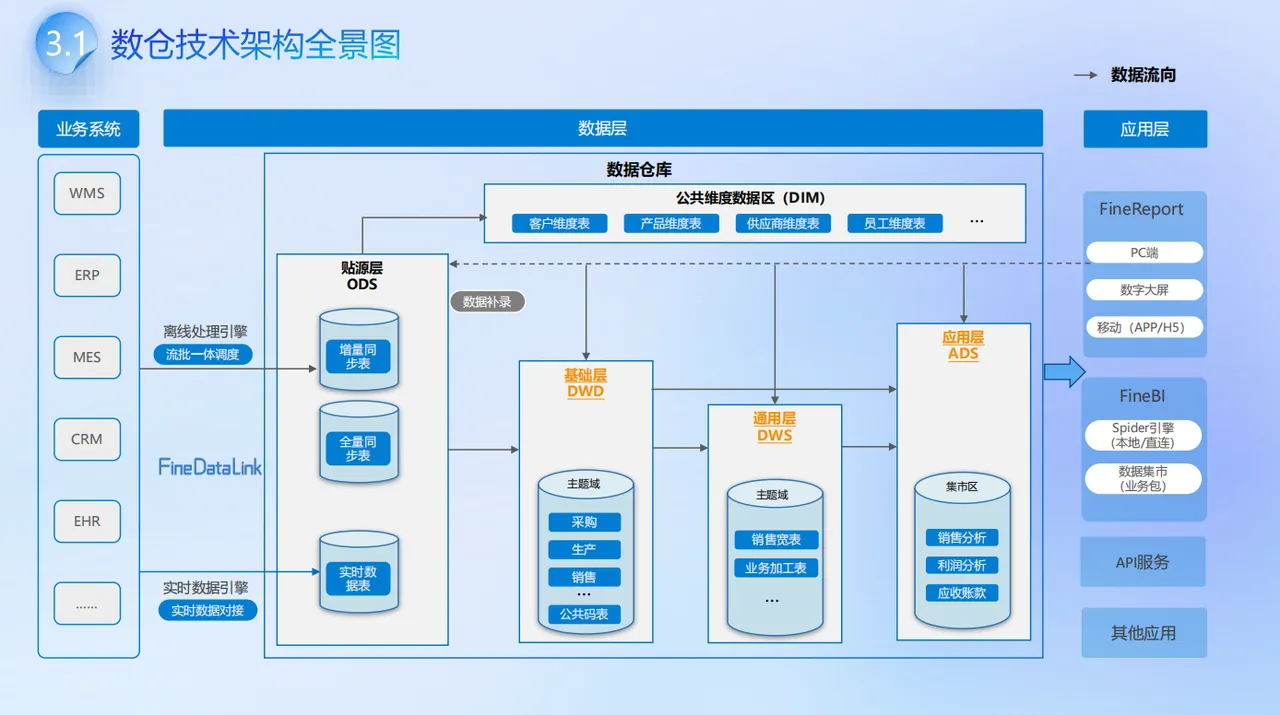
四、数据仓库:真正解决的是“企业到底相信哪套数据”
数据仓库最大的价值,不是把很多表搬到一个服务器,而是重新定义企业分析数据的组织方式。 例如“销售收入”看起来只是一个指标,实际上就可能存在多种口径:按下单日期统计;按发货日期统计;按签收日期统计;按财务收入确认日期统计。如果各部门直接从自己的系统取数,即使SQL都没有写错,结果仍然可能不同。
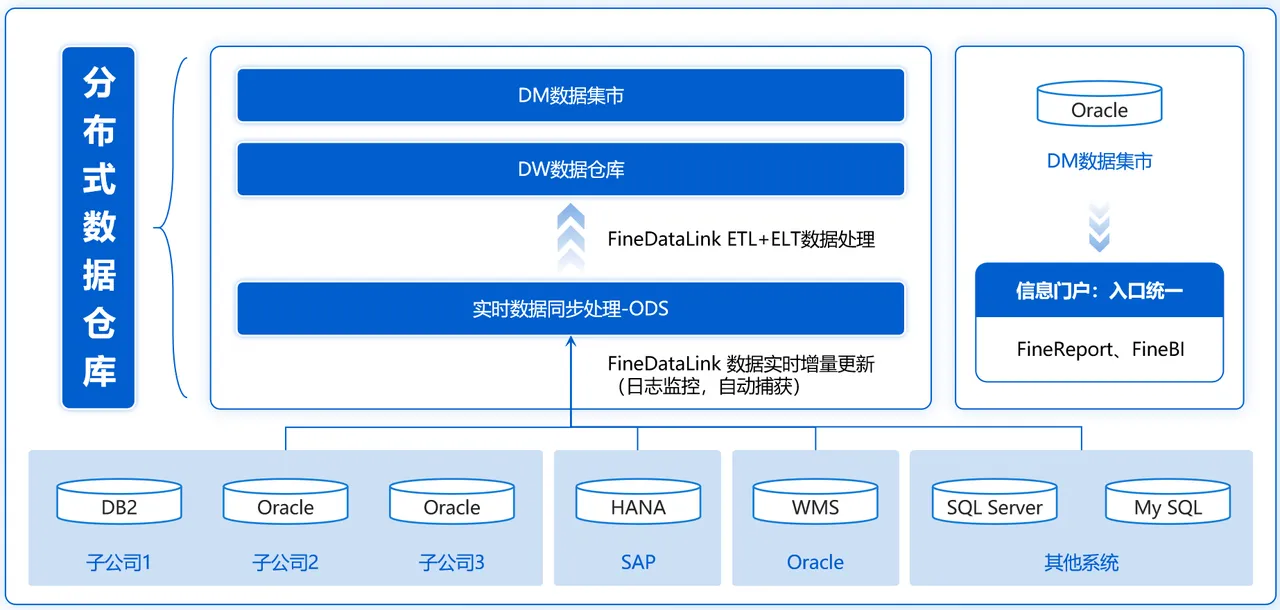
因此数仓建设需要对源数据逐层加工。
ODS:尽量保留源系统原貌
解决“原始数据有没有完整进入平台”。
DWD:形成统一业务明细
处理编码映射、字段标准化、清洗规则以及业务逻辑。
DWS:沉淀公共分析能力
围绕客户、商品、订单、供应链等主题形成公共汇总。
ADS:服务具体应用
面向经营分析、财务分析、营销分析等场景形成应用数据。
这一过程真正解决的是三个问题:同一个对象能不能识别成同一个对象;同一个业务事件能不能按照同一套规则解释;同一个指标能不能得到统一口径。
所以数据仓库本质上是一个数据语义统一工程。而真正进入实施阶段之后,数仓分层也不是画出ODS、DWD、DWS几层架构图就结束了。每天的数据要按照依赖关系持续跑起来:先同步订单,再关联商品和客户,再生成销售明细,最后才能计算主题汇总。
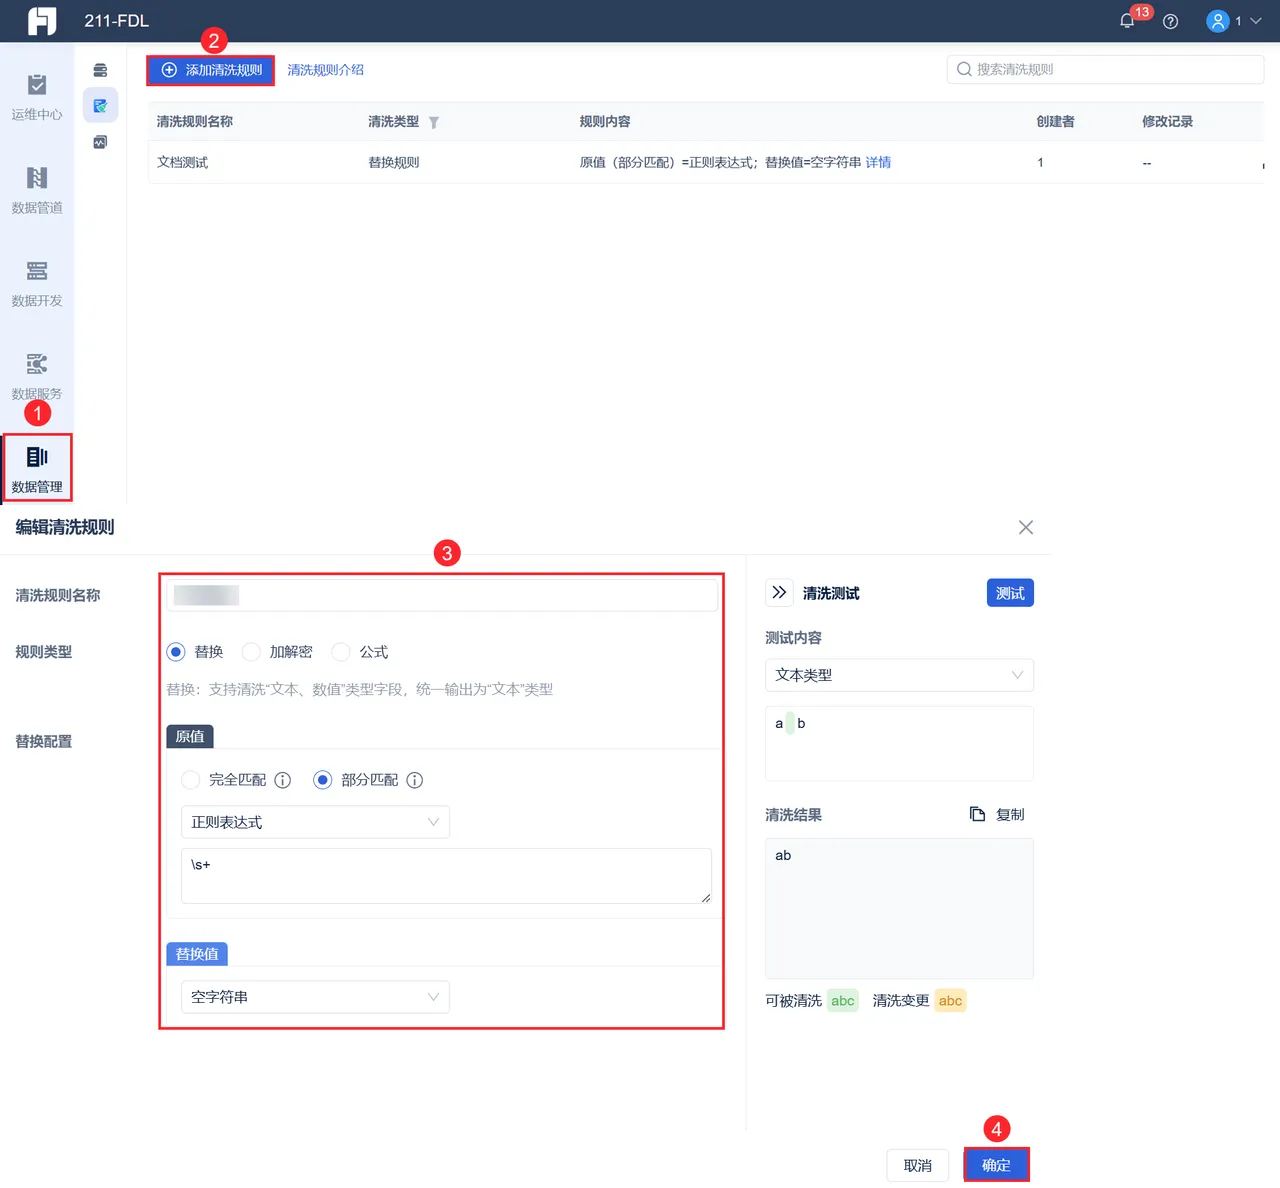
如果只完成数据搬运,没有主数据、维度、指标和业务规则统一,那么得到的仍然只是一个“大号数据库”,而不是成熟的数据仓库。
五、数据湖:不是“什么都存”,而是保留数据未来被利用的可能
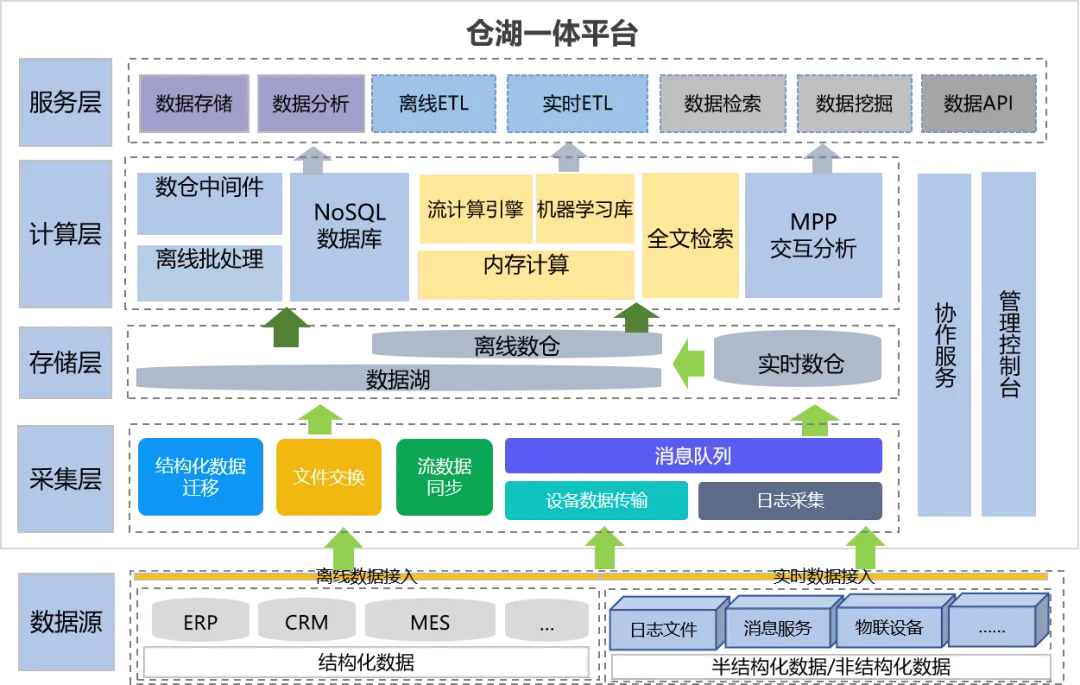
数据仓库擅长结构化数据,但企业现在产生的数据远不止数据库表。还有日志、JSON、图片、音视频、PDF、IoT设备数据以及AI训练数据。
这类数据有一个共同特点:采集的时候,往往还无法完全确定未来怎样使用。 如果要求每种数据进入平台之前,都必须提前设计完整模型,建设成本会很高。
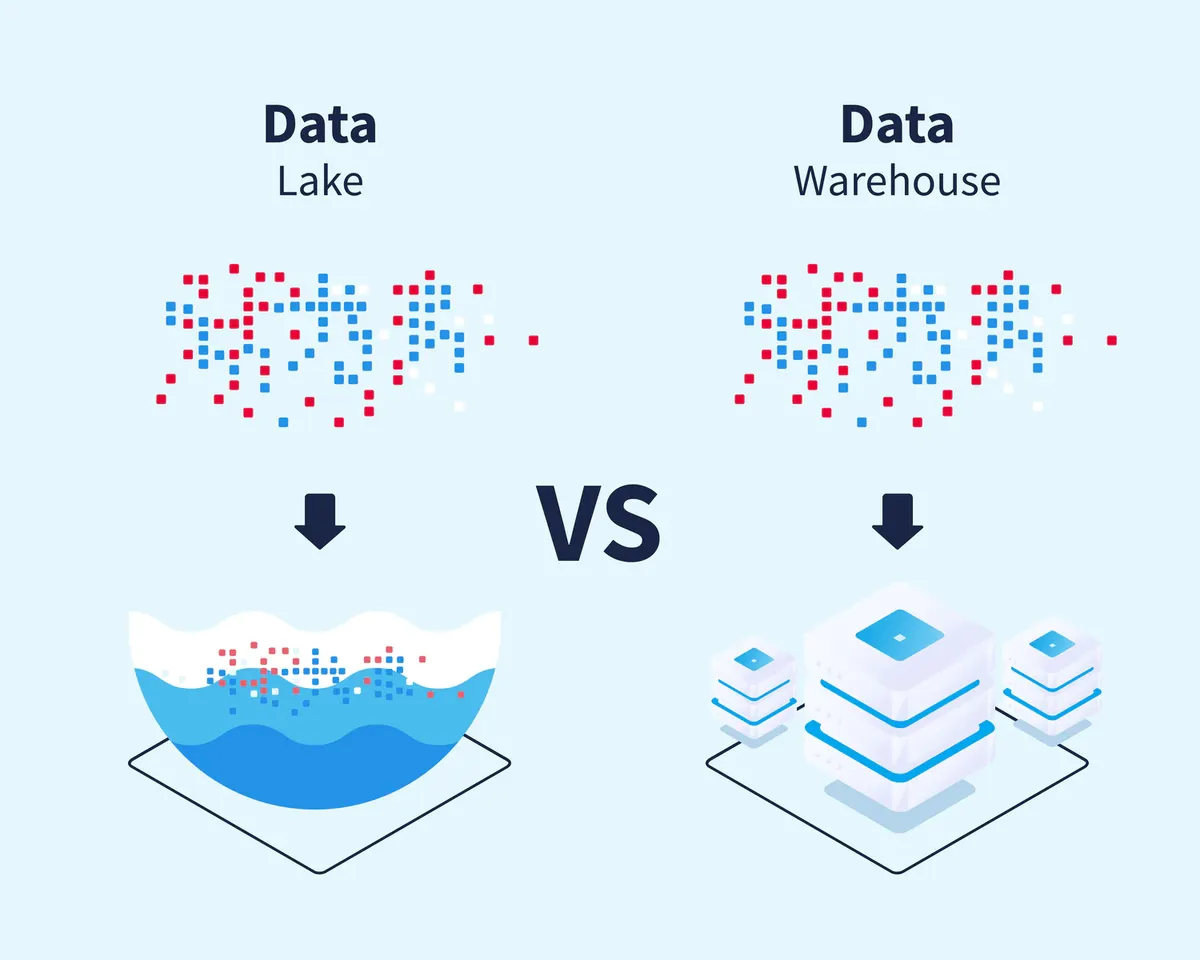
数据湖采用的是另一种思路:先尽量保留原始数据,真正使用时再根据具体场景加工。 因此数仓更强调 Schema on Write:写入之前先确定结构。
数据湖更强调 Schema on Read:数据先保存,在读取和计算时再解释结构。 例如一批设备日志,今天可能只是用来排查故障,未来还可能被用于训练预测性维护模型。只要原始数据仍然保留,就还有重新解释和加工的空间。
但“什么都能存”同样带来风险。如果只有文件进入数据湖,却没有元数据、数据目录、权限、质量和生命周期管理,几年之后很容易出现大量不知道来源、含义和可信度的数据。数据湖真正的风险不是容量不够,而是数据的可发现、可理解和可治理能力跟不上。
实际架构中,一份源数据也未必只有一个去向。比如订单明细进入数仓服务经营分析,完整历史数据进入湖中长期保存,业务日志直接落湖供算法使用。
六、湖仓一体:真正要减少的是数据重复和架构割裂
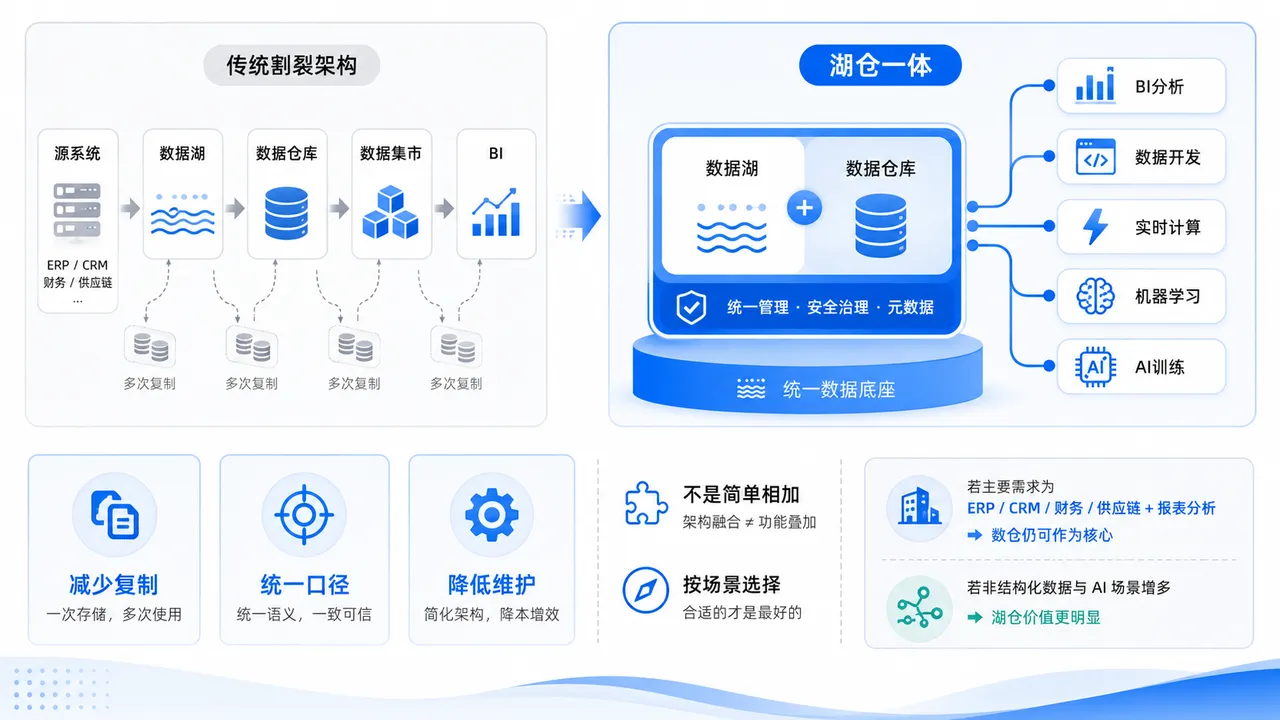
传统架构中,数据湖和数据仓库往往各自发展。于是可能形成:源系统 → 数据湖 → 数据仓库 → 数据集市 → BI同一份数据在不同层之间不断复制。
数据湖具有开放、扩展性强的特点,但传统湖架构在事务、一致性和高性能SQL分析方面存在短板;数据仓库分析能力成熟,但并不是为大量原始、半结构化和非结构化数据设计的。
湖仓一体试图解决的正是这种割裂。它的核心并不是简单把湖和仓“拼起来”,而是:让同一套底层数据同时拥有数据湖的开放性,以及数仓需要的表管理、事务、元数据和分析能力。
于是同一份数据可以同时面向:BI分析;数据开发;实时计算;机器学习;AI训练。这背后真正希望降低的是三类成本。第一,数据复制成本。 减少同一份数据反复在湖、仓、数据集市之间搬运。第二,口径分裂成本。 尽量让BI、算法和其他数据应用基于一致的数据底座工作。第三,平台维护成本。 减少多套存储长期并行带来的任务、权限和治理复杂度。
但湖仓一体也不是“传统数仓升级版”的同义词。如果企业数据主要来自ERP、CRM、财务和供应链系统,核心需求仍然是报表分析、指标统一和经营决策,那么成熟的数据仓库完全可能继续承担核心作用。只有当非结构化数据增加、AI场景增多、湖仓之间反复复制越来越明显时,湖仓一体的价值才会进一步体现。技术升级应该来源于实际架构问题,而不是来源于技术名词更新。
结语
关系型数据库、NoSQL、OLAP数据库、数据仓库、数据湖和湖仓一体,对应的是企业数据生命周期中的不同问题。关系型数据库关注交易是否准确;NoSQL关注特殊数据模型和访问方式;OLAP数据库关注大规模分析效率;数据仓库关注企业分析口径能否统一;数据湖关注原始、多类型数据能否长期沉淀;湖仓一体关注如何减少湖与仓之间的复制和割裂。
所以真正做技术选型时,不应该先问:“现在最流行什么数据库?”而应该先回答:数据在哪里产生读写模式是什么?需要多强的一致性?是服务交易、分析还是AI?需要保存加工结果,还是保留原始数据?
把这些问题回答清楚之后,很多技术选择其实会自然浮现。数据架构的成熟度,从来不取决于用了多少种数据库,而取决于是否让每一种存储技术承担了它真正应该承担的工作。



