
在AI应用开发、智能体搭建、代码工程落地、文档解析等场景中,模型选型直接决定项目效果、响应速度与调用成本。很多开发者初次接触Qwen系列模型时,很容易混淆Qwen3.8‑Max、Qwen3.7‑Max、Qwen3.7‑Plus、Qwen3.7‑Flash之间的定位差异,单纯依靠模型名称判断能力,出现选用高成本模型做简单任务造成预算浪费,或是选用轻量模型处理复杂推理任务,导致结果质量不达预期的情况。四款模型虽然都具备百万级上下文窗口,支持工具调用、结构化输出、思考模式,但在模态支持、推理深度、多模态能力、响应速度、单位Token定价上有着明确的区分。本文将逐一拆解四款模型的核心功能、能力边界、优势短板,结合业务场景给出选型建议,同时提供可直接运行的API调用代码,演示不同模型之间的切换方式,帮助开发者快速匹配业务需求,平衡推理质量、响应时延与调用开销。
一、四款模型基础定位与核心能力总览
Qwen3.8‑Max是该系列全新旗舰模型,属于多模态全能旗舰,支持文本、图像、长视频输入,在复杂逻辑推理、数学计算、大型项目代码开发、专业文档深度解析、长周期Agent自主任务闭环方面达到最高水准。它支持1M上下文窗口,原生支持深度思考模式,内置工具调用、网页检索、结构化输出能力,能够处理多轮复杂智能体任务,比如独立规划完整软件开发项目、解析上百页法律合同、分析长视频中的逻辑信息。适合对结果精度要求极高,预算充足,处理复杂专业任务的场景。详情👉访问阿里云百炼大模型服务平台页面 了解。
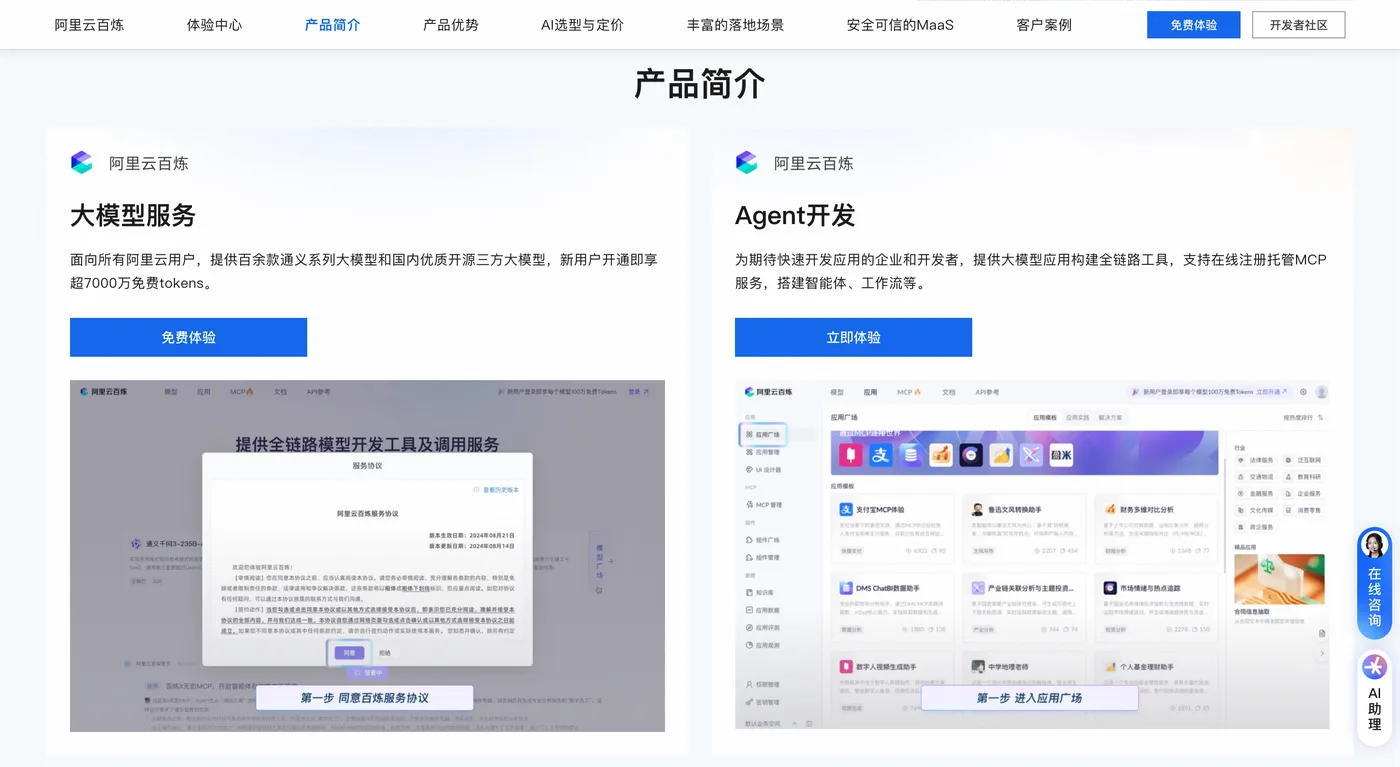
Qwen3.7‑Max是3.7系列的文本旗舰,仅支持文本输入输出,不具备图像、视频多模态理解能力。它的核心优势集中在纯文本领域的深度推理、长文本逻辑梳理、复杂代码编写、长循环智能体任务,同样拥有1M上下文,支持Function Calling、结构化输出、上下文缓存。当业务只需要处理大量纯文字文档、代码库、文本类Agent任务,不需要图片和视频解析时,Qwen3.7‑Max是纯文本高难度任务的优选。如果业务需要识图、解析截图、读取图表,这款模型就无法完成,这是和Plus版本最核心的分界线。
Qwen3.7‑Plus是均衡型多模态模型,兼顾文本推理、图像理解、图表识别、截图OCR,同时拥有完整的工具调用与Agent能力,1M上下文窗口。它在文本任务上的推理能力弱于3.7‑Max,但是补齐了多模态短板,能够同时处理文字、图片、截图、图表,性价比突出。适合大量混合输入场景,比如上传带图表的PDF文档、截图代码识别、GUI视觉智能体、图文混合知识库问答。在企业知识库、RAG检索增强、图文内容生成、简单视觉Agent项目中应用广泛,也是很多AI编程工具、知识库平台的默认选择。
Qwen3.7‑Flash属于高速经济型多模态模型,同样支持图文输入,保留基础工具调用和结构化输出能力,核心卖点是更低的调用单价、更快的响应速度,推理成本远低于Max和Plus系列。它的短板在于复杂推理、超长链式任务、高难度数学问题能力会有所下降,适合高并发、大批量简单任务,例如简单文档摘要、图片OCR、基础问答、批量内容分类、客服对话等吞吐量优先的场景。当业务请求量大,单条请求逻辑简单,需要控制整体Token开销,优先选择Flash版本。
二、功能维度详细对比,厘清能力边界
1. 输入模态区分
Qwen3.8‑Max:文本、图片、长视频全部支持,多模态推理能力最强,不仅可以识别图片文字,还可以理解图表逻辑、分析视频内的时序信息,支持大量图片批量输入,适合多模态复杂分析任务。
Qwen3.7‑Max:纯文本模型,仅能接收文字输入,图片、视频传入后无法识别内容,只会将图片链接当作普通文本处理,无法解析画面信息。
Qwen3.7‑Plus:文本+图像多模态,支持图片、截图、图表解析,可处理图片内公式、表格,不支持长视频深度理解。
Qwen3.7‑Flash:文本+图像,基础识图、OCR能力完备,图片理解精度弱于Plus和3.8‑Max,适合简单图文识别。
2. 上下文窗口与长文本处理
四款模型都支持1M Token超长上下文,能够一次性读取几十万字的文档、完整代码仓库文件,不需要做文档切片拆分。但长文本推理质量存在差距。Qwen3.8‑Max在百万字长文档的细节检索、跨章节逻辑关联上表现最优;Qwen3.7‑Max在纯文本长文档逻辑推理表现优秀;Qwen3.7‑Plus可以处理图文混合长文档;Qwen3.7‑Flash虽然支持1M上下文,但超长文档里面的细节召回、复杂逻辑推理能力偏弱,适合长文档摘要、提取要点,不适合深度推理。
3. 工具调用与智能体Agent能力
四款模型全部支持Function Calling函数调用、内置工具、结构化JSON输出,能够构建自主规划、工具调用、结果校验的Agent闭环。能力梯度由高到低依次为Qwen3.8‑Max > Qwen3.7‑Max > Qwen3.7‑Plus > Qwen3.7‑Flash。
3.8‑Max可以完成多步骤、跨工具的复杂长周期Agent任务,自主拆分复杂目标,多次调用工具,迭代校验结果;3.7‑Max擅长纯文本类Agent,例如代码工程智能体、文档分析智能体;3.7‑Plus适合图文混合的Agent,例如读取截图,调用工具完成网页检索;3.7‑Flash适合简单工具调用,单轮短任务,复杂多轮Agent容易出现规划断裂、工具调用参数错误。
4. 代码编写能力
Qwen3.8‑Max在大型工程代码开发、复杂算法实现、调试排错、多文件项目架构设计上最强,能够生成完整可运行项目,处理复杂业务逻辑代码。Qwen3.7‑Max纯文本代码能力优秀,适合纯代码仓库分析、后端逻辑开发。Qwen3.7‑Plus兼顾代码+图片场景,比如根据UI截图生成前端代码,识别截图中的报错信息进行调试。Qwen3.7‑Flash适合简单代码片段生成、脚本编写,复杂项目架构设计能力有限。详情👉访问阿里云百炼大模型服务平台页面 了解。
5. 响应速度与计费成本
从推理速度上:Qwen3.7‑Flash > Qwen3.7‑Plus > Qwen3.7‑Max > Qwen3.8‑Max;
从单位Token调用价格上:Qwen3.7‑Flash最低,Qwen3.8‑Max价格最高。
高并发场景,每秒大量请求,如果选用Max系列,会带来很高的账单压力;而Flash版本可以大幅降低单位请求成本。在低频、高价值专业任务场景,优先选用旗舰Max模型,牺牲部分速度换取更高的推理质量。
三、分场景选型策略
场景1:复杂专业推理、大型项目开发、长视频深度解析、高价值复杂Agent任务。推荐选择Qwen3.8‑Max。例如法律合同深度审查、金融财报全文档分析、完整网站项目开发、长视频内容理解、多工具复杂自主智能体。
场景2:纯文本高难度任务,不需要图片视频,超大代码库分析、纯文本长文档逻辑推理、纯文本Agent。推荐Qwen3.7‑Max。如果业务完全没有图片输入,使用3.7‑Max相比3.8‑Max能够节约成本,同时保留顶级纯文本推理能力。
场景3:图文混合场景,需要识图、解析图表、截图OCR,兼顾性能与成本,搭建RAG知识库、视觉辅助编程、图文问答。推荐Qwen3.7‑Plus。这是平衡能力与价格的主力生产模型,也是绝大多数企业知识库、AI助手项目的首选。
场景4:高并发批量任务,简单问答、文档摘要、图片文字提取、内容分类、客服机器人,请求量大,单条任务逻辑简单,追求低成本高吞吐。推荐Qwen3.7‑Flash。在大规模批量处理场景,能够显著降低整体Token消耗。
很多项目可以采用多模型混合架构,实现分层调用。例如使用Flash处理绝大多数简单请求,当检测到任务属于复杂推理、图文复杂分析时,自动路由切换到Plus或者3.8‑Max,这样兼顾成本和效果。
四、API代码实操:四款模型调用与动态路由示例
下面提供Python调用代码,只需要修改模型名称参数,即可切换四款模型,方便开发者快速测试对比效果。调用前需要配置环境变量DASHSCOPE_API_KEY,填入平台获取的API Key。
import os
import requests

# 模型名称配置,切换模型只需要修改此处model变量
# "qwen3.8-max" / "qwen3.7-max" / "qwen3.7-plus" / "qwen3.7-flash"
model = "qwen3.7-plus"

api_key = os.getenv("DASHSCOPE_API_KEY")
url = "https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions"
headers = {

    "Authorization": f"Bearer {api_key}",
    "Content-Type": "application/json"
}

def llm_call(user_prompt, model_name):
    payload = {

        "model": model_name,
        "messages": [
            {
   "role": "user", "content": user_prompt}
        ],
        "temperature": 0.7,
        "max_tokens": 2048
    }
    resp = requests.post(url, headers=headers, json=payload)
    return resp.json()

if __name__ == "__main__":
    prompt = "分析这份技术文档,梳理系统架构,输出结构化JSON结果"
    result = llm_call(prompt, model)
    print(result)
在服务器终端执行环境变量配置命令:
# 配置API密钥
export DASHSCOPE_API_KEY="sk-xxxxxxxxxxxxxxxxxxxxxxxx"
# 运行脚本
python3 qwen_model_test.py
如果需要实现多模型自动路由,编写简单判断逻辑,根据用户输入是否包含图片链接、任务复杂度自动选择模型,示例代码片段:
def select_model(user_content, has_image:bool):
    # 包含图片,复杂任务,选择qwen3.8-max
    if has_image and len(user_content) > 3000:
        return "qwen3.8-max"
    # 包含图片,常规图文任务,选择qwen3.7-plus
    elif has_image:
        return "qwen3.7-plus"
    # 纯文本超长复杂推理,选择qwen3.7-max
    elif len(user_content) > 5000:
        return "qwen3.7-max"
    # 其余简单任务,使用flash节约成本
    else:
        return "qwen3.7-flash"
这个路由逻辑可以直接集成到后端服务,实现模型自动调度,避免所有请求都使用旗舰模型,有效控制项目整体调用费用。
同时可以使用CLI命令查询模型调用的用量消耗,方便监控不同模型的Token开销:
aliyun dashscope ListCallRecords --StartTime 2026-09-01T00:00:00Z --EndTime 2026-09-16T23:59:59Z
该命令可以查看不同模型的调用次数、输入输出Token消耗,统计每款模型的账单占比,评估模型选型是否合理。
五、选型常见踩坑点与避坑指南
第一,误用Qwen3.7‑Max处理图片。很多开发者没有注意3.7‑Max是纯文本模型,传入图片链接,模型无法识别图片内容,只会返回无效结果。如果业务有图片、截图、图表解析需求,必须切换到Plus或者3.8‑Max。详情👉访问阿里云百炼大模型服务平台页面 了解。
第二,全部请求统一使用旗舰模型。不少开发者为了省事,所有请求全部使用Qwen3.8‑Max,简单问答、短文本摘要这类低难度任务也使用旗舰模型,造成Token成本成倍上涨。建议分层路由,简单任务交给Flash。
第三,高估Flash模型复杂推理能力。Qwen3.7‑Flash适合简单任务,遇到复杂数学、多步骤逻辑、长链式Agent任务,容易出现幻觉、逻辑断裂,不要在高价值复杂业务场景直接上线Flash。
第四,忽略上下文缓存优化。四款模型都支持上下文缓存,在多轮对话、RAG知识库场景开启缓存,可以大幅降低输入Token消耗,减少账单。尤其是百万上下文场景,缓存优化带来的成本下降效果非常明显。
第五,测试环境与生产环境模型不一致。本地调试使用3.8‑Max,上线后切换Flash,没有做充分回归测试,出现生产环境输出质量下降,建议上线前针对目标模型做完整效果评估。
六、计费与订阅方案搭配建议
四款模型都支持Token按量计费、资源包抵扣,也可以使用Token Plan订阅套餐。旗舰模型3.8‑Max的单位Token单价最高,适合低频高价值任务;3.7‑Flash单价最低,适合高吞吐业务。在项目开发阶段,可以先用新人免费额度测试四款模型,评估业务效果,确认满足需求之后,再购买对应模型的资源包,相比按量计费更划算。
如果是Agent项目,需要大量调用工具,频繁多轮对话,优先看总Token消耗量。很多Agent项目的Token消耗集中在多轮迭代,选择模型时不仅要看单次调用质量,还要评估整体吞吐成本。可以使用上面提供的调用记录查询命令,统计开发阶段不同模型的Token消耗,预估正式上线后的账单。
七、常见问题解答
问题1:Qwen3.8‑Max和Qwen3.7‑Max怎么选?如果业务需要图片、视频理解,只能选3.8‑Max;纯文本复杂推理,不需要多模态,3.7‑Max性价比更高。
问题2:Qwen3.7‑Plus和3.7‑Flash的区别?Plus推理更强,多模态识别精度更高,适合复杂图文任务;Flash速度更快、更便宜,适合大批量简单图文OCR、摘要。
问题3:四款模型的上下文都是1M,是否代表处理长文档效果一样?并不是。虽然窗口长度一致,但是长文本里面的细节召回、逻辑推理能力,旗舰模型明显优于Flash,Flash能读取长文本,但很难完成深度的跨段落逻辑分析。
问题4:模型是否支持微调?四款模型不支持用户侧微调,业务个性化需求,推荐使用RAG检索增强,或者通过System Prompt、结构化输出约束来实现。
在AI项目落地的整个流程中,模型选型不是一次性决策,需要持续监控调用日志、输出质量、账单消耗。项目初期可以并行测试多款模型,利用代码脚本批量跑业务测试用例,对比输出效果,再确定最终上线模型,同时预留模型切换接口,方便后续迭代调整。结合分层路由策略,把简单任务交给经济型模型,复杂高价值任务交给旗舰模型,在输出质量和成本之间找到最优平衡点。理解Qwen3.8‑Max、Qwen3.7‑Max、Qwen3.7‑Plus、Qwen3.7‑Flash之间的能力差异,是搭建稳定、低成本AI应用与智能体的基础,开发者可以根据业务模态、任务复杂度、并发规模、预算约束,快速锁定最合适的模型方案。



