模型越接越多,API Key、用量和分配额度怎么管?
接入一个大模型时,事情通常很简单:申请 API Key、填入接口地址、写几行调用代码,就能跑起来。
但当模型从一个变成多个,问题也会一起变多。
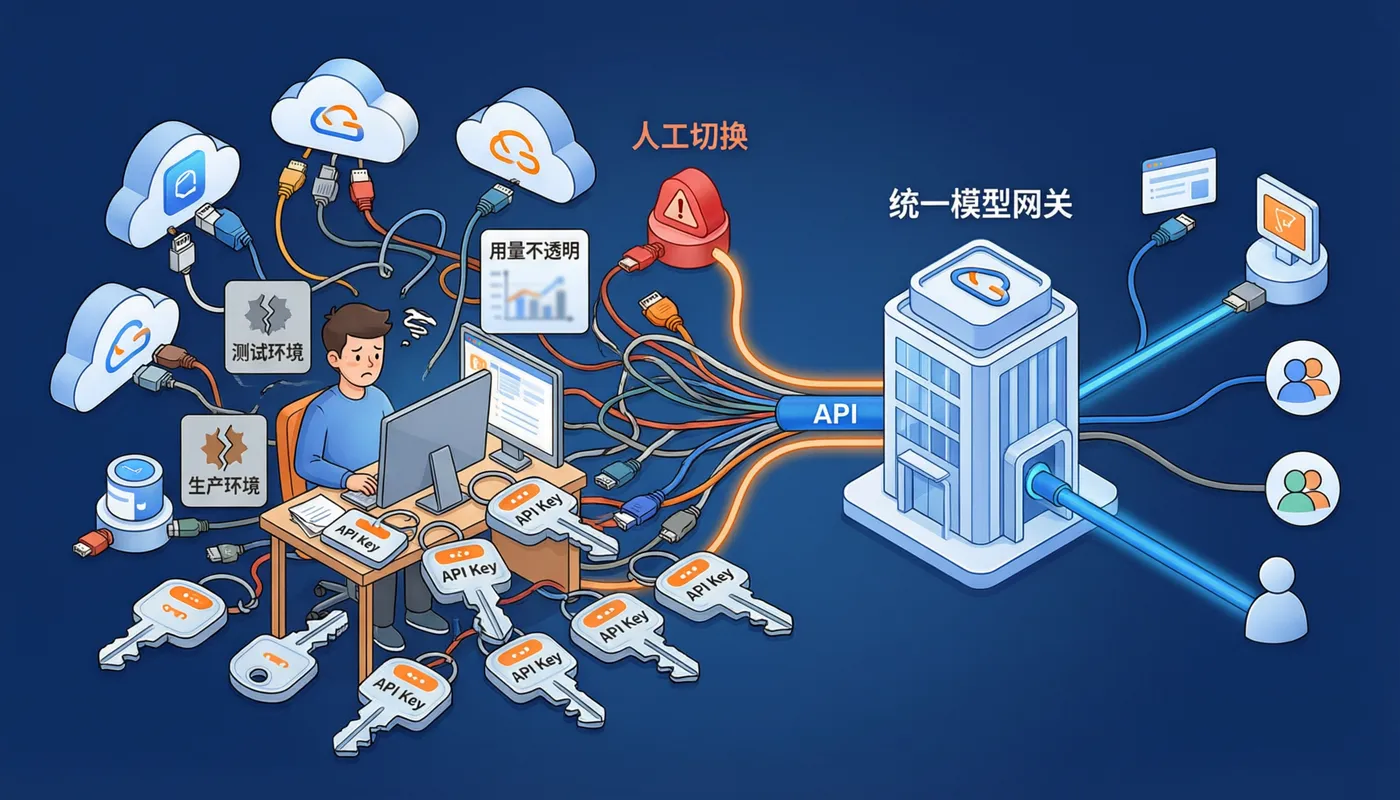
不同模型有不同的接口格式,API Key 分散在多个项目里;测试环境和生产环境各用一套配置;团队成员都在调用,却很难看清谁用了多少;某个上游服务临时不可用时,业务还需要人工切换。
不少开发者因此认识了 OpenRouter。它把多个模型和供应商接到一个托管入口后面,开发者使用一个 API,就能更方便地选择模型、切换供应商。对于个人尝鲜和快速验证,OpenRouter 的优势很直接:不用自己部署,注册后即可使用。
但如果希望使用自己的上游 API Key,把模型入口部署在自己的云环境里,或者进一步管理内部应用、团队成员和外部用户,就需要一套可自建的模型网关。
LiteLLM 和 New API,正是模型网关的两种开源方案。
它们都不是大模型,位于业务应用与上游模型服务之间,负责统一接口、管理访问、分配额度和转发请求。
从 OpenRouter 到 LiteLLM、New API:如何选择大模型统一入口?
LiteLLM 和 New API 都能帮助客户统一接入多个模型,并且在用户、密钥、额度、渠道和路由等能力上存在交叉。
它们的主要区别不是“有没有某项功能”,而是产品重心和管理流程不同:LiteLLM 更关注应用如何稳定、统一地调用模型;New API 更关注如何通过可视化后台管理用户、Token、渠道和额度。
因此,选型时不必先比较功能数量,而应先判断当前最需要优化的是应用侧工程治理,还是多用户 API 管理。
对比维度 |
LiteLLM |
New API |
github stars |
58.8k |
48.1k |
核心定位 |
面向研发和平台团队的模型网关 |
面向多用户管理与运营的 API 管理平台 |
更适合谁 |
研发团队、AI 平台团队、企业技术团队 |
个人开发者、小团队、API 服务及运营团队 |
统一模型接口 |
支持 |
支持 |
用户管理 |
支持用户、团队及应用维度管理,更偏内部治理 |
用户注册、账号和权限体系更完整 |
Token 管理 |
通过 Virtual Key 管理模型权限、预算及速率限制 |
可为用户或项目创建独立 Token,并配置额度和有效期 |
额度与运营 |
侧重预算控制和成本追踪 |
侧重额度分配、用量统计、充值、订阅等运营能力 |
观测性 |
关注调用日志、费用、延迟、错误及外部监控集成 |
关注渠道日志、用户用量和消费记录 |
上手门槛 |
更适合具备一定开发、配置和运维能力的团队 |
后台操作相对直观,非研发人员参与管理更方便 |
LiteLLM:更偏向研发团队的模型网关
假设一个团队同时在做智能客服、代码助手和内容生成。三个应用使用的模型不同,调用量也不同。如果每个应用都直接保存上游 API Key,并分别开发重试、日志和成本统计,模型越多,维护工作就越重。
LiteLLM 的核心价值,是为不同模型提供统一的调用入口,并把路由、容错、成本和访问控制集中到网关层。
主要包含六项能力:
- 统一 API:用 OpenAI 兼容接口调用 OpenAI、通义千问、Claude、Gemini、MiniMax 等模型。
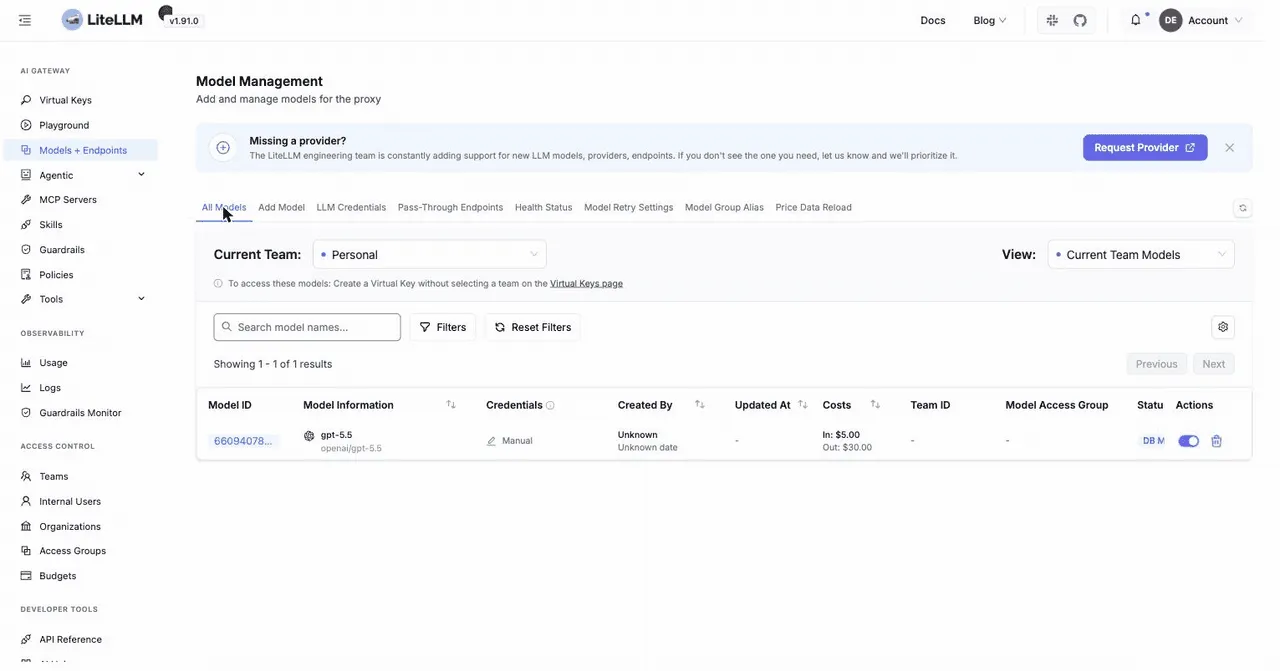
- 模型管理:集中配置模型、供应商、API Key、Base URL 和部署参数。
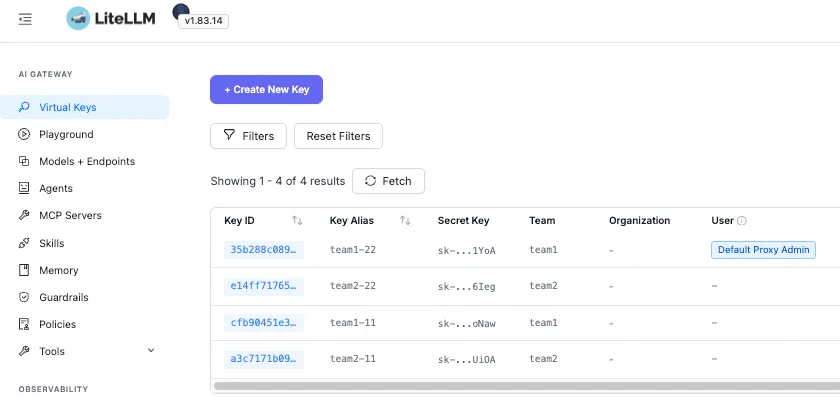
- 密钥与权限:通过 Virtual Key 为不同应用、团队分配权限;Master Key 仅用于网关管理。
- 预算与限流:按用户、团队或 Key 设置预算、RPM、TPM 和并发限制。
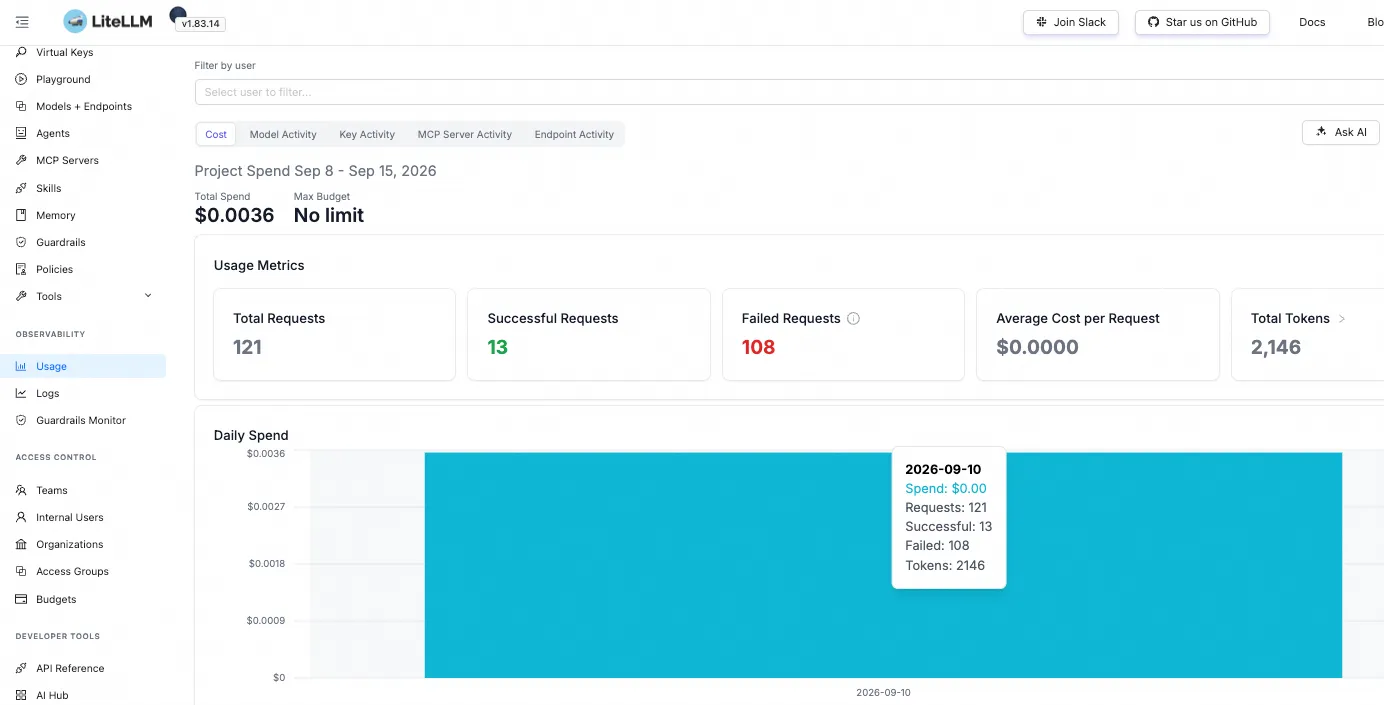
- 日志与用量:统计请求量、Token、费用、延迟和错误,支持调用链排查;日志正文默认不一定保存。
- 路由与容灾:在多个模型部署间负载均衡,并支持重试、冷却、超时和故障回退。
- 统一 API:一次接入,多模型复用
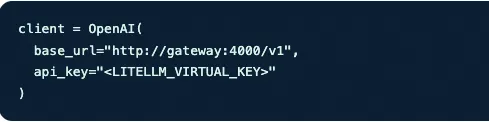
- 配置模型:添加上游模型服务商,配置秘钥与可用模型。
- Virtual Keys:把上游密钥留在网关
应用拿到的是 LiteLLM 生成的虚拟密钥,而不是供应商原始 API Key。每个 Key 可绑定团队、用户、模型范围、预算、限流和有效期,便于撤销、轮换与审计归属。
- 日志与用量监控:定位每一次调用
日志页面可追踪成功/失败状态、请求 ID、模型、Key、团队、Token 与成本,并查看请求级详情。它是费用归因、异常定位和模型切换验证的共同证据层。
New API:更偏向多用户 API 管理与运营
New API 同样可以连接多个上游模型渠道,并提供统一接口。但相比 LiteLLM,它把更多能力放在用户、令牌、额度和运营管理上。
部署完成后,管理员可以通过自建实例的可视化后台配置模型渠道、管理用户、创建访问令牌,并查看调用量和费用。
主要包含六项能力:
- 统一 API:兼容 OpenAI、Anthropic、Gemini 等接口,统一接入多家模型服务。
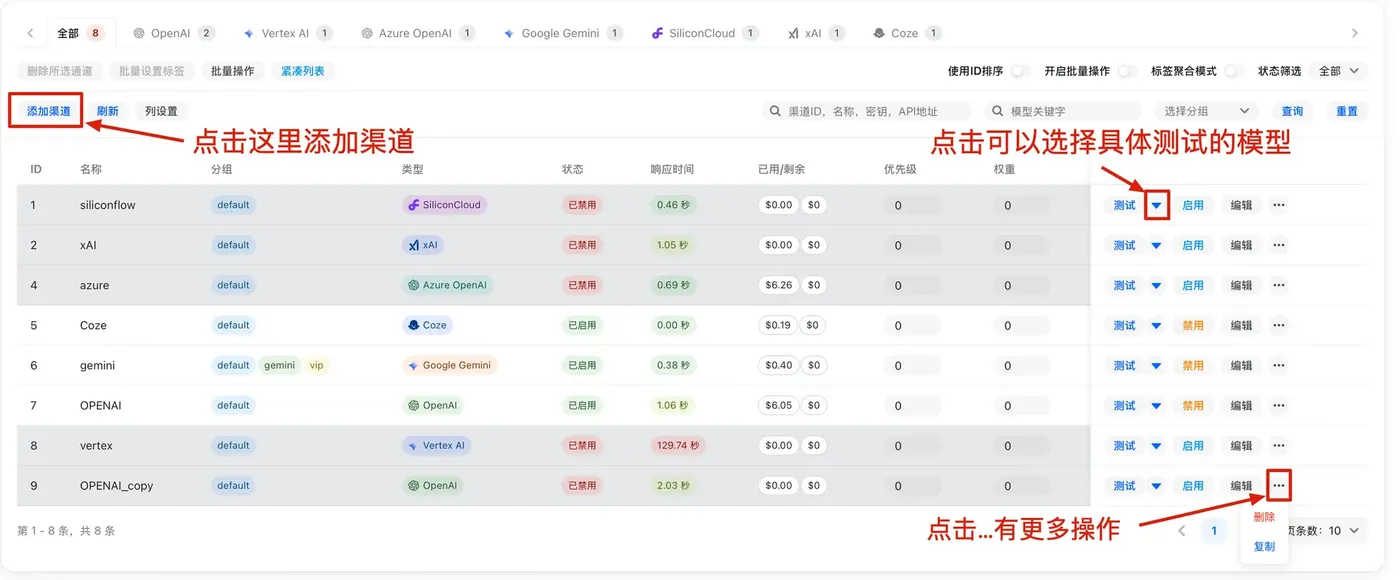
- 渠道与模型管理:集中维护供应商密钥、模型列表、渠道测试、批量操作及模型名称映射。
- Token 与权限:为用户签发 Token,可限制额度、有效期、模型、IP和用户分组。
- 额度与计费:支持模型倍率、补全倍率、分组倍率、预扣费和请求完成后的实际结算。
- 日志与统计:记录 Token、费用、渠道、响应时间、重试和退款等信息。
- 调度与容灾:先按优先级筛选渠道,再按权重随机分流;支持失败重试、自动禁用异常渠道和跨渠道切换。
- 配置模型:添加上游模型服务商,配置秘钥与可用模型
- 添加令牌:为应用创建访问令牌,开始调用统一AI接口。

- 数据看板:使用概览页和数据看板了解网关状态、用量、模型调用和分流等情况。

和 OpenRouter 相比,自建方案赢在哪里?
OpenRouter 是已经运营好的托管聚合服务。平台负责接入多个模型和供应商,并提供供应商路由与故障切换。它的优势是省事:个人开发者或小团队不必先准备服务器,也不用维护网关,就能快速验证不同模型。
LiteLLM 和 New API 则是部署到自己云环境里的软件。它们的优势不是“天然拥有更多模型”,而是获得更多控制权。
你可以决定接入哪些上游模型,使用哪些官方 API Key;可以使用自己的域名和统一入口;可以自行设置模型映射、用户权限、预算和日志策略;还可以根据团队需求扩展配置与管理流程。
已选择LiteLLM、New API,但不想手动配环境,怎么办?
理解项目并不难,真正让不少人停在第一步的,往往是部署。
准备 ECS、安装运行环境、配置容器和数据库、开放端口、检查启动日志……这些工作并不复杂,但任何一个参数配置错误,都可能让第一次尝试变成反复排查。
为降低上手门槛,LiteLLM 和 New API 可通过阿里云预置的资源与应用部署模板一键部署。
想搭建偏企业内部的统一模型网关,可体验 LiteLLM:一键部署
想搭建带用户、令牌和额度体系的 API 管理平台,可体验 New API:一键部署
LiteLLM官网文档:https://docs.litellm.ai/docs/
New API官网文档:https://docs.newapi.pro/zh/docs