过去七天,我这台 Mac 上的 Hermes 一共跑了 126 个会话、4,744 次工具调用,消耗 6.54 亿 tokens。
其中 88% 不是新内容。它是在每问一次,就把前面所有历史重新发一遍。
多数人以为 AI 贵在"问得太多"。真正贵的是:你问第 100 句时,它把前 99 句又读了一遍。
上下文不是越大越好。它更像一间从不打扫的房间——东西都在,找起来越来越慢,租金照付。
这篇文章把 Hermes 里控制 token 的开关全拆开:怎么开、怎么验证、能省多少、哪里会白忙一场。所有数字都来自本机实测,命令可以直接复制。
一、先看清钱花在哪:三层模型
省 token 之所以多数人白忙,是因为打错了地方。成本其实分三层:
| 层 | 是什么 | 本机实测量级 | 治理手段 |
| ① 固定成本 | system prompt + 技能索引 + 工具说明书 | 每轮约 2.2 万 tokens 固定支出 | 工具按需加载、关掉不用的工具集 |
| ② 前缀重发 | 每轮把整段历史重发一遍 | 周 5.76 亿 tokens(占总用量 88%) | 压缩触发点(本文核心) |
| ③ 工具结果 | 单次工具返回的原始体量 | 周约 2,000 万字符 | 输出上限 + 落盘 + 查询收窄 |
本机的固定成本实测是:system prompt 33,806 字符,外加 27 个工具的说明书 42,421 字节。看起来不小,但它一周只值这些——真正吞掉用量的是第 ② 层。
顺序错了就是白忙:先治 ②,再治 ③,最后才动 ①。
二、最贵的一笔支出,是"系统根本没动手"
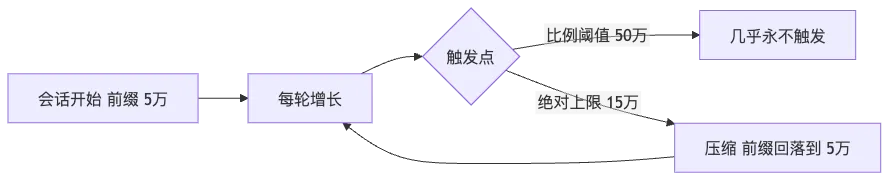
Hermes 有一个压缩机制:历史攒到一定量,就把前面的内容压成摘要,让上下文保持有界。听起来很省心,但它的触发点是按窗口比例算的。
我的主模型窗口是 100 万 token,配置里写的是 0.5。于是:
折叠保存复制91›触发点 = 1,000,000 × 0.50 = 500,000 tokens
50 万是什么概念?本机一周里平均每次调用携带的前缀是 8.9 万 tokens,最高 26.8 万。永远够不到 50 万。
结果就是:七天内压缩触发 0 次。日志、失败计数、无效压缩计数,全是零。也就是说,你以为系统在帮你打扫,它七天真的一次手都没动过。
这里有个反常识的结论:
上下文窗口越大,按比例算出来的触发点越高,"自动压缩"越等于不存在。
1M 窗口给了你一种安全感,代价是每一轮都在重发一整段历史。窗口大不是福利,是账单。
三、对症下药:把触发点钉成一个绝对数字
解法只有一个键——compression.threshold_tokens,给压缩设一个绝对上限,生效值取"比例值"和"绝对值"里较小的那个:
hermes config set compression.threshold_tokens 150000
hermes config set compression.tail_mode lean
为什么是 15 万,不是 25 万、也不是 5 万?看本机的前缀分布就清楚了:
| 会话平均前缀 | 会话数 | 占缓存读取比例 |
| < 50K | 21 | 0.4% |
| 50–100K | 35 | 11.3% |
| 100–150K | 28 | 27.7% |
| 150–250K | 11 | 50.8% |
| 250–500K | 1 | 9.8% |
12 个会话(占总数 12%)承担了 60.7% 的缓存读取。 改动只需要精准打在这批会话上,而不是"每处省一点"。
15 万这个数字落在这里:刚好切在 150K 分档之上,不动小会话,只压大会话。
tail_mode: lean 是配套动作:压缩后保留尾部 2.5% 窗口的原文(上限 25K tokens),而不是全丢给摘要。它决定压缩之后你还能不能"接得上话"。
四、剩下 8 个开关:命令照抄就行
Agent 自己是改不了 config.yaml 的——Hermes 有硬护栏,会直接拒绝,提示你去用官方 CLI。所以下面这些必须走 hermes config set:
hermes config set compression.threshold_tokens 150000
hermes config set compression.tail_mode lean
hermes config set tool_output.max_bytes 150000
hermes config set tool_output.max_line_length 2000
hermes config set tools.tool_search.enabled on
hermes config set tools.tool_search.threshold_pct 5
hermes config set tools.tool_search.listing auto
hermes config set tools.tool_search.listing_max_tokens 4000
hermes config set tools.tool_search.max_search_limit 15
每一项干什么,一张表说清:
| 配置项 | 作用 | 本机取值 |
compression.threshold_tokens |
压缩触发的绝对上限 | 150000 |
compression.tail_mode |
压缩后尾部保留原文策略 | lean |
tool_output.max_bytes |
单次工具输出上限 | 150000 |
tool_output.max_lines |
单次工具输出行数上限 | 5000(保持默认) |
tool_output.max_line_length |
单行长度上限 | 2000 |
tools.tool_search.enabled |
工具按需加载 | on |
tools.tool_search.threshold_pct |
触发按需加载的固定成本占比 | 5 |
tools.tool_search.listing |
保留能力目录 | auto |
tools.tool_search.listing_max_tokens |
目录预算 | 4000 |
tools.tool_search.max_search_limit |
单次搜索返回上限 | 15 |
其中 tool_search 是治第 ① 层的:工具说明书本身要占 token,本机 27 个工具就是 42KB。一旦挂上多个 MCP 服务,光说明书就能吃掉 2–3 万 tokens 的固定支出——据今年 7 月一篇 Hermes 上下文压缩架构的分析,工具 schema 普遍占 20K–30K token。按需加载的意思是:需要哪个工具,再把它的说明书拿出来。
listing: auto 千万别关。没有能力目录时,模型会误判"我没这个工具",转头用 terminal 硬凑。
五、两个必须知道的坑
坑一:小窗口别设这个键。 窗口小于 512K 时,Hermes 里有一条"只升不降"的下限逻辑,比例阈值会被抬到 0.75,你手动往下调没用。更小的本地模型上,还有 64K 的下限会和整个窗口重合——那种情况下硬设绝对上限,会变成"每轮都压缩"。
坑二:别把工具输出上限压得太狠。 过度截断会换来额外一轮"去读落盘文件",那一轮要把整个前缀重发一次,一次可能就是十万级 tokens——比你省下的那点还贵。
仙踪问道在帮用户做本机部署时发现,多数人卡住的地方不是不会配,而是不敢确定自己到底配上没有。所以我们在交付流程里坚持让用户看到那行"打印出来的触发点"——配置这东西,看不见就等于没生效。
六、改完别信"看起来成功了"
配置写完只是开始。hermes config set 会重写整个 YAML 文件,外观会变,所以文本对比没有意义,必须做语义深比较:递归比对改动前后的每一个叶子节点。
验收标准是两条:
| 验证项 | 通过标准 |
| 语义深比较 | 差异恰好 9 处,全部是预期项;MCP 配置完好 |
| 生效值复算 | 打印出 TRIGGER = 150,000 |
第二条是关键:直接读真实代码路径,把"生效触发点"算出来打印给你看。数字对了,才算真生效。
生效时机也不一样,别搞错:
| 配置 | 生效条件 |
compression.* |
新会话即可 |
tools.tool_search.* |
新会话(中途改会破坏缓存前缀) |
tool_output.* |
必须重启进程 |
提醒一句:不要在对话进行中重启后端,会直接中断会话。正确说法是"下次启动应用后生效"。
七、效果:缓存读取降三成,但请看清口径
一周后的目标值和实测结果:
| 指标 | 改造前 | 改造后 | 变化 |
| 周缓存读取 | 576.4M | 399.4M | −30.7% |
| 受影响会话平均前缀 | 204,590 | 101,000 | −51% |
| 压缩事件 | 0 次 | 约 30 次/周 | 配置真的动了 |
| 受影响范围 | — | 12/101 个会话 | 只动 12% |
成本口径我算得很保守,因为省 token 和省钱不是一回事:
| 缓存读单价(相对输入价) | 净节省占比 |
| 0.10×(Claude、OpenAI、Gemini 现行普遍口径) | 约 15% |
| 0.25× | 约 22% |
| 0.50× | 约 26% |
这里必须诚实说两件事。
第一,如果你的模型"缓存命中价极低",钱账会打平。 以 DeepSeek 现价为例,缓存命中 0.04 元/百万 tokens,缓存未命中 2 元/百万——前者只有后者的 2%。我按这个口径把整周账单重算了一遍:改前约 100.54 元/周,改后约 100.68 元/周,差 +0.14 元,实际上就是打平。省下的 177M 缓存读取值 7 元出头,新增的压缩摘要调用花 7.22 元,两头抵消。
第二,别把上下文压到极小。 Hermes 官方文档里记录过一次 1,393 个子代理的运行回放:在缓存前缀完好时,20 万与 40 万上限的成本差异在 5% 以内。而且每次压缩都是一次"丢细节的机会"。压缩是工具,不是信仰。
那收益到底在哪?在三个地方:每轮少 prefill 十万 tokens 的响应速度、额度和配额的耐用度、以及上下文不腐烂。最后一条对长任务最重要——上下文一旦开始"腐烂",摘要质量也会跟着下降,因为生成摘要的模型自己已经受损了。(业界有一条被反复验证的原则:先用零成本的本地规则,再用缓存友好的手段,最后才动用昂贵且有损的摘要。)
八、不想动配置?先做这 5 件事
| 习惯 | 做法 | 为什么有用 |
| 阶段化会话 | 长任务按阶段开新会话,交接信息写进文件 | 从根上避免前缀无限增长 |
| 主动压缩 | 一个阶段做完、结论已落盘后手动压缩 | 在可控的时间点断缓存,而不是被动触发 |
| 窄查询 | 先看 --stat 再决定要不要看全文;先定位行号再按行读 |
直接减少第 ③ 层体量 |
| 子代理隔离 | 大范围搜索、批量读取交给子代理 | 中间结果不进主上下文 |
| 固定模型 | 不要频繁切模型 | 换模型等于换缓存命名空间,缓存全部失效 |
仙踪问道提醒:长任务一定要有文件化的进度。每完成一步追加一行到进度文件——压缩会摘掉早期细节,但只要状态在文件里,压缩之后仍能恢复,而不是靠"记忆"。
九、按窗口选档,以及一条命令回滚
别照抄 15 万。规则是 min(150000, 0.35 × 窗口),而且只在窗口 ≥ 512K 时才设:
| 模型窗口 | 触发上限 | 工具输出上限 | 行数上限 |
| ≥ 512K | 150000 | 150000 | 5000 |
| 200K–512K | 100000 | 100000 | 3000 |
| 32K–200K | 不设 | 50000 | 2000 |
| ≤ 32K | 不设 | 20000 | 500 |
小窗口下官方比例逻辑本来就够好,硬设绝对上限反而会变成"每轮都压缩"。
所有改动都是键值,没有结构性变化,所以回滚就一条命令:
cp ~/.hermes/config.yaml.bak_20260915_111105 ~/.hermes/config.yaml
hermes gateway restart
养成习惯:改之前先备份,并记下 sha256。出事的时候,你会感谢自己。
说到底,省 token 是"让长任务不烂尾"的工程题
把上面这一套串起来,其实只有三句话:
一句是先量再改——hermes prompt-size 看固定成本,hermes insights --days 7 看用量分布,hermes config check 看配置健康度。不测量,所有网上的"省 token 秘籍"都可能是空操作。
一句是打准地方——88% 的用量在"重发历史"上,12% 的会话吃掉 61% 的缓存读取。省在少数几个大会话上,才有效果。
一句是留好退路——压缩会丢细节,所以进度要落文件、配置要有备份、参数要按窗口分档。
一句话总结:上下文管理的目标不是"更短的上下文",而是"你该记住的事,一件都没丢"。
如果你正在用 AI 处理长文档、跑定时任务,或者只是想知道自己每个月这些 token 到底花在哪层——欢迎关注这个账号,接下来我会继续拆 Hermes 的实测细节,不讲配置名词,只讲"改哪个键、看哪行数字、能省多少"。
也欢迎在评论区说说:你的 AI 助手有没有出现过"越聊越笨、忘了前面说过什么"的情况?