
很多企业都有一个共同感受:数据越来越多,但真正用起来并不容易。 销售、客户、生产、供应链系统每天都在产生大量数据,但业务遇到问题时,依然会问:“为什么销售下降?”“哪些客户可能流失?”“未来库存怎么准备?”
报表只能回答过去发生了什么。 而企业更需要知道: 为什么发生?未来怎样?下一步怎么做?这就是数据挖掘的价值。但很多企业误以为数据挖掘难在算法。实际上,真正影响效果的往往是数据基础。
所以,数据挖掘的第一步不是选择算法,而是先建立可靠的数据基础。下面一起看看分类、聚类、关联、预测到底怎么用。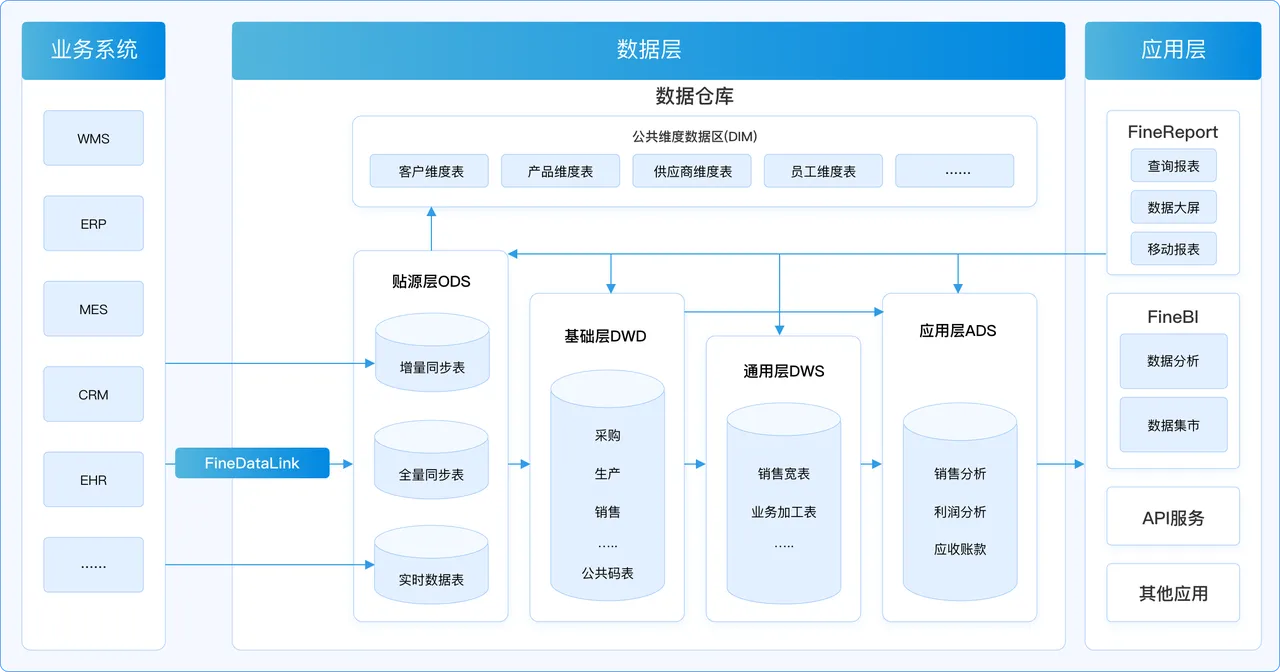
一、别急着做模型,先看看你的数据能不能挖
很多企业做数据挖掘时,容易走进一个误区:认为只要引入算法工具,数据价值自然就会出现。但实际情况并不是这样。数据挖掘本质上是在大量历史数据中发现隐藏规律,并利用这些规律辅助企业识别问题、预测趋势和优化决策。
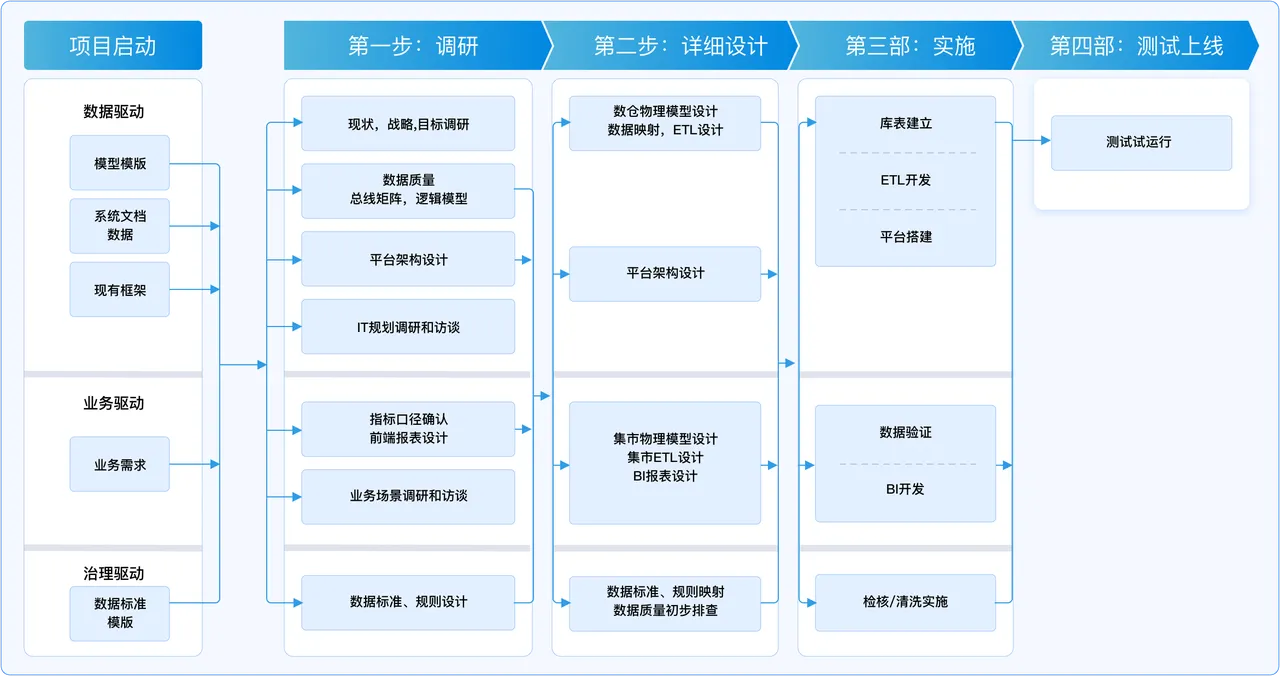
如果输入的数据本身存在问题,模型得到的结果也很难可靠。比如:数据来源不统一,模型无法准确理解业务对象;数据口径不一致,分析结果容易出现偏差;历史数据缺失,预测结果难以反映真实趋势。因此,企业开展数据挖掘之前,需要先解决数据基础问题。
通常需要做好: 数据来源统一;数据标准统一;数据质量管理;数据持续更新。只有数据基础稳定,后续的数据挖掘才能真正服务业务。
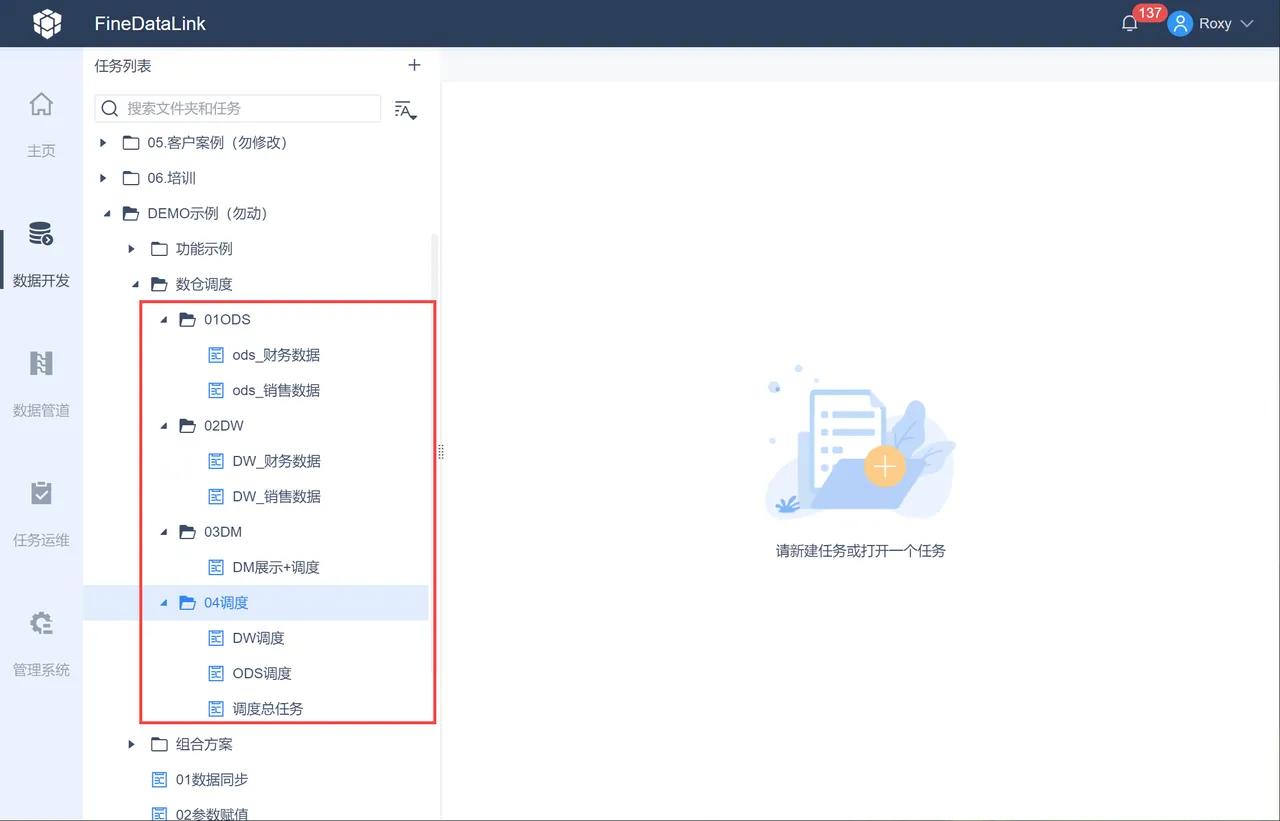
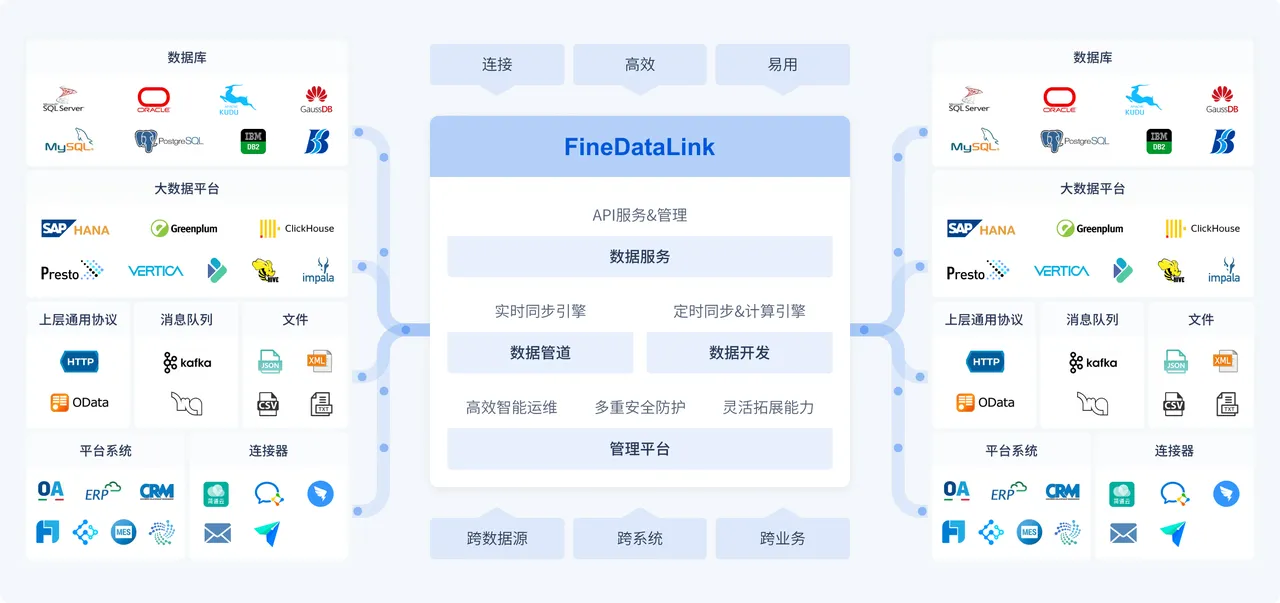
实际项目中,很多企业的数据来自ERP、CRM、MES、数据库以及Excel文件。这些数据如果长期分散管理,模型分析往往会变成 “拿不同口径的数据计算同一个问题”。 数据挖掘的第一步,不是寻找复杂算法,而是让数据先变得可信。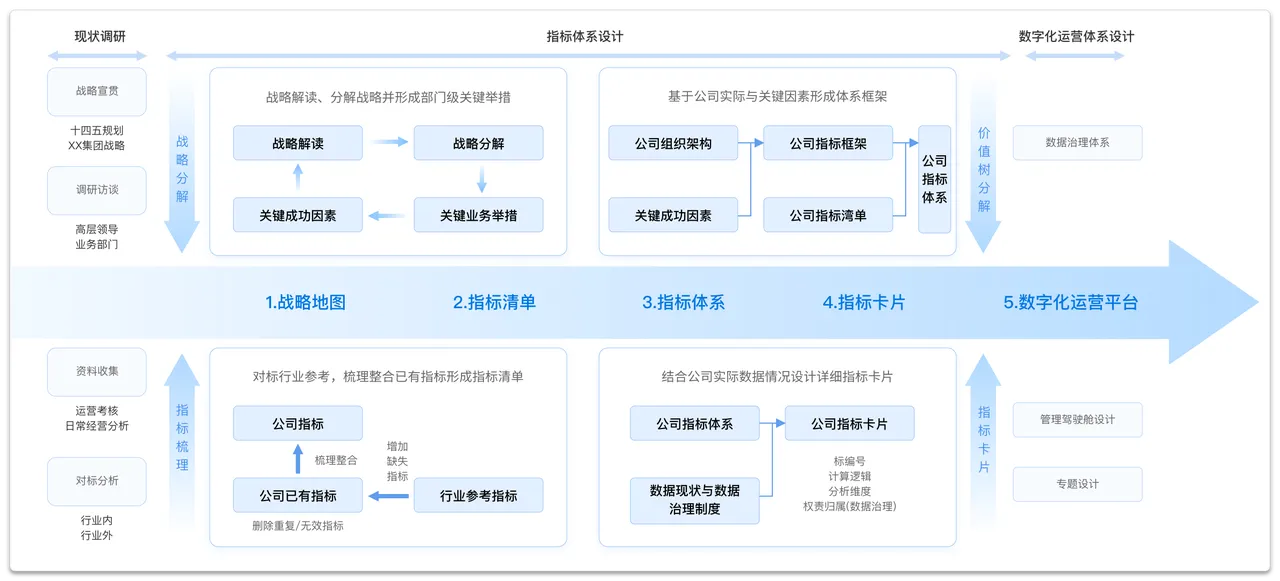
二、分类:提前判断“谁可能出问题”
说到数据挖掘,很多人第一个想到的就是分类。简单理解:分类分析就是利用已有结果的历史数据,学习其中规律,然后判断新的对象未来更可能属于哪种情况。
它解决的问题通常是: 这个客户会不会流失?这个订单有没有风险?这个设备会不会异常?分类分析的特点是:企业过去已经知道哪些属于正常情况,哪些属于异常情况。
模型通过学习这些历史案例,找到影响结果的关键因素。 客户流失预测就是分类分析非常典型的应用。很多企业过去做客户管理,通常是在客户停止购买之后,才开始分析:为什么流失?哪里出了问题?
但真正有价值的数据分析,应该提前发现风险。企业可以结合: 客户交易变化;消费频率变化;服务互动情况;历史行为特征。建立客户流失预测模型。
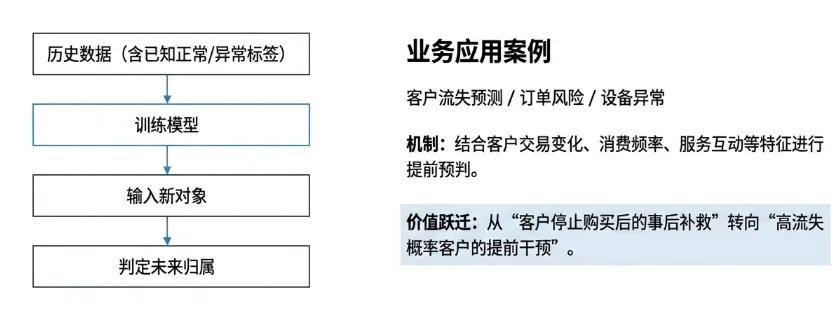
模型运行后,可以帮助企业识别哪些客户未来流失概率较高。 业务团队就可以根据预测结果提前采取行动,通过加强客户维护、优化服务体验和制定针对性运营策略,降低客户流失风险。这样,客户管理就从“事后补救”转向“提前干预”。 有的企业做分类模型,最后发现预测效果不理想。
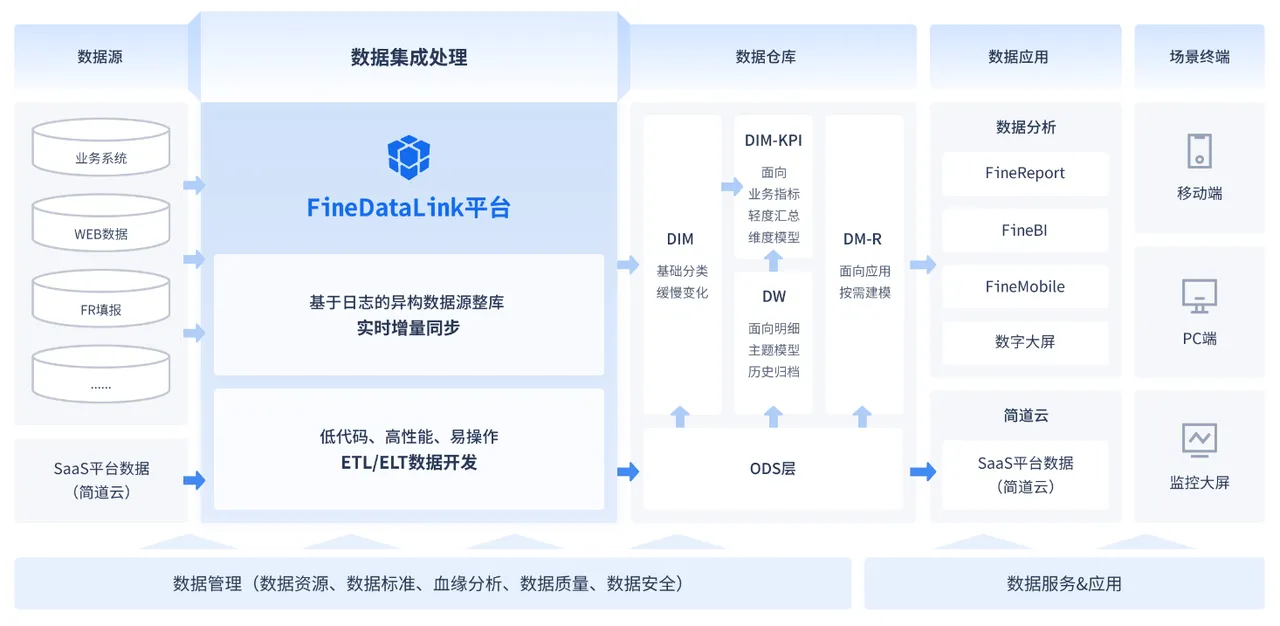
第一反应通常是:算法是不是不够先进?但实际项目中,更常见的问题是训练数据。 例如客户流失预测,需要结合客户信息、交易记录和行为变化等多个维度的数据。如果这些数据分别存在不同系统中,字段定义不一致,模型学习到的规律就可能出现偏差。因此,分类模型之前,需要先建立稳定的数据准备流程。 只有输入数据可靠,分类模型才能真正帮助企业识别风险。
三、聚类:别等业务告诉你,让数据自己发现规律
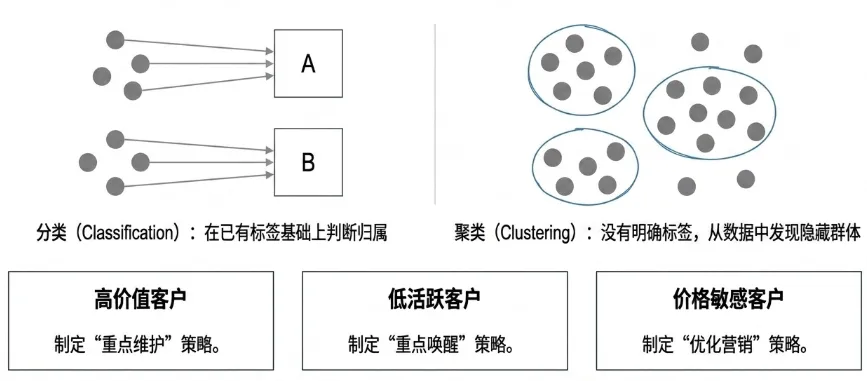
分类和聚类经常被混淆。但两者最大的区别是:分类是在已有标签基础上判断归属, 聚类是在没有明确标签时,从数据中发现隐藏群体。
简单来说:分类是在回答:“这个对象属于哪一类?”聚类是在回答:“数据里面到底有哪些不同群体?”
很多企业拥有大量客户数据,运营时,经常采用同一种方式管理所有客户。问题在于:不同客户的价值和需求并不一样。
通过聚类分析,可以根据客户行为特征发现不同群体。企业可以针对不同群体制定不同策略。 高价值客户:重点维护。低活跃客户:重点唤醒。价格敏感客户:优化营销方式。聚类解决的是发现数据结构的问题,而不是直接替代业务决策。
聚类分析真正的价值,不是生成几个客户标签,而是帮助企业发现过去没有看到的业务规律。 聚类分析想得到准确结果,输入数据需要覆盖更多业务维度。
四、关联:隐藏在数据里的关系,可能就是机会
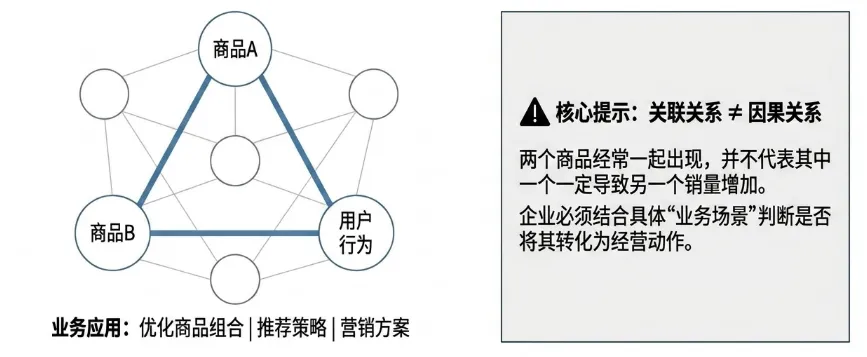
关联分析关注的是:不同事件之间有没有稳定关系。它回答的问题是:哪些事情经常一起发生? 很多企业的数据里,其实隐藏着大量关联规律。只是过去没有被发现。电商和零售行业经常使用关联分析。企业通过分析历史交易记录,可以发现: 哪些商品经常同时出现;哪些产品存在组合销售机会;哪些用户行为存在明显关联。这些结果可以帮助企业优化: 商品组合;推荐策略;营销方案。
但需要注意:关联关系不等于因果关系。 两个商品经常一起出现,并不代表其中一个一定导致另一个销量增加。企业需要结合业务场景判断:这个关系是否值得转化成经营动作。关联分析需要多个业务维度共同支持。例如分析商品关系,不仅需要订单数据,还需要商品信息、客户信息以及营销活动数据。
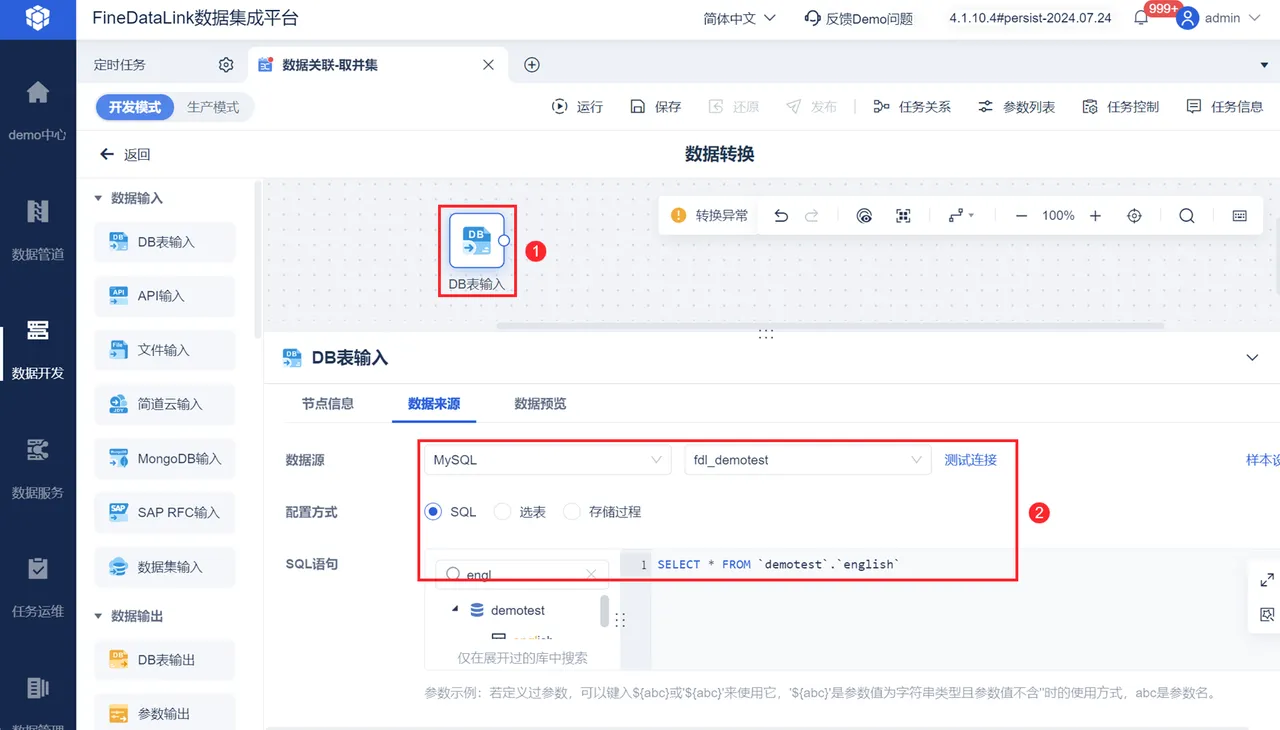
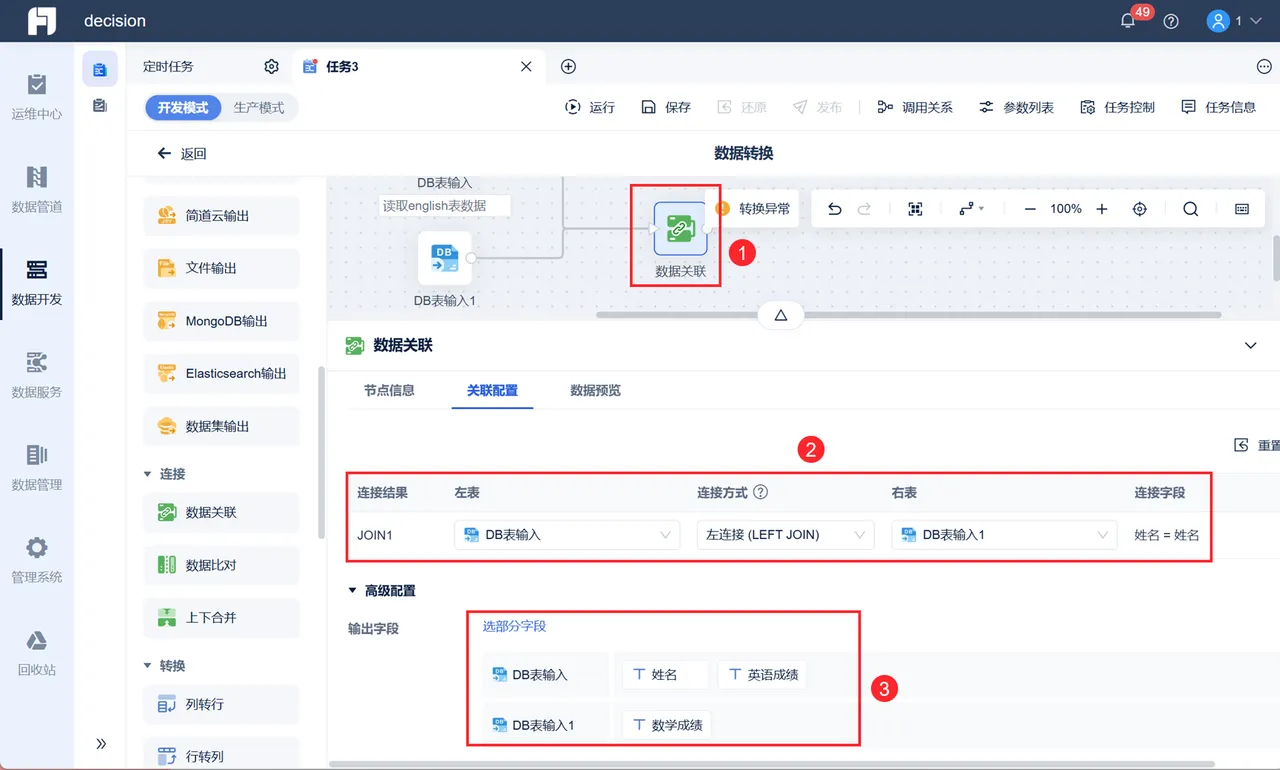
如果数据只来自一个系统,很难发现深层规律。因此,企业需要先解决数据连接问题。 数据越完整,发现业务关系的可能性越高。
五、预测:不是算命,而是提前看到趋势
预测分析可能是企业最关注的数据挖掘方法之一。简单理解:预测分析就是利用历史规律和业务变量,判断未来可能出现的趋势。
它解决的问题是:未来可能发生什么?销售预测是企业常见应用。企业可以结合: 历史销售情况;市场变化;业务周期。判断未来需求趋势。
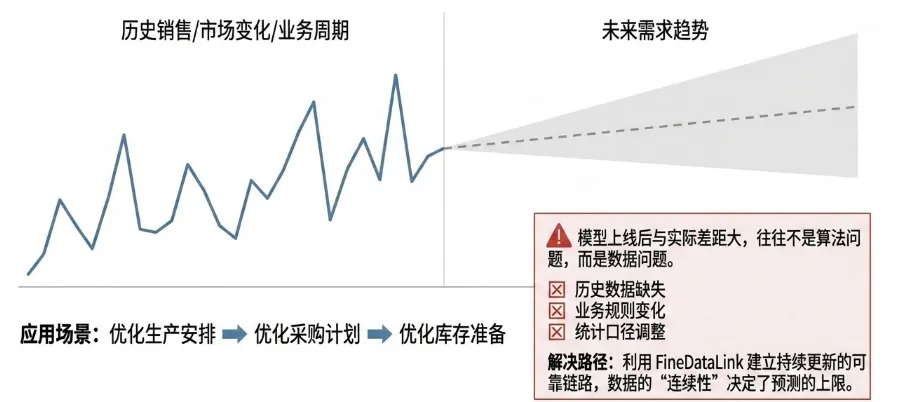
预测结果可以帮助企业优化: 生产安排;采购计划;库存准备。这样,企业不再完全依赖经验判断,而是让数据参与经营规划。此外,很多企业做预测时,会发现:模型上线了。结果却和实际差距很大。问题往往不是模型,而是数据。
例如:历史数据缺失;业务规则变化;统计口径调整。都会影响模型判断。预测模型不是凭空预测未来,而是在历史规律基础上推断未来,因此数据连续性决定预测上限。
六、分类、聚类、关联、预测,到底什么时候用?
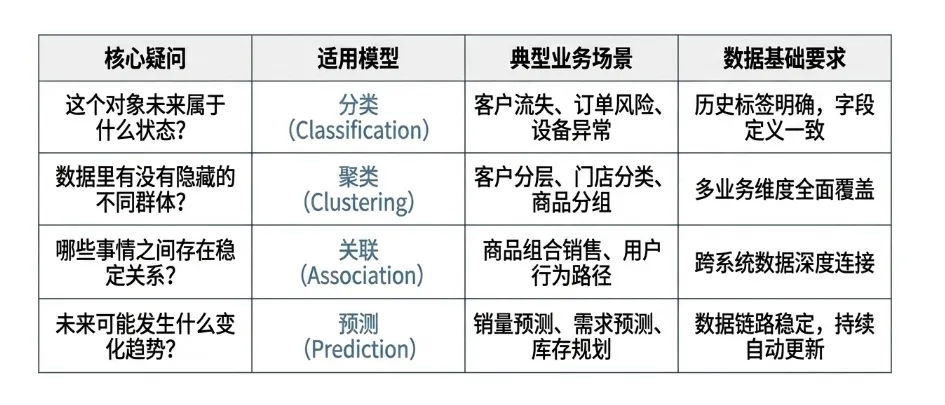
其实不用死记算法名称。关键看企业想解决什么问题。如果企业想判断:“这个对象未来属于什么状态?” 可以考虑分类。
例如:客户是否流失;订单是否风险;设备是否异常。如果企业想发现:“数据里面有没有隐藏群体?” 可以考虑聚类。例如:客户分层;门店分类;商品分组。
如果企业想知道:“哪些事情之间存在关系?” 可以考虑关联。例如:商品组合;用户行为路径。 如果企业想判断:“未来趋势可能怎样?” 可以考虑预测。例如:销量预测;需求预测;库存规划。
选择数据挖掘方法之前,企业需要先明确业务目标、需要解决的具体问题以及分析结果如何真正进入业务流程并产生实际价值。 数据挖掘不是为了使用算法,而是为了帮助业务解决问题。
七、数据挖掘真正难的,不是算法
很多企业认为数据挖掘最大的难点是模型。但从实际落地情况来看,真正影响效果的通常是: 数据基础是否可靠; 业务理解是否充分; 分析结果是否落地。
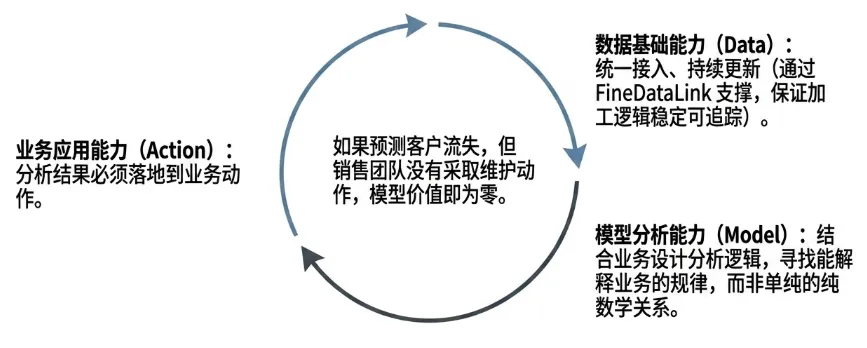
首先,数据必须可信。 如果数据来源不统一,模型学习到的规律可能并不真实。其次,需要结合业务设计分析逻辑。 数据挖掘不是单纯寻找数学关系,而是寻找能够解释业务、指导行动的规律。最后,模型结果必须进入业务流程。
如果预测客户可能流失,但销售团队没有采取维护动作,那么模型价值就无法真正体现。因此,企业真正需要建设的是:数据基础能力、模型分析能力和业务应用能力之间的闭环。 与其花大量精力追求更复杂的算法,不如先把数据基础建设做好,让模型拥有稳定、准确、持续的数据输入。
对于企业来说,数据挖掘真正的价值,并不是展示一个预测结果,而是让数据从业务系统流向分析模型,再从分析结果回到业务决策,形成持续循环的数据驱动能力。
总结:数据挖掘的价值,是让企业从分析过去走向判断未来
数据挖掘不是为了展示复杂算法,而是为了帮助企业从大量历史数据中发现规律,并把分析结果转化为业务行动。
其中: 分类分析帮助企业判断对象未来可能属于哪种状态; 聚类分析帮助企业发现隐藏的数据群体; 关联分析帮助企业找到数据之间潜在关系; 预测分析帮助企业提前判断未来变化趋势。
真正有价值的数据挖掘,不是建立一个模型就结束,而是让数据、算法和业务形成完整闭环。 企业最终需要解决的问题,不只是:“发生了什么?”
更重要的是:“为什么发生?”“未来可能怎样?”“下一步应该怎么做?”这才是数据挖掘真正能够创造业务价值的地方。




