在前面四个主题行中,我完成了 Schema-As-Code把设计规范写成代码格式 框架从"发现问题"到"定义规则"的闭环前半段:
① 语义令牌与字典:把"红色代表致命"这种模糊直觉,编码为 **status.critical** 这样的离散语义令牌,建立了组织级唯一信源。但它只回答了"词汇是什么",没回答"怎么造句"。
② 语义域:把组件从"自带语义"变成"空容器",语义由场景外赋。它只回答了"语法结构是什么",没回答"怎么写文章"。
③ 约束显化:把"文案要准确"这种自然语言规范,变成机器可读的断言。它只回答了"写作方法是什么",没回答"谁能持续产出作品"。
④ 语义契约:把设计意图翻译成YAML的7个冻结字段,经过入库三道闸,成为可版本管理、可 Diff 追溯的资产。但它仍然聚焦在"个人怎么写一份契约",一个人,一台电脑,一份文件。
到这一步,规则可以写出来了,但还停在个人工具层面:一个人写,一个人用,一个团队内部消化。
⑤ 编译管线开始回答"规则怎么被组织消费":一份YAML编译出Prompt前缀、JSON Schema、Checklist、CI规则,自动分发给前端、AI工程师、DesignOps。但它回答的是"机器怎么分发",没回答"谁来触发分发、谁来监控消费、谁来处理团队间的语义冲突"。
当组织里有5个团队、10个产品、20名设计师时,"个人写得好"不等于"组织运转得好"。同一个语义,团队A叫"严重",团队B叫"Critical";同一份契约,前端说Schema没更新,AI工程师说Prompt前缀没收到;规则写了30条,其中12条三个月没人用,成了"沉默规则"。
从"个人翻译能力"到"组织翻译机制",中间缺一个枢纽角色,不是写代码的工程师,不是画界面的设计师,而是专门负责"把设计意图翻译成机器规则,并让这个规则在组织内持续运转"的人。
这个角色,就是具备语义翻译能力的设计师。
本文是这个角色的能力宣言:不讲系统架构,不讲组织治理,只讲这个角色自身的能力模型,从一次语义漂移的判断开始,到一份YAML契约的产出,再到规则在组织内的消费与验证。
一、什么是翻译能力?人懂的直觉,机器读的规则
1.1 定义:在直觉和规则之间架一座桥
这种能力,不写代码,也不画设计稿。它只做一件事:把‘设计意图’翻译成‘机器规则’
上游(人懂的直觉)                    下游(机器读的规则)
┌─────────────────────────┐        ┌────────────────────────────────┐
│ "这个按钮在删除账户时必须   │  翻译   │ action.destructive            │
│  是红色、必须二次确认"     │ ─────→ │ + color_token: status.critical │
│  ——设计师的直觉           │        │ + llm_constraints: [...]       │
└─────────────────────────┘        └────────────────────────────────┘
              翻译动作 = 把直觉转化为机器能执行、能校验、能版本管理的代码格式
1.2 起点:四种错误共用一种红,问题出在哪?
这个角色的经验,通常从一个判断转折开始。
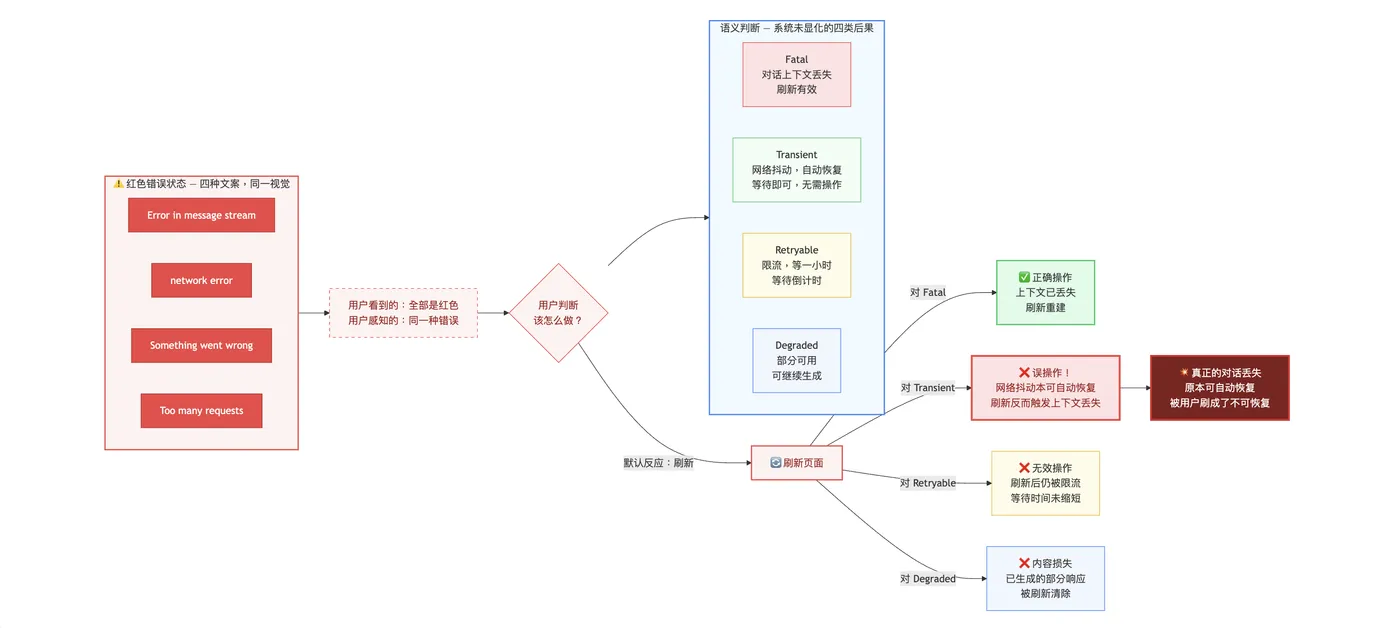
面对一个AI对话产品的错误状态界面:至少四种错误,"Error in message stream""network error""Something went wrong""Too many requests",全部是红色。但后果完全不同:有的是对话上下文丢失,有的是网络抖动会自动恢复,有的是限流等一小时就好。用户看到红色就刷新,把还能自动恢复的网络抖动,刷成了真正的对话丢失。
当时的判断:这不是视觉问题,颜色本身没做错;这是语义问题,红色没有区分后果的严重程度。
为什么这样判断:如果是视觉问题,修正色值就能解决;但用户做出错误行动(不该刷新时刷新)的根源,是界面没有传达"这个错误意味着什么后果"。视觉层是完整的,语义层是缺失的。
经验沉淀:语义漂移的第一个信号,不是"界面不好看",而是"用户看到界面后,做出了错误的行动决策"。这个信号后来成为这个角色识别一切语义问题的入口。
回头看,这正是前三个主题行各自缺一块的地方:
| 主题行 | 已建立 | 缺什么 |
|---|---|---|
| ① 语义令牌与字典 | 组织级唯一信源(词汇表) | 知道词汇,不等于会造句 |
| ② 语义域 | 组件的场景分类(语法) | 知道语法,不等于会写文章 |
| ③ 约束显化 | 机器可读的规则表达(方法论) | 知道方法,不等于能产出作品 |
| ④ 语义契约 | 🙅 缺失 | 需要有人把①②③组合成机器能读懂的文章 |
1.3 价值:从“口头说”到“机器执行”,解决了什么
| 问题 | 没有这种能力时 | 有了之后 |
|---|---|---|
| 设计意图怎么传达 | 评审会上口头说,事后靠人转述 | 写成YAML契约,机器自动执行 |
| 规范更新了怎么同步 | @全员、开会、逐个改 | Git Diff自动触发重编译,下游自动换版 |
| AI 生成内容怎么约束 | Prompt里写自由文本,不可审计 | 注入编译后的Prompt前缀,机器校验 |
| 跨团队术语怎么统一 | 各团队各自定义"严重""Critical""紧急" | 引用组织级语义字典,禁止自创 |
| 规则用得好不好 | 不知道写了没人用 | 消费追踪面板实时可见 |
二、语义契约:一份让机器“听话”的文件
一份契约要能让机器"听话",必须回答七个不可省略的问题。不是拍脑袋定的,是我们踩过坑后逐步收敛出来的。七个字段,每个对应机器执行时的一个信息缺口:详见④主题行《YAML 契约:设计意图的接口定义,编译即规则》
| 字段 | 机器需要它回答什么 | 缺了会怎样 |
|---|---|---|
| intent_id | 我是谁? | 出了拦截事故,定位不到是哪条规则 |
| description | 我解决什么问题? | 机器不知道这条规则的适用范围 |
| version | 我是哪个版本? | 规则更新了,下游还在用旧版 |
| semantic_domain | 属于哪个语义域? | 致命错误可能被当成普通提示 |
| applicable_products | 在哪些产品生效? | 规则误伤不该管的产品 |
| semantic_tokens | 定义了什么语义级别? | 机器不知道"严重"和"Critical"的区别 |
| immutable_boundaries | 不可突破的红线是什么? | 高危操作缺少二次确认也放行 |
七个字段中,真正能约束机器的是 llm_constraints。它把"给人读的规范"变成"给机器执行的规则":
description 是给人读的,机器无法判定"准确"还是"不准确"
visual_mapping 只管视觉渲染,不管文案内容对不对
llm_constraints 才是注入AI生成流程的断言,分三类,机器直接执行:
- 必须型:"必须显示倒计时" → 机器检查字段是否存在
- 禁止型:"禁止用'严重'替代 Critical" → 机器做字符串匹配
- 限制型:"只能使用 outline_danger" → 机器检查值是否在枚举范围
没有 llm_constraints,契约只是"给人看的规范";有了它,契约才是"给机器执行的规则"。
2.1 一份源文件,十份编译产物:为什么不能手改
这个角色产出的11个交付件里,只有1个是源文件:语义契约(YAML)。其余10个全部是它的编译产物:
                    ┌──────────────────┐
                    │ 语义契约 (YAML)   │  ← 唯一源文件,人工编写
                    └────────┬─────────┘
                             │ 编译管线
        ┌──────────┬─────────┼─────────┬──────────┐
        ↓          ↓         ↓         ↓          ↓
   Prompt前缀  JSON Schema  Checklist  CI规则   验证框架/对抗用例
   (给AI工程师) (给前端)    (给设计师) (给流水线) (给验证)
        └──────────┴─────────┴─────────┴──────────┘
              全部禁止手改 —— 一改,下游就会分裂
为什么禁止手改:手一改,版本就分叉。前端改Schema,AI工程师改Prompt前缀,契约一更新,团队A的Schema是 v1.1,团队B的Prompt还是 v1.0。同一个语义,两套版本。当时我们就判断:下游版本分裂,就是“四种错误共用红色”在组织层面的翻版,语义一样,表达不同,机器和工程师只能跟着做错。
2.2 七个字段,七问七答:机器必须知道什么
| 字段 | 回答的问题 | 这个角色的理解 |
|---|---|---|
| intent_id | 我是谁? | 出了拦截事故,靠它定位到哪条规则 |
| description | 我解决什么问题? | 现象+根因+后果,让三个月后还记得当时为什么写 |
| version | 我是哪个版本? | SemVer,变更触发重编译 |
| semantic_domain | 我属于哪个语义域? | 从字典下拉选,不许自创 |
| applicable_products | 我在哪些产品生效? | 防止规则误用到不该管的场景 |
| semantic_tokens | 我定义了什么语义? | 核心:级别、视觉映射、用户行动、LLM约束 |
| immutable_boundaries | 我画了什么红线? | 绝对不能做什么,违反即拦截 |
这个道理,是我踩过坑才真正明白的,
┌─────────────────────────────────────────────────────────────────┐
│  踩坑记录:为什么 llm_constraints 必须是可判定的断言              │
└─────────────────────────────────────────────────────────────────┘

Step 1:假设
  早期契约只填 description("文案要准确")和 visual_mapping(红色脉冲)
  以为"描述清楚 + 颜色定死 = 机器能执行"

Step 2:运行
  AI 生成错误状态时,颜色对了(红色)
  但文案把 "Critical" 写成了 "严重"

Step 3:检查
  前端按 color_token: status.critical 渲染,视觉层通过
  走查时人眼发现文案降级,但机器没报错
  原因:description 里没有可判定的拦截规则

Step 4:归因
  ├─ description 是给人读的语义描述
  │   机器读不懂"不要替换"这种模糊指令
  │
  └─ visual_mapping 只管视觉,不管文案

Step 5:修正
  强制要求 llm_constraints 必须是可判定的断言,不能是描述
  只准写三类:

  ● 必须型
    "必须显示倒计时"
    → 机器检查字段是否存在
  ● 禁止型
    "禁止用'严重'替代 Critical"
    → 机器字符串匹配,命中即拦截
  ● 限制型
    "只能使用 outline_danger"
    → 机器检查值是否在枚举范围内

Step 6:验证
  机器拿到这三类断言,直接执行
  不需要二次理解"什么叫准确"
2.3 第一份契约:当“错误状态诊断”变成机器能读的规则
这个角色翻译的第一个模式,通常就是"错误状态后果差异未分级":
模式卡片(人读的):
ERR-001 后果差异未分级:系统无法区分致命错误、网络抖动、限流提示和
降级错误,导致用户无法判断后果严重程度。
翻译成YAML(机器读的),四个关键翻译动作:
| 直觉(人懂) | 断言(机器读) | 机器因此能做什么 |
|---|---|---|
| "后果差异未分级" | error_severity: fatal/transient/retryable/degraded | 判断错误属于哪一级 |
| "用户无法判断" | user_action: [刷新 / 导出 / 等待] | 检查是否提供了正确的行动按钮 |
| "红色乱用" | visual_mapping: color_token=status.critical | 校验颜色令牌是否符合语义级别 |
| "文案模糊" | llm_constraints: 必须型/禁止型/限制型 | 拦截包含违禁词的文案 |
反向验证:机器若只读到 error_severity: fatal,能自动推导出“红色脉冲 + 八边形图标 + 刷新按钮 + 不可恢复文案”吗?能。因为视觉映射和用户行动早已写死在契约里,不需要任何二次解释。经验沉淀成一句话:翻译的本体,是“直觉变成断言”;而断言,天生不需要二次理解。
一份契约的结构性骨架(ERR-001错误状态诊断 示例)
契约不是代码,是一份"设计意图的身份证"。7个顶层字段,每个字段回答一个特定问题:详见④主题行《YAML 契约:设计意图的接口定义,编译即规则》
┌─ intent_id ───────────── "我是谁?"
│   命名规则:[领域缩写]-[三位序号]
│   示例:ERR-001(错误状态)、ACT-001(操作按钮)
│
├─ description ─────────── "我解决什么问题?"
│   三段式:现象(用户看到什么)+ 根因(系统缺了什么)+ 后果(用户因此困惑什么)
│   示例:"错误状态后果差异未分级:系统无法区分致命错误与网络抖动,导致用户无法判断后果严重程度"
│
├─ version ─────────────── "我是哪个版本?"
│   格式:x.y.z(SemVer)
│   规则:新增级别=Minor / 删除级别=Major / 文案修正=Patch
│
├─ semantic_domain ─────── "我属于哪个语义域?"
│   引用字典已注册的覆盖层,禁止自创
│   可选值:transactional / observational / navigational / conversational
│
├─ applicable_products ─── "我在哪些产品里生效?"
│   全局:["*"]
│   指定:["ChatGPT", "文心一言", "Kimi"]
│   排除:["*"] + excluded_products: ["某产品"]
│
├─ semantic_tokens ─────── "我定义了什么语义?"
│   │
│   ├─ [令牌组名] ──────── 如 error_severity / process_phase / boundary_action
│   │   │
│   │   ├─ [级别名] ────── 如 fatal / transient / retryable / degraded
│   │   │   │
│   │   │   ├─ description ─ "这个级别的含义是什么?"
│   │   │   │   示例:"系统级故障,对话上下文可能丢失"
│   │   │   │
│   │   │   ├─ visual_mapping ─ "这个级别长什么样?"
│   │   │   │   ├─ color_token ─ 语义颜色(如 status.critical),不写死色值
│   │   │   │   ├─ motion_token ─ 动效(如 pulse.red.urgent / spinner)
│   │   │   │   └─ icon_token ─ 图标(如 alert.octagon / clock)
│   │   │   │
│   │   │   ├─ user_action ─ "用户看到这个级别后,能做什么?"
│   │   │   │   ├─ label ─ 按钮文案(如"刷新页面")
│   │   │   │   ├─ action ─ 动作标识(如 refresh / wait / upgrade)
│   │   │   │   └─ priority ─ 优先级(1=最高,决定按钮排序)
│   │   │   │
│   │   │   └─ llm_constraints ─ "对 AI 的强制要求(必填)"
│   │   │       ├─ 必须型:"必须显示倒计时"
│   │   │       ├─ 禁止型:"禁止仅显示'出错了'"
│   │   │       └─ 限制型:"只能使用 outline_danger 样式"
│   │   │
│   │   └─ [下一级别] ──── 重复上述结构
│   │
│   └─ [下一令牌组] ────── 重复上述结构
│
└─ immutable_boundaries ── "我画了什么红线?"
    │
    ├─ boundary_type ───── 边界类型:safety / semantic / compliance
    ├─ rule ────────────── 禁令命题(可判定):"禁止直接执行删除操作而不显示二次确认"
    └─ violation_action ── 违反后果:block(阻断)/ warn(警告放行)/ escalate(升级人工)
三、YAML契约:不是文档格式,是机器接口
3.1 写在文档里的规范,为什么AI看不见
| 困境 | 典型表现 | 后果 |
|---|---|---|
| 不可见 | 规范写在文档平台,AI工具不读取 | AI按概率生成,"错误=红"的惯性继续 |
| 不可审计 | 改了哪条、谁改的,无记录 | 团队各自理解,版本混乱 |
| 不可复用 | 每个项目重写一遍 Prompt 约束 | 重复劳动,标准不一 |
| 不可校验 | 机器判断不了"那段话"是否被违反 | 只能靠人眼走查,覆盖率约 20% |
3.2 YAML能做到什么:可读、可管、可校验、可分发的四重能力
| 能力 | YAML 如何实现 | 对比自然语言 |
|---|---|---|
| 机器可读 | llm_constraints 直接注入AI的 system message | 自然语言需要人工翻译 |
| 版本管理 | Git Diff自动记录变更历史 | 文档散落,无追溯 |
| 自动校验 | 编译前置校验5项,任一不过即阻断 | 人工走查,遗漏率高 |
| 多格式分发 | 编译管线自动生成4种消费格式 | 人工复制粘贴,同步滞后 |
3.3 关键设计:从"一段话"到"一组断言"
Before(自然语言):
"错误状态要分级,严重的用红色,文案要写清楚。"
——机器无法执行:什么叫"严重"?

After(YAML 断言):
fatal 级别必须 status.critical + 红色脉冲 + "对话上下文可能已丢失"
文案 + 刷新/导出按钮
——每条都可机器校验:能进 CI、能进 Prompt、能被对账
同样是"分级",前者是一段话,后者是一组断言。这就是这个角色存在的理由。
四、谁来翻译?,语义翻译设计师
当设计意图必须变成机器能读懂的规则时,谁来做这件事?答案是:团队里往往会长出一个叫“语义翻译设计师”的角色。他们不写代码,也不管像素,只专注一件事: 确保机器能准确理解设计意图 。 但这活儿一开始并不需要专人专岗,它往往是从各个角色手里自然长出来的。| 角色 | 可以学会的翻译动作 |
|---|---|
| 设计师 | 把直觉翻译成规则 |
| 产品经理 | 把需求翻译成约束 |
| 前端工程师 | 把组件语义翻译成校验规则 |
| DesignOps | 把规范运营翻译成自动化流程 |
五、三道闸门:工作流的三个阶段
Guard 发现问题                Contract 翻译规则              Verify 验证生效
┌────────────────────┐      ┌────────────────────┐      ┌────────────────────┐
│ 6字段快照           │      │ 模式卡片 + 语义字典  │      │ 四层推演 + 对抗测试  │
│ → 三层判定模型       │ ───→ │ → 契约编辑器填7字段  │ ───→ │ → 验证报告          │
│ → 诊断报告          │      │ → 前置校验5项        │      │ 通过率≥95%          │
│ ≥0.85归档/0.60-0.85 │      │ → MR入库(三道闸)   │      │ 误报率<5%           │
│  复核/<0.60新模式   │      │                    │      │                    │
└────────────────────┘      └────────────────────┘      └─────────┬──────────┘
       ↑                                                          │
       └──────────── Verify 不过 → 回流修订;通过 → 编译分发 ──────┘
三道闸不是抽象概念,是我每次提交契约时必须跑完的完整检查链:
| 闸口 | 解决什么问题 | 谁执行 | 不过怎么办 |
|---|---|---|---|
| 第一道:入库安检 | 契约格式对不对、引用是否合法 | 机器自动 | 阻断,返回具体错误项 |
| 第二道:编译验证 | 4种消费格式是否表达同一语义 | 机器自动 | 阻断,退回契约修订 |
| 第三道:运行时拦截 | AI生成内容是否遵守契约约束 | 机器自动 | BLOCK,不流入下游 |
三道闸环环相扣:格式正确 → 语义一致 → 生成合规。前一闸不过,后一闸不启。人只出现在两端,我写契约,我看效果。中间所有检查、翻译、分发、拦截,全部由机器按规则自动执行。
六、五个团队、一个标准:规则怎么在组织里统一
当只有一个人写规则时,没有治理问题。当5个团队、10个产品时,问题出现了:
| 团队 | 对"系统崩溃"提示的做法 | 问题 |
|---|---|---|
| 团队 A | 红色脉冲(符合 ERR-001 契约) | 无 |
| 团队 B | 红色背景加三角形(偏离契约) | 偏离但未被发现 |
| 团队 C | 自创 status.danger(与 status.critical 语义重叠) | 没查字典直接自创,字典未拦截 |
同一个语义,三种表达。治理的四个设计:
- 统一基线 + 团队扩展:组织级规范手册强制继承,团队只能增加不能删减;
- 机器校验代替人工审批:规则写在 schema/intent-schema.json,任何人提交跑同一套检查,不因人而异;
- 消费追踪与沉默规则唤醒:30天零消费自动标记,通知语义规则负责人;
- 效果驱动的基线迭代:多个团队申请同一扩展 → 规范评审组评估是否升级为基线。
编译管线是这套治理的规则分发中枢:输入基线+扩展,按团队隔离编译,输出4种格式,消费数据回流。它让"统一基线、团队自治、无感知接入"从架构宣言变成可运行的工程机制。
七、数据说话:这套能力到底值不值
这个角色第一次用数据证明规则有效,是契约入库一周后打开消费追踪面板(演示环境数据):
| 指标 | 数值 | 解读 |
|---|---|---|
| Prompt 前缀加载 | 23次 | AI工程师侧消费活跃 |
| JSON Schema 引用 | 17次 | 前端侧消费正常 |
| 本月拦截语义漂移 | 5次 | 其中1次:AI把"Critical"写成"严重",被同义词约束拦住并返回修改建议 |
三层度量面板的结构性概括:
个人层(语义翻译设计师)
- 回答:我写的规则有人用吗?拦住了多少问题?
- 核心指标:规则消费率(30天内被加载次数)、拦截归因数(本月因我的规则被拦住的漂移次数)
- 看板:Steward工作台
团队层(DesignOps/前端TL)
- 回答:我们团队接入了吗?返工降了吗?
- 核心指标:基线规则继承率(已接入/应接入)、语义返工率(从30%→5%)
- 看板:团队治理健康度周报
组织层(管理层)
- 回答:这件事投入产出比如何?要不要继续投?
- 核心指标:语义一致性得分(目标95%)、返工成本节省(盈亏平衡点:产品>3且组件>50)
- 看板:季度投入产出报告
所有数字在 Phase 0 为"数据模型推演",Phase 1 试点实测,Phase 2 全域统计。
八、写在最后:你的翻译能力从哪里开始
意图设计的翻译能力,是AI时代设计角色的进化方向。当AI可以生成 80% 的界面时,这个角色的核心价值不再是"画得更好看",而是"告诉AI这个场景下必须表达什么语义、不能突破什么边界"。
这个角色的经验从一次语义漂移的判断开始。你的可以从下篇开始,那里有完整的操作步骤、6个模板和30天上手路径:《角色专题 ④|语义翻译设计师:操作手册》。
系列阅读指引:
- 想了解"怎么发现语义问题并提交给翻译者",见角色专题①《设计师与产品经理》
- 想了解"怎么消费规则、怎么接入约束",见角色专题②《前端与 AI 工程师》
- 想了解契约的字段设计逻辑、语义层与视觉层分离、入库三道闸,见④主题行三篇:《YAML 契约》《字段层差异》《契约的机器防线》
1920