
阿里云通义千问系列在2026年完成了两代主力模型的迭代,当前在售的四款核心模型分别为旗舰级的qwen3.8-max、轻量多模态的qwen3.8-flash、纯文本旗舰qwen3.7-max以及轻量高并发的qwen3.7-flash。四款模型覆盖从超高复杂度多模态专业任务到海量并发轻量交互的全场景需求,但在架构设计、模态支持、推理精度、调用成本上存在明显差异,很多开发者在选型时常常难以匹配最合适的版本。本文将从模型简介、适用场景、能力对比、价格体系、最新活动、选型指南、新人免费额度七个维度全面拆解,帮你快速找到最优的模型搭配方案。阿里云千问大模型中心详情:https://www.aliyun.com/product/tongyi
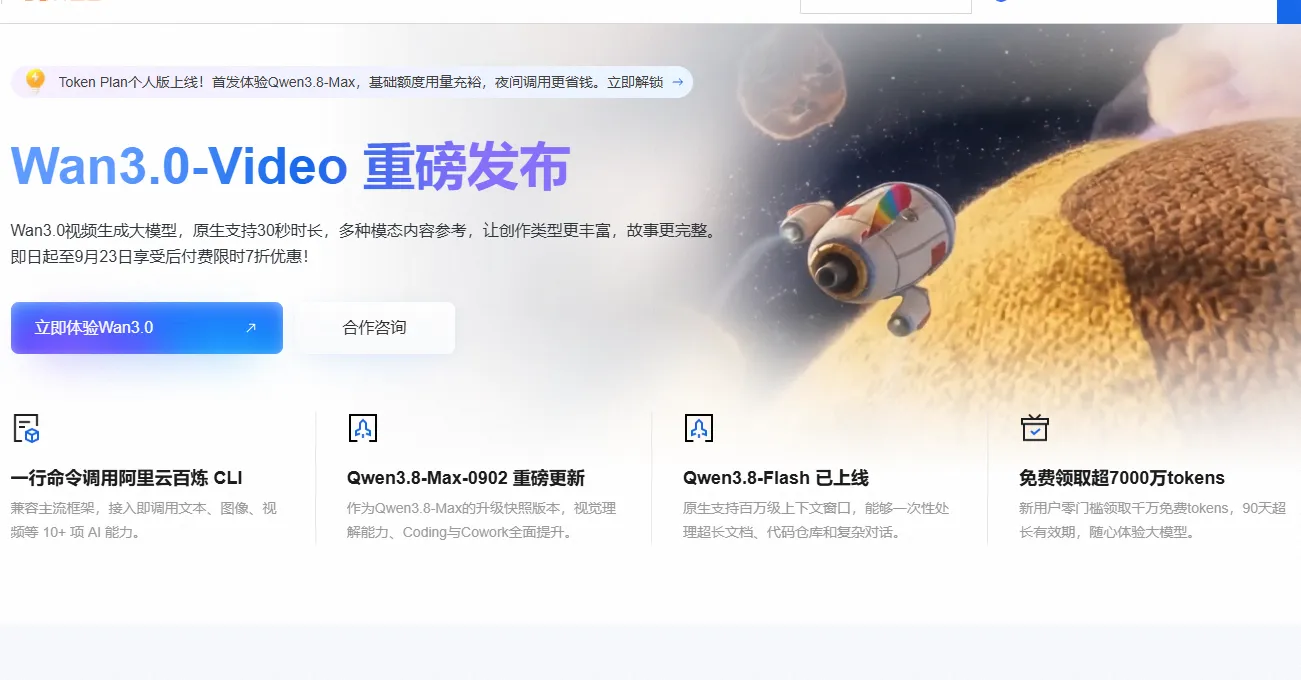
一、阿里云千问qwen3.8-max、qwen3.8-flash与qwen3.7-max、qwen3.7-flash模型简介
qwen3.8-max
2026年8月3日正式发布的千问系列新一代旗舰模型,总参数量2.4万亿,采用第三代稀疏MoE(混合专家)架构,推理时仅激活950亿参数,算力消耗较同等规模密集模型降低60%以上。模型原生支持文本、图像、视频多模态输入,输出为文本,支持100万Token上下文窗口(最大输入991808 Token,最大输出131072 Token,最大思维链长度262144 Token),具备全栈代码工程、长周期智能体执行、原生多模态视觉生产力、专业办公端到端交付等能力,在Text Arena排名全球第五、Vision Arena排名第二,是当前千问系列能力天花板。
qwen3.8-flash
2026年8月26日发布的新一代多模态轻量旗舰模型,采用Next全新架构(也是Qwen4系列的技术预览版本),总参数量1250亿,搭配510亿参数的N-gram Embedding模块,每Token仅激活60亿参数。原生支持文本、图像、视频多模态输入,支持100万Token上下文窗口(最大输出131072 Token,最大思维链262144 Token),训练成本仅为上一代同定位模型的1/9,在编程、办公自动化、智能体任务等多项评测中表现超越同规模竞品,是高并发多模态场景的最优性价比选择。
qwen3.7-max
2026年7月发布的上一代旗舰模型,采用全参数密集架构,总参数量约1.2万亿,推理时激活约450亿参数,仅支持纯文本输入输出,无原生多模态处理能力。支持100万Token上下文窗口,最大输出65536 Token,在纯文本深度推理、超长逻辑推演、高精度代码重构等场景表现稳定,是纯文本专业任务的成熟选择。
qwen3.7-flash
2026年7月15日发布快照版本的轻量高速模型,采用轻量化MoE架构,支持文本、图像、视频多模态输入,输出为文本。支持100万Token上下文窗口,最大输出131072 Token(最大思维链262144 Token),主打毫秒级响应、超高并发、极低成本,推理速度是Max系列的3倍以上,适合高频轻量交互场景。
四款模型的共性:均支持100万Token超长上下文、深度思考与快速模式双推理机制、Function Calling工具调用、结构化输出、联网搜索、上下文缓存等全套生产级特性。
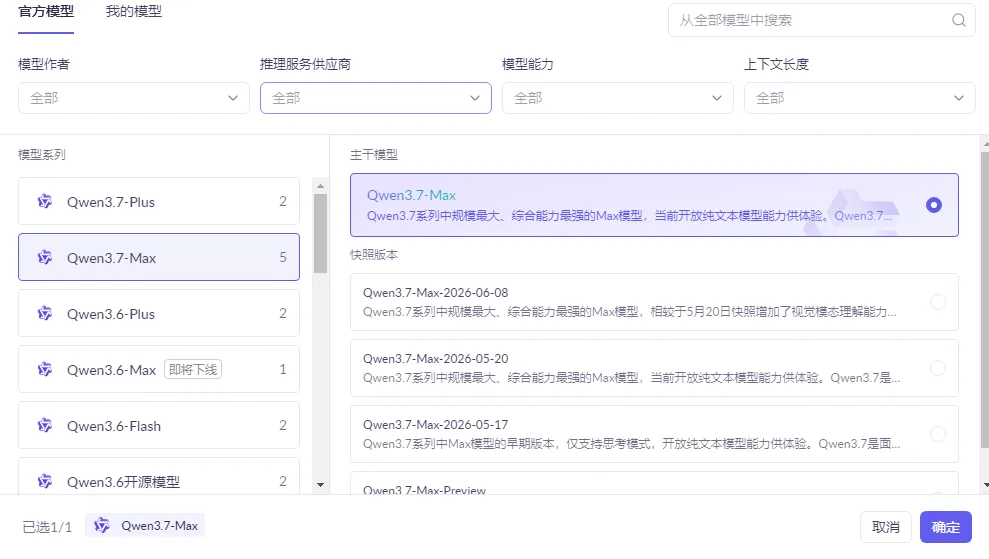
二、阿里云千问qwen3.8-max、qwen3.8-flash与qwen3.7-max、qwen3.7-flash各自适用场景对比
qwen3.8-max适用场景
作为当前能力最强的旗舰模型,适配对精度、复杂度要求极高的多模态专业任务:
- 全栈软件工程:独立完成跨越数天的真实项目开发,支持百万行代码重构、漏洞排查、单元测试自动生成
- 专业领域深度分析:金融财报逐表推演、法律合同逐字审核、芯片设计、量化交易策略生成
- 长周期智能体任务:35小时连续自治执行,支持数千轮工具调用、跨文档关联推理、复杂任务闭环迭代
- 多模态视觉生产力:UI截图重建前端网页、2D平面图转3D效果图、长视频内容解析、复杂图表推理
qwen3.8-flash适用场景
作为高性价比多模态模型,适配绝大多数中高复杂度商用场景:
- 高并发智能体工作流:完整支持Function Calling,适配中等复杂度的多轮工具调用、知识库检索、自动化业务流程
- 编程辅助与代码仓库解析:支持Vibe Coding视觉编程,可读取完整项目源码完成跨文件溯源、漏洞扫描、代码重构
- 多模态内容处理:复杂图表解读、PDF扫描件解析、短视频内容摘要、商品图文生成
- 超长文档批量处理:一次性载入几十万字的合同、研报、项目文档,完成摘要、信息抽取、风险点提取
qwen3.7-max适用场景
作为上一代纯文本旗舰,适配对成本不敏感、对纯文本精度要求极高的场景:
- 纯文本超高精度推理:精密数学推导、学术论文梳理、科研实验方案生成
- 纯文本大型代码工程:百万级存量代码重构、系统分库分表改造、多层复杂算法自主实现
- 纯文本长周期智能体:连续数十小时的文档整理、多步骤深度数据复盘、长篇叙事文稿创作
qwen3.7-flash适用场景
作为轻量高并发模型,适配无复杂逻辑的轻量化交互任务:
- 高并发实时交互:在线客服问答、弹窗即时咨询、海量用户问答
- 轻量级多模态处理:简单截图解析、OCR识别、短视频标签生成、商品图片分类
- 低成本批量任务:批量短文本过滤、基础标签分类、简单数据格式化、标题生成
三、阿里云千问qwen3.8-max、qwen3.8-flash与qwen3.7-max、qwen3.7-flash模型能力对比
| 对比维度 | qwen3.8-max | qwen3.8-flash | qwen3.7-max | qwen3.7-flash |
|---|---|---|---|---|
| 架构 | 第三代MoE架构 | Next架构(Qwen4预览) | 全参数密集架构 | 轻量化MoE架构 |
| 总参数量 | 2.4万亿 | 1250亿+510亿Embedding | 约1.2万亿 | 未公开 |
| 推理激活参数 | 950亿 | 60亿 | 约450亿 | 未公开 |
| 模态支持 | 文本+图像+视频 | 文本+图像+视频 | 纯文本 | 文本+图像+视频 |
| 最大输出Token | 131072 | 131072 | 65536 | 131072 |
| 最大思维链长度 | 262144 | 262144 | 262144 | 262144 |
| 上下文窗口 | 100万Token | 100万Token | 100万Token | 100万Token |
| 推理速度 | 较慢(基准) | 快(比Max快5倍以上) | 中等 | 最快(比Max快10倍以上) |
| 纯文本推理精度 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| 多模态处理能力 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ❌ 不支持 | ⭐⭐⭐ |
| 代码工程能力 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| 长周期Agent能力 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| 工具调用稳定性 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
核心能力差异总结
- 多模态能力:qwen3.8-max和qwen3.8-flash均原生支持图像、视频输入,qwen3.8-max在长视频解析、复杂视觉推理上更强,qwen3.7-max仅支持纯文本,qwen3.7-flash支持轻量多模态处理;
- 推理精度:qwen3.8-max和qwen3.7-max在各自支持的模态范围内精度最高,qwen3.8-flash精度接近旗舰水平,qwen3.7-flash仅适合简单任务;
- 推理速度:qwen3.7-flash > qwen3.8-flash > qwen3.7-max > qwen3.8-max,qwen3.8-flash凭借60亿激活参数实现了接近轻量模型的响应速度,同时具备远超同规模模型的能力。
四、阿里云千问qwen3.8-max、qwen3.8-flash与qwen3.7-max、qwen3.7-flash模型价格
四款模型均采用按量付费模式,以下为华北2(北京)地域的价格对比(单位:元/百万Token):
| 计费项 | qwen3.8-max | qwen3.8-flash | qwen3.7-max(5折后) | qwen3.7-flash |
|---|---|---|---|---|
| 输入(≤32K) | 12 | 0.8 | 6 | 0.2 |
| 输入(32K-256K) | 12 | 0.8 | 6 | 0.6 |
| 输入(256K-1M) | 12 | 0.8 | 6 | 1.2 |
| 输出 | 36 | 2.7 | 18 | 0.4/0.8/2.4(对应输入三档) |
| 缓存命中 | 1.5 | 0.1 | 0.6 | 0.04/0.12/0.24 |
| Batch输入 | 6 | 0.4 | 6 | 0.1 |
| Batch输出 | 18 | 1.35 | 18 | 0.4 |
| 显式缓存创建 | 15 | 1.25 | 7.5 | 0.25 |
| 显式缓存命中 | 1 | 0.1 | 0.6 | 0.02 |
成本对比总结
- qwen3.8-max调用成本最高,输入价格是qwen3.8-flash的15倍、qwen3.7-max(折后)的2倍、qwen3.7-flash的60倍;
- qwen3.8-flash综合成本仅为qwen3.8-max的1/15,同时具备多模态能力,性价比最优;
- qwen3.7-max折后价格与qwen3.8-max持平,但不支持多模态,适合已有纯文本业务迁移;
- qwen3.7-flash输入价格低至0.2元/百万Token,缓存命中仅0.04元/百万Token,是四款中成本最低的。
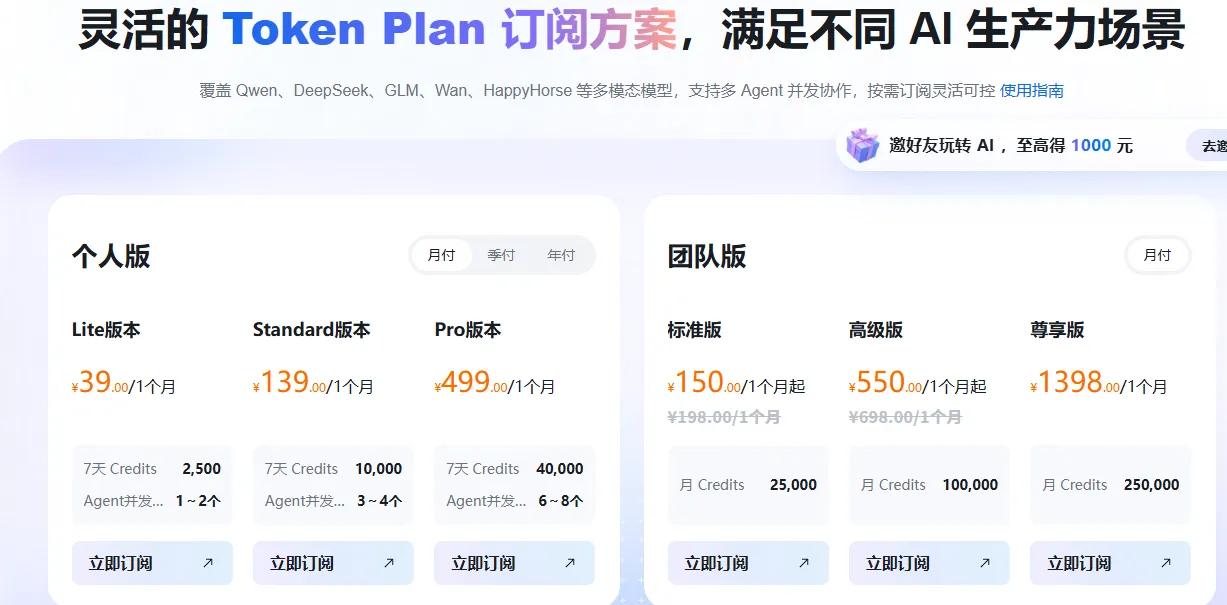
此外,四款模型均可通过Token Plan订阅计划使用,采用Credits统一计量,个人版限时活动价:Lite版39元/月、Standard版139元/月、Pro版499元/月;团队版标准坐席限时150元/席位/月、高级坐席限时550元/席位/月。
五、阿里云千问qwen3.8-max、qwen3.8-flash与qwen3.7-max、qwen3.7-flash最新活动
截至目前,四款模型正在进行多项限时优惠活动:
按量付费限时折扣
- qwen3.8-max:Batch Chat限时5折,输入折后6元/百万Token,输出折后18元/百万Token
- qwen3.7-max:全计费项限时5折,输入6元/百万Token,输出18元/百万Token
- qwen3.8-flash:Batch Chat限时5折,输入折后0.4元/百万Token,输出折后1.35元/百万Token
- qwen3.7-flash:Batch Chat限时5折,输入折后0.1元/百万Token,输出折后0.4元/百万Token
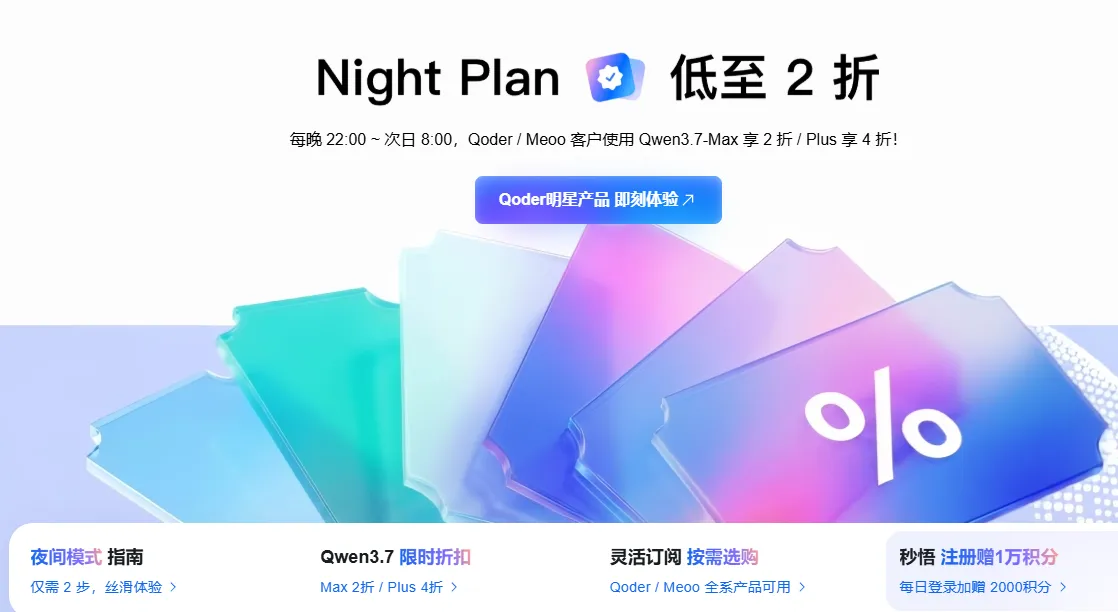
Night Plan夜间错峰优惠
每晚22:00至次日08:00(北京时间),Qoder和秒悟Meoo客户可享受大幅折扣:
- qwen3.8-max:享5折优惠,Credits消耗为白天的50%
- qwen3.8-flash:享4折优惠,Credits消耗为白天的40%
- qwen3.7-max:享2折优惠,Credits消耗为白天的20%,最高可节省80%成本
- qwen3.7-flash:享4折优惠,Credits消耗为白天的40%
覆盖产品包括Qoder全系及秒悟Meoo网页端,Pro Trial试用用户及付费订阅用户自动生效,无需报名、不用领券。活动详情可参考:https://www.aliyun.com/benefit/client/nightplan
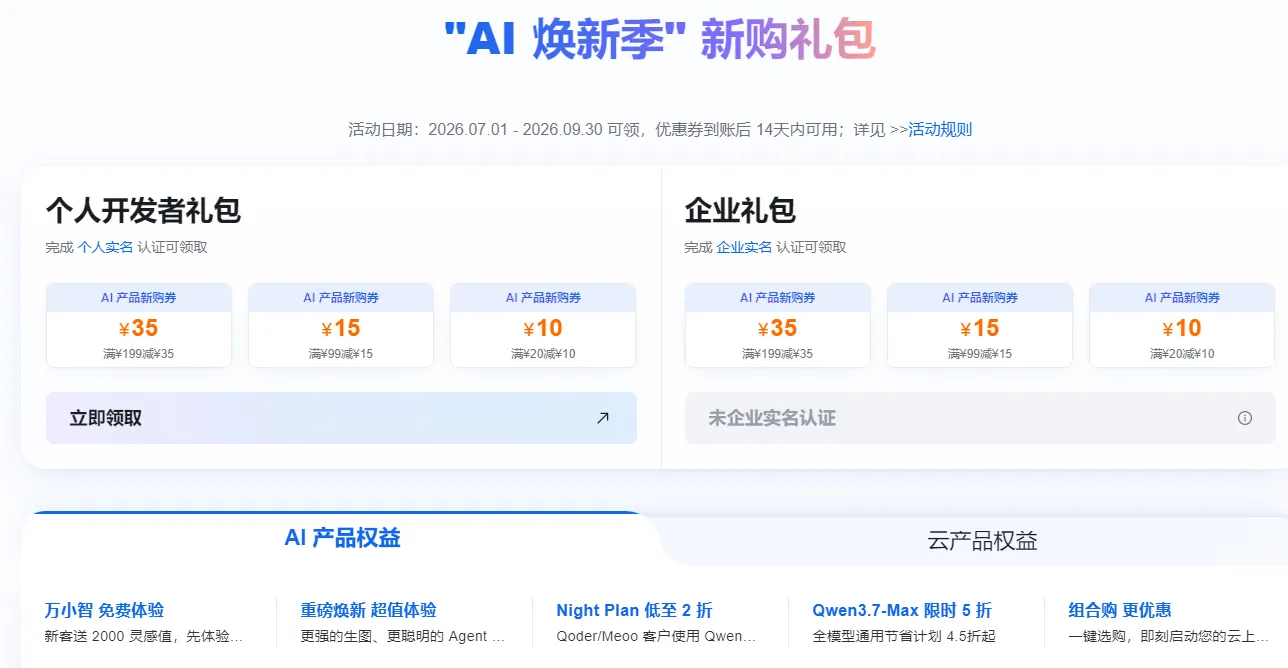
AI焕新季满减券(2026年9月30日截止)
面向已完成实名认证并开通百炼平台的特邀用户,提供三档满减券:满20减10、满99减15、满199减35,领取后14天内有效,支持Token Plan订阅、Qoder套餐等产品抵扣。详情可参考:https://www.aliyun.com/benefit/client/cross
Token Plan订阅套餐限时优惠
个人版和团队版均有限时活动价,相比按量付费可节省30%以上成本,团队版限时优惠仅适用于包月订阅。详情可访问阿里云百炼Token Plan服务页面:https://www.aliyun.com/benefit/scene/tokenplan
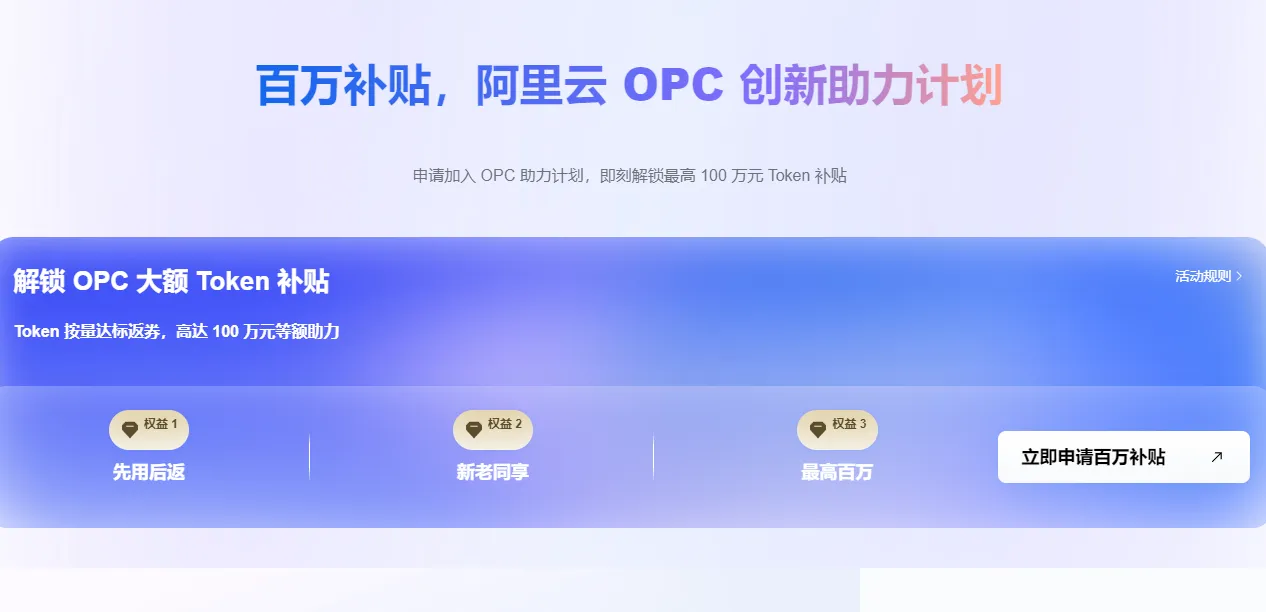
OPC创新助力计划
面向独立开发者、自由职业者及"一人公司",提供最低1000元、最高100万元Token补贴,采用"先用后返"模式。申请入口:https://opc.aliyun.com/products
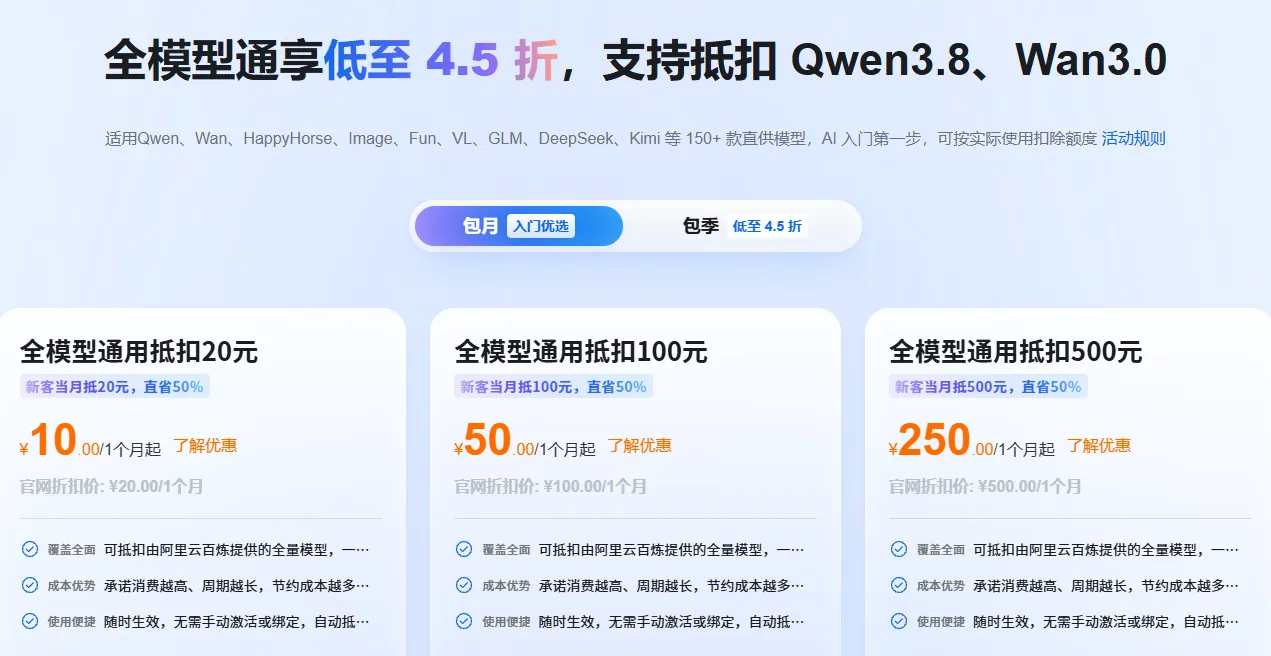
AI通用型节省计划
新客首月10元起,当月可抵扣20元,覆盖全模型通兑,最高享4.5折,可与Token Plan叠加使用。
六、阿里云千问qwen3.8-max、qwen3.8-flash与qwen3.7-max、qwen3.7-flash选择指南参考
选型的核心逻辑是:先判断是否需要多模态能力,再判断任务复杂度,最后考虑成本预算。
第一步:是否需要处理图片、视频等视觉素材?
- 需要 → 优先选择qwen3.8系列(qwen3.8-max或qwen3.8-flash),qwen3.7-max不支持多模态,qwen3.7-flash仅支持轻量多模态处理
- 不需要 → 进入第二步
第二步:任务复杂度如何?
- 超高复杂度(跨天数项目开发、法律金融深度推演、超长文档深度逻辑分析)→ 选择qwen3.8-max
- 中等复杂度(常规编程辅助、图文内容处理、办公自动化)→ 选择qwen3.8-flash,性价比最优
- 纯文本超高精度任务 → 选择qwen3.7-max
- 简单轻量任务(高并发问答、批量短文本处理)→ 选择qwen3.7-flash
第三步:成本预算如何?
- 预算充足,追求极致效果 → qwen3.8-max
- 追求性价比最优 → qwen3.8-flash(绝大多数场景的首选)
- 预算有限,追求极致低成本 → qwen3.7-flash
生产环境推荐:分层调度策略
建议在实际业务中采用分层调度,而非所有请求使用同一款模型:
- 简单问答、短句摘要、高并发实时交互 → 路由到qwen3.7-flash
- 常规图文任务、编程辅助、办公自动化 → 使用qwen3.8-flash
- 超长代码重构、法律金融深度分析、超高精度推理 → 单独调用qwen3.8-max
- 所有场景尽量开启输入缓存复用,可降低最高九成的Token消耗
七、阿里云千问Qwen3.8系列与Qwen3.7系列四款核心模型的综合对比
基础参数对比
| 对比维度 | qwen3.8-max | qwen3.8-flash | qwen3.7-max | qwen3.7-flash |
|---|---|---|---|---|
| 发布时间 | 2026年8月3日 | 2026年8月26日 | 2026年7月 | 2026年7月15日 |
| 定位 | 新一代旗舰 | 新一代轻量多模态 | 上一代纯文本旗舰 | 轻量高速 |
| 架构 | 第三代MoE | Next架构(Qwen4预览) | 全参数密集架构 | 轻量化MoE |
| 总参数量 | 2.4万亿 | 1250亿+510亿Embedding | 约1.2万亿 | 未公开 |
| 推理激活参数 | 950亿 | 60亿 | 约450亿 | 未公开 |
| 模态支持 | 文本+图像+视频 | 文本+图像+视频 | 纯文本 | 文本+图像+视频 |
| 上下文窗口 | 100万Token | 100万Token | 100万Token | 100万Token |
| 最大输入长度 | 991,808 Token | 991,808 Token | 991,808 Token | 991,808 Token |
| 最大输出长度 | 131,072 Token | 131,072 Token | 65,536 Token | 131,072 Token |
| 最大思维链长度 | 262,144 Token | 262,144 Token | 262,144 Token | 262,144 Token |
| 深度思考模式 | ✅ | ✅ | ✅ | ✅ |
| Function Calling | ✅ | ✅ | ✅ | ✅ |
| 结构化输出 | ✅ | ✅ | ✅ | ✅ |
| 联网搜索 | ✅ | ✅ | ✅ | ✅ |
| 35小时自治执行 | ✅ | ✅ | ✅ | ✅ |
价格对比(华北2北京地域,单位:元/百万Token)
| 计费项 | qwen3.8-max | qwen3.8-flash | qwen3.7-max(限时5折) | qwen3.7-flash |
|---|---|---|---|---|
| 输入(≤32K) | 12 | 0.8 | 6 | 0.2 |
| 输入(32K-256K) | 12 | 0.8 | 6 | 0.6 |
| 输入(256K-1M) | 12 | 0.8 | 6 | 1.2 |
| 输出 | 36 | 2.7 | 18 | 0.4/0.8/2.4(对应输入三档) |
| 缓存命中 | 1.5 | 0.1 | 0.6 | 0.04/0.12/0.24 |
| Batch输入 | 6 | 0.4 | 6 | 0.1 |
| Batch输出 | 18 | 1.35 | 18 | 0.4 |
| 显式缓存创建 | 15 | 1.25 | 7.5 | 0.25 |
| 显式缓存命中 | 1 | 0.1 | 0.6 | 0.02 |
| 成本等级 | ⭐⭐⭐⭐ 最高 | ⭐⭐ 中等 | ⭐⭐⭐ 较高 | ⭐ 最低 |
性能与能力对比
| 对比维度 | qwen3.8-max | qwen3.8-flash | qwen3.7-max | qwen3.7-flash |
|---|---|---|---|---|
| 推理速度 | 较慢(基准) | 快(比Max快5倍以上) | 中等 | 最快(比Max快10倍以上) |
| 纯文本推理精度 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| 多模态处理能力 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ❌ 不支持 | ⭐⭐⭐ |
| 代码工程能力 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| 长周期Agent能力 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| 工具调用稳定性 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ |
| Vibe Coding | ✅ 支持 | ✅ 支持 | ❌ 不支持 | ✅ 支持 |
| 复杂图表推理 | ✅ 支持 | ✅ 支持 | ❌ 不支持 | ⚠️ 轻量支持 |
| 长视频解析 | ✅ 支持 | ✅ 支持 | ❌ 不支持 | ⚠️ 轻量支持 |
适用场景对比
| 场景类型 | qwen3.8-max | qwen3.8-flash | qwen3.7-max | qwen3.7-flash |
|---|---|---|---|---|
| 全栈项目开发 | ✅ 首选 | ⚠️ 中小型项目 | ✅ 纯文本项目 | ❌ 不适用 |
| 金融/法律深度推演 | ✅ 首选 | ⚠️ 可用 | ✅ 首选(纯文本) | ❌ 不适用 |
| 百万行代码重构 | ✅ 首选 | ⚠️ 中等规模 | ✅ 首选(纯文本) | ❌ 不适用 |
| 多模态图文视频处理 | ✅ 首选 | ✅ 首选 | ❌ 不支持 | ⚠️ 轻量支持 |
| UI截图转代码 | ✅ 首选 | ✅ 首选 | ❌ 不支持 | ⚠️ 可用 |
| 复杂图表推理 | ✅ 首选 | ✅ 首选 | ❌ 不支持 | ⚠️ 简单图表 |
| 通用文案/办公 | ⚠️ 大材小用 | ✅ 首选 | ⚠️ 大材小用 | ⚠️ 简单任务 |
| 高并发实时客服 | ❌ 成本过高 | ⚠️ 可用 | ❌ 成本过高 | ✅ 首选 |
| 简单问答/摘要 | ❌ 成本过高 | ⚠️ 可用 | ❌ 成本过高 | ✅ 首选 |
| 批量文本处理 | ❌ 成本过高 | ⚠️ 可用 | ❌ 成本过高 | ✅ 首选 |
| 长周期智能体 | ✅ 首选 | ✅ 中等复杂度 | ✅ 首选(纯文本) | ⚠️ 轻量任务 |
选型速查总结
| 你的需求 | 推荐模型 | 理由 |
|---|---|---|
| 有图片/视频/截图处理需求+高复杂度 | qwen3.8-max | 多模态+推理精度双天花板 |
| 有图片/视频/截图处理需求+中等复杂度 | qwen3.8-flash | 多模态+性价比最优 |
| 纯文本超高精度推理(金融/法律/科研) | qwen3.7-max | 纯文本精度最高 |
| 日常通用开发/办公/图文任务 | qwen3.8-flash | 性价比之王,覆盖绝大多数场景 |
| 高并发客服/简单问答/批量处理 | qwen3.7-flash | 速度最快、成本最低 |
| 预算有限,追求极致低成本 | qwen3.7-flash | 输入仅0.2元/百万Token |
| 预算充足,追求极致效果 | qwen3.8-max | 能力天花板 |
| 不确定,想要"万金油" | qwen3.8-flash | 多模态+高性价比+覆盖广 |
生产环境分层调度建议
| 请求类型 | 路由目标 | 说明 |
|---|---|---|
| 简单问答、短句摘要、高并发交互 | qwen3.7-flash | 成本最低,速度最快 |
| 常规图文任务、编程辅助、办公自动化 | qwen3.8-flash | 性价比最优,多模态全能 |
| 超长代码重构、法律金融深度分析 | qwen3.8-max | 精度最高,处理最复杂任务 |
| 纯文本超高精度专业任务 | qwen3.7-max | 纯文本场景成熟稳定 |
八、阿里云千问大模型新人免费额度介绍
阿里云百炼的新人免费额度在首次开通时由系统自动发放,无需手动领取或购买任何产品,每个模型通常拥有独立的免费额度(如100万Token),有效期为90天。具体各模型的免费额度数值及剩余情况,详情可通过阿里云百炼平台获取:https://www.aliyun.com/product/bailian
核心规则说明
- 适用范围:仅华北2(北京)地域的模型享有免费额度,且仅抵扣模型实时推理(调用)产生的费用;Batch调用、模型调优、模型部署、自定义模型及OSS存储等不支持用免费额度抵扣。
- 有效期计算:从开通阿里云百炼、模型发布或模型申请通过之日起计算(以较晚者为准)。2025年9月8日11点前已开通的用户,免费额度有效期可能不足90天;在此之后开通的用户有效期为90天。额度过期或耗尽后自动失效,不支持补发、延期或重置。
- 额度独立性:不同模型(含同一模型的不同快照版本)的免费额度相互独立,不互通、不共享;主账号与RAM子账号共享同一模型的免费额度。
- 认证要求:无需实名认证即可获取和使用免费额度;但未认证用户免费额度用完后无法继续调用,需完成认证并充值后方能按量付费。
查看与管理
- 查看剩余额度:可通过控制台免费额度页面、模型广场详情页或模型用量页面查看各模型的免费额度余量及过期时间。
- 避免意外扣费:已认证用户可在免费额度页面开启“免费额度用完即停”功能,额度耗尽时服务自动停止并返回HTTP 403错误,不会继续扣费。
总结建议:qwen3.8系列是当前千问的主力迭代版本,多模态能力和性价比全面优于qwen3.7系列,建议新用户优先选择qwen3.8-flash作为主力模型,复杂任务升级至qwen3.8-max,纯文本高并发场景使用qwen3.7-flash降低成本。先领取免费额度体验效果,再结合夜间优惠和满减券活动,把每一分预算都花在刀刃上。
