
一篇面向开发者和技术选型人员的兼容性测试方法指南。不空谈,给可落地的验证步骤。
阅读时间:约 12 分钟 | 标签:#数据库选型 #兼容性测试 #Oracle #MySQL
数据库选型或迁移时,几乎每家厂商都会在售前材料里写「100% 兼容 Oracle / MySQL」。但真到 POC 和割接,很多团队才发现「兼容」这个词有巨大的解释空间:语法能跑,不代表语义正确;语义正确,不代表性能不塌。
本文不讨论「该不该换库」,只解决一个工程问题:怎么用一套可复现的方法,把厂商口中的「兼容」验证成可验收的事实。
一、「兼容」不是一个词,是四个层
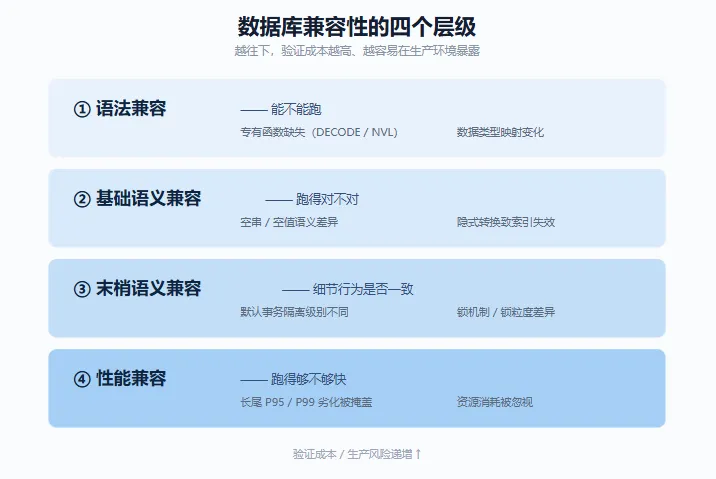
谈兼容必须先分层。一个被广泛采用的框架,是把兼容拆成四层:
| 层级 | 覆盖范围 | 回答的问题 | 典型风险点 |
|---|---|---|---|
| 语法兼容 | DDL/DML/函数/操作符 | 能不能跑 | 专有函数缺失、数据类型映射变化 |
| 基础语义兼容 | NULL 处理、隐式类型转换、聚合行为 | 跑得对不对 | 空串/空值差异、隐式转换导致索引失效 |
| 末梢语义兼容 | 事务隔离级别、锁机制、系统变量 | 细节行为是否一致 | 默认隔离级别不同、锁粒度差异引发并发问题 |
| 性能兼容 | OLTP 吞吐量波动区间 | 跑得够不够快 | 只比峰值不比长尾,P95/P99 劣化被掩盖 |
大多数数据库能做到前两层,第三层开始暴露差异,第四层最容易被销售话术模糊掉。下面逐层给验证方法。
二、每一层怎么测
2.1 语法兼容:先做覆盖度扫描,再谈通过率
语法兼容的验证目标,是搞清楚存量 SQL 里有多少能「原样迁移」、多少需要改写。
方法:用迁移评估工具对生产/测试库的 SQL 日志、存储过程、视图做静态扫描,输出对象级兼容报告,重点看三个指标:
- 直接可迁移占比:无需改写就能跑的对象比例。
- 改写点清单:哪些专有函数、语法结构需要重写。典型如 Oracle 的
DECODE、NVL、(+)外连接写法:
-- Oracle 专有写法(迁移到标准 SQL 需改写)
SELECT DECODE(status, 1, '启用', 2, '停用', '未知') FROM t_order;

-- 等价的标准 CASE 写法
SELECT CASE status WHEN 1 THEN '启用' WHEN 2 THEN '停用' ELSE '未知' END FROM t_order;
- 数据类型映射风险:
NUMBER、VARCHAR2、DATE在目标库的精度、长度、时区行为是否一致。
经验:别只看「自动转换成功率 95%」这种总数字。要问清楚剩下 5% 是什么、落在哪些核心对象上——一个存储过程里的半自动改写,可能顶得上一百张普通表的全自动迁移。
2.2 基础语义兼容:用边界用例抓差异
这一层的坑,几乎都是「看起来没区别,跑起来结果不一样」。
最经典的是空串与 NULL 的处理。Oracle 里空字符串 '' 等价于 NULL;MySQL 里空串是空串、不等于 NULL:
-- 同一句 SQL,在两个库里结果可能完全不同
SELECT COUNT(*) FROM t WHERE col = '';
-- Oracle: '' 等价 NULL,col='' 恒不成立,结果为 0
-- MySQL : 匹配实际为空串的行,结果可能 > 0
另一个高频坑是隐式类型转换。字符串列和数字常量比较时,目标库的转换规则不同,轻则结果集变化,重则索引失效、把走索引的查询变成全表扫描:
-- order_id 是数字列,'10086' 是字符串常量
SELECT * FROM orders WHERE order_id = '10086';
-- 若目标库隐式把数字列转成字符串再比较,可能放弃索引
方法:不要用随机数据测,要构造「边界用例集」——空串、空值、0、负数、超长字符串、特殊字符、时区边界,逐条在源库和目标库跑同一句 SQL,diff 结果集。差异测试比功能冒烟测试更能暴露语义层问题。
2.3 末梢语义兼容:隔离级别和锁是定时炸弹
这一层是生产事故高发区。几个典型差异:
- 默认事务隔离级别不同:Oracle 默认 READ COMMITTED,MySQL InnoDB 默认 REPEATABLE READ。业务代码若依赖了某种隔离级别下的行为(幻读、不可重复读预期),迁移后并发行为会变。
- 锁机制差异:行锁、间隙锁、锁升级粒度不同,可能让同样的业务在目标库出现新的死锁或并发争用。
- 系统变量语义:
autocommit、事务超时、连接池参数默认值不一致,直接影响事务边界。
方法:做一张「隔离级别 × 并发操作」矩阵,在 READ COMMITTED、REPEATABLE READ 下分别跑并发读写用例,观察幻读、死锁、阻塞行为是否与预期一致。
-- 确认目标库当前隔离级别
-- MySQL      : SELECT @@transaction_isolation;
-- PostgreSQL : SHOW transaction_isolation;
这一层必须做并发压测,单线程冒烟测不出来。
2.4 性能兼容:比长尾,别只比峰值
性能兼容的验证目标是「迁移后性能波动在可接受区间」。
方法:迁移前后用同一套基准(TPC-C 风格的 OLTP 负载)对比,重点看三个数:
- 平均吞吐量:是否在合理波动范围。
- P95 / P99 延迟:长尾劣化比平均吞吐量更致命,尤其对交易类系统。
- 资源消耗:同负载下 CPU、内存、IO 的变化,避免「性能达标但成本翻倍」。
经验:售前 PPT 里的性能对比往往是「峰值最优值」,不代表生产常态。一定要看长尾延迟和资源消耗曲线,这两项才决定上线后的用户体感和账单。
三、一套可复现的 POC 验证清单
把上面的方法串成可执行流程,选型时照着走:
| 阶段 | 验证动作 | 输出 |
|---|---|---|
| 迁移前 | SQL/对象兼容扫描,统计可迁移占比与改写点 | 兼容性评估报告 |
| 迁移前 | 数据类型映射核对,边界用例集准备 | 差异风险清单 |
| 迁移中 | 数据一致性校验,增量同步与在线比对 | 数据一致性报告 |
| 迁移后 | 隔离级别矩阵 + 并发压测 | 并发行为验证记录 |
| 迁移后 | 性能基准对比(平均吞吐 + P95/P99 + 资源消耗) | 性能对比报告 |
| 迁移后 | 边界用例回归(空串/空值/隐式转换) | 语义差异记录 |
验收标准建议:把「100% 兼容」翻译成可量化验收项,例如「核心对象可迁移率 ≥ X%」「边界用例结果集一致率 = 100%」「P95 延迟劣化 ≤ X%」。把模糊话术变成可验收指标,是选型谈判里最有效的动作。
四、三个高频踩坑点
- 别只看通过率,要问「没通过的是什么」。那 5% 的改写点如果落在核心交易路径上,改造成本可能超过迁移本身。
- 别只在测试环境测。生产的数据量、数据分布、SQL 复杂度、并发规模完全不同,测试环境全绿不代表生产能过。
- 别忽略周边工具。监控、备份、审计、数据同步这些周边工具链的兼容程度,直接决定迁移后「能不能过上好日子」,却最容易被排除在评估之外。
结语
「100% 兼容」是销售的入场券,不是验收的依据。选型时把它当成一个待验证的假设,用上面的四层方法,把它变成已验证的事实——这才是对生产负责的做法。
验证通过之后,还有一句话值得记进选型纪要:兼容帮你把迁移门槛降到最低,但决定系统三年后账本的,是兼容之外的原生能力——运维生态、性能工程、云原生演进。兼容是敲门砖,不是护城河。
本文为技术选型方法分享,不构成任何产品推荐。
