本文是一篇纯技术视角的架构梳理。目标是帮你理解一个BI系统内部到底由哪些部件组成、它们之间如何协作,从而在选型、搭建或运维时看懂门道。
一、BI不是"画图工具",而是一条数据流水线
很多人以为BI就是"连个数据库、拖个图表"。实际上,从原始数据到一块能指导决策的看板,中间要经过一整条工程流水线。任何一环薄弱,结果就是:取数慢、口径乱、图表不准、老板不敢信。
一套完整的BI技术架构,通常可以拆成六层:
1. 接入层——把数据"搬"进来;
2. 数据准备层——把数据"洗干净、存整齐";
3. 语义层——把指标"定义清楚、统一口径";
4. 查询与计算引擎——把查询"算得快";
5. 分析与可视化层——把结果"看得懂";
6. 服务与治理层——把能力"用得出去、管得起来"。
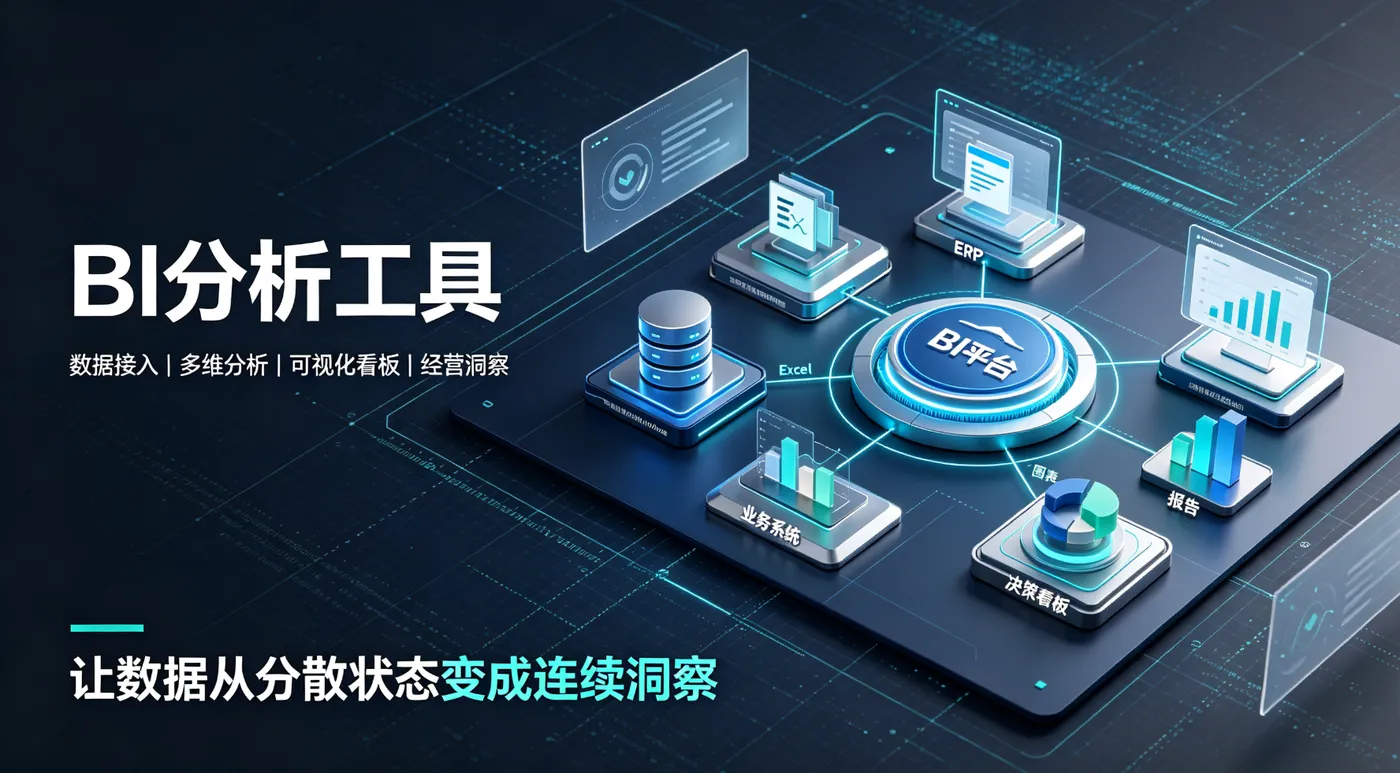
二、六层架构总览
层级 |
核心职责 |
关键技术/组件 |
L1 接入层 |
多源数据连接与同步 |
JDBC/ODBC、API、CDC、文件解析 |
L2 数据准备层 |
清洗、建模、存储 |
ETL/ELT、数据仓库、数据湖仓 |
L3 语义层(指标平台) |
统一业务口径 |
维度建模、指标定义、权限映射 |
L4 查询计算引擎 |
高性能查询与聚合 |
OLAP、向量化执行、内存计算 |
L5 分析与可视化层 |
自助分析与呈现 |
自助BI、看板、嵌入式分析 |
L6 服务与治理层 |
共享、告警、血缘、安全 |
API、订阅、数据血缘、脱敏 |
> 和AI架构一样,安全与治理是横切全栈的,不单独占一层,但每一层都要考虑。
三、L1 接入层:数据的入口
BI的价值上限,取决于它能连到多少真实数据源。
● 连接器类型:关系型数据库(JDBC/ODBC)、大数据引擎、SaaS API(REST)、消息队列、对象存储里的文件(Excel/CSV/日志)。
● 同步方式:
-批量(Batch):定时全量/增量抽取,适合T+1报表;
-流式(Streaming):实时摄入,适合监控大屏;
-CDC(变更数据捕获):捕获数据库变更日志,增量同步更轻量。
● 常见坑:源系统字段改了、时区不一致、编码乱码——接入层要有 schema 校验和告警,否则下游全错。
四、L2 数据准备层:洗和存
原始数据不能直接分析,要先清洗、关联、建模。
● ETL vs ELT。传统ETL是"先转换再入库";现代ELT借助数据仓库的计算能力,主张"先入库再转换",更灵活、可回溯。湖仓架构让两者边界进一步模糊。
● 数据仓库(Data Warehouse)。面向分析优化的存储,按主题组织(如销售域、库存域)。核心概念是星型模型:一张事实表(交易记录)+ 多张维度表(时间、地区、产品)。
● 数据湖仓(Lakehouse)。在低成本存储上叠加事务与治理,既能存原始明细,也能建分析表,逐渐成为新底座。
● 数据质量。去重、空值处理、单位统一、缓慢变化维(SCD)处理——这些"无聊"的活,决定了BI可不可信。
五、L3 语义层:BI架构里最该重视的一层
很多BI项目失败,不是图不好看,而是同一个"销售额"在不同报表里数字对不上。语义层(Semantic Layer)就是来解决这个问题的。
它做三件事:
7. 统一定义指标:把"销售额""活跃用户""毛利率"的业务含义、计算口径、过滤条件写成一份权威定义,所有人引用同一份,避免各算各的。
8. 映射维度与层级:地区→省份→城市,时间→年→月→日,让下钻上卷有统一路径。
9. 绑定权限:哪些人能看哪个部门的数据,在语义层统一配置,而不是在每个报表里硬写。
行业里近年把这一层独立成"指标平台(Metrics Layer)",甚至演化出"Headless BI"——语义层作为独立服务,前端看板、API、AI问答都从它取数,保证"无论怎么看,口径都一致"。这对后面接AI问答尤其重要。
六、L4 查询与计算引擎:快才是硬道理
用户点一下筛选,3秒出结果和30秒出结果,体验天差地别。引擎层的优化手段主要包括:
● OLAP(联机分析处理):
-MOLAP:预聚合 cube,查询极快但占用空间大、不够灵活;
-ROLAP:直接查关系表,灵活但依赖引擎优化;
-HOLAP:两者结合,热数据预聚合、冷数据实时算。
● 列存(Columnar Storage):分析查询通常只取几列,列存大幅减少IO。
● 向量化执行:一次处理一批数据而非一行,充分利用CPU。
● 内存计算(In-memory):把热点数据放内存,告别磁盘瓶颈。
● 物化视图/预计算:把常用聚合提前算好,查询时直接读结果。
选型权衡点:数据量、查询并发、实时性要求、成本。没有"最快"的引擎,只有"最合适"的组合。
七、L5 分析与可视化层:人真正接触的部分
● 自助式分析(Self-service):业务人员自己拖拽字段生成图表,不依赖IT取数。前提是语义层建得好,否则人人都能造出"错误但好看"的图。
● 看板(Dashboard)与大屏:把关键指标固化成监控视图,支持下钻、联动、筛选。
● 即席查询(Ad-hoc):临时想问"上个月华东区退货率是多少",能快速拖出来。
● 嵌入式分析(Embedded Analytics):把图表/报表能力嵌进业务系统(如CRM里直接看客户画像),而非让用户跳到另一个平台。
● AI增强分析(近期趋势):用自然语言提问直接出图、自动找异常波动原因、生成文字结论——这要求前面的语义层和指标平台足够扎实,否则"AI说的数字"没人敢信。
八、L6 服务与治理层:让BI用得久
● API与订阅:报表结果能推送到钉钉/企微/邮件,或供其他系统调用。
● 告警:指标跌破阈值自动通知负责人。
● 数据血缘(Lineage):这张图的数字,从源头哪张表、经过哪步转换得来?出了问题能快速定位。
● 权限与脱敏:行级(只看自己部门)、列级(手机号打码)权限,满足合规。
● 生命周期:看板会过期,要有下线和归档机制,别让垃圾报表淹没搜索。
九、批处理 vs 实时:两条技术路线
维度 |
批处理(Batch) |
实时/近实时(Streaming) |
时延 |
分钟~小时级 |
秒~亚秒级 |
典型场景 |
经营月报、财务结算 |
实时监控大屏、风控 |
架构 |
调度+数仓 |
消息队列+流处理+时序存储 |
成本 |
低 |
高 |
实践中多为"批处理打底、实时补关键链路"的混合架构。
十、给技术负责人的三条建议
10. 先建语义层,再铺看板。口径统一的指标平台,是BI可信、可扩展的地基;没有它,看板越多越乱。
11. 数据质量预算不能省。接入层的schema校验、准备层的去重空值处理,是隐性但致命的投入。
12. 为AI问答预留接口。如果未来想做"用自然语言查数据",今天就把指标口径和权限固化在语义层,否则AI只能瞎编数字。
---
本文为BI技术架构通识梳理。如需做选型评估,可基于上述六层分别列出评估维度(连接广度、建模能力、查询性能、语义层成熟度、治理完备度)逐项打分。