周五傍晚,研发把一个 PR 丢进群里:“AI 辅助改完了优惠计算逻辑,47 个文件,单测全绿,麻烦测一下。”
测试最怕的,往往不是 47 个文件,而是下一句:
“那是不是把回归跑一遍?”
如果每次 AI Coding 改动都全量回归,测试环境、执行时长和人力很快会被压垮;如果只挑几个接口测,又极容易漏掉订单金额、支付金额、优惠券核销这些真正贵的风险。
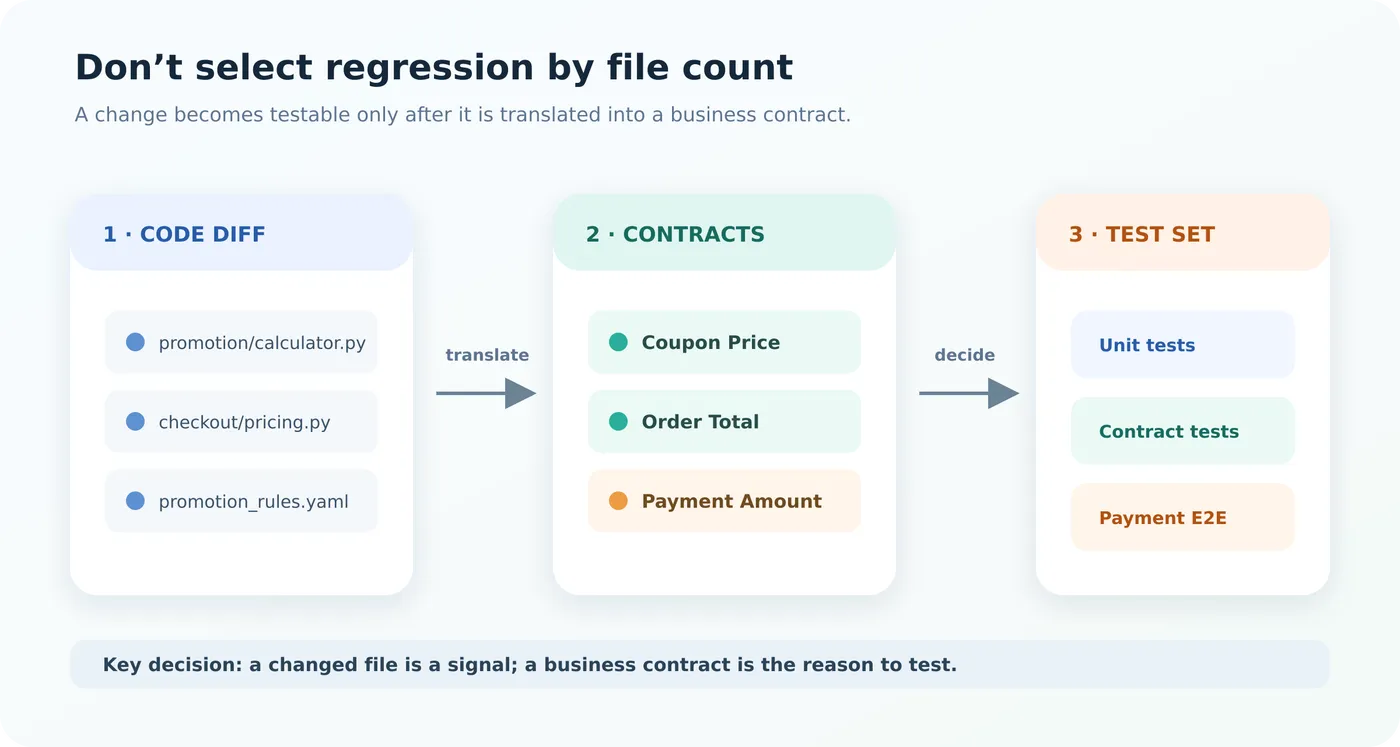
结论先说:回归范围不该按“改了多少文件”决定,而应该按“哪些业务合约被改变、改变后是否可逆、会波及到哪些下游合约”决定。
AI 可以帮团队写代码、拆文件、改配置、补测试,但不应该由它来拍脑袋决定“测什么”。测试团队要把这件事变成一条可追溯的工程链路:
代码 Diff → 业务合约 → 风险等级 → 测试集 → CI 放行结论
一、代码 Diff 只能告诉你“改了哪里”,不能告诉你“会赔多少钱”
假设电商团队把优惠计算从订单服务里拆出来,交给 AI Coding 工具协助重构。
这次变更包含:
services/promotion/下的满减、折扣券、会员券计算;- 订单结算页的金额展示;
- 支付前创建交易单的金额校验;
- 一份优惠规则配置;
- 若干测试桩和接口字段。
如果只按文件路径理解风险,测试很容易得到一个错误结论:
| 改动文件 | 表面判断 | 真正需要验证的业务合约 |
|---|---|---|
promotion/calculator.py |
优惠模块单测 | 优惠金额不能超过商品金额 |
order/checkout.py |
下单接口回归 | 应付金额、优惠明细、库存锁定 |
payment/create_trade.py |
支付接口回归 | 支付金额必须等于订单应付金额 |
promotion_rules.yaml |
配置变更 | 新老优惠规则兼容、灰度用户一致性 |
这里的“业务合约”,不是接口文档上的字段说明,而是系统不能被破坏的承诺。
例如:
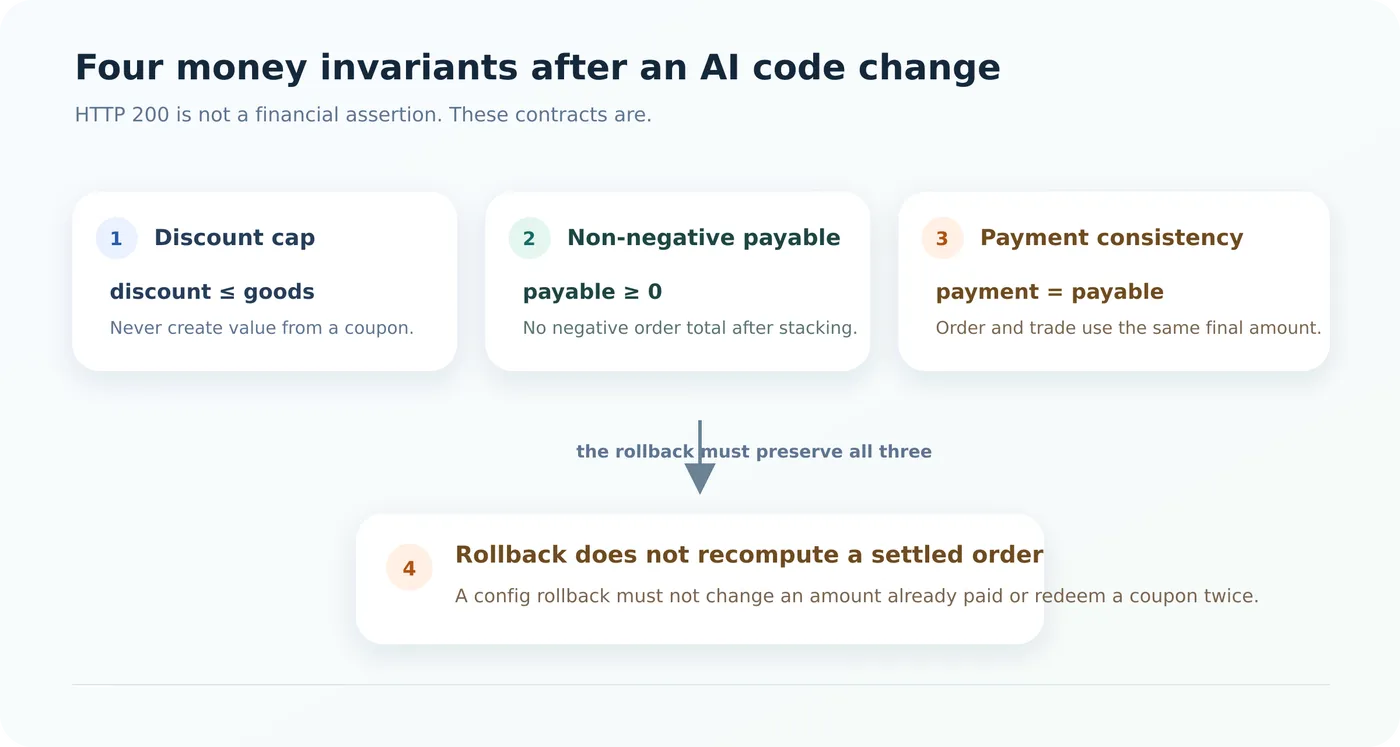
- 优惠金额不能超过商品金额;
- 订单应付金额不能为负;
- 订单金额和支付交易单金额必须一致;
- 同一张优惠券不能被重复核销;
- 降级或回滚后,已创建订单不能重新计算出另一个金额。
AI 生成的代码最容易让人误判的一点是:它可能把一个业务规则拆散到多个文件里,也可能通过重构、抽象、重命名,让 Diff 看起来“只是局部调整”。
但用户不会因为你的代码结构更优雅,就原谅一次多扣款。
二、先维护“业务合约地图”,再让 CI 选择测试
下面是一份可放进仓库维护的 impact-map.yaml。它不依赖某个大模型,也不需要先上复杂平台;核心是让研发、测试、产品对“改动会影响什么”形成共同语言。
policy:
  expand_threshold: 12

contracts:
  coupon_price:
    paths:
      - "services/promotion/**"
      - "schemas/promotion*.py"
    criticality: 5        # 收入和用户感知,最高级
    irreversible: false
    downstream:
      - order_total
      - payment_amount

  order_total:
    paths:
      - "services/order/checkout.py"
      - "services/order/pricing/**"
    criticality: 5
    irreversible: false
    downstream:
      - payment_amount
      - coupon_redeem

  payment_amount:
    paths:
      - "services/payment/**"
    criticality: 5
    irreversible: true    # 已发起支付后的补救成本高
    downstream: []

  coupon_redeem:
    paths:
      - "services/promotion/redeem/**"
    criticality: 4
    irreversible: true
    downstream: []

tests:
  - id: coupon_unit
    command: "pytest -q tests/unit/test_coupon_calculator.py"
    covers: [coupon_price]

  - id: checkout_contract
    command: "pytest -q tests/contract/test_checkout_amount.py"
    covers: [coupon_price, order_total]

  - id: payment_e2e
    command: "pytest -q tests/e2e/test_pay_after_coupon.py"
    covers: [order_total, payment_amount, coupon_redeem]

  - id: rollback_regression
    command: "pytest -q tests/regression/test_coupon_rollback.py"
    covers: [coupon_price, order_total, payment_amount]
这份地图里有两个关键设计。
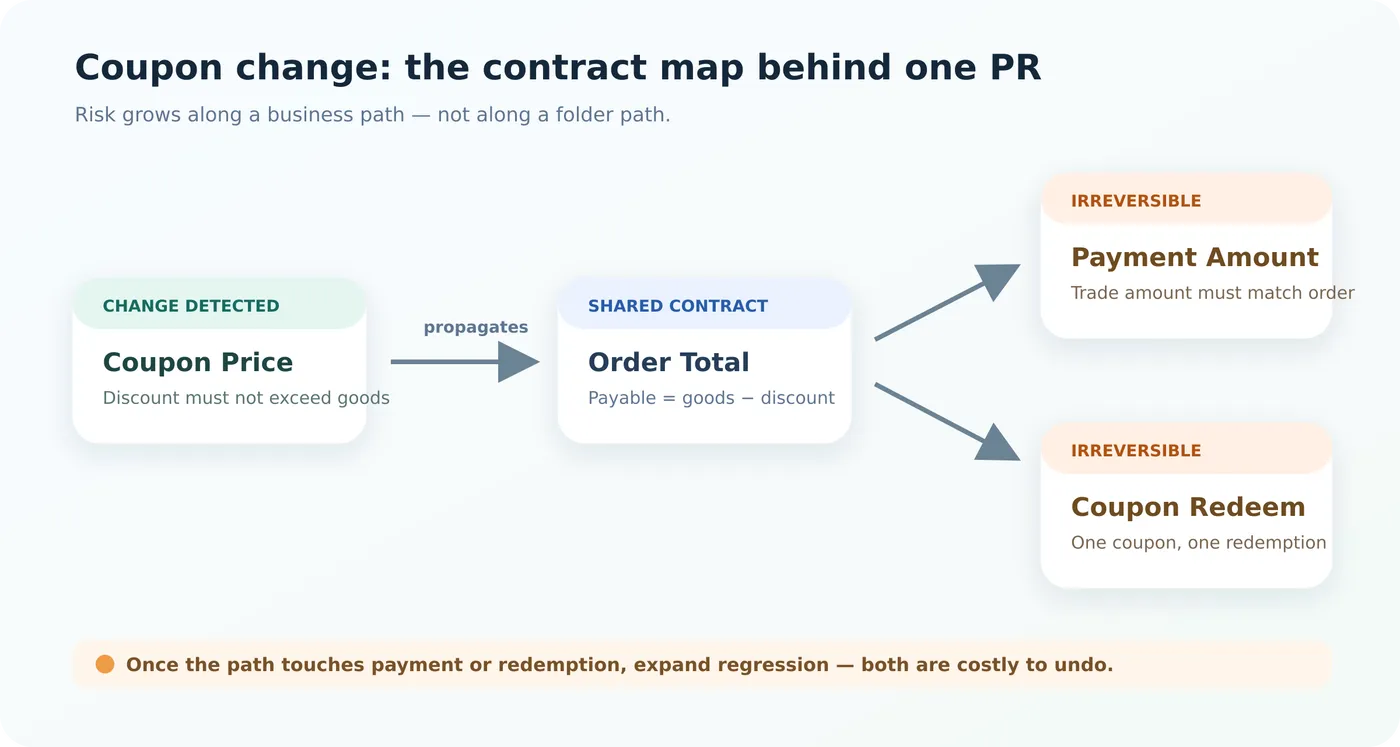
第一,路径不是测试范围,路径只是合约识别信号。services/promotion/** 被改动,不代表只跑优惠单测;它意味着 coupon_price 这个合约被触发,需要继续判断它会不会影响订单和支付。
第二,不可逆比文件复杂度更重要。
支付、扣券、库存锁定这类动作,一旦出现错误,往往不是“重新发布修一下”就能解决。它们应该天然得到更高的回归优先级。
三、一段真正能放进 CI 的回归选择器
下面的脚本做三件事:
- 获取当前 PR 的变更文件;
- 从业务合约地图中找出直接受影响的合约;
- 当风险超过阈值时,沿下游链路扩大测试范围。
更重要的是:找不到映射时,脚本默认全量回归,而不是默认少跑。
# tools/select_regression.py
import fnmatch
import json
import subprocess
import sys
from collections import deque

import yaml


def changed_files(base_sha: str, head_sha: str) -> list[str]:
    result = subprocess.run(
        ["git", "diff", "--name-only", base_sha, head_sha],
        check=True,
        capture_output=True,
        text=True,
    )
    return [line.strip() for line in result.stdout.splitlines() if line.strip()]


def matches_any(path: str, patterns: list[str]) -> bool:
    return any(fnmatch.fnmatch(path, pattern) for pattern in patterns)


def risk_score(contract: dict) -> int:
    # 业务重要性 × 2:确保金额、支付等核心链路天然优先
    score = contract["criticality"] * 2

    # 发生后无法简单回滚的动作,额外加权
    if contract.get("irreversible"):
        score += 3

    # 下游越多,影响面越大;最多加 3,避免依赖图过度放大
    score += min(len(contract.get("downstream", [])), 3)
    return score


def downstream_closure(seed: set[str], contracts: dict) -> set[str]:
    impacted = set(seed)
    queue = deque(seed)

    while queue:
        current = queue.popleft()
        for target in contracts[current].get("downstream", []):
            if target not in impacted:
                impacted.add(target)
                queue.append(target)

    return impacted


def select_tests(base_sha: str, head_sha: str, map_file="impact-map.yaml"):
    with open(map_file, "r", encoding="utf-8") as f:
        catalog = yaml.safe_load(f)

    contracts = catalog["contracts"]
    files = changed_files(base_sha, head_sha)

    direct = {

        contract_id
        for contract_id, contract in contracts.items()
        if any(matches_any(path, contract["paths"]) for path in files)
    }

    # 没有识别出的业务合约,不能假装“没有风险”
    if not direct:
        return {

            "mode": "full",
            "reason": "存在未映射文件,按 fail-closed 策略执行全量回归",
            "changed_files": files,
            "tests": [item["command"] for item in catalog["tests"]],
        }

    expanded = set(direct)
    threshold = catalog["policy"]["expand_threshold"]

    for contract_id in direct:
        if risk_score(contracts[contract_id]) >= threshold:
            expanded |= downstream_closure({
   contract_id}, contracts)

    selected = [
        item["command"]
        for item in catalog["tests"]
        if set(item["covers"]) & expanded
    ]

    covered_contracts = {

        contract_id
        for item in catalog["tests"]
        for contract_id in item["covers"]
        if item["command"] in selected
    }

    missing = expanded - covered_contracts
    if missing:
        return {

            "mode": "full",
            "reason": f"关键合约缺少测试覆盖:{sorted(missing)}",
            "changed_files": files,
            "tests": [item["command"] for item in catalog["tests"]],
        }

    return {

        "mode": "targeted",
        "changed_files": files,
        "direct_contracts": sorted(direct),
        "expanded_contracts": sorted(expanded),
        "tests": selected,
    }


if __name__ == "__main__":
    result = select_tests(sys.argv[1], sys.argv[2])
    print(json.dumps(result, ensure_ascii=False, indent=2))
如果 AI 改动了 services/promotion/calculator.py,coupon_price 的风险分为:
业务重要性 5 × 2 + 下游合约 2 = 12
达到阈值后,脚本不只跑优惠单测,还会扩展到:
coupon_price
→ order_total
→ payment_amount
→ coupon_redeem
对应的回归集合是:
tests/unit/test_coupon_calculator.py
tests/contract/test_checkout_amount.py
tests/e2e/test_pay_after_coupon.py
tests/regression/test_coupon_rollback.py
这才是“有依据的扩大回归”,而不是测试同学凭经验说一句:“这次还是全跑吧。”
四、测试用例要守住的,是金额链路的两个不变量
回归选择器只是决定跑哪些测试;真正兜底的,仍然是测试代码中的业务断言。
以“优惠后支付”为例,至少要固定两个不变量:
def test_coupon_price_is_consistent_with_payment(checkout_client, payment_client):
    checkout = checkout_client.create_order(
        items=[{
   "sku": "keyboard", "price": 69900, "count": 1}],
        coupon_code="VIP-100",
    )

    # 不变量 1:应付金额不能为负,优惠不能超过商品金额
    assert checkout["payable_amount"] >= 0
    assert checkout["discount_amount"] <= checkout["goods_amount"]

    payment = payment_client.create_trade(order_id=checkout["order_id"])

    # 不变量 2:支付交易金额必须等于订单最终应付金额
    assert payment["amount"] == checkout["payable_amount"]
这段测试看似简单,但它比“接口返回 200”“优惠字段存在”更接近真实损失。
因为 AI 改代码时,最常见的并不是把接口直接写崩,而是:
- 计算顺序换了,会员折扣和满减叠加错误;
- 精度处理变了,分转元后出现一分钱误差;
- 订单金额更新了,支付交易单仍读取旧字段;
- 补偿逻辑没同步,回滚后出现重复核券。
五、别把“精准回归”做成少跑测试的借口
这套方法最容易被误用成一句话:
“脚本只选了 8 条,所以其他测试都不用跑。”
不对。它解决的是 PR 阶段的反馈速度,不是取消全量质量保障。
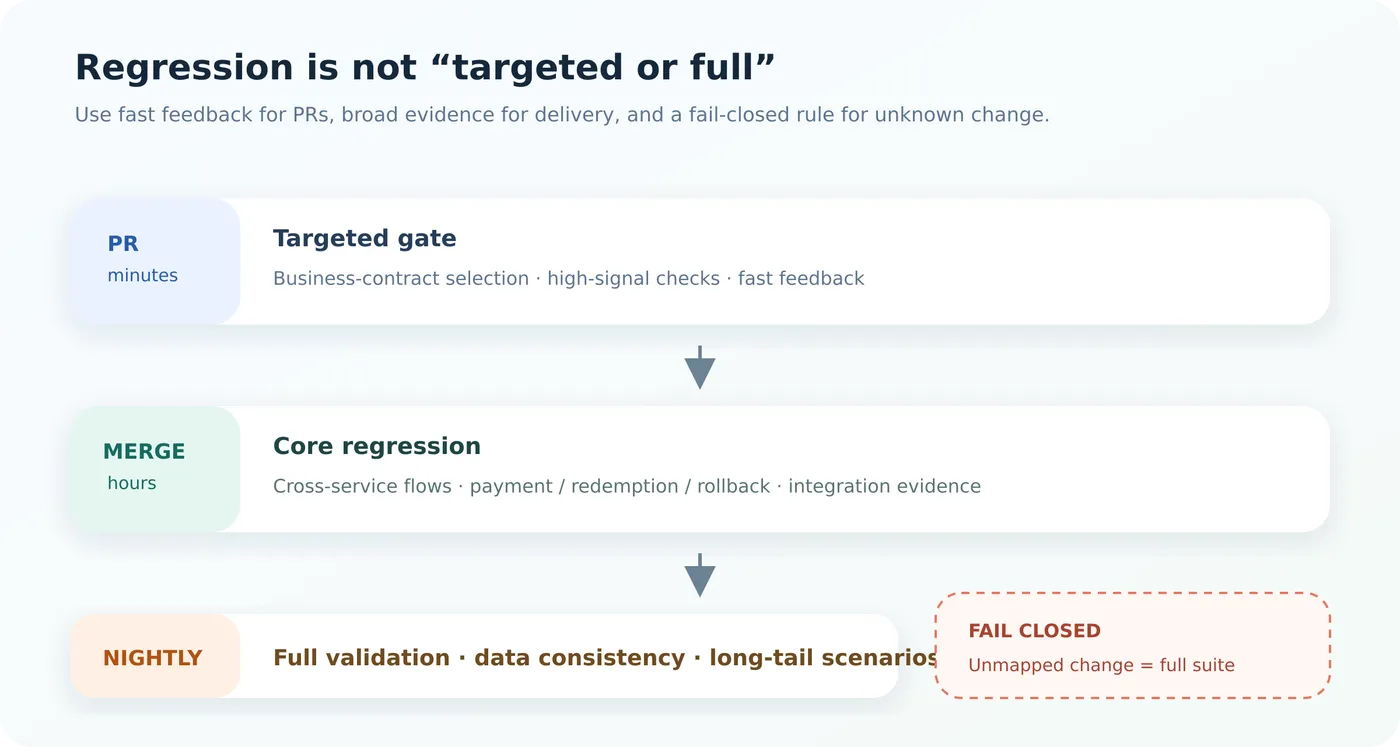
建议把回归拆成三层:
| 阶段 | 目标 | 执行策略 |
|---|---|---|
| PR 快速门禁 | 尽快拦截直接风险 | 按业务合约自动选测 |
| 合并后回归 | 发现跨模块耦合问题 | 核心链路全量回归 |
| 夜间/发布前 | 发现低频、慢性问题 | 全量 + 数据一致性 + 回滚验证 |
还有一条必须写进团队规则:
新增业务路径、改动跨服务链路、出现未映射文件时,默认扩大,不默认缩小。
GitHub 的 Copilot cloud agent 已经可以在分支中研究仓库、修改代码、执行自动化测试,并在准备后创建 PR。代码产出变快后,测试最需要补上的不是“再加一个 AI 工具”,而是让每一个改动都留下可审计的业务影响证据。GitHub 官方文档
写在最后
AI Coding 让“改代码”越来越便宜,但它没有让“判断改动影响”变简单。
真正成熟的测试体系,不是跑得最快,也不是跑得最多,而是每次面对一个 PR 时,都能回答清楚:
- 它改变了哪条业务承诺?
- 如果错了,用户和公司会付出什么代价?
- 我们为什么相信这批测试足以支持放行?
当这三个问题能被代码、测试资产和 CI 记录共同回答时,测试才真正从“回归执行者”变成了交付风险的决策者。