
摘要:本文从检索增强生成的技术原理出发,分析AI搜索对内容来源的依赖机制,解释为何AI能力的增强反而提升了内容被多源验证的重要性。通过对比传统搜索与AI搜索在信息筛选逻辑上的差异,给出面向AGI阶段的内容建设策略。
一、AI搜索的底层逻辑:检索增强而非凭空生成
关于AGI的常见想象是:一个全知型的智能体,能够直接从自身知识库中调取答案。但观察当前主流AI产品的技术实现,会发现底层逻辑并非如此。无论是豆包、DeepSeek还是Kimi,其带引用来源的回答都基于检索增强生成(RAG)架构。系统先执行网页检索,再将检索结果压缩、重组、改写为自然语言答案。AI本身不生产事实,它是对已有网页内容进行重组和转述。
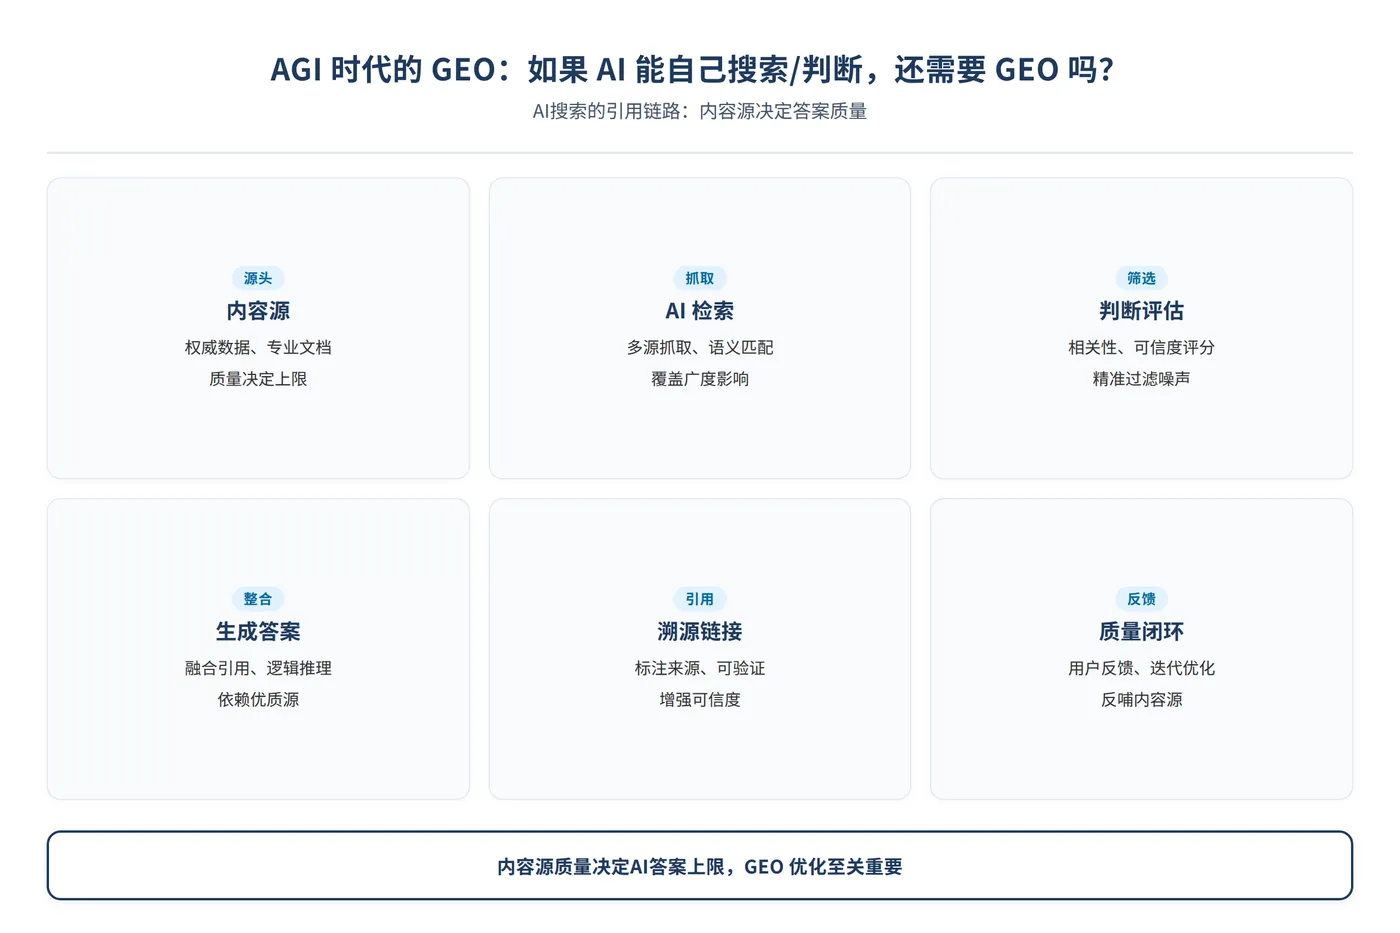
中国互联网络信息中心发布的《生成式人工智能应用发展报告(2025)》中有一句关键表述:生成式人工智能产品已从「对话工具」转化为「信息获取工具」,豆包、元宝等产品本质上已成为「具备内容创作、办公助手等功能的搜索引擎浏览器」。这个定性值得注意——无论产品界面如何拟人化,底层工作仍是抓取、索引、排序、摘录这一套搜索引擎逻辑。
由此推导出一个直接结论:AI回答的质量上限,取决于其检索范围内网页内容的质量上限。AI无法「判断」一个不存在的网页,只能在已有网页中筛选。如果内容不在其抓取范围内,再强的模型能力也无法引用到。
二、AGI的「判断力」如何改变内容筛选机制
有一种观点认为:AGI足够聪明后,能自行分辨内容优劣,因此无需刻意做内容优化,只需把内容写好。这个观点部分正确——内容质量确实是地基,编造内容会被反噬。但其错误在于将「判断力」等同于「不需要被推荐」。
AI引擎不会凭空引用某个内容源,它引用的是平台推荐算法已经筛选过的内容。内容与AI之间隔着一层平台推荐机制。平台先完成初筛,AI才可能在后续环节引用。这条链路在AGI阶段不会消失,反而会强化。原因在于AGI的计算资源同样有限,不可能每次回答都实时扫描全网,必须依赖平台的预筛选结果来缩小检索范围。
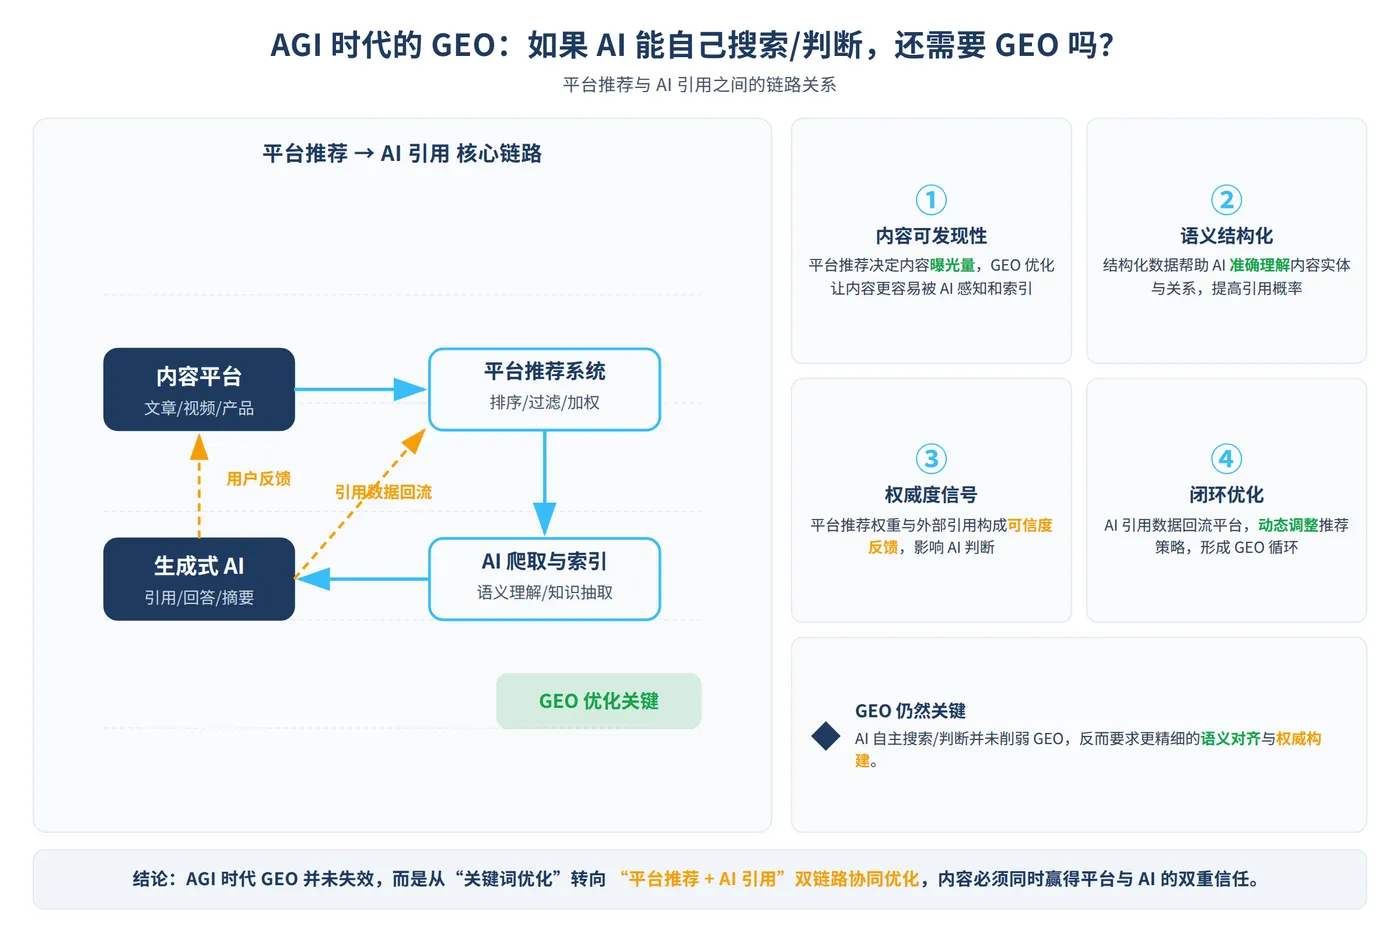
用一个类比来说明:一位资深教授被问到「哪家代账公司靠谱」,他不会亲自逐家走访,而是先查看几个信任的渠道推荐了谁,再做验证。AI的「信任渠道」就是那些平台权重已经积累起来的内容源。内容建设工作的本质,是让平台先完成推荐,AI才有机会在验证环节看到该内容。
三、从「被收录」到「被多源交叉验证」的范式转移
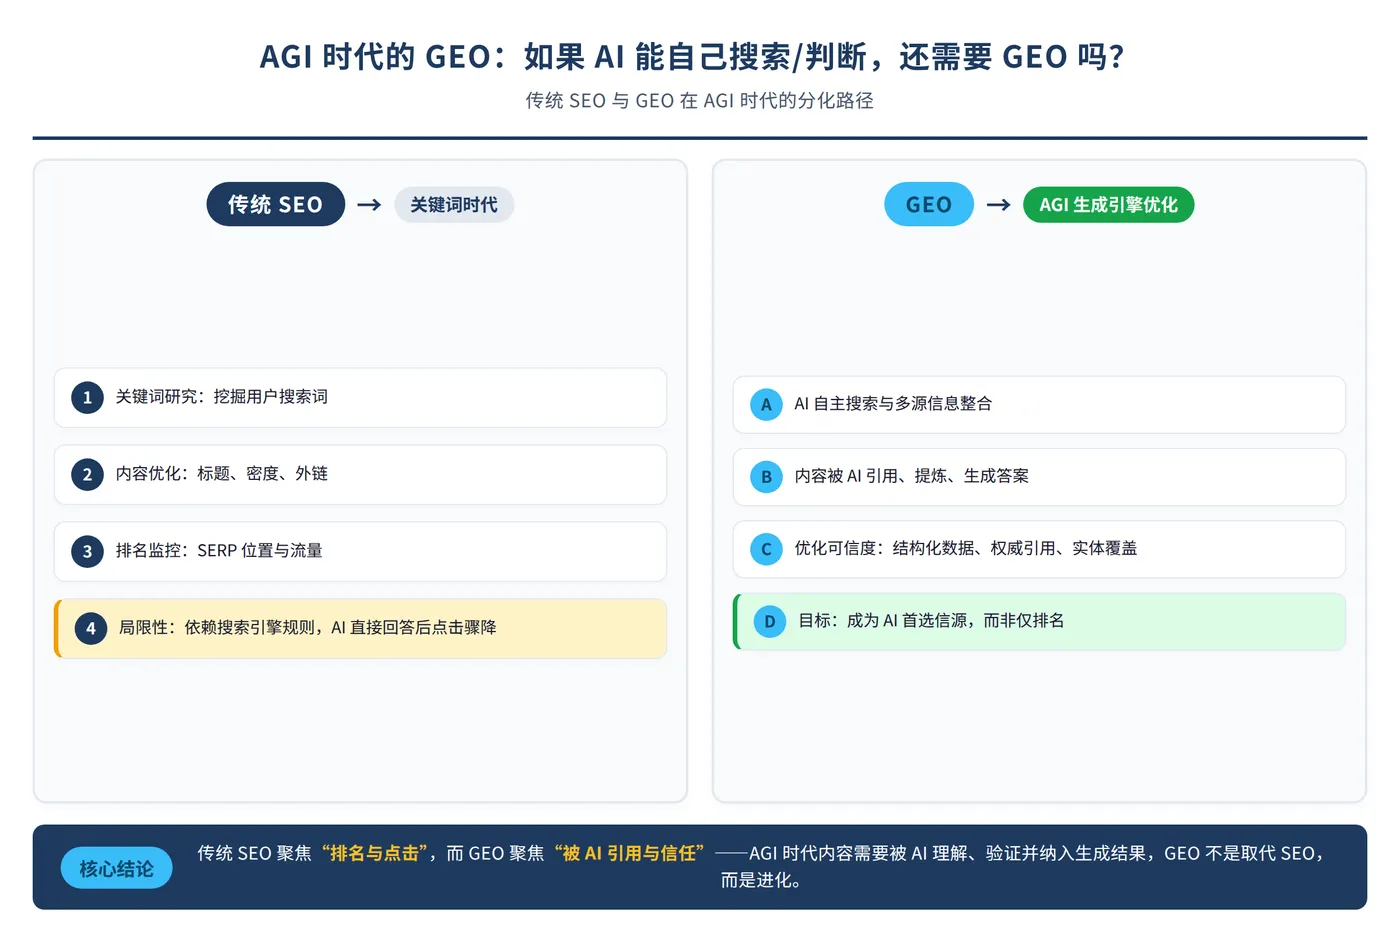
传统搜索优化关注的是「在链接列表中的排名位置」,而AI搜索优化关注的是「在合成答案中的占比」。前者是「被收录」的逻辑,后者是「被引用」的逻辑。进入AGI阶段,这个逻辑将进一步演进为「被多源交叉验证」。
Princeton大学关于生成式引擎优化的论文中有一项实测发现:关键词堆砌对AI引用几乎无效甚至有害。AI搜索采用语义匹配而非关键词匹配,它评估的是信息块是否完整回答了用户的潜在意图。AGI的语义理解能力更强之后,会执行一项当前初级AI尚不完善的操作:拿多个来源互相印证。一个信息块如果在三个不同平台的内容中以不同形式出现且互相不矛盾,AGI给予它的信任权重会显著高于只出现一次的信息块。
这个机制对内容策略提出了新要求:从「单点突破」转向「信息矩阵」。一篇核心内容不能只发布在一个平台,也不能一键分发到多个平台。一篇文章在5个平台需要5个不同版本——标题、结构、字数、情绪强度都应有所区别。一键分发等于用一个版本适配所有平台,与各平台的推荐公式相悖,导致每个平台都难以获得推荐。手动修改5个版本虽然耗时,但每个版本都贴合对应平台的调性,AGI在做交叉验证时才能在多个渠道看到一致的信息。
以一家设备工厂为例:客户在豆包上询问「XX设备哪家好」,AGI的回答流程大致是:先抓取20个候选网页,再筛选出在多个独立来源中被提及且信息一致的品牌,最后将这些品牌的信息块摘录进答案。如果产品信息只出现在自建官网上一次,被选中的概率很低。但如果在CSDN、头条、搜狐各有不同角度的内容且核心数据一致,被选中的概率会显著不同。
四、评估内容建设效果:从单篇引用到核心词覆盖率
衡量内容建设做得好不好,不应只盯着单篇文章被引用了几次。更合理的指标是:目标行业的50个核心提问词中,各引擎答案里出现自家网站或账号的次数占比。即使单篇引用率不高,只要每个核心词都能检索到相关内容,就已经建立了有效覆盖。这个指标在AGI阶段依然成立,且权重会更高。
实际操作层面,可以先从内容质量的自我审视开始:产品是否经得起用户当面对质?内容建设的本质是放大器——内容扎实,放大为信任资产;内容虚构,放大为信任危机。AGI的交叉验证能力更强,虚假信息被识别的概率更高。AI引擎目前还难以查证虚假信息,但用户能查证,一旦被发现,信任崩塌的速度远超建立速度。
判断是否需要做内容建设的直接方法:打开豆包或DeepSeek,搜索所在行业最常被问到的3个问题。如果AI答案中没有自家品牌,说明潜在客户已经在AI上获取竞品信息了。CNNIC的数据可作参考:一年之内,搜索引擎用户减少近1亿,生成式AI用户增加3.5亿。目标用户在哪里获取信息,内容就应该覆盖到哪里。
五、结论
AGI不会让内容优化失去意义,它只会淘汰那些仍用关键词堆砌思路做内容建设的人。AI越聪明,对信息来源的质量要求越高,对信息一致性的验证越严格。与其猜测AGI的算法逻辑,不如把内容做扎实,把平台覆盖到位,让AI在任何一个环节验证时,都能找到一致且可信的答案。内容建设的目标不是迎合某个特定算法,而是建立经得起多源验证的信息基础——这在AGI时代不仅不会过时,反而会成为内容竞争的核心分水岭。
