Qwen3.8-Flash模型介绍:能力、上下文限制、费用定价详细说明

简介: 通义千问最新多模态大模型Qwen3.8-Flash(ID:qwen3.8-flash),原生支持百万级上下文(100万tokens)、文本/图像/视频输入,输出为文本。具备Function Calling、结构化输出、联网搜索(限北京/新加坡)等能力,兼容OpenAI/Anthropic协议,已在阿里云百炼平台开放免费试用(赠100万Tokens)。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens

Qwen3.8-Flash 是通义千问最新推出的多模态大模型,模型调用 ID 为 qwen3.8-flash,原生支持百万级上下文窗口(1,000,000 tokens),输入模态支持文本、图像和视频,输出模态为文本。在阿里云百炼AI大模型平台:https://www.aliyun.com/product/bailian 测试使用,可以免费领取100万Tokens,如下图:
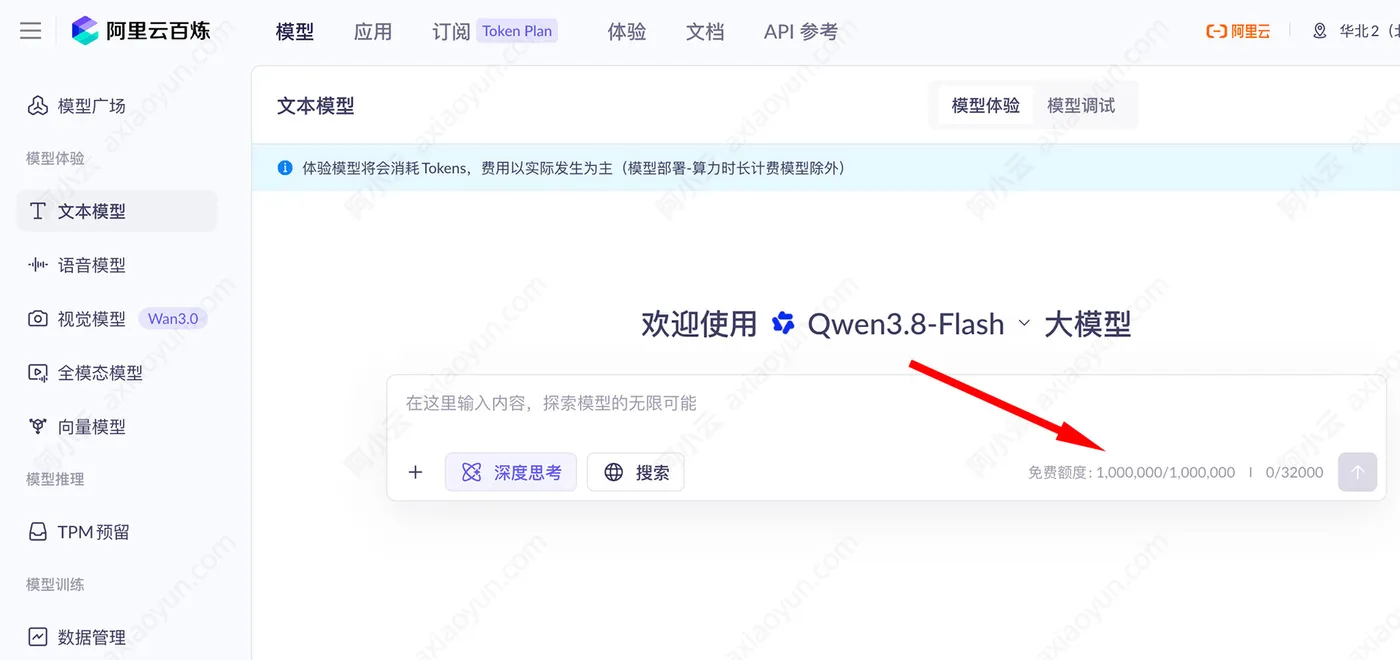
阿里云百炼Qwen3.8-Flash

核心能力:

  • 支持 Function Calling、结构化输出、联网搜索、前缀续写和上下文缓存;不支持批量推理和模型调优。
  • 兼容 OpenAI 与 Anthropic 接口协议,可接入 Claude Code、Codex 等开发者工具。
  • 在编程辅助、智能体协作、图文理解、长视频分析等场景中表现突出。

上下文限制:

  • 最大输入长度:991,808 tokens(思考模式下 983,616)
  • 最大输出长度:131,072 tokens
  • 最大思维链长度:262,144 tokens

部署地域与能力差异:

  • 华北2(北京)、新加坡:支持联网搜索
  • 德国(法兰克福)、日本(东京)、美国(弗吉尼亚):不支持联网搜索
  • 所有地域均支持 Function Calling、结构化输出、上下文缓存和前缀续写

计费信息(华北2-北京):

  • 输入:0.8 元/百万 tokens
  • 输出:2.7 元/百万 tokens
  • 输入(缓存命中):0.1 元/百万 tokens

价格可能调整,实际关于Qwen3.8-Flash模型精准报价,请在阿里云百炼平台查询:https://www.aliyun.com/product/bailian

相关文章
|
2月前
|
人工智能 监控 测试技术
Qwen3.8-Flash 来了,100万上下文、Agent、Coding 都加强了
8月26日,通义千问发布Qwen3.8-Flash-Next:125B参数、每Token仅激活6B,原生支持26万Token、可扩展至100万上下文;Coding、Agent与工具调用能力显著增强,面向真实软件工程任务,推动大模型从“回答问题”迈向“完成工作”。
|
2月前
|
缓存 人工智能 监控
阿里云Qwen3.8-Flash模型解析:多模态 MoE 模型,支持百万级上下文窗口,能一次性处理超长文档、代码仓库
本文详细介绍了阿里云最新发布的多模态大模型Qwen3.8-Flash。该模型采用稀疏混合专家(MoE)架构,原生支持百万级上下文,可一次性处理超长文档、代码仓库与复杂对话。文章系统梳理了其文本、图像、视频输入与结构化输出、函数调用、联网搜索等核心能力,提供了覆盖编程辅助、智能体协作、长视频分析等五大典型场景的实践指引,并附有OpenAI与DashScope双协议接口的详细调用示例与百炼平台快速上手指南,是开发者与企业构建高并发AI应用的理想技术选型。
阿里云Qwen3.8-Flash模型解析:多模态 MoE 模型,支持百万级上下文窗口,能一次性处理超长文档、代码仓库
|
1月前
|
缓存 人工智能 API
Qwen3.8‑Flash完整能力解析:模型特性、API调用实操与计费规则深度拆解与成本避坑指南
Qwen3.8‑Flash依托全新MoE混合专家架构,激活参数量低,兼顾百万级上下文、原生多模态能力、稳定Agent工具调用,搭配云端缓存计费机制,在长会话、代码智能体、文档解析场景拥有突出的性价比。但它并不是全能模型,超高难度深度推理任务表现不及同系列旗舰大模型,业务落地需要结合自身业务诉求做综合评估。
704 1
|
1月前
|
缓存 人工智能 JSON
阿里云通义千问Qwen3.8‑Flash多模态模型全解:核心功能、订阅计费规则与生产环境选型参考
在大模型落地的生产实践当中,很多业务场景并不需要旗舰模型的顶级推理上限,但是对响应速度、并发承载能力、多模态输入、代码辅助、简单智能体任务有硬性诉求,同时还要严格控制推理成本。Qwen3.8‑Flash作为百炼平台推出的高性价比多模态基座模型,在推理速度、token成本、综合能力之间完成很好的平衡,原生支持文本、图片、视频输入,拥有百万token超大上下文窗口,强化代码生成、工具调用与中等复杂度Agent任务能力,非常适合中小开发者、中小企业构建高并发AI业务。不少开发团队初次接触该模型,容易混淆它与同系列其他版本的能力边界,分不清按量计费与Token Plan订阅的适用条件,不清楚哪些业务适
314 3
|
2月前
|
缓存 人工智能 数据挖掘
阿里云qwen3.8-max模型详解:模型能力、价格、上下文限制及使用注意事项参考
本文全面解析阿里云的Qwen3.8-Max旗舰大模型,这款采用2.4万亿参数MoE架构的通义千问系列最强模型,定位为智能体时代全能旗舰,在全球5个核心区域同步部署。它具备百万级超长上下文窗口,支持文本、图像、2小时内长视频的原生多模态输入,可独立完成跨天级软件工程交付、法律金融等专业领域生产级任务,同时实现数千轮交互下的长程任务自主规划与闭环迭代。文章同步梳理了不同区域的功能支持差异、梯度定价策略与API调用要点,明确了其适配复杂智能体应用的核心优势,新用户登录百炼平台即可领取百万Tokens免费试用额度。
阿里云qwen3.8-max模型详解:模型能力、价格、上下文限制及使用注意事项参考
阿里云轻量应用服务器68元/年,新用户特价,不要退款,重新买价格459元,涨价了!
阿里云轻量应用服务器新用户专享价68元/年(2核2G、200M带宽、40GB ESSD),秒杀低至38元。⚠️地域选定后不可修改,退款将失去新用户资格,再购恢复原价459元/年!务必下单前确认地域,避免浪费优惠。阿里云轻量应用服务器官网:https://t.aliyun.com/U/dwftch
|
1月前
|
缓存 人工智能 自然语言处理
阿里云qwen3.8-flash最全介绍:模型能力、适用场景、使用教程与最新活动参考
本文介绍了通义千问Qwen3.8-Flash这款兼顾性能与速度的多模态大模型,它拥有百万级上下文窗口,原生支持图文视频多模态输入,在长文档处理、编程辅助、高并发应用场景表现突出。文章覆盖五大地域部署差异、最新下调后的Token计费标准、两种接入方式与限流规则,叠加新用户免费额度、夜间4折等活动,是企业与开发者平衡效果与成本的高性价比选型。
|
1月前
|
存储 缓存 JSON
最新版阿里云通义千问(Qwen3.8‑Flash)功能介绍
大模型产业规模化落地过程中,推理性能与调用成本之间的矛盾,一直是开发者与企业需要直面的核心难题。旗舰级大模型综合能力强悍,但在批量Agent任务、高频文档解析、高并发接口服务场景,Token消耗会快速上涨,直接推高整体业务开销;轻量化模型虽然调用成本低廉,但是在代码工程开发、多轮工具调用、超长文档理解等复杂任务上存在明显短板,难以满足生产级业务诉求。Qwen3.8‑Flash作为通义千问推出的新一代多模态MoE模型,同时也是下一代Qwen4架构的技术预览版本,依托多项底层架构革新,在保障复杂任务处理能力的前提下,大幅压低训练与推理开销,原生支持百万级上下文窗口、图文视频多模态输入、高稳定性Fu
908 0