草莓成熟度目标检测数据集:3类别、2,000张图像 | 目标检测
源码数据分享
通过网盘分享的文件:草莓成熟度检测数据集
链接: https://pan.baidu.com/s/1WAfTb-SM0Jov7QQ1gFPXAw?pwd=tmwd
提取码: tmwd
一、从经验判断到视觉智能:草莓成熟度检测的范式变革
草莓是全球最受欢迎的水果之一,也是智慧农业技术落地的典型场景。不同于水稻、小麦等大宗粮食作物,草莓的经济价值高度依赖于采摘时机的精准把控——提前一天采摘,果实甜度不足、口感酸涩;延后一天采摘,果实过熟软化、货架期骤降。在商业化草莓种植中,每一天的采摘时机偏差都可能导致数万元的经济损失。
传统的成熟度判断完全依赖人工经验——种植者通过观察果实颜色、触摸硬度、嗅闻香气等感官指标进行判断。这种方式在小规模种植中尚可运作,但在动辄数十亩的大棚种植基地中,人工巡检的效率瓶颈极为突出:
- 一名熟练工人每天最多检查2-3亩草莓,每株需逐一翻看
- 不同工人的判断标准存在差异,同一果实可能被不同人给出不同判定
- 夜间和清晨(最佳采摘时段)的人工巡检效率更低
- 重复弯腰翻叶的体力劳动强度大,工人疲劳后判断力下降
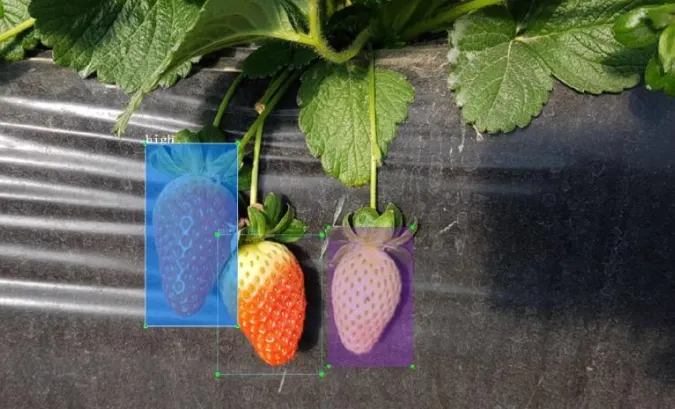
基于深度学习的草莓成熟度视觉检测技术,正在从根本上改变这一局面。通过在温室大棚中安装视觉系统或部署采摘机器人,AI可以7×24小时不间断地监测每颗草莓的成熟状态,在最佳时机发出采摘指令或自动完成采摘。
而这一切的起点,就是一个高质量、多环境覆盖、成熟度标签精确的检测数据集。本草莓成熟度目标检测数据集(2000张已标注图像),正是为这一需求而构建。
二、数据集全景解析:三类成熟度的农业语义深度解读
2.1 类别定义与农业语义
数据集包含3类草莓成熟度目标:
| 类别ID | 类别名称 | 含义 |
|---|---|---|
| 0 | unripe | 未成熟草莓 |
| 1 | ripe | 成熟草莓 |
| 2 | overripe | 过熟草莓 |
未成熟(unripe):草莓整体呈绿色或浅白色,果实尚未开始转色。此时果实内部的糖分积累尚不充分,酸度较高,口感远未达到商品标准。从农业管理角度看,检测到大量unripe果实意味着该区域距离采收期尚早,可以优先安排其他成熟区域的采摘工作。
在视觉特征上,unripe草莓的颜色与叶片、花萼的绿色非常接近,这是检测的主要难点——模型需要在大量绿色背景中区分出绿色的果实目标。
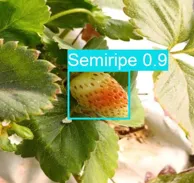
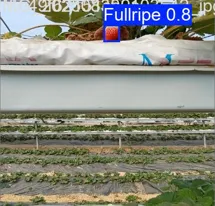
成熟(ripe):果实整体呈鲜红色,表面光泽度高,种子清晰可见。这是最佳采摘阶段,果实的糖度、酸度和香气达到最佳平衡。在商业化种植中,ripe阶段的草莓是采收的唯一目标——过早影响品质,过晚影响货架期。
在视觉特征上,ripe草莓的红色与绿色叶片形成鲜明对比,是最容易检测的类别。但在大棚环境中,光照不均和阴影干扰可能导致红色呈现暗红色或偏紫色,增加检测难度。
过熟(overripe):草莓颜色加深至暗红色甚至紫红色,表面可能出现软化、凹陷或轻微霉斑。过熟草莓的货架期极短,通常需要立即处理——要么降价销售,要么加工为果酱、果汁等产品。
在视觉特征上,overripe草莓与ripe草莓的区分是最大的检测难点——两者的颜色差异可能非常微妙,尤其是在不同光照条件下。此外,部分过熟草莓可能被叶片遮挡,仅露出少量区域,进一步增加了识别难度。
2.2 数据集基本信息
| 参数 | 数值 |
|---|---|
| 图像总量 | 约2000张 |
| 标注格式 | YOLO标准格式 |
| 检测类别 | 3类成熟度 |
| 数据划分 | 训练集/验证集/测试集 |
| 采集环境 | 大棚+田间+多光照条件 |
三、数据构建方法论:农业视觉数据的采集挑战与标注策略
3.1 数据采集的农业特殊性
农业视觉数据采集面临独特挑战:
光照变化剧烈:大棚内的光照在一天之内变化极大——清晨微光、正午强光、阴天散射光、补光灯人工光源。不同光照下,同一颗草莓的视觉外观差异显著。
背景高度复杂:草莓生长在叶片丛中,果实被大量绿色叶片、花萼和藤蔓包围。这些遮挡物不仅影响检测,还使得标注工作需要仔细辨认目标边界。
目标密度高:一株草莓可能同时挂有10-20颗果实,不同成熟度的果实密集分布在狭小空间内,标注时需要逐一区分。
时间敏感性:草莓的成熟状态在几天内就会发生显著变化,数据采集需要覆盖不同生长阶段,确保每个成熟度类别都有充足样本。
3.2 数据采集方案
本数据集覆盖了以下采集维度:
环境多样性:
- 温室大棚种植环境(塑料薄膜棚、玻璃温室)
- 田间自然种植环境(露天草莓田)
- 不同种植方式(地面种植、高架种植、吊蔓种植)
光照变化:
- 自然光环境(晴天/阴天/不同时间段)
- 人工补光环境(LED补光灯照射)
- 混合光照环境
拍摄角度:
- 俯视拍摄(大棚顶部安装的固定相机)
- 斜视拍摄(机器人/手持设备拍摄)
- 近距离特写(单颗果实的高分辨率图像)
3.3 标注策略
采用YOLO标准标注格式:
class x_center y_center width height
标注过程中的关键决策:
- 遮挡处理:被叶片部分遮挡的草莓仍需标注,标注框覆盖可见部分。遮挡超过80%的果实不标注
- 密集目标:多颗紧密相邻的草莓需逐一标注,每颗一个独立框
- 成熟度判定标准:
- unripe:绿色面积>70%
- ripe:红色面积>70%,且无明显软化
- overripe:暗红色/紫红色,或有明显软化/霉斑
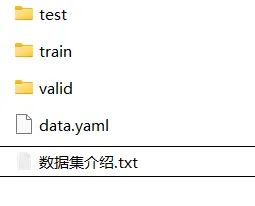
3.4 数据集目录结构
dataset/
├── images/
│   ├── train/
│   ├── val/
│   └── test/
└── labels/
    ├── train/
    ├── val/
    └── test/
四、模型训练与优化实战
4.1 数据配置文件
nc: 3
names: ['unripe', 'ripe', 'overripe']
4.2 基准训练
from ultralytics import YOLO

model = YOLO("yolov8n.pt")

model.train(
    data="dataset.yaml",
    epochs=150,
    imgsz=640,
    batch=16,
    patience=30,
    fliplr=0.5,
    mosaic=1.0,
    hsv_h=0.015,
    hsv_s=0.7,
    hsv_v=0.4
)
4.3 针对农业场景的优化策略
颜色特征增强:成熟度分类的核心特征是颜色。建议在HSV色彩空间中进行增强,特别是色调(Hue)通道的增强,可以帮助模型更好地学习不同成熟度的颜色分布。
遮挡鲁棒性提升:
- 在训练集中保留大量遮挡样本,让模型学习从局部特征推断整体
- 使用Copy-Paste增强,将草莓目标粘贴到不同的遮挡背景中
ripe与overripe的精细区分:
- 增加两个类别之间的边界样本(如刚进入过熟阶段的草莓)
- 使用对比学习损失函数,增强类间区分能力
- 在后处理中结合置信度阈值——当ripe和overripe的置信度接近时,输出为"边界样本"供人工复核
小目标检测增强:远距离拍摄的草莓图像中,单颗果实可能仅占10×10像素。增大输入分辨率(640→1280)或使用SAHI切片推理可以显著提升小目标检测性能。
4.4 数据增强组合
model.train(
    data="dataset.yaml",
    epochs=150,
    imgsz=640,
    batch=16,
    fliplr=0.5,
    mosaic=1.0,
    mixup=0.1,
    copy_paste=0.3,     # 复制粘贴增强,对遮挡场景有效
    degrees=10,          # 旋转±10度
    translate=0.1,       # 平移10%
    scale=0.5,           # 缩放0.5-1.5
    hsv_h=0.02,          # 色调增强(对颜色特征重要)
    hsv_s=0.7,           # 饱和度增强
    hsv_v=0.4            # 明度增强
)
五、工程部署与智慧农业系统集成
5.1 采摘机器人集成
在自动化草莓采摘系统中,视觉检测模块与机械臂控制系统协同工作:
视觉相机 → YOLO检测 → 3D定位 → 采摘路径规划 → 机械臂执行
              ↓
        成熟度筛选(仅采摘ripe)
成熟度筛选:采摘机器人只采摘ripe类别的草莓,忽略unripe和overripe目标。这要求检测模型对ripe类别的精确率足够高——误摘unripe意味着产量损失,误摘overripe意味着品质降级。
3D定位:将2D检测框转换为3D空间坐标,需要相机的内参标定与工作平面的外参标定。精度要求通常为±3mm,以确保机械臂的夹爪准确对准果实。
采摘路径规划:基于3D坐标与遮挡信息,规划机械臂的无碰撞运动路径,避免碰落相邻果实。
5.2 产量预测与采收管理
基于检测结果,系统可以实现更高级的农业管理功能:
产量预测:统计每株草莓的ripe+unripe果实数量,结合成熟时间模型,预测未来一周的采收量
成熟进度追踪:对同一区域进行定期拍摄,追踪果实从unripe→ripe→overripe的变化过程
采收排期优化:基于成熟度分布统计,优化每日的采收路线与人力分配
5.3 品质分级系统
在分选线上,将检测模型部署为自动分级系统:
- A级:ripe且无明显缺陷 → 鲜食市场
- B级:ripe但有轻微外观瑕疵 → 加工市场
- C级:overripe → 果酱/果汁原料
- 淘汰:unripe或严重缺陷 → 废弃处理
六、扩展研究方向
6.1 缺陷检测扩展
在成熟度检测基础上,增加草莓缺陷类别:霉斑、虫蛀、畸形、机械损伤等。这需要更大规模的标注数据与更精细的检测模型。
6.2 多品种适配
当前数据集以红颜、章姬等常见品种为主。不同品种的草莓在颜色、形状和成熟特征上存在差异,需要通过迁移学习或域适应技术实现跨品种泛化。
6.3 多模态融合
融合高光谱成像与可见光图像,利用高光谱数据提供的化学成分信息(如糖度、酸度),实现更精确的内在品质评估,而不仅仅是外观成熟度判断。
七、总结
本草莓成熟度目标检测数据集(2000张已标注图像),是一套面向智慧农业精准采摘场景构建的目标检测数据资源。三类成熟度——未成熟、成熟、过熟——的划分紧密对接农业生产中的实际采摘决策需求,数据覆盖多种种植环境与光照条件,标注质量经过严格管控。
对于从事智慧农业、采摘机器人与农业视觉检测的开发者而言,该数据集不仅是一份可直接使用的训练资源,更是一套从数据构建到系统部署的完整技术参考。随着农业智能化的持续推进,基于视觉AI的成熟度检测将成为精准农业的核心能力,而高质量数据集将持续推动这一领域的技术创新与产业落地。